

A Google Blog Editor: Have you ever wondered how Google Cloud Technical Solutions (TSE) engineers handle your support requests? The TSE support engineers are responsible for identifying and resolving issues reported by users. Some of these problems are quite simple, but sometimes a request requires the attention of several engineers. In this article, one TSE staff member will share with us a particularly tricky problem from their recent experience — . Throughout this story, we will see how the engineers managed to resolve the situation and what new insights they gained during the troubleshooting process. We hope this story not only informs you about a deeply rooted bug but also provides an understanding of the processes involved in submitting a request to Google Cloud Support.
Troubleshooting is both a science and an art. It all begins with building a hypothesis about the cause of the system's unusual behavior, which is then tested rigorously. However, before formulating a hypothesis, we must clearly define and articulate the problem. If the question is too vague, you will need to analyze everything thoroughly; that's where the 'art' of troubleshooting comes in.
In the context of Google Cloud, such processes are considerably more complicated, as Google Cloud strives to ensure the privacy of its users. As a result, TSE engineers do not have the ability to edit your systems, nor can they survey configurations as broadly as users do. Therefore, to verify any of our hypotheses, we (the engineers) cannot quickly modify the system.
Some users believe that we will fix everything like mechanics in a car service and simply send us the virtual machine ID, whereas in reality, the process unfolds as a conversation: gathering information, forming and confirming (or refuting) hypotheses, and ultimately, the solution to the problem is built on communication with the client.
The problem under consideration
Ma előttünk egy jó véget érő történet áll. Az egyik oka a javasolt ügy sikeres megoldásának a probléma nagyon részletes és pontos leírása. Lent látható az első jegyzet másolata (szerkesztve, hogy elrejtsük a bizalmas információkat):
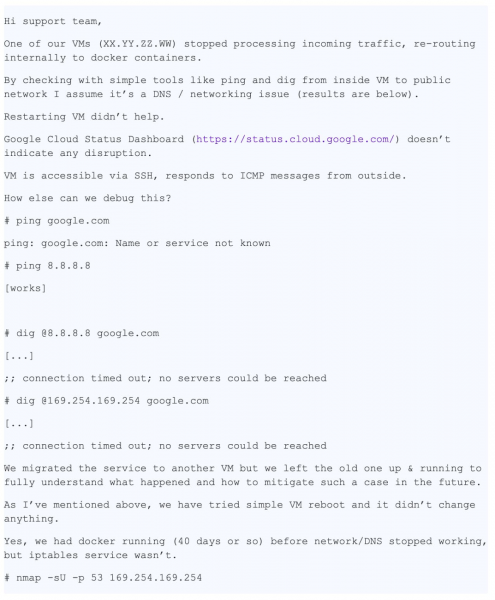
Ebben az üzenetben nagyon sok hasznos információ található számunkra:
- Meg van adva a konkrét VM
- Meg van adva a probléma — a DNS nem működik
- Meg van adva, hol jelentkezik a probléma — VM és konténer
- Meg vannak adva a felhasználó lépései a probléma meghatározásához
A bejelentést "P1: Kritikus Hatás — Szolgáltatás Használhatatlan a termelésben" néven regisztrálták, ami folyamatos ellenőrzést jelentett 24/7 a "Follow the Sun" módszer szerint (a linken részletesebben olvashat erről ), az egyes csapatok közti átadás minden időeltolódásnál. Lényegében, mire a probléma a zürichi csapatunkhoz eljutott, már körbeautózta a Földet. Ekkorra a felhasználó megtett lépéseket a következmények csökkentésére, de attól tartott, hogy a helyzet megismétlődhet a termelésben, mivel az alapvető okot még nem találták meg.
Amikor a jegy eljutott Zürichbe, már a következő információk álltak rendelkezésünkre:
- Tartalom
/etc/hosts - Tartalom
/etc/resolv.conf - Következtetés
iptables-save - A csapat által összegyűjtött
ngreppcap fájl
Ezekkel az adatokkal készen álltunk a "nyomozás" és a hibaelhárítás szakaszának megkezdésére.
Első lépéseink
Elsősorban a naplókat és a metadataszerver állapotát ellenőriztük, és megbizonyosodtunk arról, hogy az megfelelően működik. A metadataszerver válaszol a 169.254.169.254 IP-címre, és többek között a domainek nevének ellenőrzéséért is felel. A tűzfalat is újraellenőriztük, hogy megfelelően működik a VM-mel, és nem blokkolja a csomagokat.
Ez egy furcsa probléma volt: az nmap ellenőrzés megcáfolta a fő hipotézisünket a UDP csomagok elvesztéséről, ezért gondolatban több alternatívát és ellenőrzési módot dolgoztunk ki:
- Választékosan eltűnnek a csomagok? => Ellenőrizni az iptables szabályokat
- Nem túl kicsi-e ? => Проверить вывод
ip a show - Csak az UDP-csomagokat érinti a probléma, vagy a TCP-t is? => Futassuk le a
dig +tcp - Visszatérnek a generált dig csomagok? => Futassuk le
tcpdump - Jól működik a libdns? => Futassuk le
stracea csomagok kétirányú átvitelének ellenőrzésére
Itt úgy döntünk, hogy telefonon beszélünk a felhasználóval a hibaelhárítás érdekében.
A hívás során több dolgot ellenőrizni tudunk:
- Néhány ellenőrzés után kizárjuk az iptables szabályokat, mint a problémák lehetséges okait.
- Ellenőrizzük a hálózati interfészeket és az útválasztási táblázatokat, valamint újra ellenőrizzük az MTU helyességét.
- Megállapítjuk, hogy
dig +tcp google.com(TCP) megfelelően működik, dedig google.com(UDP) nem működik. - Futtatva
tcpdumpjól működik.dig, és arról számolunk be, hogy az UDP csomagok visszatérnek. - Futtatjuk
strace dig google.com, és látjuk, hogy a dig megfelelően hívja meg asendmsg()ésrecvms(), azonban a második időtúllépés miatt megszakad.
Sajnos lejár a műszak, és kénytelenek vagyunk a problémát átadni a következő időzónának. Az ügy azonban felkeltette a csapatunk érdeklődését, és egy kolléga javasolja, hogy hozzunk létre egy DNS csomagot a Python scrapy modul segítségével.
from scapy.all import *

answer = sr1(IP(dst="169.254.169.254")/UDP(dport=53)/DNS(rd=1,qd=DNSQR(qname="google.com")),verbose=0)
print ("169.254.169.254", answer[DNS].summary())
Ez a részlet létrehozza a DNS csomagot és elküldi a kérdést a metadat szervernek.
A felhasználó futtatja a kódot, a DNS válasz visszatér, és az alkalmazás megkapja azt, ami megerősíti, hogy a probléma nem a hálózati szinten van.
Miután egy újabb "körutazás" után a kérés visszatér a csapatunkhoz, teljesen átvállalom, mivel úgy gondolom, hogy a felhasználónak könnyebb lesz, ha a kérés leáll a bolyongással.
Közben a felhasználó kedvesen beleegyezik, hogy megossza a rendszerképet. Ez nagyon jó hír: a rendszer tesztelésének lehetősége jelentősen felgyorsítja a hibakeresést, mivel többé nem kell kérnem a felhasználót, hogy futtasson parancsokat, küldje el nekem az eredményeket és elemezze azokat; mindent meg tudok csinálni önállóan!
A kollégák kezdik irigyelni a helyzetemet. Az ebédnél megbeszéljük az ügyet, de senkinek sincs ötlete arról, hogy mi történik. Szerencsére maga a felhasználó már tett lépéseket a következmények enyhítésére, és nem siet, így van időnk alaposan megvizsgálni a problémát. Mivel van képezett rendszerünk, bármilyen érdekes tesztet el tudunk végezni. Nagyszerű!
Visszatérve egy lépést hátra
Az egyik leggyakoribb kérdés a rendszertechnikusi interjúkon így hangzik: „Mi történik, amikor pingel egy ?» Вопрос шикарный, так как кандидату необходимо описать пусть от оболочки до пользовательского пространства, до ядра системы и далее к сети. Я улыбаюсь: иногда вопросы с интервью оказываются полезны и в реальной жизни…
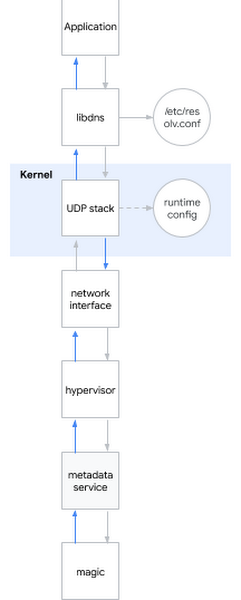
Úgy döntök, hogy alkalmazom ezt a HR kérdést a jelen problémára. Egy szóval, amikor megpróbálja meghatározni a DNS nevet, a következő történik:
- Az alkalmazás hívja a rendszerkönyvtárat, például a libdns-t
- A libdns ellenőrzi a rendszer konfigurációját, hogy melyik DNS szerverhez kell kapcsolódnia (a diagramon ez 169.254.169.254, a metadat szerver)
- A libdns rendszerg hívásokat használ UDP socket (SOKET_DGRAM) létrehozásához és UDP csomagok továbbításához DNS kérésekkel mindkét irányban
- A sysctl interfészen keresztül beállítható az UDP verem a kernel szintjén
- A kernel a hardverrel kommunikál a csomagok hálózaton keresztüli továbbításával a hálózati interfészen
- A hipervizor elkapja és továbbítja a csomagot a metadat szervernek, amikor kapcsolatba kerül vele
- A metadat szerver varázslatával meghatározza a DNS nevet és ugyanazzal a módszerrel adja vissza a választ
Emlékeztetnék, hogy mely hipotéziseket vizsgáltuk már:
Hipotézis: Megtörtek a könyvtárak
- Teszt 1: futtassuk a rendszeren a strace-t, ellenőrizzük, hogy a dig megfelelő rendszerhívásokat indít-e
- Eredmény: a rendszerhívások helyesek
- Teszt 2: a srapy segítségével ellenőrizzük, tudunk-e neveket meghatározni a rendszerkönyvtárakon kívül
- Eredmény: tudunk
- Teszt 3: futtassuk a rpm –V parancsot a libdns csomagon és az összes könyvtár md5sum fájlján
- Eredmény: a könyvtár kódja teljesen megegyezik a működő operációs rendszer kódjával
- Teszt 4: csatoljunk egy felhasználói gyökér rendszerképet a VM-be hasonló viselkedés nélkül, futtassuk a chroot-ot, nézzük meg, működik-e a DNS
- Eredmény: a DNS helyesen működik
A tesztek alapján levont következtetések: a hiba nem a könyvtárakban van
Hipotézis: Hiba van a DNS beállításaiban
- Teszt 1: ellenőrizzük a tcpdump-ot és figyeljük meg, hogy megfelelően küldik-e és térnek-e vissza a DNS csomagok a dig indítása után
- Eredmény: a csomagok helyesen továbbítódnak
- Teszt 2: ellenőrizzük a szerveren
/etc/nsswitch.confés/etc/resolv.conf - Eredmény: minden rendben van
A tesztek alapján levont következtetések: a hiba nem a DNS konfigurációban van
Hipotézis: a kernel megsérült
- Teszt: telepítsünk új kernelt, ellenőrizzük az aláírást, indítsuk újra
- Eredmény: hasonló viselkedés
A tesztek alapján levont következtetések: a kernel nem sérült
Hipotézis: a felhasználói hálózat (vagy a hipervizor hálózati interfésze) helytelenül működik
- Teszt 1: ellenőrizzük a tűzfal beállításait
- Eredmény: a tűzfal átengedi a DNS csomagokat, mind a gazdagépen, mind a GCP-n
- Teszt 2: fogjuk el a forgalmat és kövessük nyomon a DNS kérések helyes továbbítását és visszatérését
- Eredmény: a tcpdump megerősíti, hogy a gazdagép visszakapja a csomagokat
A tesztek alapján levont következtetések: a hiba nem a hálózatban van
Hipotézis: a metadat szerver nem működik
- Teszt 1: ellenőrizzük a metadat szerver logjait anomáliákra
- Eredmény: a logokban nincsenek anomáliák
- Teszt 2: Kerülje meg a metaadat-szervert a
dig @8.8.8.8 - Eredmény: a feloldás megszakad még a metaadat-szerver használata nélkül is
A tesztek alapján levont következtetések: a probléma nem a metaadat-szerverrel van
Összegzés: minden alközpontot teszteltünk, kivéve a futtatási környezet beállításait!
Mélyebbre merülve a magfuttatás beállításaiba
A magfuttatás beállításához használhatja a parancssori (grub) vagy a sysctl interfészt. Beléptem a /etc/sysctl.conf és csak képzelje, találtam néhány egyedi beállítást. Úgy éreztem, mintha valami fontosat fogtam volna meg, visszautasítottam minden nem hálózati vagy nem tcp beállítást, és csak néhány beállítással maradtam net.core. Ezután azon a helyen ellenőriztem, ahol a VM host engedélyei találhatók, és lépésről lépésre alkalmaztam a hibás VM beállításait, amíg végül rátaláltam a tettesre:
net.core.rmem_default = 2147483647Itt van, a DNS-konfigurációt tönkretevő beállítás! Megtaláltam a bűnjelet. De miért történik ez? Még mindig szükségem volt egy indokra.
A DNS csomagok alapméretének beállítása a net.core.rmem_default. A tipikus érték valahol 200KiB körül mozog, de ha a szervere sok DNS csomagot kap, akkor megnövelheti a buffer méretét. Ha új csomag érkezésekor a buffer tele van, például mert az alkalmazás nem dolgozza fel elég gyorsan, akkor csomagvesztést tapasztalhat. Ügyfelünk helyesen növelte meg a buffer méretét, mert adatvesztéstől tartott, mivel DNS csomagokkal gyűjtötte az adatokat. Az érték, amit beállított, a legmagasabb lehetett: 231-1 (ha 231-et állít be, a kernel „ÉRVÉNYTELEN ÉRVELÉS”-t küld vissza).
Hirtelen rájöttem, miért működtek jól az nmap és a scapy: nyers socketeket használtak! A nyers socketek eltérnek a hagyományosaktól: megkerülik az iptables-t, és nem bufferszálódnak!
De miért okoz problémákat a „túl nagy buffer”? Nyilvánvalóan nem úgy működik, ahogy azt elvárták.
Ekkorra képes voltam a problémát több kernel és sok disztribúció alatt is reprodukálni. A probléma már a 3.x kernel alatt megjelent, és most a 5.x kernel alatt is megmutatkozott.
Valóban, a következő parancs futtatásakor
sysctl -w net.core.rmem_default=$((2**31-1))a DNS leállt.
Elkezdtem egyszerű bináris keresési algoritmus segítségével keresni a működő értékeket, és felfedeztem, hogy a rendszer 2147481343-nál működik, de ez a szám számomra értelmetlen számjegyek halmaza volt. Javasoltam az ügyfélnek, hogy próbálja meg ezt a számot, és ő azt válaszolta, hogy a rendszer működött a google.com-mal, de más domaineknél még mindig hibát adott, ezért folytattam a nyomozást.
Telepítettem , egy eszközt, amit korábban érdemes lett volna használnom: megmutatja, hogy pontosan hová kerül a csomag a kernelben. A hibás a következő funkció volt: udp_queue_rcv_skb. Letöltöttem a kernel forráskódját, és hozzáadtam néhány nyomtatást, hogy nyomon kövessem, hová pontosan kerül a csomag. Gyorsan felfedeztem a szükséges feltételt, és egy ideig csak bámultam rá, mert akkor minden végre összeállt egy koherens képpé: 231-1, értelmetlen szám, nem működő domain... A probléma egy kódrészletben volt a if__udp_enqueue_schedule_skb if (rmem > (size + sk->sk_rcvbuf)) goto uncharge_drop;:
Figyeljen:rmem
típusú inttípusú u16 (nem előjelzett 16 bites int) és tárolja a csomag méretét.méretsk->sk_rcvbuftípusú int és tárolja a bufferméretet, amely a definíció szerint megegyezik ask_rcvbufnet.core.rmem_default
Amikor értékével, ami megközelíti a 231-et; a csomag méretének összege túllépheti a számítógépes túlcsordulást. A hiba triviálisan javítható: konvertálással a ).
. Alkalmaztam a javítást és újraindítottam a rendszert, utána a DNS ismét működött. unsigned intA győzelem íze
Megosztottam az eredményeimet az ügyféllel, és elküldtem neki a
LKML Elismerem, hogy az eset ritka volt, és szerencsére a felhasználóktól ritkán érkeznek hozzánk ennyire bonyolult bejelentések.
A Checkpoint Safe-Linking védelmi technikát ajánlott, amely megnehezíti a sebezhetőségek kihasználását.
Forrás: habr.com
