

Helló mindenkinek. Ebben a cikkben elmondom, miért választottuk a Kafka-t kilenc hónappal ezelőtt az Avitónál, és miről szól valójában. Megosztok egy gyakorlati példát a használatáról — üzenetközvetítő. Végül pedig beszélgessünk arról, milyen előnyöket szereztünk a Kafka as a Service megközelítés alkalmazásával.
Probléma
Először is, egy kis háttér. Néhány idővel ezelőtt elkezdtünk elmozdulni a monolitikus architektúrától, és most az Avitónál már több száz különböző szolgáltatás működik. Ezeknek saját tárolóik, saját technológiai stackjük van, és felelősek a saját üzleti logikájuk egy részéért.
Az egyik probléma a nagy számú szolgáltatással a kommunikáció. A szolgáltatás A gyakran szeretne információt kérni, amelyet a szolgáltatás B birtokol. Ebben az esetben a szolgáltatás A a szinkron API-n keresztül fordul a szolgáltatás B-hez. A szolgáltatás C szeretné tudni, mi történik a szolgáltatások D és E-nél, a D és E pedig érdeklődik az A és B szolgáltatások iránt. Amikor sok ilyen „kíváncsi” szolgáltatás van, a köztük lévő kapcsolatok kusza gubancsá válnak.
Eközben bármikor előfordulhat, hogy a szolgáltatás A nem elérhető. Mi a teendő ebben az esetben a szolgáltatás B-nek és minden egyéb, hozzá kapcsolódó szolgáltatásnak? Mi van, ha egy üzleti művelet végrehajtásához több szinkron hívás sorozata szükséges, a teljes művelet kudarcának valószínűsége még nagyobbá válik (és ez annál nagyobb, minél hosszabb ez a lánc).
Technológia választás
Oké, a problémák világosak. Ezeket meg lehet szüntetni, ha központosított üzenetváltó rendszert hozunk létre a szolgáltatások között. Most már minden szolgáltatásnak elég, ha ismeri ezt az üzenetváltó rendszert. Ezenkívül magának a rendszernek is hibátlanul működőnek és vízszintesen skálázhatónak kell lennie, és vészhelyzet esetén puffert kell tárolnia a későbbi feldolgozás érdekében.
Most válasszunk ki egy technológiát, amely megvalósítja az üzenetek kézbesítését. Ehhez először is értsük meg, mit várunk el tőle:
- az üzeneteknek a szolgáltatások között nem szabad elveszniük;
- az üzenetek megduplázódhatnak;
- az üzeneteket néhány napig lehet tárolni és olvasni (perzisztens puffert);
- a szolgáltatások feliratkozhatnak az érdekes adataikra;
- több szolgáltatás olvashatja ugyanazokat az adatokat;
- az üzenetek részletes, jelentős payload-ot tartalmazhatnak (event-carried state transfer);
- néha szükséges az üzenetek sorrendjének garantálása.
Számunkra kritikus volt, hogy a lehető legskálázhatóbb és megbízhatóbb rendszert válasszuk, megemelkedett áteresztőképességgel (legalább 100 ezer üzenet általában néhány kilobájt másodpercenként).
Ezért ezen a ponton elbúcsúztunk a RabbitMQ-tól (nehéz magas rps esetén stabilan fenntartani), a PGQ-tól a SkyTools-ból (nem elég gyors és nem skálázható jól) és az NSQ-tól (nem perzisztens). Mindezek a technológiák megtalálhatók a cégünkben, de a megoldandó feladathoz nem voltak megfelelőek.
Ezt követően elkezdtük nézni az új technológiákat számunkra — Apache Kafka, Apache Pulsar és NATS Streaming.
Elsőként elvetettük a Pulsar-t. Úgy döntöttünk, hogy a Kafka és a Pulsar viszonylag hasonló megoldások. Annak ellenére, hogy a Pulsar-t nagy cégek tesztelték, újabb és alacsonyabb késleltetést kínál (elméletben), úgy döntöttünk, hogy ebből a két megoldásból a Kafka marad a de facto standard ezen feladatokra. Valószínűleg a jövőben visszatérünk az Apache Pulsar-hoz.
Így hát két jelölt maradt: NATS Streaming és Apache Kafka. Mindkét megoldást alaposan megvizsgáltuk, és mindkettő megfelelt a feladatnak. Végül azonban tartottunk a NATS Streaming viszonylagos fiatalságától (és attól, hogy az egyik fő fejlesztő, Tyler Treat, úgy döntött, hogy elhagyja a projektet és sajátot indít — Liftbridge). Ezen kívül az NATS Streaming Clustering módja nem biztosít erős horizontális skálázást (valószínűleg már nem probléma, mivel a partícionálás mód 2017-ben került bevezetésre).
Mindazonáltal a NATS Streaming egy nagyszerű technológia, amely Go nyelven készült és támogatja a Cloud Native Computing Foundation-t. Az Apache Kafka-val ellentétben nem szükséges a Zookeeper a működéséhez (lehet, hogy ), mivel belül RAFT implementációt használ. Ezen kívül a NATS Streaming egyszerűbb az adminisztráció szempontjából. Nem zárjuk ki annak lehetőségét, hogy a jövőben újra visszatérünk ehhez a technológiához.
Mindazonáltal napjainkban a győztesünk az Apache Kafka lett. A tesztjeink során elég gyorsnak bizonyult (több mint egymillió üzenet másodpercenként olvasás és írás esetén, egyszóval 1 kilobájt terjedelmű üzenetekkel), megbízható, jól skálázható és nagy cégek által bevált volt a piacon. Ezen kívül a Kafka támogat minimum néhány nagy kereskedelmi céget (például mi a Confluent verzióját használjuk), valamint a Kafka kiterjedt ökoszisztémával rendelkezik.
A Kafka áttekintése
Mielőtt elkezdenénk, azonnal ajánlok egy nagyszerű könyvet — „Kafka: The Definitive Guide” (van orosz fordítás is, de a kifejezések kicsit zavaróak). Itt megtalálható az alapvető Kafka megértéséhez szükséges információ, és még egy kicsivel több. Az Apache dokumentáció és a Confluent blogja szintén jól meg van írva és könnyen olvasható.
Tehát nézzük meg, hogyan néz ki a Kafka madártávlatból. A Kafka alapvető topológiája a producer, consumer, broker és zookeeper.
Broker
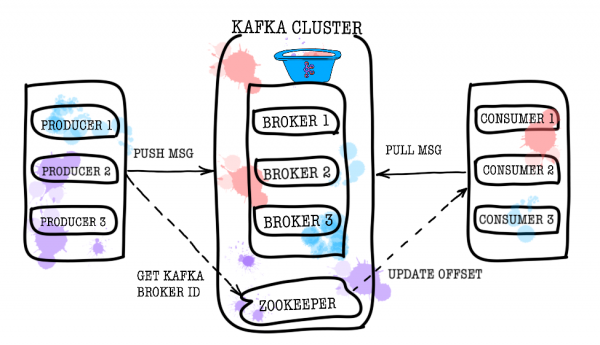
Az adatok tárolásáért a broker (broker) felel. Minden adat bináris formában van tárolva, és a broker nagyon keveset tud arról, hogy ezek mit is jelentenek és mi a struktúrájuk.
Minden logikai eseménytípus általában a saját külön topikjában (topic) található. Például a hirdetés létrehozásának eseménye az item.created topikba, míg a módosítás eseménye az item.changed topikba kerül. A topikokként osztályozhatók az események. A topik szintjén olyan konfigurációs paramétereket lehet beállítani, mint:
- a tárolt adatok mennyisége és/vagy életkoruk (retention.bytes, retention.ms);
- az adatok redundanciájának mértéke (replication factor);
- az egy üzenetre vonatkozó maximális méret (max.message.bytes);
- a minimális száma olyan szinkronizált replikáknak, amelyeknél adatokat lehet írni a topikba (min.insync.replicas);
- a lehetőség, hogy a nem szinkronizált, elmaradó replikára történő failover esetén potenciális adatvesztéssel (unclean.leader.election.enable);
- és még sok más ().
Viszont minden topik egy vagy több partícióra (partition) van felosztva. Az események végül a partíciókba kerülnek. Ha a klaszterben több mint egy broker van, a partíciókat a broker között egyenletesen osztják el (amennyire csak lehetséges), ami lehetővé teszi, hogy a terhelést egyszerre több brokerre skálázzuk írás és olvasás szempontjából egy topik tekintetében.
A lemezen az adatok minden partícióhoz szegmensfájlként tárolódnak, alapértelmezés szerint egy gigabyte méretben (log.segment.bytes vezérli). Fontos jellemző, hogy az adatok törlése a partíciókból (Retention megtörténése esetén) szegmensek szerint történik (nem lehet egy eseményt törölni a partícióból, csak egy teljes szegmenst, méghozzá csak az inaktívak közül).
Zookeeper
A Zookeeper a metadat tárolóként és koordinátorként funkcionál. Ő az, aki meg tudja mondani, hogy a brókerek élnek-e (azt a zookeeper szempontjából így nézheti meg: zookeeper-shell paranccsal ls /brokers/ids), melyik broker a vezérlő (get /controller), vajon a partíciók szinkronban vannak-e a replikáikkal (get /brokers/topics/topic_name/partitions/partition_number/state). Ezen kívül a producer és a consumer elsőként a zookeeperhez fordul, hogy megtudja, melyik broker hol tárolja a témákra és partíciókra vonatkozó információkat. Amikor a témához a replication factor értéke 1-nél nagyobb, a zookeeper megadja, hogy melyik partíciók a vezetők (itt történik a felvétel és innen olvasnak is). Ha a broker leáll, a zookeeper tárolja az új vezető partíciók információit (1.1.0 verziótól aszinkron módon, ).
A régebbi Kafka verziókban a zookeeper felelt az offsetek tárolásáért is, de most már ezt egy speciális témában tárolják __consumer_offsets a broker-en (bár továbbra is használhatja a zookeeper-t ezekre a célokra).
A legegyszerűbb módja, hogy az adatait tökökké változtassa, éppen a zookeeper információinak elvesztése. Ilyen esetben nehéz lesz megérteni, hogy mit és honnan kell olvasni.
Producer
A Producer általában az a szolgáltatás, amely közvetlenül az adatokat rögzíti az Apache Kafka-ba. A producer kiválaszt egy témát, ahol a tematikus üzeneteit tárolni fogja, és elkezdi rögzíteni az információkat. Például egy hirdetési szolgáltatás lehet producer. Ebben az esetben a tematikus témákba olyan eseményeket fog küldeni, mint „hirdetés létrehozva”, „hirdetés frissítve”, „hirdetés törölve” stb. Minden esemény egy kulcs-érték párt képvisel.
Alapértelmezés szerint minden eseményt round-robin módszerrel osztanak el a témák partíciói között, ha a kulcs nincs megadva (kialakítva a sorrend elvesztésével), és MurmurHash (kulcs) módszerrel, ha a kulcs meg van adva (sorrend megőrzése egy partíción belül).
Itt azonnal meg kell jegyezni, hogy a Kafka csak egy partíción belül garantálja az események sorrendjét. De valójában ez gyakran nem jelent problémát. Például minden változást biztosan egy partícióba lehet hozzáadni ugyanazon hirdetés keretein belül (így megőrizve a változások sorrendjét a hirdetésen belül). Azt is lehetővé lehet tenni, hogy egy sorszám kerüljön a mezők egyikébe az eseményben.
Consumer
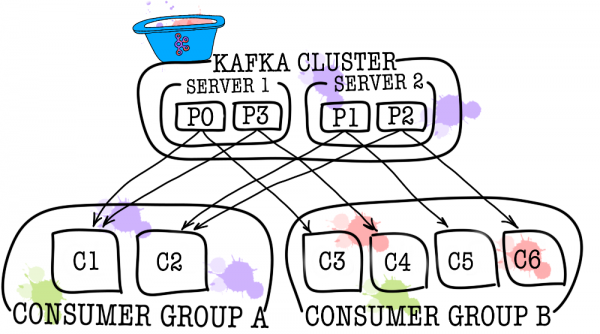
A vevő felelős az adatok beszerzéséért az Apache Kafka-ból. Ha visszatérünk a fenti példához, a vevő lehet például egy moderáló szolgáltatás. Ez a szolgáltatás fel lesz iratkozva a hirdetési szolgáltatás témájára, és amikor új hirdetés jelenik meg, megkapja és elemzi azt bizonyos előre meghatározott politikák szerint.
Az Apache Kafka megjegyzi, hogy a vevő milyen legutolsó eseményeket kapott (ehhez egy segéd témát használ __consumer__offsets), így garantálva, hogy a sikeres olvasás során a vevő nem kap ugyanazt az üzenetet kétszer. Ugyanakkor, ha az enable.auto.commit = true opciót használjuk, és teljesen rábízzuk a vevő pozíciójának nyomon követését a Kafka-ra, akkor lehet . A termelési kód esetében a vevő pozícióját gyakran manuálisan ellenőrzik (a fejlesztő kezeli azt az időpontot, amikor a beolvasott esemény kötelezően el kell köteleződnie).
Azokban az esetekben, amikor egy vevő nem elegendő (például ha az új események folyamatosan nagy mennyiségben érkeznek), további vevőket adhatunk hozzá, összekapcsolva őket egy vevő csoportban. A vevő csoport logikailag egy ugyanilyen vevőt képvisel, de az adatok részesedését a csoport tagjai között osztja el. Ez lehetővé teszi, hogy minden résztvevő a saját üzenetarányát vegye, ezáltal növelve az olvasási sebességet.
Tesztelési eredmények
Itt nem kívánok sok magyarázó szöveget írni, csak megosztom az eredményeket. A tesztelésre 3 fizikai gépen került sor (12 CPU, 384 GB RAM, 15k SAS DISK, 10 GBit/s Net), a broker-ek és a zookeeper lxc-ben lettek telepítve.
Teljesítménytesztelés
A tesztelés során a következő eredmények születtek.
- 1 KB méretű üzenetek írási sebessége 9 producer által együtt — 1300000 esemény másodpercenként.
- 1 KB méretű üzenetek olvasási sebessége 9 consumer által együtt — 1500000 esemény másodpercenként.
Hibalehetőség-tesztelés
A tesztelés során a következő eredmények születtek (3 broker, 3 zookeeper).
- Egy broker váratlan leállása nem vezet a klaszter leállításához vagy elérhetetlenségéhez. A munka zavartalanul folytatódik, de a megmaradt broker-ekre nagyobb terhelés hárul.
- Két broker váratlan leállása három brokerből álló klaszter esetén és min.isr = 2 a klaszter írása szempontjából elérhetetlenné válik, de olvasásra elérhető marad. Ha viszont min.isr = 1, a klaszter írásra és olvasásra is továbbra is elérhető. Ez a mód azonban ellentmond a magas adatvédelem követelményének.
- A Zookeeper egyik szerverének váratlan leállása nem vezet a klaszter leállításához vagy elérhetetlenségéhez. A működés zavartalanul folytatódik.
- Két Zookeeper szerver váratlan leállása a klaszter elérhetetlenségét eredményezi, amíg legalább az egyik Zookeeper szerver működése helyre nem áll. Ez az állítás igaz a 3 szerverből álló Zookeeper klaszterre. A kutatások eredményeként úgy döntöttünk, hogy a Zookeeper klasztert öt szerverre bővítjük a meghibásodás-ellenállás növelése érdekében.
Kafka mint szolgáltatás
Meggyőződtünk arról, hogy a Kafka egy nagyszerű technológia, amely lehetővé teszi számunkra a kitűzött cél (üzenetbroker megvalósítása) elérését. Ugyanakkor úgy döntöttünk, hogy megakadályozzuk a szolgáltatások közvetlen hozzáférését a Kafkához, ezért egy data-bus szolgáltatással fedtük el. Miért tettük ezt? Valójában több oka is van.
A data-bus átvette az összes feladatot, amely a Kafkával való integrációval kapcsolatos (consumer-ek és producer-ek megvalósítása és konfigurálása, monitorozás, riasztás, naplózás, skálázás stb.). Így az üzenetbrokerhez való integráció a lehető legegyszerűbbé válik.
A data-bus lehetővé tette, hogy elvonatkoztassunk a Kafkával való munkához használt konkrét nyelvtől vagy könyvtártól.
A data-bus lehetővé tette más szolgáltatások számára, hogy elvonatkoztassanak a tárolási rétegtől. Elképzelhető, hogy egy későbbi időpontban a Kafkát Pulsarra cseréljük, ekkor senki sem fogja észrevenni (mert minden szolgáltatás csak a data-bus API-ját ismeri).
A data-bus átvette az eseménysémák validálását.
A data-bus segítségével megvalósítottuk az autentikációt.
A data-bus keretein belül zökkenőmentesen, leállás nélkül frissíthetjük a Kafka verzióit, központosítva kezelhetjük a producer-ek, consumer-ek, broker-ek stb. konfigurációit.
A data-bus lehetővé tette számunkra, hogy olyan szükséges funkciókat adjunk hozzá, amelyeket a Kafka nem biztosít (például a témák auditálása, anomáliák ellenőrzése a klaszterben, DLQ létrehozása stb.).
A data-bus lehetővé teszi a központosított failover megvalósítását minden szolgáltatás számára.
Jelenleg elegendő egy kis könyvtárat csatlakoztatni a szolgáltatásunk kódjához az események küldésének megkezdéséhez. Ennyi az egész. Lehetőséget kap, hogy egy sor kóddal írjon, olvasson és méretezzen. Az egész megvalósítás el van rejtve Ön elől, csak néhány batch méretű kezelőfelület marad látható. A data-bus szolgáltatás a háttérben Kubernetes-en emel annyi producer és consumer példányt, amennyi szükséges, és átadja nekik a megfelelő konfigurációt, de mindez átlátható az Ön szolgáltatása számára.
Természetesen nincs ezüst golyó, és ennek a megközelítésnek is megvannak a maga korlátai.
- A data-bus-t saját erőforrásaival kell fenntartani, ellentétben a harmadik féltől származó könyvtárakkal.
- A data-bus növeli a kapcsolatokat a szolgáltatások és a broker között, ami teljesítménycsökkenéshez vezet a sima Kafka-hoz képest.
- Nem minden rejthető el így a szolgáltatások elől, nem szeretnénk a KSQL vagy a Kafka Streams funkciót a data-bus-ban megismételni, ezért néha engedélyezni kell, hogy a szolgáltatások közvetlenül kommunikáljanak.
A mi esetünkben az előnyök túlsúlyban voltak a hátrányokkal szemben, és a döntés, hogy a broker-t egy külön szolgáltatás mögé helyezzük, igazolódott. Egy évnyi üzemeltetés alatt nem volt komolyabb balesetünk vagy problémánk.
P.S. Köszönet a barátnőmnek, Ekaterina Obalayeva-nak, a cikkhez készült szuper képekért. Ha tetszettek, további illusztrációk is várnak.
Forrás: habr.com
