

Kifejlesztettük a dátaközponti hálózat designját, amely lehetővé teszi a 100 ezer szervert meghaladó számítási klaszterek telepítését, amelyek csúcsközi sávszélessége (bisection bandwidth) meghaladja az egy petabájt másodpercenként.
Dmitrij Afanaszev előadásából megtudhatja az új design alapelveit, a topológiák skálázását, a felmerülő problémákat, a megoldási lehetőségeket, a modern hálózati berendezések forwarding plane funkcióinak irányítási és skálázhatósági sajátosságait a sűrűn kapcsolt (densely connected) topológiákban sok ECMP-útvonal mellett. Ezen kívül Dima röviden beszélt a külső kapcsolatok szervezéséről, a fizikai szintről, a kábelrendszerről és a kapacitás további növelésének módjairól.
— Mindenkinek jó napot! A nevem Dmitrij Afanaszev, én vagyok a Yandex hálózati architektája, többnyire a dátaközpontok hálózatának tervezésével foglalkozom.
Az előadásom a Yandex frissített dátaközponti hálózatáról szól. Ez nagyrészt az előző design evolúciója, de van benne néhány új elem is. Ez egy áttekintő prezentáció, mert sok információt kellett sűríteni a rövid időkeretbe. A logikai topológia kiválasztásával kezdünk. Ezt követően áttekintjük a control plane-t és a data plane skálázhatósági problémáit, választunk, hogy mi történik a fizikai szinten, és megnézzük néhány berendezés sajátosságait. Egy kicsit érintjük az MPLS-t is a dátaközpontban, amiről nemrég beszéltünk.
Tehát, mi is a Yandex a terhelések és szolgáltatások szempontjából? A Yandex egy tipikus hiperskálázó. Ha a felhasználók irányába nézünk, először a felhasználói kérések feldolgozása történik. Emellett különböző streaming szolgáltatások és adatkiadás is zajlik, mert tárolószolgáltatásaink is vannak. Ha a háttérfelé nézünk, ott infrastrukturna terhelések és szolgáltatások jelennek meg, mint például elosztott objektumtárolók, adatmásolás, és természetesen tartós sorok. Az egyik fő terheléstípus a MapReduce és hasonló rendszerek, folyamatos feldolgozás, gépi tanulás stb.
Hogyan épül fel az infrastruktúra, amelyen mindez zajlik? Ismétlem, mi egy viszonylag tipikus hiperskálázó vagyunk, bár talán egy kicsit közelebb állunk ahhoz a spektrumhoz, ahol a kisebb hiperskálázók találhatók. De minden tulajdonságunk megvan. Olcsó hardvert használunk, és mindenhol alkalmazzuk a horizontális skálázást, ahol csak lehet. A forráspooling teljes mértékben jelen van nálunk: nem különálló gépekkel, különálló állványokkal dolgozunk, hanem egy nagy, kölcsönösen helyettesíthető erőforráskészletet alkotunk, egyes szolgáltatásokkal, amelyek a tervezést és az allokációt végzik, és együtt dolgozunk ezzel az egész készlettel.
Így jön létre a következő szint – a számítási klaszter szintű operációs rendszer. Nagyon fontos, hogy teljes mértékben ellenőrizzük a használt technológiai stack-et. Ellenőrizzük az végpontokat (hosztokat), a hálózatot és a szoftverstack-et.
Több nagy adatközpontunk van Oroszországban és külföldön. Ezeket egy MPLS technológiát használó backbone köti össze. A belső infrastruktúránk szinte teljes egészében IPv6-ra épül, de mivel külső forgalmat kell kiszolgálnunk, amely továbbra is nagyrészt IPv4-en érkezik, valahogyan el kell juttatnunk az IPv4-en érkező kéréseket a frontendhez,szerverek, és egy kicsit az IPv4 internet felé is kell menni – például az indexeléshez.
Az utolsó néhány adatközpont hálózati dizájniteráció több szintű Clos-topológiát használ, és csak L3-at alkalmaz. Már egy ideje távol tartózkodunk az L2-től, és megkönnyebbültünk. Végül is az infrastruktúránk több százezer számítási (szerver) instanciát foglal magában. A klaszter maximális mérete nemrég körülbelül 10 ezer szerver volt. Ez nagymértékben függ attól, hogy a klaszterszintű operációs rendszerek, ütemezők, erőforrás-allokáció és hasonlók hogyan működnek. Mivel az infrastruktúra szoftver oldalán előrelépés történt, most a cél a körülbelül 100 ezer szerver egy számítási klaszterben, és felmerült a feladat – olyan hálózati gyárakat építeni, amelyek lehetővé teszik az erőforrások hatékony poolingját egy ilyen klaszterben.
Mit mit is várnunk az adatközpont hálózatától? Először is, sok olcsó és kellően egyenletesen elosztott sávszélességre van szükségünk. Mert a hálózat az az alap, amelyen keresztül erőforrásokat tudunk poolingolni. Az új célméret körülbelül 100 ezer szerver egy klaszterben.
Természetesen egy skálázható és stabil control plane-re is szükségünk van, mert egy ilyen nagy infrastruktúrával már sok fejfájás származik akár véletlenszerű eseményekből is, és nem akarjuk, hogy a control plane újabb fejfájást okozzon nekünk. Eközben minimalizálni szeretnénk az állapotot benne. Minél kevesebb az állapot, annál jobban és stabilabban működik minden, és egyszerűbb a diagnosztika.
Természetesen automatizációra is szükségünk van, mert egy ilyen infrastruktúrát manuálisan kezelni lehetetlen, és már egy ideje lehetetlen is. Olyan mértékben kell támogatnunk az üzemeltetési tevékenységet és a CI/CD-t, amennyire csak lehetséges.
Ezekkel az adatközpontokkal és klaszterekkel egyre égetőbbé vált az igény az incrementális telepítés és a szolgáltatás megállása nélküli bővítés támogatására. Ha ezer gépből álló klasztereknél ez még viszonylag egyszerű volt, közel tízezer gépnél, ahol a bővítést egyetlen műveletként lehetett végrehajtani — például a végrehajtási infrastruktúra bővítésekor több ezer gépet egy műveletként adtak hozzá —, akkor egy száz ezer gépből álló klaszter nem azonnal alakul meg, hanem egy bizonyos idő alatt épül fel. Ideális esetben ezen idő alatt a már telepített infrastruktúra, ami már rendelkezésre áll, folyamatosan elérhető legyen.
És egy követelmény, amely nálunk volt és eltűnt: a multitenancy támogatása, tehát a virtualizáció vagy a hálózat szegmentálása. Most már nem kell ezt a hálózati gyár szintjén végezni, mert a szegmentálást a hostokra vittük, és ez nagyon megkönnyítette a skálázást. Az IPv6-nak és a nagy címterének köszönhetően nem kellett belső infrastruktúrában duplikált címeket használnunk, az összes címezés így is egyedi volt. Mivel a hálózati szűrést és szegmentálást a hostokra vittük, nem kellett virtuális hálózati entitásokat létrehoznunk az adatközponti hálózatokban.
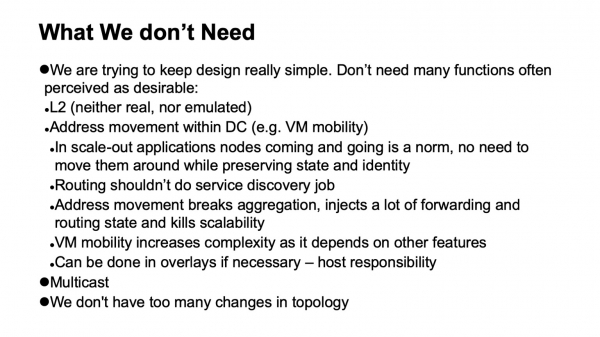
Egy nagyon fontos dolog, amire nincs szükségünk. Ha néhány funkció eltávolítható a hálózatról, az jelentősen megkönnyíti az életet, és általában szélesíti a rendelkezésre álló hardverek és szoftverek választékát, valamint nagyon leegyszerűsíti a diagnosztikát.
Tehát mi az, amire nincs szükségünk, amitől meg tudtunk szabadulni, nem mindig örömmel abban a pillanatban, amikor ez történt, de nagy megkönnyebbüléssel, amikor a folyamat befejeződött?
Elsősorban az L2 elhagyása. Nincs szükségünk valódi vagy emulált L2-re. Nem használjuk jelentős mértékben, mivel kontrolláljuk az alkalmazásvertek. Alkalmazásaink vízszintesen skálázhatók, L3 címzést használnak, nem nagyon aggasztja őket, ha egy különálló példány leáll, egyszerűen új verziót indítanak, ami nem szükséges az előző címre való frissítéshez, mert van egy külön szint a szolgáltatás felfedezésére és a klaszterben lévő gépek monitoringjára. Ezt a feladatot nem helyezzük át a hálózatra. A hálózat feladata az, hogy csomagokat szállítson A pontból B pontba.
Emellett nincsenek olyan helyzetek, amikor az címek elmozdulnak a hálózaton belül, amit nyomon kellene követni. Sok dizájnban ez általában szükséges a VM mobilitás fenntartásához. Mi nem használunk virtuális gépek mobilitását a nagy Yandex belső infrastruktúráján, és azon kívül úgy véljük, hogy ha ezt meg is kell valósítani, azt nem szabad a hálózat támogatásával megtenni. Ha nagyon szükséges, azt a hosztok szintjén kell megoldani, és az átvándorló címeket overlay-ekbe kell rakni, hogy ne érintsük a tényleges route rendszer dinamikus változásait.
Egy másik technológia, amit nem használunk, a multicast. Azoknak, akik érdeklődnek, részletesen elmagyarázhatom, hogy miért. Ez jelentősen megkönnyíti az életet, mivel ha valaki foglalkozott vele és látta, hogyan néz ki a multicast control plane — az összes telepítés esetében, kivéve a legegyszerűbbeket, ez nagy fejfájás. Ráadásul nehéz jól működő nyílt megvalósítást találni, például.
Végül, hálózatainkat úgy tervezzük, hogy ne történjen benne túl sok változás. Számíthatunk arra, hogy a külső események áramlása a routing rendszerben csekély.
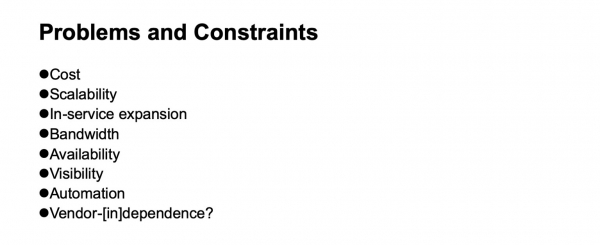
Milyen problémák merülnek fel, és milyen korlátokat kell figyelembe venni, amikor adatközponti hálózatot fejlesztenünk? Természetesen a költség. A skálázhatóság, hogy meddig szeretnénk növekedni. Szükség van a szolgáltatás megszakítása nélküli bővítésre. Sávszélesség, elérhetőség. A hálózatban zajló események láthatósága a monitorozó rendszerek és az üzemeltető csapatok számára. Az automatizálás támogatása — ismét, amennyire csak lehetséges, mivel különböző feladatokat különböző szinteken lehet megoldani, beleértve a kiegészítő rétegek bevezetését is. És a szállítóktól való függetlenség — bár különböző történelmi időszakokban, attól függően, hogy melyik szelet nézzük, ez a függetlenség könnyebben vagy nehezebben volt elérhető. Ha a hálózati eszközök chipjeit nézzük, akkor az utolsó időpontig nagyon feltételesen beszélhettünk a beszállítóktól való függetlenségről, ha nagy sávszélességű chipekre is szükségünk volt.
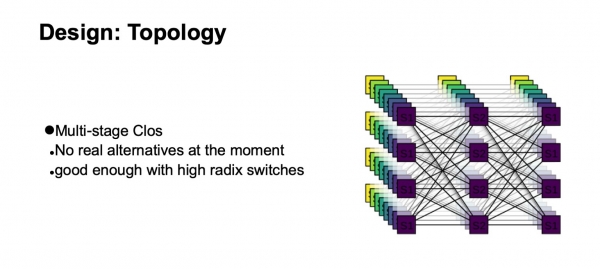
Milyen logikai topológia alapján építjük fel a hálózatunkat? Többlépcsős Clos lesz. Valójában jelenleg nincs valós alternatíva. A Clos-topológia elég jó, még akkor is, ha összehasonlítjuk különböző fejlett topológiákkal, amelyek most inkább az akadémiai érdeklődés területén találhatóak, feltéve, hogy nagy radixú switch-eket használunk.
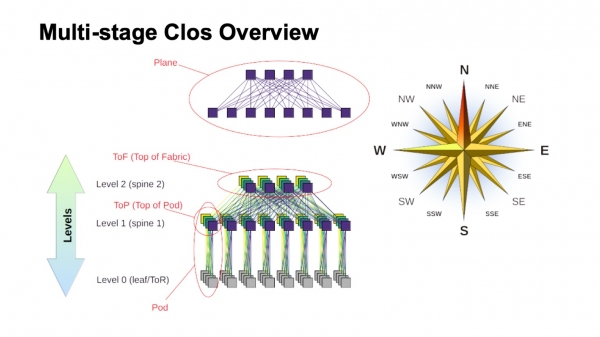
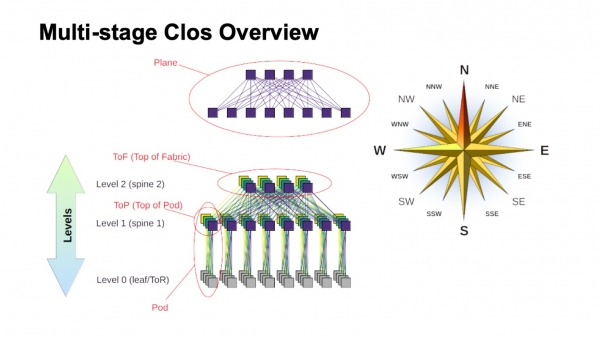
Hogyan épül fel egy többlépcsős Clos-hálózat, és hogyan nevezik az egyes elemeit? Először is, a szélrózsa, hogy orientálódjunk, hol van észak, hol van dél, hol van kelet, hol van nyugat. Az ilyen típusú hálózatot általában azok építik, akiknek nagyon nagy forgalma van nyugat-kelet irányban. Ami a többi elemet illeti, fent egy virtuális switch látható, amely kisebb switchekből összeállítva készült. Ez a rekurszív Clos-hálózatok építésének alapötlete. Olyan elemeket veszünk, amelyeknek van valamilyen radixuk, és összekötjük őket úgy, hogy az, ami keletkezik, egy nagyobb radixú switch-ként szemlélhető legyen. Ha még nagyobb szükséges, a folyamat megismételhető.
Például kétrétegű Clos hálózatok esetén, amikor egyértelműen kiemelhetjük a vertikális elemeket a diagramomon, ezeket a síkoknak nevezzük. Ha három szintű spine switch-ekkel építenénk Clos-t (az összes, ami nem határolt és nem ToR switch, és csak tranzit céljára használják), akkor a síkok bonyolultabbak lennének, a kétrétegűek éppen ilyenek. A ToR- vagy leaf switch-ek blokkját és az első szintű spine switch-eket Pod-nak nevezzük. A spine-1 szintű spine switch-ek a Pod tetején a Pod tetejét jelentik. Azok a switch-ek, amelyek az egész fabric tetején helyezkednek el – ez a fabric teteje, azaz a Top of fabric.
Természetesen felmerül a kérdés: a Clos hálózatokat már egy ideje építik, maga az ötlet az klasszikus telefonhálózatokból, TDM hálózatokból származik. Talán van valami jobb, talán lehetne valahogy jobban csinálni? Igen és nem. Elméletileg igen, de a gyakorlatban a közeljövőben biztosan nem. Mert van egy kis számú érdekes topológia, amelyek közül néhány már alkalmazásban van, például a Dragonfly, amelyet HPC-alkalmazásokban használnak; vannak érdekes topológiák, mint az Xpander, FatClique, Jellyfish. Ha megnézzük az olyan konferenciák, mint a SIGCOMM vagy az NSDI legutóbbi előadásait, észlelhetjük, hogy elég nagy számú munka található alternatív topológiákról, amelyek kedvezőbb tulajdonságokkal bírnak (ilyen vagy olyan) mint a Clos.
De mindezeknek a topológiáknak van egy érdekes tulajdonsága. Ez megakadályozza, hogy bevezessük őket az adatközponti hálózatokban, amelyeket commodity hardveren próbálunk építeni, és amelyek értékeelfogadható költségek mellett van. Mindezekben az alternatív topológiákban a sávszélesség nagy része sajnos nem a legrövidebb utakon érhető el. Ezért azonnal megfoszt minket a hagyományos control plane használatának lehetőségétől.
Elméletileg a feladat megoldása ismert. Például a link state módosításai k-shortest path használatával, de ismét, nincsenek olyan protokollok, amelyek megvalósításra kerültek volna a gyakorlatban és tömegesen elérhetők lennének a berendezéseken.
Ráadásul, mivel a kapacitás nagy része nem a legrövidebb utakon érhető el, nemcsak a vezérlési síkot kell módosítanunk, hogy az minden ilyen utat kiválasszon (és egyébként ez jelentősen nagyobb állapot a vezérlési síkon). A forwarding síkot is módosítanunk kell, és általában legalább két további funkció szükséges. Az egyik a csomagok forwarding döntéseinek egyidejű meghozatala, például a hoszton. Valójában ez az úgynevezett forrás routing, amit néha az interconnection networks irodalmában all-at-once forwarding decisions-nek hívnak. A másik pedig az adaptív routing — ez már egy olyan funkció, amelyre a hálózati elemeknél van szükség, például azt jelenti, hogy a következő ugrást a legkisebb terhelés alapján választjuk ki. Például más lehetőségek is felmerülhetnek.
Így tehát az irány érdekes, de sajnos most nem tudjuk alkalmazni.
Oké, megállapodtunk a logikai Clos-topológián. Hogyan fogjuk méretezni? Nézzük meg, hogyan van felépítve, és mit lehet tenni.
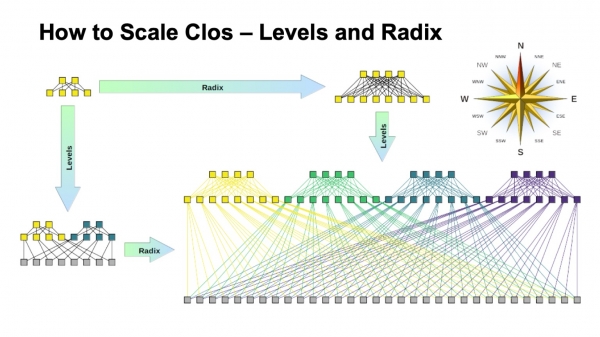
A Clos-hálózatban két alapvető paraméter van, amelyet valahogyan változtathatunk, hogy eltérő eredményeket érjünk el: az elemek radix-e és a hálózat szintjeinek száma. Vázlatosan meg van ábrázolva, hogy mindkettő hogyan befolyásolja a méretet. Ideálisan a kettőt kombináljuk.
Látható, hogy a Clos-hálózat végső szélessége a spine switch-ek dél-irányú radixainak szorzataként jelenik meg, attól függően, hogy hány linkünk van lefelé és hogyan ágazik el. Így méretezzük a hálózat méretét.
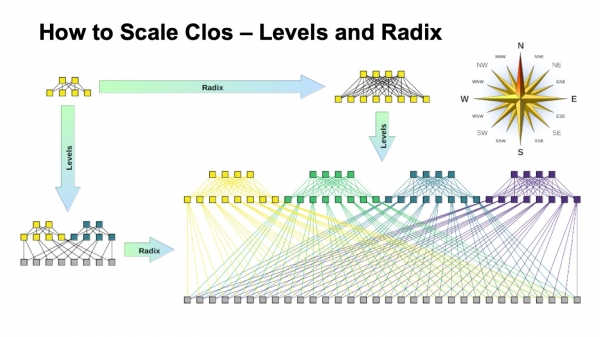
Ami a kapacitást illeti, különösen a ToR switch-eken, itt két skálázási lehetőség van. Vagy megtarthatjuk az általános topológiát, de gyorsabb linkeket használunk, vagy több síkot adhatunk hozzá.
Ha megnézzük a kibővített Clos-hálózat verzióját (a jobb alsó sarokban) és visszatérünk ehhez a Clos-hálózathoz alul...
... akkor ez pontosan ugyanaz a topológia, de ezen a dián kompaktabban van összehúzva, és a gyár síkjai egymásra vannak helyezve. Ez ugyanaz.
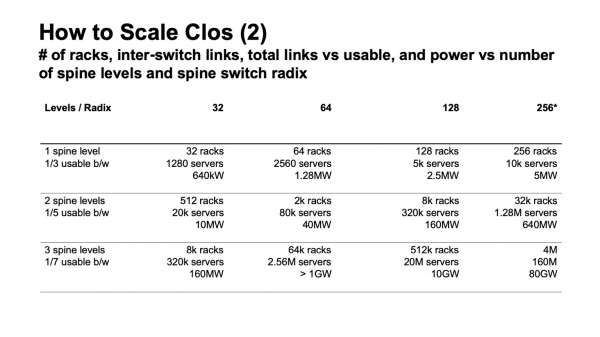
Hogyan néz ki a Clos-hálózat méretezése számokban? Itt van adat arról, hogy mekkora maximális szélességet érhetünk el a hálózattal, hány racket, ToR switch-et vagy leaf switch-et kaphatunk, ha nem állnak rackekben, attól függően, hogy milyen radix switch-eket használunk a spine szinteken, és hány szintet használunk.
Itt látható, hány állványunk lehet, hány szerver, és körülbelül mennyit fogyaszthat mindez, ha 20 kW-ot számolunk állványonként. Korábban említettem, hogy a klaszter mérete körülbelül 100 ezer szerverre összpontosítunk.
Látható, hogy ennek az építménynek a két és fél variánsa van. Van egy változat két réteg spájnnal és 64-portos switchekkel, ami kissé alulmarad. Aztán remekül illeszkedő lehetőségek vannak a 128-portos (128-as radixszal) spájnswitekre két szinten, vagy a 32-es radixú switchekre három szinten. Minden esetben, ahol a radix és a szintek száma nagyobb, nagyon nagy hálózatot lehet létrehozni, de ha megnézzük a várható fogyasztást, akkor általában gigawattokról van szó. Kábelt lehet fektetni, de ennyi elektromosságot egy helyszínen valószínűleg nem tudunk biztosítani. Ha megnézzük a statisztikákat, a nyilvános adatokat az adatközpontokról — nagyon kevés olyan adatközpont található, amelynek tervezett kapacitása meghaladja a 150 MW-t. Ami nagyobb, az általában adatközpont-campusok, több nagy adatközpont, amelyek viszonylag közel helyezkednek el egymáshoz.
Van még egy fontos paraméter. Ha megnézi a bal oszlopot, ott van feltüntetve a használható sávszélesség. Nem nehéz észrevenni, hogy a Clos-hálózatban a portok jelentős része az switch-ek összekapcsolására megy el. A használható sávszélesség az, amit a szerverek felé kiadhatunk. Természetesen feltételes portokról és a sávszélességről beszélek. Általában a hálózaton belüli linkek gyorsabbak, mint a szerverek felé vezető linkek, de a sávszélesség egy egységére, amit a szerverparkhoz tudunk biztosítani, a hálózaton belül is szükség van sávszélességre. Minél több szintet csinálunk, annál nagyobb a költség, amit a sávszélesség külső biztosítására fordítunk.
Továbbá, még ez a kiegészítő sávszélesség sem egészen egyenletes. Amíg a távok rövidek, használhatunk DAC-t (direct attach copper, tehát twinax kábelek) vagy multimódus optikát, ami még viszonylag ésszerű árban van. Ahogy hosszabb távokra kerülünk — általában ez a single mode optika, és a kiegészítő sávszélesség költsége jelentősen megnő.
Ismét utalva az előző diára, ha Clos-hálózatot építünk átírás nélkül, nem nehéz megnézni a sémát, és megfigyelni, hogyan épül a hálózat - minden egyes szintű spine switch hozzáadásával megismételjük az alsó sávot. Ráadásul minden szint - plusz az azonos nagy sáv - annyi porttal a kapcsolókban, amennyi volt az előző szinten, plusz annyi transceiver. Ezért kívánatos minimalizálni a spine switch-ek szintjeinek számát.
Ebből a képből látszik, hogy nagyon szeretnénk valamilyen 128-as radixú kapcsolóra építkezni.
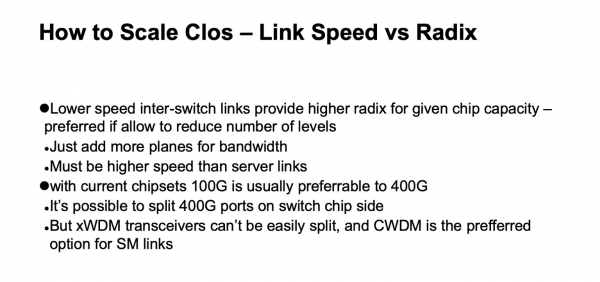
Itt tulajdonképpen ugyanez van, amit most elmondtam, ez a dia inkább későbbi átnézésre készült.
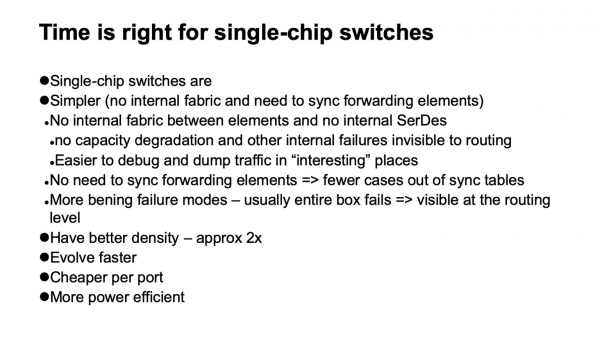
Milyen lehetőségek vannak arra, hogy milyen kapcsolókat választhatunk? Nagyon jó hír számunkra, hogy most már ezeket a hálózatokat végre lehet építeni egychip-es kapcsolókkal. Ez nagyon klassz, rengeteg kellemes jellemzőjük van. Például szinte nincs belső struktúrájuk. Ez azt jelenti, hogy egyszerűbben elromlanak. Elromlanak, hová is hallanánk ezt, de ami a szerencsénk, teljes mértékben elromlanak. A moduláris berendezésekben rengeteg kellemetlen meghibásodás van, amikor a szomszédok és a vezérlő sík szempontjából működik, de például egy rész elveszett a gyárból, és nem működik teljes kapacitással. A rá irányított forgalmat úgy egyensúlyozzák ki, hogy teljesen funkcionálisnak tűnik, és túltöltődhet.
Vagy például problémák merülhetnek fel a backplane-nel, mert a moduláris berendezésen belül is vannak nagy sebességű SerDes-ek - igazán bonyolult belső szerkezettel rendelkezik. Vagy a forwarding elemek között szinkronizálódnak, vagy nem szinkronizálódnak a táblázatok. Összességében bármilyen nagy teljesítményű moduláris eszköz, amely sok elemből áll, általában tartalmazza a Clos-hálót, csak éppen azt nagyon nehéz diagnosztizálni. Gyakran még a gyártónak is nehéz diagnosztizálnia.
És ennek számos hibaforrása van, amelyeknél az eszközök megromlanak, de nem esnek ki teljesen a topológiából. Mivel a hálózatunk nagy, aktívan használunk terheléselosztást az azonos elemek között, a hálózat nagyon szabályos, tehát egy olyan út, ahol minden rendben van, nem különbözik semmiben a másik úttól, előnyösebb számunkra egyszerűen elveszíteni néhány eszközt a topológiából, mint egy olyan helyzetbe kerülni, amikor egyesek úgy tűnik, hogy működnek, de nem.
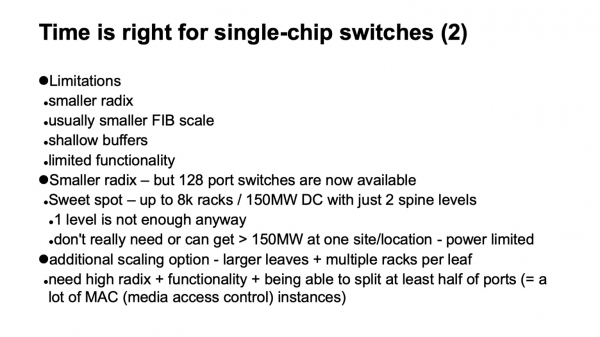
A következő kellemes tulajdonsága az egységes chip-eszközöknek, hogy jobban evolválódnak, gyorsabban. Rendszerint jobb kapacitással is rendelkeznek. Ha figyelembe vesszük a nagyobb összeszerelt konstrukciókat, amelyek nálunk vannak, a rack-egységenkénti kapacitás a portoknál ugyanazon sebesség mellett majdnem kétszer jobb, mint a moduláris eszközöknél. Az egy chip köré épített eszközök jelentősen olcsóbbak, mint a modulárisak, és kevesebb energiát fogyasztanak.
De természetesen mindez nem ingyen van, vannak hátrányai is. Először is, szinte mindig kisebb a radix, mint a moduláris eszközöknél. Ha egy, egy chip köré épített eszközt 128 porttal tudunk megcsinálni, akkor modulárisat már több száz porttal tudunk létrehozni, különösebb probléma nélkül.
Ez észrevehetően kisebb méretű forwarding táblákat eredményez, és jellemzően minden, ami a data plane skálázhatóságával kapcsolatos. Shallower buffer. És általában meglehetősen korlátozott funkcionalitás. De kiderül, hogy ha tudjuk ezeket a korlátokat, és időben gondoskodunk arról, hogy megkerüljük vagy csak figyelembe vegyük őket, akkor ez nem olyan ijesztő. Az, hogy a radix kisebb, a nemrégiben megjelent eszközöknél 128 már nem jelent problémát, tudunk építkezni két spájvonalon. És kevesebb mint két semmilyen érdekes méretet nem lehet egyáltalán felépíteni. Egyetlen szinten a nagyon apró klaszterek alakulnak ki. Még a korábbi dizájnjaink és követelményeink is meghaladták őket.
Valójában, ha véletlenül a megoldás valahol határeset, van még egy lehetőség a skálázásra. Mivel az utolsó (vagy első), legalsó szint, ahová a szerverek csatlakoznak — ToR kapcsolók vagy leaf kapcsolók, nem vagyunk kötelesek egy racket csatlakoztatni hozzájuk. Tehát, ha a megoldás valahol kétszeres erősségű, érdemes megfontolni, hogy egyszerűen használjunk egy nagyobb radixsu kapcsolót az alsó szinten, és például két-három racket csatlakoztassunk egy kapcsolóhoz. Ez is egy lehetőség, ennek is megvannak a maga költségei, de jól működhet, és jó megoldás lehet, amikor kétszeres méretet kell elérni.
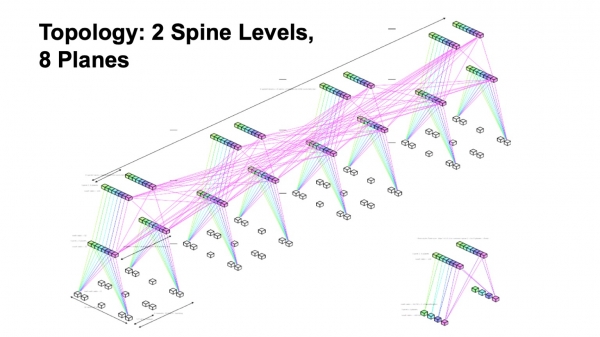
Összefoglalva, olyan topológiát építünk ki, amely két szintű spine-ből áll, nyolc gyártréteggel.
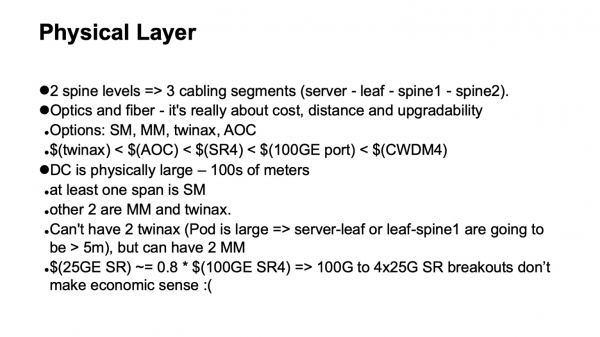
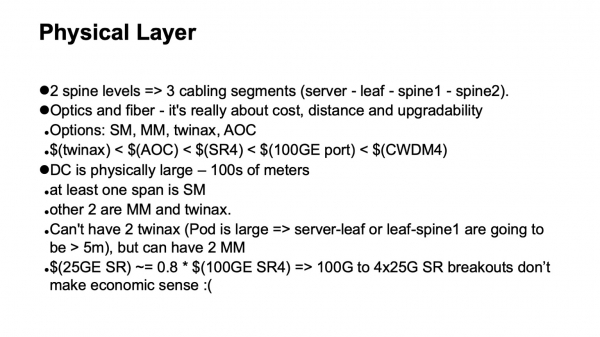
Mi lesz a fizikával? Nagyon egyszerű számítások. Ha két szintű spine van, akkor összesen három szint kapcsolónk van, és azt várjuk, hogy a hálózatban három kábel szegmens lesz: a szerverektől a leaf kapcsolókig, az 1-es spine-ig, a 2-es spine-ig. Azok a lehetőségek, amit használhatunk — twinax, multimód, egymód. Itt figyelembe kell venni, hogy mekkora sávszélesség áll rendelkezésre, mennyibe fog kerülni, mik a fizikai méretek, milyen távolságokat tudunk megtenni, és hogyan fogunk fejleszteni.
Ár szempontjából mindent egy sorba tudunk állítani. A twinaxok érzékelhetően olcsóbbak, mint az aktív optika, olcsóbbak, mint a multimód transceiverek, ha a végponttól nézzük, némileg olcsóbbak, mint a 100 gigabites kapcsoló port. És, figyelem, olcsóbbak, mint az egymódú optika, mert azon a szakaszon, ahol egymód szükséges, az adatközpontokban számos okból értelmes CWDM-et használni, a párhuzamos egymód (PSM) nem igazán kényelmes, nagyon nagy szálcsomagok keletkeznek, és ha ezeknél a technológiáknál maradunk, akkor körülbelül ilyen árhierarchia alakul ki.
Még egy megjegyzés: sajnos nem igazán működik a felosztott 100 k 4x25 multimód portok használata. A SFP28 transceiverek konstrukciójának sajátosságai miatt nem sokkal olcsóbb, mint a QSFP28 100 Gbit-re. És ez a felosztás a multimód számára nem igazán működik.
Egy további korlátozás, hogy a számítási klaszterek mérete és a szerverek száma miatt adatközpontjaink fizikailag nagyok. Ez azt jelenti, hogy legalább egy nyílást egyes üzemmódban kell készíteni. Ismét, a Pods fizikai mérete miatt nem lehet két nyílást twinax kábelekkel átvinni.
Végül, ha ár szempontjából optimalizálunk és figyelembe vesszük ennek a struktúrának a geometriáját, egy nyílást kapunk twinax-kábel használatával, egy nyílást multimódúval és egy nyílást egyes üzemmóddal CWDM alkalmazásával. Ez figyelembe veszi a lehetséges frissítési utakat.
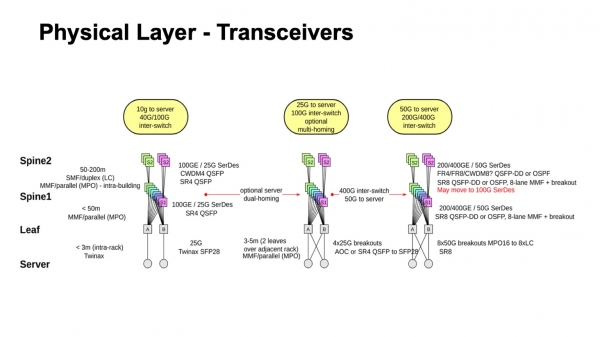
Így néz ki körülbelül, ami nemrég történt, hová haladunk és mi lehetséges. Egyértelmű, hogy legalábbis a 50 gigabites SerDes felé haladhatunk, mind a multimódú, mind az egyes üzemmód számára. Ráadásul, ha megnézzük, mi van jelenleg az egyes üzemmódú transzceiver-ekben és a jövőben a 400G esetében, gyakran előfordul, hogy amikor a 50G SerDes-ek megérkeznek a villamos oldalon, az optikában már 100 Gbps per lane sebességgel távoznak. Tehát valószínű, hogy a 50 gigabites váltás helyett 100 gigabites SerDes-re és 100 Gbps per lane-re váltás várható, mert sok gyártó ígérete szerint ezek hozzáférhetősége elég hamar várható. A 50G SerDes-ek voltak a leggyorsabbak, úgy tűnik, nem tartanak túl sokáig, mivel a 100G SerDes-ek első példányai gyakorlatilag a következő évben debütálnak. És egy idő után valószínűleg ésszerű áron is elérhetők lesznek.
Egy további szempont a fizikai választásban. Elvileg már most is alkalmazhatunk 400- vagy 200 gigabites portokat 50G SerDes-ek használatával. De kiderül, hogy ennek nincs különösebb értelme, mert, ahogy korábban elmondtam, szeretnénk elegendő radixot a switchekben, természetesen ésszerű keretek között. 128-at szeretnénk. Ha a chip kapacitása korlátozott, és növeljük a link sebességét, akkor a radix természetesen csökken, ami nem varázslat.
Összességében a kapacitást a síkok számának növelésével tudjuk fokozni, és ebben különösebb költségek nincsenek, növelhetjük a síkok számát. Ha elveszítjük a radixot, akkor egy további szintet kell bevezetnünk, ezért a jelenlegi számok mellett, a maximálisan elérhető kapacitással egy chip esetében, kiderül, hogy hatékonyabb 100 gigabites portokat használni, mert ezek nagyobb radixot biztosítanak.
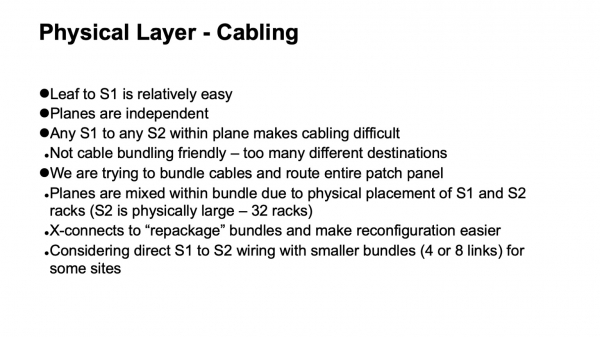
A következő kérdés a fizikai infrastruktúra szervezésével kapcsolatos, de már a kábel-infrastruktúra szemszögéből. Kiderül, hogy ez meglehetősen szórakoztató módon van megszervezve. A leaf switch-ek és az első szintű spine-ok közötti kábelezésnél nem sok link van, ott minden viszonylag egyszerűen van felépítve. Viszont ha egy síkot nézünk, akkor, ami belül történik – ott minden első szintű spine-t össze kell kötni a második szintű spine-okkal.
Ráadásul általában vannak bizonyos kívánságok azzal kapcsolatban, hogy hogyan kellene kinéznie az adatközpont belsejének. Például számunkra nagyon fontos volt, hogy a kábeleket kötegbe vonjuk, és úgy vezessük őket, hogy egy magas sűrűségű patch panelek egy az egyhez menjenek egy másik patch panelhez, elkerülve ezzel a káoszt a hosszúságokban. Ezt a feladatot sikerült megoldanunk. Ha kezdetben megnézzük a logikai topológiát, látható, hogy a síkok függetlenek, mindegyik sík önállóan építhető. De amikor ilyen bundlingot adunk hozzá, és teljesen egy patch panelt szeretnénk egy másik patch panelhez vinni, akkor a bundlen belül különböző síkokat kell kevernünk, és be kell vezetni egy köztes konstrukciót optikai cross-connectek formájában, hogy újra csomagoljuk őket attól függően, hogy hogyan álltak össze az egyik szegmensen, és hogy hogyan fognak összeállni egy másik szegmensen. Ennek köszönhetően egy kellemes tulajdonsággal rendelkezünk: az összes bonyolult kapcsolás a rack határain belül marad. Amikor valamit nagyon összezavarna, „kibővíteni a síkokat”, ahogy azt néha a Clos-hálózatokban nevezik, minden egyetlen racken belül összpontosul. Nincsenek nagyon szétszedett, egyedi linkek közötti kapcsolások a rackek között.
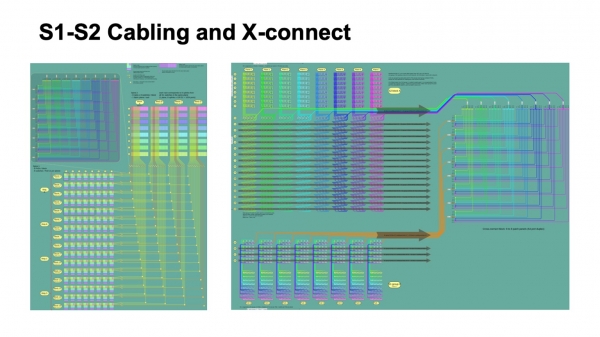
Így néz ki a kábel-infrastruktúra logikai szervezésének szempontjából. A bal oldali képen a színes blokkok az első szintű spine switch-ek blokkjait ábrázolják, nyolc darabot, és az ezekből induló négy kábelköteg, amelyek keresztezik a spine-2 switch-ek blokkjait.
A kis négyzetek a kereszteket jelölik. A bal felső sarokban látható minden ilyen kereszteződés kidolgozása valójában egy 512x512 portos cross-connect modul, amely a kábeleket úgy csomagolja, hogy az összes egy állványba érkezzen, ahol csak egy spine-2 sík van. Jobbra pedig ennek a képeknek egy kicsit részletesebb kidolgozása látható néhány Pods vonatkozásában a spine-1 szinten, és hogy ez hogyan van csomagolva a cross-connectben, hogyan érkezik a spine-2 szintre.
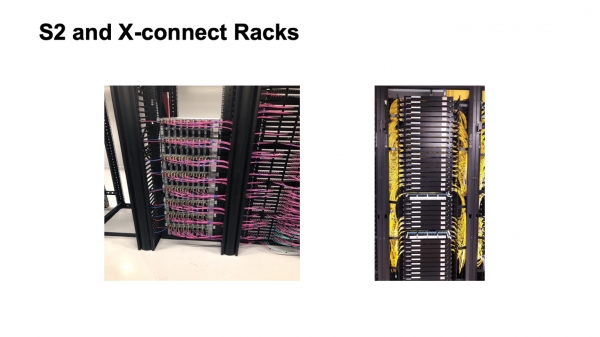
Így néz ki. A spine-2 állvány (balra) és a cross-connect állvány még nem teljesen összeállítva. Sajnos, nem túl sok minden látható. Ez az egész konstrukció jelenleg egyike a nagy adatközpontjainknak, amely bővül. Ez egy folyamatban lévő munka, szebbé fog válni, jobban ki lesz töltve.
Fontos kérdés: kiválasztottuk a logikai topológiát, felépítettük a fizikát. Mi lesz a control plane-nel? A működés tapasztalatából jól ismert, hogy van egy bizonyos számú megjelenés, amely szerint a link state protokollok jók, és szívesen dolgozunk velük, de sajnos a sűrűn kötött topológián rosszul skálázódnak. És van egy fő tényező, amely ezt megakadályozza — ez a flooding működése a link state protokollokban. Ha egyszerűen megnézzük a flooding algoritmust, és nézzük, hogyan van felépítve a hálózatunk, akkor látható, hogy minden lépésnél nagyon nagy fanout lesz, és egyszerűen elárasztja a control plane-t frissítésekkel. Ezek a topológiák, amelyek a hagyományos flooding algoritmussal rendelkeznek a link state protokollokban, nagyon rosszul keverednek.
A választás — BGP használata. Hogy ezt hogyan kell megfelelően előkészíteni, azt az RFC 7938 leírja a BGP nagy adatközpontokban történő használatára. Az alapvető ötletek egyszerűek: a lehető legkevesebb prefix a gazdagépen és a hálózatban általában, aggregáció használata, ha lehetséges, és a path hunting elnyomása. Nagyon óvatos, nagyon kontrollált frissítések terjesztésére van szükségünk, amit valley free-nek neveznek. Azt akarjuk, hogy a frissítések a hálózán keresztül egyszer terjedjenek. Ha alul keletkeznek, akkor felfelé mennek, és legfeljebb egyszer terjednek. Nem szabad zig-zaggá alakulni. A zig-zagok nagyon rosszak.
Ennek érdekében egy viszonylag egyszerű sémát alkalmazunk, hogy használjuk az alap BGP mechanizmusokat. Vagyis az eBGP-t használjuk, amely a link helyi kapcsolatra épül, és az autonóm rendszereket a következőképpen rendeljük hozzá: egy autonóm rendszer a ToR-on, egy autonóm rendszer az egy Pod összes spajn-1 kapcsolójának blokkjához, és egy közös autonóm rendszer az egész Top of Fabric esetében. Nem nehéz megnézni és megbizonyosodni arról, hogy ebben az esetben még a BGP normál viselkedése is megadja nekünk azt a frissítési terjedést, amire szükségünk van.
Természetesen az címzés és a címek összegyűjtése úgy van megtervezve, hogy kompatibilis legyen a routing felépítésével, biztosítsa a control plane stabilitását. Az L3 címzés a szállításon belül a topológiához van kötve, mert nélküle nem tudjuk elérni az aggregációt, különben az egyedi címek be fognak jutni a routing rendszerbe. És még egy dolog — az aggregáció, sajnos, nem jól keveredik a multi-path-szal, mert amikor van multi-path és aggregáció, minden rendben van, amikor az egész hálózat működőképes, nincsenek kiesések. Sajnos, amint a hálózatban kiesések lépnek fel és a topológia szimmetriája elveszik, eljuthatunk arra a pontra, ahonnan az aggregátumot bejelentették, ahonnan nem tudunk tovább haladni oda, ahová szükségünk van. Ezért az aggregációt legjobban ott érdemes végezni, ahol nincs többé multi-path, az esetünkben ez a ToR kapcsolók.
Valójában aggregálni lehet, de óvatosan. Ha képesek vagyunk kontrollált de-aggregációt végezni, amikor kiesések merülnek fel a hálózatban. De ez egy viszonylag bonyolult feladat, még mi is mérlegeltük, hogy lehetséges-e ezt megvalósítani, lehet-e automatikát és végállapot gépeket hozzáadni, amelyek megfelelően ütik a BGP-t a kívánt viselkedés eléréséhez. Sajnos a sarkalatos esetek kezelése nagyon nem egyértelmű és bonyolult, és a BGP-hez csatlakoztatott külső berendezés ezt a feladatot jól nem oldja meg.
Nagyon érdekes munka készült ebben a tekintetben az RIFT protokoll keretein belül, amelyről a következő előadásban fognak beszélni.
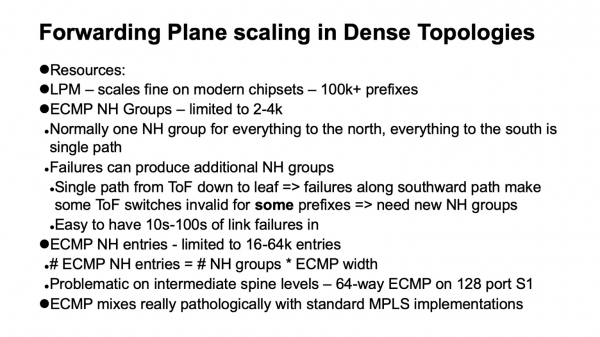
Egy másik fontos dolog, hogy hogyan skálázódnak a data plane sűrű topológiákban, ahol nagy mennyiségű alternatív útvonal van. Ehhez néhány további adatszerkezetet használnak: ECMP csoportokat, amelyek viszont a Next Hop csoportokat írják le.
A normálisan működő hálózatban, zavarok nélkül, amikor a Clos-topológián felfelé haladunk, elegendő csak egy csoportot használni, mert minden, ami nem lokális, alapértelmezés szerint van leírva, lehet felfelé haladni. Amikor fentről lefelé haladunk dél felé, akkor minden út nem ECMP, ez egyetlen útvonal. Minden rendben van. A probléma ezzel, és a klasszikus Clos-topológia sajátossága, hogy ha a szövet tetejére nézünk, bármely elemhez, bármely alábbi elemhez egy út vezet. Ha ezen az úton zavarok lépnek fel, akkor az adott elem a szövet tetején érvénytelen lesz azok számára a prefixek számára, amelyek a sérült út mögött találhatóak. A többi számára érvényes, és le kell bontanunk az ECMP csoportokat, és új állapotot kell bevezetnünk.
Hogyan néz ki a data plane skálázhatósága a modern eszközökön? Ha LPM-t (longest prefix match) végzünk, az egész jól működik, 100k prefix fölött. Ha a Next Hop csoportokról beszélünk, akkor rosszabb a helyzet, 2-4 ezer. Ha a táblázatról beszélünk, amely a Next Hopok (vagy a szomszédok) leírását tartalmazza, az valahol 16k-tól 64k-ig terjed. És ez problémává válhat. Itt érkezünk egy érdekes kitérőhöz: mi történt az MPLS-szel az adatközpontokban? Alapvetően szeretnénk elkészíteni.
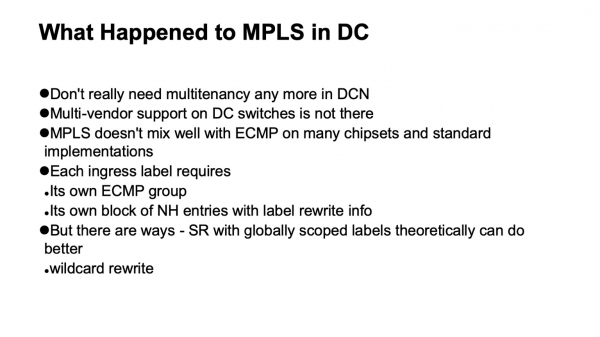
Két dolog történt. Mikro-szegmentációt végeztünk a hosztokon, ezért nem volt szükségünk arra, hogy ezt a hálózaton végezzük. Nem volt túl jó a különböző gyártók támogatása, és különösen a nyílt megvalósítások a white box-okkal és az MPLS-szel. Emellett az MPLS, legalábbis a hagyományos megvalósításai, sajnos nagyon rosszul illeszkednek az ECMP-hez. És ez az oka.
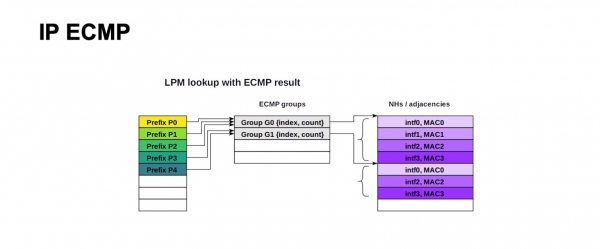
Így néz ki az ECMP-átirányítás struktúrája IP esetén. Nagy számú prefix használhatja ugyanazt a csoportot és ugyanazt a Next Hop blokkját (vagy szomszédságokat, a különböző dokumentációkban differentes nevével hivatkozhatnak rá). A lényeg az, hogy úgy van leírva, mint a kimenő port, és mire kell átírni a MAC-címet, hogy elérjük a helyes Next Hopot. IP esetén ez egyszerűen néz ki, nagyon sok prefixet használhatunk ugyanazon csoporthoz, ugyanazon Next Hop blokkhoz.
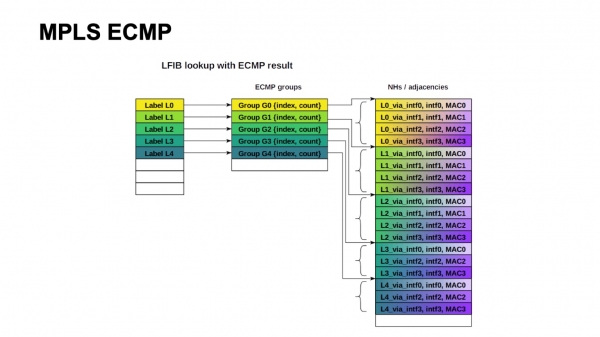
A klasszikus MPLS architektúra azt jelenti, hogy a kimeneti interfésztől függően a címke különféle értékekre írható át. Ezért szükség van egy csoport és egy Next Hop blokk fenntartására minden egyes bejövő címkéhez. És ez sajnos nem skálázható.
Nem nehéz észrevenni, hogy a konstrukciónkhoz körülbelül 4000 ToR kapcsolóra volt szükségünk, a maximális szélesség 64 út ECMP, ha a spinestruktúra-1-től a spinestruktúra-2 felé haladunk. Nehezen fértünk el egy ECMP-csoport táblázatban, ha csak egy ToR prefixed van, és egyáltalán nem fértünk el a Következő Ugrások táblázatában.
Minden nem reménytelen, mert a Segment Routing típusú architektúrák globális címkéket feltételeznek. Formálisan újra össze lehetne zsugorítani ezeket a Következő Ugrások blokkjait. Ehhez wildcard műveletre van szükség: egy címkét venni, és újraírni ugyanazzal anélkül, hogy konkrét értéket adnánk meg. De sajnos, a rendelkezésre álló megvalósításokban ez nem igazán van jelen.
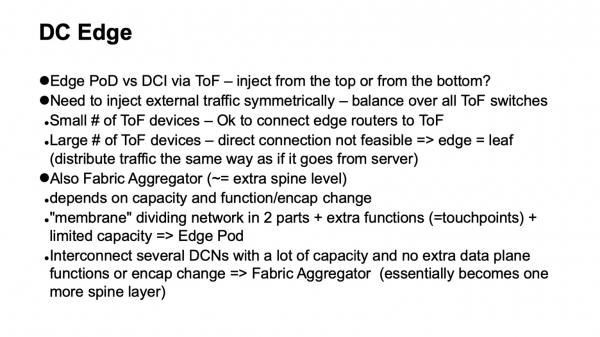
Végül szükséges, hogy a külső forgalmat az adatközpontba hozzuk. Hogyan tegyük ezt? Korábban a forgalmat a Clos hálózatokba a tetejéről vezették be. Vagyis voltak határoló routerek, amelyek csatlakoztak az összes eszközhez a Top of fabric-on. Ez a megoldás viszonylag jól működik kis és közepes méretekben. Sajnos ahhoz, hogy a forgalmat szimmetrikusan vezessük be az egész hálózatba, egyszerre kell csatlakozni az összes Top of fabric elemhez, és amikor ezek száma meghaladja a százat, kiderül, hogy nekünk egy nagy radikális megoldásra van szükségünk a határoló routereken is. Egyébként ennek költségei vannak, mert a határoló routerek funkcionálisabbak, és a portok drágábbak, így nem igazán esztétikus konstrukció jön létre.
Egy másik lehetőség az, hogy a forgalmat alulról vezessük be. Nem nehéz megállapítani, hogy a Clos topológia úgy van felépítve, hogy az alulról beérkező forgalom, vagyis a ToR irányából, egyenletesen oszlik el a szinteken az egész Top of fabric-ban két iteráción keresztül, így terheli meg az egész hálózatot. Ezért bevezetünk egy különleges típusú Podot, Edge Podot, amelyek biztosítják a külső kapcsolódást.
Van még egy lehetőség. Például ezt a Facebook csinálja. Ők ezt Fabric Aggregator-nak vagy HGRID-nek hívják. Bevezetnek egy további spine szintet, hogy összekapcsolják a különböző adatközpontokat. Ez a konstrukció lehetséges, ha az átkötéseknél nincsenek további funkciók vagy inkapszulációk váltása. Ha vannak, akkor ezek plusz érintkezési pontok, ami bonyolulttá teszi a helyzetet. Általában több funkció merül fel, és egyfajta membrán jelenik meg, ami elválasztja az adatközpont különböző részeit. Nem érdemes nagy membránt csinálni, de ha valóban szükség van rá, érdemes megfontolni, hogy átmozgassuk, és maximálisan szélesre vesszük, és átkonfiguráljuk a hosztokhoz. Így működik például sok felhőszolgáltató. Náluk overlayek vannak, és ezek a hosztokkal kezdődnek.
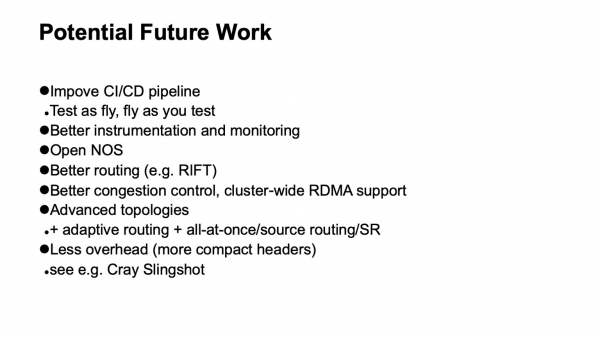
Milyen fejlődési lehetőségeket látunk? Elsősorban a CI/CD pipeline támogatásának javítását. Úgy akarunk repülni, ahogy tesztelünk, és tesztelni, ahogy repülünk. Ezt nem igazán sikerül, mivel az infrastruktúra nagy, nem lehet duplikálni tesztelés céljából. Meg kell értenünk, hogyan lehet tesztelési elemeket bevezetni a munkainfrastruktúrába anélkül, hogy azt megborítanánk.
A legjobb eszközkészletek, a legjobb monitoring soha nem felesleges. Az egész kérdés az erőfeszítések és a megtérülés egyensúlyában rejlik. Ha ésszerű erőfeszítésekkel hozzá lehet adni — az nagyon jó.
Nyílt operációs rendszerek hálózati eszközök számára. A legjobb protokollok és a legjobb routing rendszerek, például RIFT. Szintén szükséges a legjobb congestion control rendszerek alkalmazásának kutatása, és lehetőség szerint a RDMA támogatásának bevezetése, legalábbis egyes pontokon a klasztereken belül.
Ha a távolabbi jövőre tekintünk, fejlettebb topológiákra és esetleg olyan hálózatokra van szükség, amelyek kevesebb overhead-et használnak. Újabb friss dolog — nemrég publikálták a gyártó technológiákról az HPC Cray Slingshot esetében, amely alapvetően kereskedelmi Etherneten alapul, de lehetőséget ad sokkal rövidebb fejlécek használatára. Ennek eredményeként csökken a overhead.
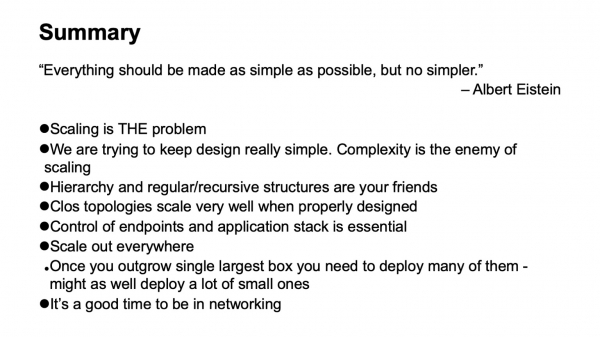
Mindent úgy kell tennünk, hogy az annyira egyszerű legyen, amennyire csak lehetséges, de ne egyszerűbb. A bonyolultság a skálázhatóság ellensége. Az egyszerűség és a rendszeres struktúrák a barátaink. Ha valahol meg tudjuk csinálni a scale out-ot — csináljuk. És egyáltalán, most nagyon izgalmas a hálózati technológiákkal foglalkozni. Sok érdekes dolog történik. Köszönöm.
Forrás: habr.com
