

Ma csodálatos időben élünk, amikor gyorsan és egyszerűen összekapcsolhatunk több kész nyílt eszközt, beállíthatjuk őket "tudat nélküli" módon a stackoverflow tanácsai szerint, anélkül hogy mélyebben belemerülnénk a "sok betűbe", és kereskedelmi használatba bocsáthatjuk őket. Amikor pedig frissíteni vagy bővíteni kell, vagy valaki véletlenül újraindít pár gépet — rá kell jönni, hogy kezdődött egy zavaró, rossz álom, minden hirtelen túlságosan bonyolult lett, nincs visszaút, a jövő ködös, és biztonságosabb, ha a programozás helyett inkább méheket tartunk és sajtot készítünk.
Nem véletlen, hogy a tapasztaltabb kollégák, akik már sok hibával a fejükben, ezáltal őszültek meg, nézik az irreálisan gyors konténertelepítést "kockákban" tucatnyi szerveren divatos nyelveken, amelyek beépített támogatását nyújtják az aszinkron, nem blokkoló I/O-hoz — szerényen mosolyogva. Csendben továbbra is újraolvassák a "man ps"-t, vérző szemmel mélyednek az "nginx" forráskódjába, és írják-írják-írják az egységteszteket. A kollégák tudják, hogy a legérdekesebb dolgok még hátra vannak, amikor "mindez" egyszer csak éjjel, szilveszterkor az éghegyre kerül. Csak a UNIX természetének mély megértése, a TCP/IP állapotok memorizált táblázata és az alapvető rendezési-keresési algoritmusok segítenek nekik abban, hogy a harangok szavára visszahozzák a rendszert az életbe.
Ó, igen, kicsit eltértem a témától, de remélem meg tudtam osztani a várakozás állapotát.
Ma szeretném megosztani tapasztalatainkat egy kényelmes és olcsó DataLake stack telepítésével, amely a vállalat különböző szervezeti egységei számára megoldja a legtöbb elemzési feladatot.
Néhány idővel ezelőtt arra a következtetésre jutottunk, hogy a vállalatok egyre inkább szükségét érzik a terméki- és műszaki analitika gyümölcseinek (nem is beszélve a torta cseresznyéiről, mint a gépi tanulás) a trendek és kockázatok megértéséhez — egyre több és több metrikát kell gyűjteni és elemezni.
Alapvető műszaki analitika a "Bitrix24"-ben
Több évvel ezelőtt, a „Bitrix24” szolgáltatás bevezetésével egy időben aktívan fektettünk időt és erőforrásokat egy egyszerű és megbízható analitikai platform létrehozásába, amely gyorsan segített látni az infrastruktúrában lévő problémákat és megtervezni a következő lépést. Természetesen, az eszközöket érdemes volt készen kapni, egyszerű és érthető formában. Ennek eredményeként a nagios lett a választott eszköz a monitorozásra, míg a munin az analitikára és vizualizációra. Most már több ezer ellenőrzésünk van a nagiosban, több száz grafikon a muninban, és kollégáink naponta és sikeresen használják őket. A metrikák érthetőek, a grafikonok világosak, a rendszer megbízhatóan működik már évek óta, és folyamatosan új tesztek és grafikonok kerülnek be: új szolgáltatást indítunk — hozzáadunk néhány tesztet és grafikont. Jó utat!
Kézben tartva — kiterjedt technikai analitika
A „minél gyorsabb” információszerzés iránti igény aktív kísérletekhez vezetett egyszerű és érthető eszközökkel — pinba és xhprof.
A Pinba UDP csomagokban küldött számunkra statisztikákat a PHP weboldal részeinek működéséről, és valós időben láthattuk a MySQL tárolóban (a pinba saját MySQL motorral rendelkezik az események gyors analitikája érdekében) a problémák rövid listáját, amelyeket azonnal tudtunk kezelni. Az xhprof automatikusan lehetővé tette a leglassabb PHP-oldalak végrehajtási gráfjainek összegyűjtését a kliensektől, és elemezhettük, hogy mi vezetett ehhez — nyugodtan, miközben teát vagy valami erősebbet öntöttünk.
Néhány idővel ezelőtt az eszközkészletünket gazdagította egy viszonylag egyszerű és érthető motor, amely az inverz indexelési algoritmuson alapul, remekül megvalósítva a legendás Lucene könyvtárban — Elastic/Kibana. Az a egyszerű ötlet, hogy több szálon dokumentumokat írunk az inverz Lucene indexbe az események alapján a naplókban, és gyors keresést végezhetünk rajtuk a fázisos osztályozás révén — valóban hasznosnak bizonyult.
Bár a Kibana vizualizációi meglehetősen technikai megjelenésűek voltak a „felfelé szivárgó” alacsony szintű fogalmakkal, mint például a „bucket”, és a teljesen újra feltalált nyelv sem feledésbe merült relációs algebrának — az eszköz jól segített minket a következő feladatokban:
- Hány PHP hiba történt a Bitrix24 kliensén a p1 portálon az elmúlt órában, és milyen hibák voltak ezek? Értsük meg, bocsássuk meg és gyorsan javítsuk ki.
- Hány videohívást végeztek el a német portálokon az elmúlt 24 órában, milyen minőségben, és voltak-e nehézségek a csatornával/hálózattal?
- Mennyire jól működik a rendszer funkciója (a PHP-hez készült kiterjesztésünk), amelyet a legutóbbi szolgáltatási frissítés során fordítottunk a forrást kódokból és kiadtunk az ügyfeleknek? Nincsenek szegfaultok?
- Felkerülnek-e az ügyfelek adatai a PHP memóriájába? Nincsenek-e a folyamatok által igényelt memória túllépési hibák: «nincs elegendő memória»? Meg kell találni és semlegesíteni.
Itt egy konkrét példa. A gondos és többszintű tesztelés ellenére, egy ügyfélnél, egy nagyon szokatlan esetben és sérült bemeneti adatok mellett váratlan hiba lépett fel, megszólalt a sziréna és megkezdődött a gyors javítási folyamat:
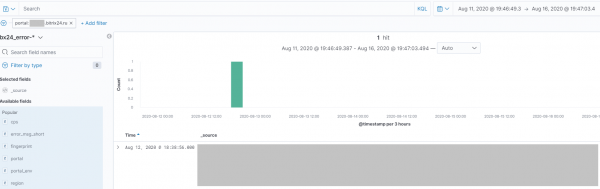
Ráadásul a Kibana lehetővé teszi, hogy értesítéseket állítsunk be a megadott eseményekről, és rövid idő alatt a cégnél több tucat alkalmazott kezdte használni az eszközt a különböző osztályokból — a műszaki támogatástól és a fejlesztéstől a QA-ig.
Bármely osztály aktivitását a cégen belül kényelmesen nyomon követhető és mérhető lett — a szerverek naplóinak kézi elemzése helyett elegendő egyszer beállítani a naplók feldolgozását és azok elküldését az elastic klaszterbe, hogy élvezhessünk például a Kibana irányítópultján látott kétnyakú cicák számának megfigyelését, amelyeket a múlt holdhónapban nyomtattak 3D nyomtatóval.
Alapvető üzleti elemzés
Mindenki tudja, hogy gyakran az üzleti elemzés a cégeknél extrém aktív Excel használattal kezdődik. De a legfontosabb, hogy ne érjen véget ott. Az égő olajhoz még a felhő alapú Google Analytics is jól hozzájárul — gyorsan hozzászokik az ember a jóhoz.
A mi harmonikusan fejlődő cégünknél egyre többször jelentek meg itt-ott az «próféták» a nagyobb adatokkal való intenzívebb munkáról. Rendszeresen felmerültek igények a mélyebb és sokoldalúbb jelentések iránt, és a különböző osztályok munkatársai néhány hónappal ezelőtt egy egyszerű és praktikus megoldást alakítottak ki – a ClickHouse és a PowerBI összekapcsolását.
Elég hosszú ideje ez a rugalmas megoldás remekül segített, de fokozatosan megértettük, hogy a ClickHouse nem gumiból készült, és nem lehet vele úgy bánni.
Fontos jól megérteni, hogy a ClickHouse, akárcsak a Druid, a Vertica és az Amazon RedShift (amely PostgreSQL alapú), elemző motorok, amelyek a viszonylag kényelmes elemzésekre (összegek, aggregálások, minimum-maximális értékek oszlopon és kis mennyiségű join) optimalizáltak, mivel hatékony oszlopos tárolásra szerveződtek, eltérően a jól ismert MySQL-től és más (soros alapú) adatbázisoktól.
Lényegében a ClickHouse csak egy nagyobb kapacitású "adatbázis", nem túl kényelmes közvetlen adatbevitellel (ez így van kitalálva, minden rendben), de kellemes elemzéssel és érdekes, erőteljes funkciók készletével az adatok kezelésére. Igen, lehet még klasztert is létrehozni — de érted, hogy nem egészen helyénvaló szögbeverni mikroszkóppal, és kezdtünk más megoldások után nézni.
Kereslet a Python és az elemzők iránt
Cégünknél sok fejlesztő van, akik szinte minden nap írnak kódot, már 10-20 éve PHP, JavaScript, C#, C/C++, Java, Go, Rust, Python, Bash nyelveken. Számos tapasztalt rendszergazda is dolgozik nálunk, akik átélték már a legtökéletesebb statisztikai törvényeket meghaladó elképesztő katasztrófákat (például amikor a legtöbb lemez tönkremegy RAID-10-ben egy erős villámlás következtében). Ilyen körülmények között sokáig nem volt világos, hogy mi is az a "Python alapú elemző". A Python gyakorlatilag a PHP, csak a neve kicsit hosszabb, és a tudatmódosító anyagok némileg kevesebb nyoma található a fordító forráskódjában. Azonban ahogy egyre több elemző jelentés készült, a tapasztalt fejlesztők egyre inkább felismerték a szűk specializáció fontosságát olyan eszközökben, mint a numpy, pandas, matplotlib, seaborn.
Valószínűleg mérföldkőnek bizonyultak a kollégák hirtelen ájulásai a "logisztikai regresszió" szavak hallatán, valamint egy eredményes jelentéskészítés demonstrálása nagy adathalmazokkal a pyspark segítségével.
Az Apache Spark és a funkcionális paradigma, amely remekül illeszkedik a relációs algebrához, olyan benyomást tett a MySQL-hez szokott fejlesztőkre, hogy világossá vált, mennyire szükséges tapasztalt elemzők bevonása.
Az Apache Spark/Hadoop további próbálkozásai, hogy felemelkedjenek, nem egészen a tervek szerint alakultak.
Hamarosan nyilvánvalóvá vált, hogy a Spark körül valami rendszerszinten nem stimmel, vagy csak jobban kellene kezet mosni. Míg a Hadoop/MapReduce/Lucene stacket elég tapasztalt programozók írták — ami nyilvánvaló, ha az ember alaposan megnézi a Java forráskódokat vagy Doug Cutting ötleteit a Lucene-ben — addig a Spark, váratlanul, egy nagyon vitatott és jelenleg nem fejlődő egzotikus Scala nyelven készült. A számítások rendszeres leállása a Spark klaszteren a reduce műveletekhez történő memóriaallokáció logikátlan és nem átlátható működése miatt (sok kulcs érkezik egyszerre) — valami olyasmit teremtett körülötte, ami számára van hova fejlődni. Továbbá, a helyzetet súlyosbította a sok furcsa nyitott port, ideiglenes fájl, amelyek a legérthetetlenebb helyeken növekedtek, és a jar-függőségek — ami a rendszergazdákban egy jól ismert, gyermekkori érzést váltott ki: vad haragot (lehet, hogy jobban kellett volna kezet mosni szappannal).
Mi, ennek eredményeként, „átéltük” több belső elemző projektet, amelyek aktívan használták az Apache Sparkot (többek között a Spark Streaming, Spark SQL) és a Hadoop ökoszisztémát (stb.). Annak ellenére, hogy idővel megtanultunk „ezt” jól elkészíteni és monitorozni, és „ez” szinte teljesen megállt hirtelen összeomlani az adatok jellege és az RDD egyenletes hash-elésének eloszlási zavarai miatt, a vágy, hogy valami már kész, frissített és valahol a felhőben adminisztrált megoldást keressünk, egyre erősebbé vált. Ekkor próbáltuk ki az Amazon Web Services kész felhős csomagját — és később ezen kezdtünk el már a feladatokat megoldani. Az EMR az Amazon által elkészített Apache Spark plusz szoftverekkel az ökoszisztémából, körülbelül úgy, mint a Cloudera/Hortonworks csomagok.
„Gumírozott” fájltároló az elemzéshez — égető szükséglet
A Hadoop/Spark „elkészítésének” tapasztalata, különféle testrészeinken szerzett égési sérülésekkel, nem múlt el nyomtalanul. Egyre világosabbá vált az igény egy egységes, olcsó és megbízható fájltároló létrehozására, amely ellenálló az硬件故障 miatt, és amelyben különböző formátumú fájlokat lehet tárolni különböző rendszerekből, és hatékony és ésszerű időn belül végrehajtható lekérdezések készíthetők ezek alapján a jelentésekhez.
Azt is szeretném, ha a szoftverfrissítés ezen a platformán nem válna újévi éjszakai rémálommá, amikor 20 oldalas Java stack trace-eket kell olvasni, és több kilométernyi részletes klaszteres naplóelemzést kell végezni a Spark History Server segítségével és egy nagyítóval. Jó lenne egy egyszerű és átlátható eszköz, amely nem igényel rendszeres benézést a motor alá, ha a fejlesztőnek leáll a megszokott MapReduce kérdése, amikor a reduce adatok memóriából való kiesése miatt nem sikerült a megfelelő particiós algoritmus választása.
Az Amazon S3 a DataLake jelöltje?
A Hadoop/MapReduce tapasztalat megtanította, hogy szükség van egy skálázható, megbízható fájlrendszerre és fölötte skálázható munkásokra, akik közelebb „jönnek” az adatokhoz, hogy ne kelljen az adatokat a hálózaton keresztül szaladgálni. A munkásoknak képesnek kell lenniük különböző formátumú adatok olvasására, de lehetőleg ne olvassanak el felesleges információkat, és lehetőség legyen az adatok tárolására a munkások számára kényelmes formátumokban.
Még egyszer — az alapötlet. Nincs kedvem nagy adatokat betenni egy egységes, klaszter alapú analitikai motorba, amely úgyis előbb-utóbb el fog fulladni és csúnyán shardolni kell. Az adatok tárolására szeretnék fájlokat, egyszerű fájlokat, érthető formátumban, és hatékony analitikai lekérdezéseket végezni rajtuk különböző, de érthető eszközökkel. És a fájlok különböző formátumokban egyre csak gyarapodnak. Jobb lenne a forrást shardolni, mint a motort. Egy skálázható és univerzális DataLake-re van szükségünk, ezt döntöttük el...
Mi lenne, ha az fájlokat egy ismerős és sokak által ismert skálázható felhőtárolóban, az Amazon S3-ban tárolnánk, anélkül hogy saját magunknak kellene a húst sütögetni a Hadoop-ból?
Nyilvánvaló, hogy a személyes adatok „tiltottak”, de más adatokat, ha oda kihelyezünk, és „hatékonyan mozgatunk”?
A klaszter-alapú nagy adatelemző ökoszisztéma az Amazon Web Services-en — nagyon egyszerű szavakkal.
Tapasztalatunk szerint az AWS-nél már régóta és aktívan használják különböző formákban az Apache Hadoop/MapReduce-t, például a DataPipeline szolgáltatásban (irigylem a kollégákat, tudják, hogyan kell ezt jól elkészíteni). Itt a különböző szolgáltatásokból DynamoDB táblákból beállítottuk a biztonsági mentéseket:
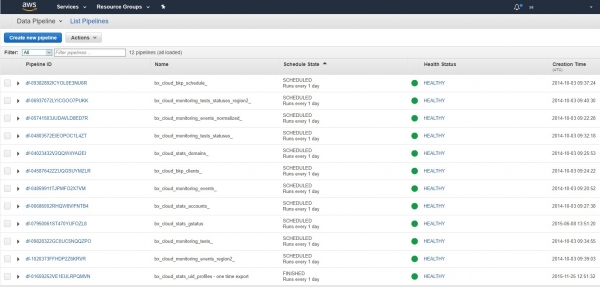
És ezek éveken át, rendszeresen, mint az óramű működnek a beépített Hadoop/MapReduce klasztereken. „Beállítottam és elfelejtettem”:
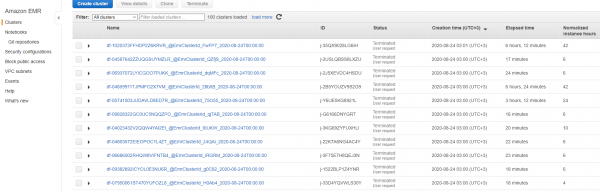
Ezen kívül hatékonyan foglalkozhatunk adatkezeléssel, ha felállítunk Jupiter-notebookokat az analitikák számára a felhőben, és az AWS SageMaker szolgáltatást használjuk az AI-modellek betanítására és telepítésére. Így néz ki nálunk:
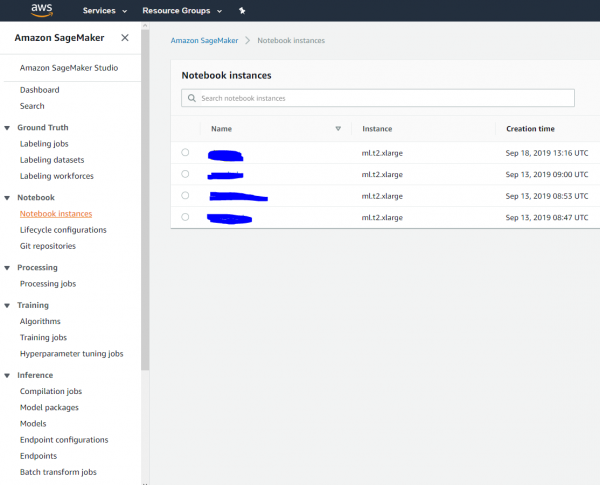
Igen, felállíthatunk egy notebookot a felhőben, és csatlakoztathatjuk egy Hadoop/Spark klaszterhez, elvégezhetjük a számításokat, majd mindent "megjelölhetünk":
Valóban kényelmes egyes analitikai projektek számára, és néhány esetben sikeresen használtuk az EMR szolgáltatást nagyszabású számításokhoz és elemzésekhez. De mi a helyzet a DataLake rendszermegoldással, sikerülni fog? Ekkor már a remény és a kétségbeesés határán voltunk, és tovább kerestük a megoldást.
Az AWS Glue – gondosan csomagolt Apache Spark "szteroidokon".
Kiderült, hogy az AWS-nek van egy "saját" verziója a Hive/Pig/Spark stacknek. A Hive szerepét, azaz a fájlok és típusok katalógusát a DataLake-ben a "Data catalog" szolgáltatás tölti be, amely nem titkolja, hogy kompatibilis az Apache Hive formátummal. A szolgáltatásba információt kell adni arról, hogy hol találhatók a fájlok, és milyen formátumban vannak. Az adatok nemcsak az S3-ban lehetnek, hanem egy adatbázisban is, de erről nem ezen a poszton. Így van szervezve a DataLake adat каталógus nálunk:
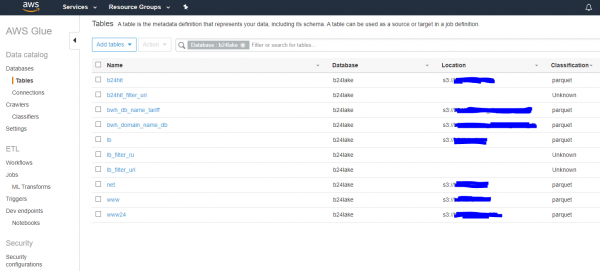
A fájlok regisztrálva vannak, remek. Ha a fájlok frissültek – elindítjuk kézzel vagy ütemezve a crawler-eket, amelyek frissítik az információt a tóról és tárolják. A továbbiakban az adatok kezelhetők, és az eredményeket valahova ki lehet exportálni. A legegyszerűbb esetben – szintén az S3-ba exportálunk. Az adatkezelést bárhol el lehet végezni, de javasolt beállítani a feldolgozási folyamatot egy Apache Spark klaszteren, kihasználva az AWS Glue API kibővített lehetőségeit. Alapvetően használhatjuk a jól bevált Python kódot a pyspark könyvtárral, és beállíthatjuk annak végrehajtását egy bizonyos teljesítményű klaszter N csomópontján, felügyelettel, anélkül, hogy a Hadoop mélyére ásnánk, és a konténerek, valamint a függőségek konfliktusainak kezelésével foglalkoznánk.
Még egyszer – egy egyszerű ötlet. Nem kell beállítani az Apache Spark-ot, csak Python kódot kell írni a pysparkhoz, helyben a munkaasztalon tesztelni, majd elindítani egy nagy klaszteren a felhőben, megadva, hol találhatók a forrásadatok, és hová kerüljön az eredmény. Néha szükség van erre, és hasznos is, és így van beállítva nálunk:
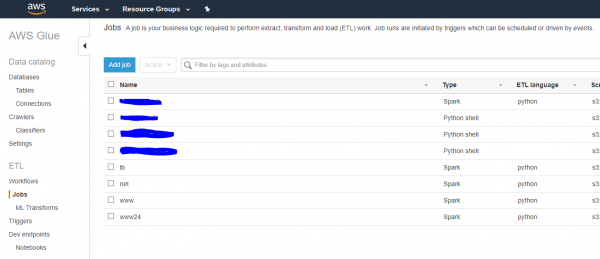
Így, ha számításokat szeretnénk végezni egy Spark klaszteren az S3 adataival – csak írjuk a Python/pyspark kódot, teszteljük és menjünk a felhőbe.
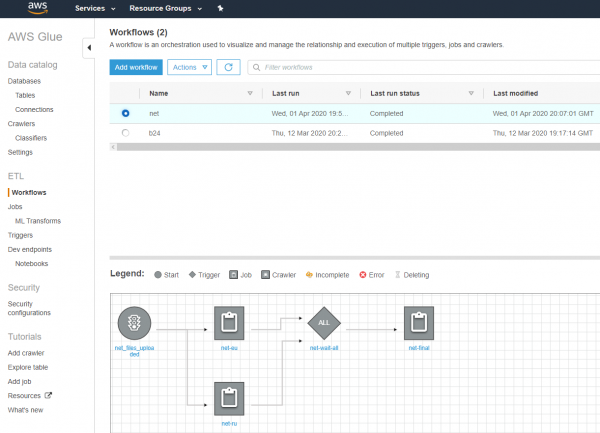
És mi a helyzet az orkestrációval? Mi van, ha a feladat leállt és eltűnt? Igen, felmerült, hogy egy szépen megtervezett pipelint hozzunk létre az Apache Pig stílusában, és ki is próbáltuk őket, de végül úgy döntöttünk, hogy maradunk a mélyen testreszabott orkestrációnknál PHP és JavaScript segítségével (tudom, hogy kognitív disszonanciát okoz, de működik, évek óta és hibák nélkül).
A tározóban tárolt fájlok formátuma - a teljesítmény kulcsa
Nagyon, nagyon fontos még két kulcsfontosságú szempontot megérteni. Ahhoz, hogy a fájlok adataira irányuló lekérdezések a lehető leggyorsabban teljesüljenek, és a teljesítmény ne romoljon új információk hozzáadásakor, szükséges:
- A fájlok oszlopait külön tárolni (hogy ne kelljen az összes sort elolvasni ahhoz, hogy megértsük, mi van az oszlopokban). Ehhez a parquets formátumot választottuk, tömörítéssel.
- Nagyon fontos a fájlokat mappák szerint shardolni, mint például: nyelv, év, hónap, nap, hét. Azok a motorok, amelyek értik ezt a shardolási típust, csak a szükséges mappákban fognak keresni, anélkül, hogy átfésülnék az összes adatot.
Lényegében így a lehető leghatékonyabb formában teszi közzé az alapadatokat a felsőbb analitikai motorok számára, amelyek szintén szelektíven tudnak belépni a shardolt mappákba, és csak a szükséges oszlopokat olvasni a fájlokból. Nincs szükség arra, hogy bárhova is "feltöltsük" az adatokat (a tároló úgyis egyszerűen megszűnne működni) - egyszerűen okosan helyezze őket el a fájlrendszerben, a megfelelő formátumban. Nyilvánvaló, hogy nem célravezető egy hatalmas csv fájlt tárolni a DataLake-ben, amelyet először soronként kellene elolvasni a klaszterrel, hogy kinyerjük az oszlopokat - fontolja meg még egyszer a fenti két pontot, ha eddig nem világos, hogy miért van erre szükség.
AWS Athena - a „genie” a ládában
És itt, amikor létrehoztuk a tavat, valahogy rábukkantunk az Amazon Athena-ra. Hirtelen kiderült, hogy ha ügyesen elrendezzük a shard mappákban a fájlokat, a megfelelő (parquet) oszlopos formátumban, akkor rendkívül gyorsan végezhetünk nagyon informatív lekérdezéseket és jelentéseket készíthetünk ANÉLKÜL, hogy Apache Spark/Glue klaszterre lenne szükség.
Az Athena motor, amely az S3 adatai felett működik, a legendás — a massive parallel processing (MPP) approach to data processing that retrieves data from its source, from S3 and Hadoop to Cassandra and regular text files. You just need to ask Athena to execute an SQL query, and then everything "works quickly and automatically". It is important to note that Athena is "smart"; it only accesses the necessary sharded folders and reads only the columns required by the query.
The requests to Athena are also billed in an interesting way. We pay for . That is, not for the number of machines in the cluster per minute, but… for the actually scanned necessary data from 100-500 machines to fulfill the query.
And by requesting only the needed columns from the correctly sharded folders, it turned out that the Athena service costs us tens of dollars a month. Well, that's great, almost free compared to analytics on clusters!
By the way, here’s how we shard our data in S3:
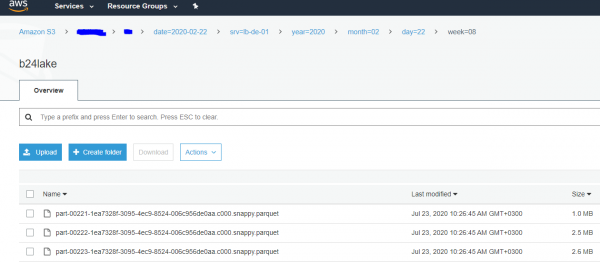
As a result, in a short time, completely different departments in the company, from information security to analytics, began actively querying Athena and quickly, in seconds, getting useful answers from "big" data over quite large periods: months, half-years, etc.
But we went further and started fetching answers from the cloud : an analyst writes an SQL query in a familiar console, which "for a pittance" queries data in S3 across 100-500 machines and usually returns the answer in a matter of seconds. Convenient. And fast. It still feels unbelievable.
As a result, having decided to store data in S3 in an efficient columnar format and with reasonable data sharding across folders… we got a DataLake and a fast and cheap analytical engine — for free. And it became very popular in the company, as it understands SQL and works orders of magnitude faster than launching/stopping/tuning clusters. "If the result is the same, why pay more?"
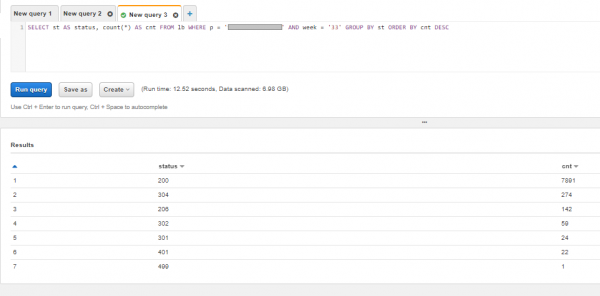
A query to Athena looks something like this. If desired, of course, one can formulate a fairly , but we will limit ourselves to a simple grouping. Let’s see what response codes the client had in the logs of the web server a few weeks ago and verify that there are no errors:
Következtetések
Miután egy nem túl hosszú, de fájdalmas utat jártam be, folyamatosan megfelelően értékelve a kockázatokat, a bonyolultság szintjét és a fenntartás költségeit, megtaláltuk a megoldást a DataLake és az analitika számára, amely minket folyamatosan boldoggá tesz a sebességével és a tulajdonlás költségével.
Kiderült, hogy hatékony, gyors és olcsón üzemeltethető DataLake-et építeni a vállalat különböző osztályainak igényeihez — ez még a tapasztalt fejlesztők számára is teljesen megvalósítható, akik sosem dolgoztak építészként és nem tudják, hogyan kell négyzeteket rajzolni négyzetekre nyilakkal, valamint ismerik a Hadoop ökoszisztéma 50 kifejezését.
Az út elején az ember feje a sok különböző, nyílt forrású és zárt szoftver állatkertje miatt szétszakadt, és az utódok iránti felelősség súlya alatt. Egyszerűen kezdje el építeni a saját DataLake-jét egyszerű eszközökkel: nagios/munin -> elastic/kibana -> Hadoop/Spark/s3..., visszajelzéseket gyűjtve és mélyen megértve a folyamatok fizikáját. Minden bonyolult és zavaros — adja át az ellenségeknek és a versenytársaknak.
Ha nem akar felhőbe menni és szereti karbantartani, frissíteni és javítani a nyílt projekteket, akkor hasonló rendszert építhet helyben, olcsó irodai gépekkel Hadoop-dal és Presto-val a tetején. A lényeg — ne álljon meg, haladjon előre, számoljon, keressen egyszerű és világos megoldásokat, és mindenki biztosan boldogulni fog! Sok szerencsét mindenkinek és viszontlátásra!
Forrás: habr.com
