

Helló, Habr! Az elmúlt pár hónap érdekes helyzetben telt, és szeretném megosztani a történetünket az infrastruktúra skálázásáról. Ez idő alatt a SberMarket megrendelései négyszeresére nőttek, és 17 új városban indítottunk szolgáltatást. A termékek iránti kereslet robbanásszerű növekedése megkövetelte tőlünk az infrastruktúra skálázását. A legérdekesebb és leghasznosabb tanulságokról a folytatásban olvashatsz.
Szervusz, Dima Bobylev vagyok, a SberMarket műszaki igazgatója. Mivel ez az első bejegyzésünk a blogunkban, szeretnék néhány szót mondani magamról és a cégről. Tavaly ősszel részt vettem az orosz internet fiatal vezetőinek versenyén. A versenyhez írtam arról, hogyan látjuk a SberMarketnél a belső kultúrát és a szolgáltatás fejlesztéséhez való hozzáállást. Bár a versenyt nem nyertem meg, mégis megfogalmaztam magam számára az IT-övezet fejlesztésének alapelveit.
A csapat irányítása során fontos megérteni és megtalálni az egyensúlyt a vállalkozás szükségletei és az egyes fejlesztők igényei között. Jelenleg a SberMarket évi 13-szoros növekedést mutat, ami hatással van a termékre, folyamatosan növelve a fejlesztési mennyiséget és ütemet. Ennek ellenére elegendő időt biztosítunk a fejlesztők számára a precíz elemzésre és a minőségi kódírásra. Az így kialakított megközelítés nemcsak a működő termék létrehozásában segít, hanem annak további skálázásában és fejlesztésében is. Ennek a növekedésnek köszönhetően a SberMarket már a termékek házhoz szállításának vezető szolgáltatójává vált: naponta körülbelül 18 ezer megrendelést teljesítünk, holott február elején még csak körülbelül 3500 volt.
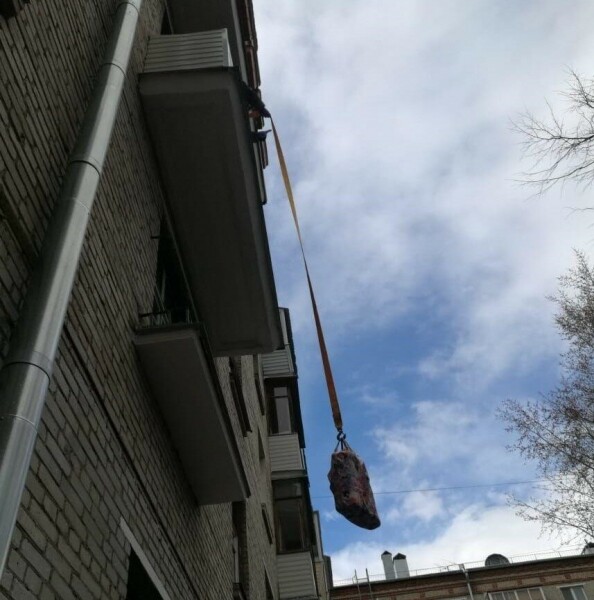
Egyszer a SberMarket egyik ügyfele azt kérte, hogy a futár érintésmentesen vigye el neki a termékeket - közvetlenül az erkélyre.
De lépjünk a konkrétumokhoz. Az utolsó néhány hónapban aktívan dolgoztunk a cégünk infrastruktúrájának skálázásán. Ezt a szükségletet külső és belső tényezők indokolták. A vevői bázis bővülésével egyidejűleg a csatlakoztatott boltok száma a év eleji 90-ről több mint 200-ra nőtt május közepére. Természetesen felkészültünk, lefoglaltuk a fő infrastruktúrát, plusz számoltunk az összes virtuális gép függőleges és vízszintes skálázásának lehetőségével, amely a Yandex felhőjében található. A gyakorlat azonban megmutatta: „Minden, ami rosszul sülhet el, el is romlik.” Ma szeretném megosztani a legérdekesebb helyzeteket, amelyek ezekben a hetekben történtek. Remélem, tapasztalatunk hasznos lesz az Ön számára.
A Slave teljes harci készültségben van
Már a világjárvány előtt is növekvő számú kéréssel szembesültünk backend szervereink iránt. A házhoz szállított termékek rendelésének tendenciája kezdetét vette, és a COVID-19 miatt bevezetett első önizolációs intézkedések bevezetésével a terhelés drámaian nőtt egész nap. Szükségessé vált a master szerverek fő adatbázisának gyors leterhelése és a részben olvasási kérések áthelyezése a replika szerverekre (slave).
Előre készültünk erre a lépésre, és már elindítottunk 2 slave szervert az ilyen manőverhez. Ezeken főként a partnerekkel való adatcsere információs feedjeinek generálásával kapcsolatos batch feladatok futottak. Ezek a folyamatok felesleges terhelést okoztak, és teljesen jogosan ki lettek vonva a 'képletből' néhány hónappal korábban.
Mivel a Slave-en replikáció történt, ragaszkodtunk ahhoz a koncepcióhoz, hogy az alkalmazások csak read only módban dolgozhatnak velük. A Disaster Recovery Plan azt feltételezte, hogy katasztrófa esetén egyszerűen a Slave-t a Master helyére tudjuk csatlakoztatni, és a write és read kéréseket a Slave-ra irányítani. Ugyanakkor a marketing osztály igényeire is szerettük volna használni a replikákat, ezért a szerverek nem teljesen kerültek át read only státuszba, és minden hoszton volt egy saját felhasználói készlet, és néhányan írási jogokkal rendelkeztek, hogy megőrizzék a számítások közbenső eredményeit.
Egy bizonyos terhelési szintig elegendő volt a mester mind az írásra, mind az olvasásra a http-kérések kezelésénél. Március közepén, éppen akkor, amikor a Sbermarket úgy döntött, hogy teljesen átáll a távoli munkavégzésre, hirtelen növekedni kezdett az RPS. Ügyfeleink egyre nagyobb arányban mentek önizolációba vagy kezdtek otthon dolgozni, ami a terhelési mutatókra is kihatott.
A „mester” teljesítménye már nem volt elegendő, ezért elkezdtük a legnehezebb olvasási kéréseket a replikára áthelyezni. Az írási kérések átlátható irányítása a mesterhez és az olvasás a slave-hez érdekében a ruby gem „„-t használtuk. Készítettünk egy speciális felhasználót _readonly végződéssel, írási jogok nélkül. Azonban egy a konfigurációs hibából kifolyólag az egyik hoston egyes írási kérelmek a slave-szerverre mentek a felhasználó nevében, akinek megvoltak a megfelelő jogai.
A probléma nem azonnal jelentkezett, mivel a megnövekedett terhelés megnövelte a slave-ek késlekedését. Az adatok inkonzisztenciáját reggel fedeztük fel, amikor az éjszakai import után a slave-ek nem „érték utol” a mestert. Ezt a magas terhelésnek a szolgáltatásra és az új bolt megnyitásával kapcsolatos importra írtuk le. De az adatok több órás késlekedéssel történő átadása elfogadhatatlan volt, ezért a folyamatokat a második analitikai slave-re váltottuk, mert annak több forrása volt és nem volt terhelve olvasási kérelmekkel (ezt magyaráztuk a replikációs késlekedés hiányának).óAmikor a fő slave „szétterjedésének” okait kielemeztük, az analitikai már szintén leállt ugyanazon okból. Annak ellenére, hogy két további szerverünk volt, amelyre a terhelést át akartuk vinni a mester leállása esetén, a kellemetlen hiba miatt kritikus pillanatban nem volt egy sem.
Ám mivel nemcsak a DB dump-ot készítettük el (a restore körülbelül 5 órát vett igénybe), hanem a mester szerver pillanatképét is, a replikát 2 órán belül sikerült elindítani. Az igazság azonban az, hogy ezután hosszú ideig tartó replikációs napló forgatás várt ránk (mivel a folyamat egyszálú módban zajlik, de ez már egy teljesen más történet).
Következtetés:
Következtetés: Ezek után egyértelművé vált, hogy fel kellene adni a felhasználók írási korlátozásának gyakorlatát, és az egész szervert readonly-ra kellene állítani. Ezzel a megközelítéssel biztosak lehetünk abban, hogy a replikák rendelkezésre állnak kritikus pillanatokban.
Már egy nehéz lekérdezés optimalizálása is képes "új életet lehelni" az adatbázisba.
Bár folyamatosan frissítjük a weboldal katalógusát, a lekérdezések, amelyeket Slave-szerverekre irányítottunk, kissé lemaradtak a Mastertől. Az idő, amely alatt felfedeztük és megoldottuk a "hirtelen elérhetetlenné vált" slave problémáját, hosszabb volt, mint a "pszichológiai határ" (ez alatt az idő alatt árváltozás történhetett, és az ügyfelek elavult adatokat láthattak), ezért kénytelenek voltunk minden lekérdezést a fő DB szerverre irányítani. Ennek eredményeként a weboldal lassan működött... de legalább működött. Amíg a Slave helyreállt, nem volt más választásunk, mint optimalizálni.
Amíg a Slave-szerverek helyreálltak, a percek lassan teltek, a Master túltelítődött, és minden erőnket az aktív feladatok optimalizálására fordítottuk a "Pareto-elv" alapján: kiválasztottuk a TOP lekérdezéseket, amelyek a legnagyobb terhelést adták, és elkezdtük a finomhangolást. Ezt közvetlenül a "futás" során végeztük.
Érdekes hatás volt, hogy a teljesen leterhelt MySQL még a legkevésbé jelentős folyamatjavításokra is reagált. Két lekérdezés optimalizálása, amelyek mindössze 5%-át adták az összes terhelésnek, már érezhetően csökkentette a CPU terhelést. Ennek eredményeként sikerült elfogadható erőforrást biztosítanunk a Master adatbázis kezelésére, és elegendő időt nyertünk a replikák helyreállításához.
Következtetés: Még egy kis optimalizálás is lehetővé teszi a "túlélés" a terhelés alatt több órán keresztül. Ez éppen elegendő volt a replikákkal rendelkező szerverek helyreállításához. Egyébként a lekérdezések optimalizálásának technikai oldalát egy következő bejegyzésben fogjuk megvitatni. Tehát iratkozzanak fel a blogunkra, ha ez hasznos lehet az Önök számára.
Szervezze meg a partnerek szolgáltatásainak működésének nyomon követését.
Ügyfeleinktől érkező megrendelések feldolgozásával foglalkozunk, ezért szolgáltatásaink folyamatosan kommunikálnak külső API-kkal — ezek SMS-küldő átjárók, fizetési platformok, útvonal-szolgáltatások, geokódolók, az adóhatóság nyilvántartása és sok más rendszer. Amikor a terhelés hirtelen megnövekedett, a partnereink API-jainak korlátjaiba ütköztünk, amelyeket korábban még figyelembe sem vettünk.
A partneri szolgáltatások váratlan kvóta túllépése a saját rendszerünk leállásához vezethet. Sok API blokkolja azokat az ügyfeleket, akik túllépik a határértékeket, és egyes esetekben a túl sok kérés túlterhelheti a partnert a termelés során.
Például, amikor a kiszállítások száma növekedett, a kísérő szolgáltatások nem tudták kezelni a feladatok kiosztását és az útvonalak meghatározását. Ennek eredményeként előfordult, hogy a rendeléseket megtették, de az útvonal-generáló szolgáltatás nem működött. Meg kell jegyeznem, hogy logisztikai csapatunk szinte lehetetlent vitt véghez ezekben a körülmények között, és a csapat szoros együttműködése segített kompenzálni a szolgáltatások ideiglenes leállását. De az ilyen mennyiségű igény folyamatos manuális feldolgozása lehetetlen, és egy idő után elviselhetetlen szakadékot tapasztalnánk a rendelések és a teljesítések között.
Számos szervezési intézkedést hoztunk, és a csapat zökkenőmentes munkája időt nyert, miközben új feltételekről tárgyaltunk és vártuk a szolgáltatások modernizálását néhány partnerünktől. Vannak más API-k is, amelyek magas ellenállóképességgel és rendkívüli tarifákkal büszkélkednek a nagy forgalom esetén. Például kezdetben egy ismert térképszolgáltatás API-ját használtuk a kiszállítási címek meghatározásához. De a hónap végén közel 2 millió rubeles számlát kaptunk. Ezt követően gyorsan úgy döntöttünk, hogy lecseréljük. Nem szeretnék reklámozni, de azt mondhatom, hogy a költségeink jelentősen csökkentek.
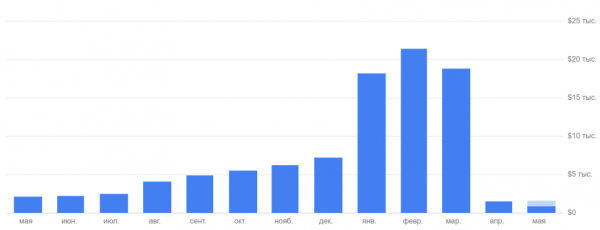
Következtetés: Mindenképpen monitorozni kell az összes partneri szolgáltatás működési feltételeit, és figyelembe kell venni őket. Még ha ma úgy tűnik is, hogy „nagy tartalékkal” rendelkeznek, ez nem jelenti azt, hogy holnap ne válnának a növekedés akadályává. És természetesen jobb, ha előre egyeztetjük a megnövekedett kereslet pénzügyi feltételeit.
Néha kiderül, hogy „” (idézet) nem segít
Megszoktuk, hogy a fő adatbázisban vagy az alkalmazásszervereken adódnak "szűk keresztmetszetek", de a méretezés során a problémák ott is megjelenhetnek, ahol nem vártuk. A webhelyünk teljes szöveges kereséséhez az Apache Solr motort használjuk. A terhelés növekedésével észleltük a válaszidő csökkenését, és a szerver CPU terhelése elérte a 100%-ot. Mi lehetne egyszerűbb — adunk a Solr konténernek több erőforrást.
A várt teljesítménynövekedés helyett a szerver egyszerűen "meghalt". Azonnal 100%-on terhelődött, és még lassabban válaszolt. Eredetileg 2 maggal és 2 GB RAM-mal indultunk. Úgy döntöttünk, hogy megteszünk valamit, ami általában segít — a szervernek 8 magot és 32 GB RAM-ot adtunk. Minden sokkal rosszabb lett (hogy pontosan hogyan és miért — erről egy külön bejegyzésben számolunk be).
Néhány nap alatt alaposan megértettük a kérdés finomságait, és 8 mag és 32 GB RAM mellett optimális teljesítményt értünk el. Ez a konfiguráció lehetővé teszi számunkra, hogy tovább növeljük a terhelést, ami nagyon fontos, mert nemcsak az ügyfelek száma, hanem az összekapcsolt boltok száma is növekszik — két hónap alatt megduplázódott a számuk.
Következtetés: A standard módszerek, mint például a "több hardver hozzáadása", nem mindig működnek. Tehát bármely szolgáltatás méretezésekor jól meg kell érteni, hogyan használja az erőforrásokat, és előre tesztelni kell, hogy hogyan működik új környezetben.
A stateless — kulcs a egyszerű vízszintes méretezéshez
Csapatunk alapvetően a jól ismert megközelítést követi: a szolgáltatásoknak nem szabad belső állapotot (stateless) tartalmazniuk, és függetlenek kell lenniük a végrehajtási környezettől. Ez lehetővé tette számunkra, hogy a növekvő terhelést egyszerű vízszintes méretezéssel kiküszöböljük. De volt egy kivételes szolgáltatásunk — a hosszú háttérfeladatok kezelője. Ez foglalkozott az e-mailek és SMS-ek küldésével, események feldolgozásával, feed-generálással, árak és készletek importálásával, képfeldolgozással. Valahogy úgy alakult, hogy függött a helyi fájl tárolótól, és egy példányban volt jelen.
Amikor a feldolgozó sorában lévő feladatok száma megnövekedett (ami természetesen történt a megrendelések számának növekedésével), a gazda teljesítménye, ahol a feldolgozó és a fájl tároló elhelyezkedett, lett a korlátozó tényező. Ennek következtében leállt a készlet és az árak frissítése, a felhasználóknak küldött értesítések továbbítása és sok más kritikus funkció, amelyek a sorban akadtak meg. Az Ops csapat gyorsan átköltöztette a fájl tárolót egy S3-szerű hálózati tárolóba, és ez lehetővé tette számunkra, hogy több erőteljes gépet indítsunk, hogy skálázzuk a háttér feladatok feldolgozóját.
Következtetés: A Stateless szabályt minden összetevőre vonatkozóan be kell tartani, kivétel nélkül, még akkor is, ha úgy tűnik, hogy "itt biztosan nem ütközünk bele". Jobb egy kicsit időt tölteni a rendszerek megfelelő megszervezésével, mint utána sietve újraírni a kódot és javítani a túlterhelt szolgáltatást.
7 elv az intenzív növekedéshez
Annak ellenére, hogy plusz kapacitások álltak rendelkezésre, a növekedés folyamán több buktatóba ütköztünk. Ez idő alatt a megrendelések száma több mint 4-szeresére nőtt. Jelenleg naponta már több mint 17 000 megrendelést kézbesítünk 62 városban, és tervezzük, hogy még inkább kiterjesztjük a tevékenységi területünket — 2020 első felében az egész Oroszországban várhatóan elindul a szolgáltatás. Annak érdekében, hogy megbirkózzunk a növekvő terheléssel, figyelembe véve a már szerzett tapasztalatokat, 7 alapelvet dolgoztunk ki a folyamatos növekedés körüli munkához:
- Incidens-menedzsment. Létrehoztunk egy táblát a Jirában, ahol minden incidens jegyként jelenik meg. Ez segít lényegében priorizálni és elvégezni az incidenshez kapcsolódó feladatokat. Mert lényegében nem veszélyes hibázni — a kétszer hibázni ugyanabban az ügyben már veszélyes. Azokban az esetekben, amikor az incidensek előbb ismétlődnek, mint ahogy a problémát meg tudjuk javítani, készen kell lennie egy cselekvési útmutatónak, mert nagy terhelés alatt fontos, hogy azonnal reagáljunk.
- Monitorozás minden infrastruktúraelemhez szükséges, kivétel nélkül. Éppen ennek köszönhetően tudtuk előre jelezni a terhelés növekedését, és helyesen kiválasztani a „szűk keresztmetszeteket” a prioritások kijelöléséhez. Valószínű, hogy nagy terhelés esetén minden elromlik vagy elkezd lelassulni, amiről nem is gondoltál. Éppen ezért a legújabb riasztásokat a legjobb az első incidensek bekövetkezte után azonnal létrehozni, hogy nyomon követhessük és megelőzhessük őket.
- Helyes riasztások elengedhetetlenek a hirtelen terhelésnövekedésnél. Először is, pontosan arról kell értesíteniük, ami elromlott. Másodszor, nem lehet sok riasztás, mert a sok nem kritikus riasztás figyelmen kívül hagyásához vezethet.
- Az alkalmazásoknak stateless-nek kell lenniük. Meggyőződtünk arról, hogy ennek a szabálynak nem lehetnek kivételei. Teljes függetlenség szükséges a futtatási környezettől. Ehhez megosztott adatokat tárolhatsz adatbázisban, vagy például közvetlenül az S3-ban. Még jobb, ha betartod a szabályokat.Hirtelen terhelésnél egyáltalán nincs idő a kód optimalizálására, ezért a terheléssel a számítási erőforrások közvetlen növelésével és a vízszintes skálázással kell megbirkózni.
- Külső szolgáltatások kvótái és teljesítménye. Gyors növekedés esetén a probléma nemcsak a te infrastruktúrádban, hanem a külső szolgáltatásokban is bekövetkezhet. A legfrusztrálóbb, amikor ez nem hiba miatt történik, hanem a kvóták vagy limitek elérése miatt. Tehát a külső szolgáltatásoknak ugyanolyan jól kell skálázódniuk, mint neked.
- Ossza szét a folyamatokat és a sorokat. Ez nagyon segít, amikor az egyik átjárónál dugó keletkezik. Nem tapasztalnánk adatátviteli késlekedéseket, ha a telített SMS küldési sorok nem zavarnák az információs rendszerek közötti értesítések cseréjét. Ráadásul a munkások számát is könnyebb lenne növelni, ha külön dolgoznának.
- Pénzügyi realitások. Amikor robbanásszerű növekedés zajlik az adatok áramlásában, nincs idő a tarifákra és előfizetésekre gondolni. De emlékezni kell rájuk, különösen, ha kisvállalkozás vagy. Nagy számlát bármely API tulajdonosa, valamint a te hosting szolgáltatód is kiállíthat. Ezért a szerződéseket alaposan el kell olvasni.
Zárás
Nem veszteségek nélkül, de túléltük ezt a szakaszt, és ma próbálunk ragaszkodni az összes felfedezett elvhez, és minden gépnek lehetősége van a teljesítményének 4-szeres növelésére, hogy megbirkózzon a váratlan helyzetekkel.
A következő bejegyzésekben megosztjuk tapasztalatainkat az Apache Solr teljesítménycsökkenésének vizsgálatáról, és beszámolunk a lekérdezések optimalizálásáról, valamint arról, hogy a NAV-val való együttműködés hogyan segít a cégnek pénzt megtakarítani. Iratkozzon fel blogunkra, hogy semmiről se maradjon le, és mesélje el a hozzászólásokban, hogy tapasztalt-e hasonló kellemetlenségeket a forgalom növekedése közben.
Csak a regisztrált felhasználók vehetnek részt a szavazáson. , kérem.
Volt valaha lassulásod/leszállásod a szolgáltatásban hirtelen terhelésnövekedés miatt?
55,6%Az azonnali számítási erőforrások hozzáadásának lehetetlensége10
16,7%A szolgáltató infrastruktúra korlátai3
33,3%Harmadik féltől származó API-k korlátai6
27,8%A saját alkalmazásaink stateless alapelveinek megsértése5
88,9%Saját szolgáltatások kódjának nem optimalizáltsága16
18 felhasználó szavazott. 6 felhasználó tartózkodott.
Forrás: habr.com
