

Pavlov Parchomenko vagyok, ML-fejlesztő. Ebben a cikkben szeretném bemutatni a Yandex Zen szolgáltatás működését, és megosztani technikai fejlesztéseket, amelyek bevezetése lehetővé tette a ajánlások minőségének növelését. A posztból megtudhatja, hogyan találhatók meg néhány milliszekundum alatt a legrelevánsabb dokumentumok a felhasználó számára a milliók közül; hogyan végezhető el a nagy mátrix folyamatos felbontása (millió oszloppal és több tízmillió sorral), hogy az új dokumentumok vektort kapjanak néhány percen belül; hogyan használható újra a felhasználó-cikk mátrix felbontása, hogy jó vektoriális reprezentációt kapjunk a videókhoz.
Ajánlórendszerünk millió dokumentumot tartalmaz különböző formátumban: szöveges cikkek, amelyeket a platformunkon készítettek és külső webhelyekről vettek, videók, narratívák és rövid posztok. Az ilyen jellegű szolgáltatás fejlesztése számos technikai kihívást hoz. Íme néhány közülük:
- A számítási feladatok szétválasztása: minden nehéz műveletet offline végezni, míg valós időben csak a modellek gyors alkalmazását végezni, hogy 100-200 ms-ra válaszoljunk.
- Gyorsan figyelembe venni a felhasználói tevékenységeket. Ehhez szükséges, hogy minden esemény azonnal eljusson az ajánlóba, és hatással legyen a modellek működésére.
- Olyan hírfolyam létrehozása, amely gyorsan alkalmazkodik az új felhasználók viselkedéséhez. A rendszerbe frissen érkező embereknek érezniük kell, hogy visszajelzésük hatással van az ajánlásokra.
- Gyorsan megérteni, kinek ajánljunk új cikket.
- Gyorsan reagálni az új tartalom folyamatos megjelenésére. Naponta több tízezer cikk jelenik meg, és soknak korlátozott élettartama van (például a hírek). Ez különbözteti meg őket a filmektől, zenétől és más hosszan tartó és drágán előállított tartalmaktól.
- Tudást átvinni egy doménből a másikba. Ha az ajánlórendszernek vannak kiképzett modelljei szöveges cikkekre, és videókat adunk hozzá, akkor a meglévő modellek új típusú tartalom jobb rangsorolásához is újra felhasználhatók.
Elmondom, hogyan oldottuk meg ezeket a feladatokat.
Jelöltek kiválasztása
Hogyan lehet néhány milliszekundum alatt jelentősen csökkenteni a dokumentumok számát anélkül, hogy gyakorlatilag rontanánk a rangsorolás minőségén?
Tegyük fel, hogy sok ML-modellt betanítottunk, és ezek alapján jellemzőket generáltunk, majd betanítottunk egy másik modellt, amely a felhasználó számára rangsorolja a dokumentumokat. Minden rendben lenne, de nem lehet egyszerűen az összes jellemzőt kiszámítani minden dokumentumra valós időben, ha ezek a dokumentumok milliószámra vannak, és a javaslatokat 100-200 ms alatt kell elkészíteni. A feladat az, hogy a milliók közül kiválasszunk egy részhalmazt, amelyet rangsorolni fogunk a felhasználó számára. Ezt a lépést általában jelölt- vagy kandidáló kiválasztásnak hívják. Ennek több követelménye van. Először is, a kiválasztásnak rendkívül gyorsan kell történnie, hogy a rangsorolásra a lehető legtöbb idő maradjon. Másodszor, a rangsorolásra szánt dokumentumok számának jelentős csökkentése mellett maximálisan meg kell őriznünk a felhasználó számára releváns dokumentumokat.
Kandidáló kiválasztási elvünk fokozatosan fejlődött, és jelenleg egy több lépcsős rendszerhez jutottunk:
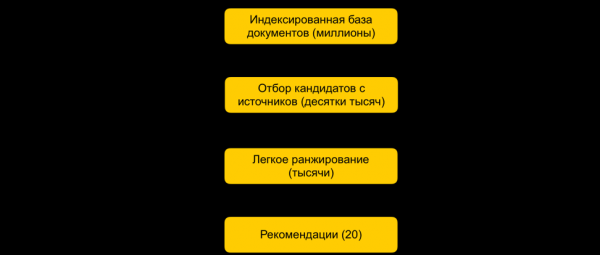
Kezdetben az összes dokumentumot csoportokra osztjuk, és minden csoportból a legnépszerűbb dokumentumokat vesszük. A csoportok lehetnek weboldalak, témák vagy klaszterek. Minden felhasználó számára az ő története alapján a legközelebb álló csoportokat választjuk ki, és ezekből vesszük a legjobb dokumentumokat. Emellett kNN-indexet is használunk, hogy a felhasználóhoz legközelebb álló dokumentumokat valós időben kiválasszuk. A kNN-index felépítésének több módszere létezik, számunkra a legjobban működött: (Hierarchical Navigable Small World grafikonok). Ez egy hierarchikus modell, amely lehetővé teszi, hogy néhány milliszekundum alatt megtaláljuk a felhasználó számára legközelebbi N vektort egy milliós adatbázisból. Előzetesen offline indexáljuk az összes dokumentumunkat. Mivel az indexben a keresés elég gyorsan működik, ha több erős embedder áll rendelkezésre, készíthetünk több indexet (minden embedderhez egy indexet), és minden egyes indexhez valós időben hozzáférhetünk.
Több tízezer dokumentum marad a felhasználók számára. Ez még mindig sok a jellemzők összeszámlálásához, így ezen a ponton könnyített rangsorolást alkalmazunk - egy nehezebb rangsor könnyített modelljét, kevesebb jellemzővel. A feladat az, hogy megjósoljuk, mely dokumentumok szerepelnek a nehéz modell legjobb helyein. A legmagasabb predikcióval rendelkező dokumentumokat használjuk a nehéz modellben, tehát a rangsorolás utolsó szakaszában. Ez a megközelítés lehetővé teszi, hogy néhány tizedmásodperc alatt a felhasználónak szánt dokumentumok alapját a milliókról ezerre csökkentsük.
ALS lépés futási időben
Hogyan lehet figyelembe venni a felhasználói visszajelzést azonnal kattintás után?
Fontos tényező a javaslatokban a felhasználói visszajelzésre való reakció idő. Ez különösen fontos új felhasználók számára: amikor valaki éppen csak elkezdi használni az ajánló rendszert, egy nem személyre szabott, különböző tematikájú dokumentumokból álló menüt kap. Amint az első kattintást végrehajtja, ezt azonnal figyelembe kell venni és a preferenciáihoz igazodni. Ha minden tényezőt offline számítunk, a rendszer gyors reakciója lehetetlenné válik a késleltetés miatt. Ezért a felhasználói tevékenységeket valós időben kell feldolgozni. E célokra futási időben ALS lépést használunk a felhasználói vektorális reprezentáció kialakításához.
Tegyük fel, hogy minden dokumentumnak van vektorális reprezentációja. Például offline, a cikk szövege alapján létrehozhatjuk az embeddingeket ELMo, BERT vagy más gépi tanulási modellek segítségével. Hogyan lehet a felhasználók vektorális reprezentációját ugyanabban a térben megszerezni az interakcióik alapján a rendszerben?
A felhasználó-dokumentum mátrix formálásának és lebontásának általános elveLegyen m felhasználónk és n dokumentumunk. Néhány felhasználó esetében ismert a dokumentumokkal kapcsolatos viszonyuk. Ezt az információt egy m x n mátrix formájában lehet megjeleníteni: a sorok a felhasználóknak, az oszlopok a dokumentumoknak felelnek meg. Mivel a legtöbb dokumentumot az emberek nem látták, a mátrix nagy része üresen marad, míg más cellák ki lesznek töltve. Minden eseményhez (tetszik, nem tetszik, kattintás) a mátrixban van valamilyen érték – de vizsgáljunk meg egy egyszerűsített modellt, ahol a tetszik 1-nek, a nem tetszik pedig -1-nek felel meg.
Bontsuk a mátrixot két részre: P (m x d) és Q (d x n), ahol d a vektoresemény dimenziója (általában ez egy kis szám). Ekkor minden objektumhoz d-dimenziós vektor fog tartozni (a felhasználónak a P mátrix sorában, a dokumentumnak a Q mátrix oszlopában). Ezek a vektorok szolgálnak az adott objektumok beágyazásaként. Ahhoz, hogy előre jelezzük, hogy egy felhasználónak tetszeni fog-e a dokumentum, egyszerűen megszorozzuk őket beágyazásaikkal.
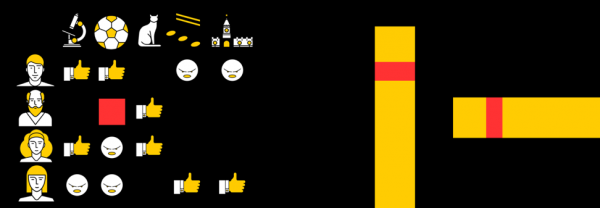
A mátrix egy lehetséges felbontási módja az ALS (Alternating Least Squares). Az alábbi veszteségfüggvényt fogjuk optimalizálni:

Itt rui a felhasználó u és az i dokumentum közötti interakció, qi az i dokumentum vektora, pu pedig a felhasználó u vektora.
Ezért a középérték négyzetes hiba szempontjából optimális felhasználói vektor (a dokumentum vektorok rögzítése mellett) analitikusan található meg a megfelelő lineáris regresszió megoldásával.
Ezt "ALS lépésnek" hívják. Az ALS algoritmus abban áll, hogy felváltva rögzítjük az egyik mátrixot (felhasználók és cikkek) és frissítjük a másikat, keresve az optimális megoldást.
Szerencsére a felhasználói vektorok megtalálása egy viszonylag gyors művelet, amelyet futási időben el lehet végezni vektoros utasítások segítségével. Ez a trükk lehetővé teszi, hogy azonnal figyelembe vegyük a felhasználói visszajelzést a rangsorolás során. Ugyanez a beágyazás felhasználható a kNN-indexben a jelöltek szűrésének javítására.
Elosztott kollaboratív szűrés
Hogyan végezzünk inkrementális elosztott mátrix faktorálást, és gyorsan találjunk vektorképviseletet új cikkekhez?
A tartalom nem az egyetlen forrása a javaslatoknak. Egy másik fontos forrás a kooperatív információ. A jó rangsorolási jelek hagyományosan a felhasználó-dokumentum mátrix szétszedéséből származnak. Azonban amikor megpróbáltuk ezt a szétszedést végrehajtani, problémákba ütköztünk:
1. Műveletünkben milliónyi dokumentum és tízmillió felhasználó van. A mátrix nem fér el egy gépen, ráadásul a szétszedés nagyon hosszadalmas lenne.
2. A rendszer tartalmának többsége rövid életű: a dokumentumok csak néhány órán át relevánsak. Ezért minél gyorsabban kell létrehozni a vektoros reprezentációjukat.
3. Ha a dokumentum közzététele után közvetlenül végezzük el a szétszedést, nem lesz elegendő idő, hogy a felhasználók megítéljék azt. Így a vektoros reprezentáció valószínűleg nem lesz valami jó.
4. Ha egy felhasználó like-ot vagy dislike-ot ad, ezt azonnal nem tudjuk figyelembe venni a szétszedésben.
A felsorolt problémák megoldásához végrehajtottuk a felhasználó-dokumentum mátrix elosztását gyakori inkrementális frissítéssel. Hogyan működik ez pontosan?
Tegyük fel, hogy van egy N gépből álló klaszterünk (N számos a százakban), és el szeretnénk végezni egy elosztott szétszedést egy olyan mátrixon, amely nem fér el egy gépen. A kérdés — hogyan lehet ezt a szétszedést végrehajtani úgy, hogy egyrészt minden gépen elegendő adat legyen, másrészt pedig a számítások függetlenek maradjanak?
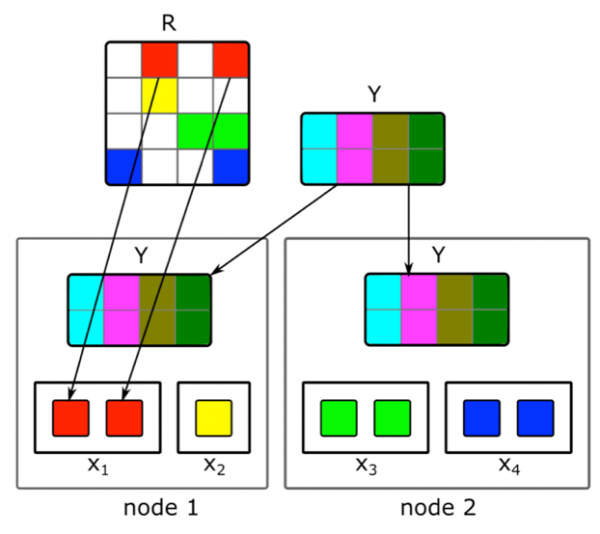
Az előzőleg leírt ALS szétszedési algoritmust fogjuk használni. Nézzük meg, hogyan lehet elosztott módon végrehajtani egy lépést az ALS-ből — a többi lépés hasonló lesz. Tegyük fel, hogy a dokumentummátrixunk rögzített, és az felhasználói mátrixot szeretnénk létrehozni. Ehhez felosztjuk N részre sorok szerint, mindegyik rész körülbelül azonos számú sorral fog bírni. Az összes gépre megfelelõ sorok nem üres celláit és a dokumentumok embedding mátrixát (teljes egészében) elküldjük. Mivel annak mérete nem túl nagy, míg a felhasználó-dokumentum mátrix általában erősen szórt, ezek az adatok elférnek egy hagyományos gépen.
Ez a trükk több kor során keresztül megismételhető a modell konvergenciájának eléréséig, fokozatosan változtatva a rögzített mátrixon. De még így is a mátrix felbontása órákig tarthat. És ez nem oldja meg a problémát, hogy gyorsan kell megtartani az új dokumentumok beágyazását, valamint frissíteni azokat a beágyazásokat, amelyekről kevés információ állt rendelkezésre a modell kiépítésekor.
Segített nekünk a modell gyors inkrementális frissítésének bevezetése. Tegyük fel, hogy van egy jelenlegi betanított modellünk. A betanítása óta új cikkek jelentek meg, amelyekkel a felhasználóink interakcióba léptek, és olyan cikkek, amelyek betanítás közben kevés interakciót kaptak. Az ilyen cikkek gyors beágyazásának eléréséhez használjuk a felhasználók beágyazásait, amelyek az első nagyobb modellbetanítás során készültek, és egy ALS lépést végzünk, hogy a dokumentumok mátrixát kiszámolhassuk egy rögzített felhasználói mátrixon. Ez lehetővé teszi számunkra, hogy a beágyazásokat meglehetősen gyorsan — néhány percen belül a dokumentum közzététele után — megszerezzük, és gyakran frissítsük a friss dokumentumok beágyazásait.
Annak érdekében, hogy a javaslatok során az emberi tevékenységeket azonnal figyelembe vegyük, a futási időben nem használunk offline környezetből származó felhasználói beágyazásokat. Ehelyett ALS lépést végzünk, és megkapjuk a felhasználó aktuális vektort.
Áthelyezés egy másik doménbe
Hogyan használható a felhasználói visszajelzés a szöveges cikkekhez a videók vektoralapú reprezentációjának felépítésére?
Eredetileg csak szöveges cikkeket ajánlottunk, ezért sok algoritmusunk erre a tartalom típusra van optimalizálva. De amikor más típusú tartalmakat adtunk hozzá, a modellek adaptációjának szükségességével szembesültünk. Hogyan oldottuk meg ezt a feladatot a videók esetében? Az egyik lehetőség az, hogy az összes modellt a nulláról újra betanítjuk. De ez időigényes, ráadásul egyes algoritmusok igényesek a tanulási minta nagyságára, amelyből az új típusú tartalom esetében az első pillanatokban még nem áll rendelkezésre a szükséges mennyiség.
Más különböző utat választottunk, és újra felhasználtuk a videószövegmodelleket. A videók vektoros reprezentációjának létrehozásában ugyanaz a trükk segített az ALS-szel. A felhasználói vektoros reprezentációt szöveges cikkek alapján vettük, és ALS lépést hajtottunk végre a videómegtekintésekről származó információk felhasználásával. Így könnyen megkaptuk a videó vektoros reprezentációját. Futásidőben egyszerűen kiszámítjuk a közelséget a felhasználói vektor és a videó vektora között.
Zárás
A valós idejű ajánlórendszer magjának fejlesztése számos feladattal jár. Gyorsan kell feldolgozni az adatokat, és ML-módszereket kell alkalmazni ezek hatékony felhasználásához; bonyolult elosztott rendszereket kell építeni, amelyek minimális idő alatt képesek feldolgozni a felhasználói jeleket és az új tartalmi egységeket; és még sok más feladat.
A meglévő rendszerben, amelynek felépítését leírtam, a felhasználói ajánlások minősége nő a aktivitással és a szolgáltatásban eltöltött idővel. Ám itt rejlik a legfőbb nehézség is: a rendszernek nehéz azonnal megérteni egy olyan személy érdeklődési körét, aki alig lépett interakcióba a tartalommal. Az új felhasználók ajánlásainak javítása a kulcsfontosságú feladatunk. Továbbra is optimalizálni fogjuk az algoritmusokat, hogy a számukra releváns tartalom gyorsabban eljusson az ő hírfolyamukba, míg a nem releváns ne jelenjen meg.
Forrás: habr.com
