

Az nevem Anton Baderin. A Magas Technológiai Központban dolgozom, és rendszergazdálkodással foglalkozom. Egy hónappal ezelőtt befejeződött a vállalati konferenciánk, ahol megosztottuk tapasztalatainkat a városunk IT közösségével. Én a webalkalmazások monitorozásáról beszéltem. Anyagom junior vagy middle szintűeknek készült, akik nem állították össze ezt a folyamatot nulláról.
A monitoring rendszerének alapját képező sarokkövünk a vállalati igények megoldása. A monitorozás önmagában senkit sem érdekel. De mit szeretne a vállalat? Azt szeretné, hogy minden gyorsan és hiba nélkül működjön. A vállalat proaktivitást vár el tőlünk, hogy mi magunk észleljük a szolgáltatás működésében felmerülő problémákat, és a lehető leggyorsabban orvosoljuk azokat. Ez lényegében az a feladat, amit az előző év során egy ügyfelünk projektjén megoldottam.
A projektről
A projekt az ország egyik legnagyobb lojalitási programja. Segítünk a kiskereskedelmi láncoknak növelni az értékesítés gyakoriságát különféle marketing eszközök, például bónusz kártyák révén. Összesen 14 alkalmazás alkotja a projektet, amelyek tíz szerveren működnek.
Beszélgetések során többször észrevettem, hogy az adminisztrátorok nem mindig a megfelelő módon közelítik meg a webalkalmazások monitorozását: sokan még mindig a rendszerszintű metrikákra korlátozódnak, és ritkán figyelik a szolgáltatásokat.
Az ügyfelem monitoring rendszerének alapját korábban az Icinga képezte. Ez a feladatokat egyáltalán nem oldotta meg. Gyakran az ügyfél maga értesített minket a problémákról, és nem ritkán egyszerűen hiányoztak az adatok, hogy kiderítsük az okokat.
Ezen kívül világos volt a rendszer további fejlesztésének kilátástalansága. Azt hiszem, azok, akik ismerik az Icingát, megértenek. Így úgy döntöttünk, hogy teljesen újraépítjük a webalkalmazások monitorozó rendszerét a projektünkben.
Prometheus
A Prometheust három alapvető mutató alapján választottuk:
- Rengeteg elérhető metrika áll rendelkezésre, összesen 60 ezer. Persze, érdemes megjegyezni, hogy ezek többségét (kb. 95%) nem használjuk. Ugyanakkor viszonylag olcsók. Ez másik szélsőség számunkra, a korábban használt Icingához képest. Ott a metrikák hozzáadása különösen fájdalmas volt: a már meglévők árban drágák voltak (elég csak megnézni bármely plugin forrásait). Minden plugin egy Bash vagy Python szkript volt, amelyek futtatása erőforrásigényes volt.
- Ez a rendszer viszonylag kevés erőforrást fogyaszt. Az összes metrikánkhoz elegendő 600 MB RAM, 15% egy mag és néhány tucat IOPS. Persze, futtatni kell a metrika-exportálókat, de mind Go nyelven íródtak, és szintén nem igényelnek sok erőforrást. Nem gondolom, hogy ez problémát jelent a mai körülmények között.
- Lehetőséget ad a Kubernetesbe való áttérésre. Figyelembe véve a megrendelő terveit — a választás nyilvánvaló.
ELK
Korábban nem gyűjtöttünk és nem dolgoztunk fel naplókat. A hátrányok mindenki számára világosak. Az ELK mellett döntöttünk, mivel már volt tapasztalatunk ezzel a rendszerrel. Csak az alkalmazások naplóit tároljuk ott. A fő választási szempontok a teljes szövegű keresés és annak sebessége voltak.
Clickhouse
Kezdetben az InfluxDB-t választottuk. Tudtuk, hogy szükség van az Nginx logok gyűjtésére, a pg_stat_statements statisztikáira, valamint a Prometheus történeti adatainak tárolására. Az Influx nem nyerte el a tetszésünket, mivel időnként nagy mennyiségű memóriát kezdett el fogyasztani és összeomlott. Ezen kívül szeretnénk a lekérdezéseket remote_addr szerint csoportosítani, de ebben az adatbázis-kezelőben a csoportosítás csak címkék alapján lehetséges. A címkék drágák (memória), számuk pedig korlátozott.
Új keresést kezdtünk. Analitikai alapra volt szükség minimális erőforrás-fogyasztással, lehetőleg az adatok lemezre tömörítésével.
A Clickhouse minden ilyen kritériumnak megfelel, és választásunkra egyszer sem bántuk meg. Nem írunk bele kiemelkedő mennyiségű adatot (a másodpercenkénti beszúrások száma összesen körülbelül ötezer).
NewRelic
A NewRelic történelmileg mindig is velünk volt, mivel ez volt a megrendelő választása. Nálunk APM-ként használják.
Zabbix
A Zabbixot kizárólag a Black Box különböző API-jainak figyelésére használjuk.
A megfigyelési megközelítés meghatározása
Szerettük volna dekomponálni a feladatot és ezzel rendszerezni a megfigyelés megközelítését.
Ezért a rendszert a következő szintekre osztottam:
- „hardver” és VMS;
- operációs rendszer;
- rendszerszolgáltatások, szoftverstack;
- alkalmazás;
- üzleti logika.
Milyen előnye van ennek a megközelítésnek:
- tudjuk, ki felelős az egyes szintek működéséért, és ennek megfelelően riasztásokat küldhetünk;
- a struktúrát a riasztások leállításakor is használhatjuk – furcsa lenne, ha adatbázis-elérhetetlenségről küldenénk riasztást, amikor az egész virtuális gép elérhetetlen.
Mivel a feladatunk a rendszer működési zavarainak azonosítása, minden szinten ki kell emelni egy adott mérési szettet, amelyre figyelmet kell fordítani a riasztási szabályok írásakor. Ezután áttekintjük a „VMS”, „Operációs rendszer” és „Rendszerszolgáltatások, szoftverstack” szinteket.
Virtuális gépek
Tárhely kiemeli a processzort, a lemezt, a memóriát és a hálózatot. Az első kettővel problémáink voltak. Tehát a mutatók:
CPU stolen time — amikor virtuális gépet vásárol az Amazonon (például t2.micro), értenie kell, hogy nem kap egy teljes processzormagot, csak a rendelkezésére álló idő arányát. Amikor ezt kimeríti, a CPU-t elkezdik elvenni.
Ez a mutató lehetővé teszi az ilyen pillanatok nyomon követését és döntések hozását. Például, szükség van-e erősebb tarifára vagy a háttérfeladatok és az API-kérések feldolgozását különböző a szerver.
IOPS + CPU iowait time — valamiért sok felhőszolgáltatás hibázik, hogy nem ad elegendő IOPS-t. Ráadásul a low IOPS grafikon számukra nem érvet jelent. Ezért érdemes gyűjteni a CPU iowait-ot is. Ezzel a két grafikon párossal — alacsony IOPS és magas bemeneti/kimeneti várakozás — már lehet beszélni a szolgáltatóval és megoldani a problémát.
Operációs rendszer
Az operációs rendszer mutatói:
- a rendelkezésre álló memória százalékos aránya;
- a swap használatának aktivitása: vmstat swapin, swapout;
- az elérhető inode-ok és a fájlrendszer szabad helyének százalékos aránya
- átlagos terhelés;
- a tw állapotú kapcsolatok száma;
- a conntrack táblázat telítettsége;
- a hálózat működésének minőségét az ss segédprogrammal figyelhetjük, az iproute2 csomaggal – elérhetjük a kimenet RTT mutatóját és az adatokat célport szerint csoportosíthatjuk.
Az operációs rendszer szintjén megjelenik egy olyan entitás, mint a folyamatok. Fontos kiválasztani a rendszerben azokat a folyamatokat, amelyek kulcsszerepet játszanak a működésében. Például, ha több pgpool-ja van, akkor mindegyikükre vonatkozóan információt kell gyűjteni.
A kiválasztott mutatók a következők:
- CPU;
- a memória — elsősorban a rendszer memória;
- IO — lehetőleg IOPS-ban;
- FileFd — nyitott és limit;
- létfontosságú oldalszámítások — így megértheti, mely folyamat swap-el.
Az összes monitorozásunk Dockerben fut, az metrikák adatainak gyűjtéséhez a Сadvisor-t használjuk. A többi gépen process-exportert alkalmazunk.
Rendszerszolgáltatások, szoftverstack
Minden alkalmazásnak megvan a maga sajátossága, és nehéz kiemelni egy meghatározott metrikakészletet.
Az univerzális készlet a következőket tartalmazza:
- lekérdezési arány;
- hiba mennyisége;
- késleltetés;
- telítettség.
A leglényegesebb monitorozási példák nálunk az Nginx és a PostgreSQL.
A legnagyobb terhelésű szolgáltatás a rendszerünkben az adatbázis. Korábban gyakran voltak nehézségeink kideríteni, hogy mivel foglalkozik az adatbázis.
Láttuk a lemezek magas terhelését, de a slow logok nem mutattak gyakorlatilag semmit. Ezt a problémát a pg_stat_statements segítségével oldottuk meg, amely nézetben összegyűlik a lekérdezések statisztikája.
Ez minden, amire egy adminisztrátornak szüksége van.
Grafikonokat építünk a lekérdezések olvasási és írási aktivitásáról:
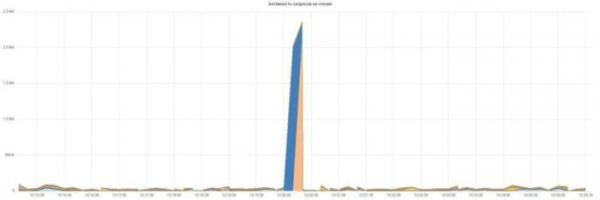
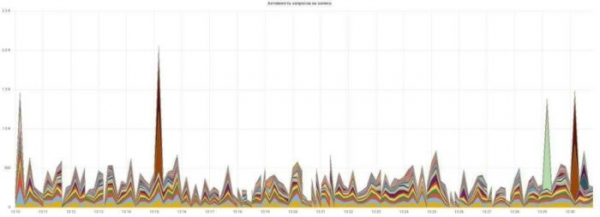
Minden egyszerű és világos, minden lekérdezésnek — saját színe van.
Nem kevésbé figyelemre méltó példa — az Nginx logok. Nem meglepő, hogy kevesen elemzik őket vagy említik a kötelező listában. A standard formátum nem túl informatív, és bővíteni kell.
Személy szerint hozzátettem a request_time, upstream_response_time, body_bytes_sent, request_length, request_id-ot. Grafikonokat építünk a válaszidőről és a hibák számáról:
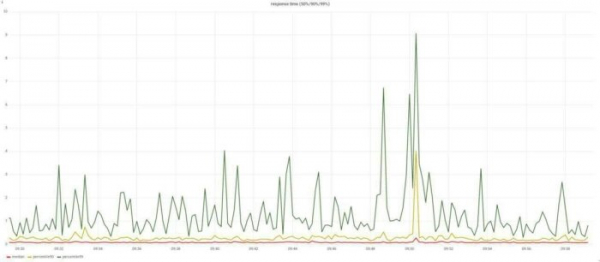
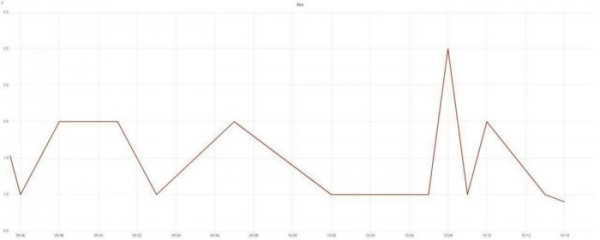
Grafikonokat építünk a válaszidőről és a hibák számáról. Emlékszik? A vállalkozás feladataira beszéltem? Hogy gyorsan és hibák nélkül? Már két grafikon e kérdések mentén lezárta. És alapjánuk már lehet hívni a ügyeletes adminisztrátorokat.
De maradt egy probléma — gyorsan megszüntetni az incidens okát.
Incidens felszámolás
Az egész folyamatot azonosítástól a probléma megoldásáig több lépésre lehet bontani:
- a probléma azonosítása;
- az ügyeletes adminisztrátor értesítése;
- reakció az incidensre;
- az okok megszüntetése.
Fontos, hogy ezt a lehető leghamarabb meg kell tennünk. Ha az incidens azonosításának és az értesítésnek a lépéseinél különösebben időt nyerni nem tudunk — mindkettőhöz két perc fog menni mindenképpen, a továbbiak viszont — egyszerű, megm műveletlen terület a fejlesztésekhez.
Képzeljük el, hogy a diszpécser telefonja megcsörren. Mit fog tenni? Keresni fogja a válaszokat a kérdésekre - mi hibásodott meg, hol hibásodott meg, hogyan kell reagálni? Így válaszolunk ezekre a kérdésekre:
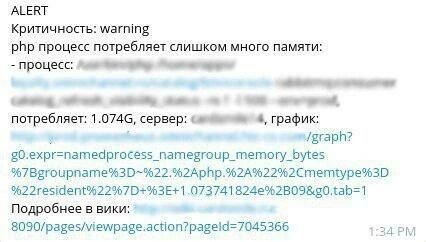
Egyszerűen beépítjük az összes információt az értesítés szövegébe, és hivatkozást adunk rá arra az oldalra a wikiben, ahol le van írva, hogyan kell reagálni erre a problémára, hogyan kell megoldani és eszkalálni azt.
Még nem beszéltem a alkalmazás és az üzleti logika szintjéről. Sajnos az alkalmazásainkban még nem lett megvalósítva a metrikák gyűjtése. Az egyetlen forrás, ami valamilyen információt nyújt ezekről a szintekről, a naplók.
Néhány dolog.
Először is, írjon strukturált naplókat. Ne kelljen a kontextust a üzenet szövegébe belefoglalni. Ez megnehezíti a csoportosítást és az elemzést. A Logstash sok időt igényel, hogy mindezt normalizálja.
Másodszor, helyesen használja a severity szinteket. Minden nyelvnek megvan a saját sztenderdje. Én személy szerint négy szintet különböztetek meg:
- nincs hiba;
- hiba az ügyfél oldalán;
- hiba a mi oldalunkon, nem veszítünk pénzt, nem hordozunk kockázatokat;
- hiba a mi oldalunkon, pénzt veszítünk.
Összefoglalva. Arra kell törekedni, hogy a monitorozást pontosan az üzleti logika alapján építsük fel. Próbáljon meg monitorozni magát az alkalmazást, és olyan metrikákkal operálni, mint az eladások száma, új felhasználói regisztrációk száma, aktív felhasználók száma stb.
Ha az egész vállalkozása egy gomb a böngészőben, akkor figyelnie kell, hogy megnyomják-e azt, működik-e megfelelően. Minden más nem fontos.
Ha nincs meg ez, megpróbálhatja ezt a naplókban, Nginx naplókban és így tovább pótolni, ahogy mi tettük. A lehető legközelebb kell lennie az alkalmazáshoz.
Az operációs rendszer metrikái természetesen fontosak, de az üzlet számára nem érdekesek, nem ezért fizetnek nekünk.
Forrás: habr.com
