

Az utóbbi években az időbeli sorozatok adatbázisai (Time-series databases) a különleges megoldásokból (amelyek vagy nyílt monitorozó rendszerekben alkalmazhatók, vagy Big Data projektekhez tartoznak) a "tömegtermékké" váltak. Oroszország területén külön köszönet illeti ezért a Yandexet és a ClickHouse-t. Eddig, ha nagy mennyiségű időbeli sorozat adatot kellett megőrizni, elkerülhetetlenül monstrózus Hadoop-stackot kellett felépíteni és karbantartani, vagy specifikus protokollokkal kellett foglalkozni, amelyek minden rendszerhez különbözők.
Lehet, hogy 2019-ben egy cikk arról, hogy melyik TSDB-t érdemes használni, csak annyiból áll: "csak használd a ClickHouse-t". De... vannak nüanszok.
Valóban, a ClickHouse aktívan fejlődik, a felhasználói bázis nő, és a támogatás nagyon aktívan zajlik, de nem váltunk-e a ClickHouse nyilvános sikerének foglyává, amely eltakarja más, esetleg hatékonyabb/biztosabb megoldásokat?
Tavaly év elején elkezdtük átdolgozni a saját monitorozó rendszerünket, amelynek során felmerült a kérdés, hogy melyik adatbázist válasszuk az adatok tárolására. Erről a választás történetéről akarok itt beszélni.
Lépjünk át a kitűzött feladatra: írjunk egy XDP mechanizmust SYN cookie-kkal.
Elsősorban — a szükséges előszó. Miért van szükségünk egyáltalán a saját monitorozó rendszerünkre, és hogyan működött ez?
2008 óta nyújtunk támogatási szolgáltatásokat, és 2010-re világossá vált, hogy nehézkessé vált az ügyfél infrastruktúrájában zajló folyamatok adatait az akkor létező megoldásokkal aggregálni (itt a szörnyetegek, a Cacti, a Zabbix és a születő Graphite-ra gondolunk).
Legfontosabb követelményeink a következők voltak:
- támogatás (akkor éppen több tucat, a jövőben pedig több száz) ügyfél egy rendszeren belül, emellett központosított figyelmeztetési rendszer megléte;
- a figyelmeztetési rendszer rugalmas kezelése (figyelmeztetések eskalálása a műszakban lévők között, ütemezés figyelembevétele, tudásbázis);
- grafikonok részletes alakítása (a Zabbix akkor grafikákat képként jelenített meg);
- nagy mennyiségű adat hosszú ideig való tárolása (egy év és több) és azok gyors lekérdezésének lehetősége.
A cikkben a legutolsó pontra fogunk összpontosítani.
A tárolásról beszélve, a követelmények a következők voltak:
- a rendszernek gyorsan kell működnie;
- előnyös lenne, ha a rendszer SQL interfésszel rendelkezne;
- a rendszernek stabilnak kell lennie, és aktív felhasználói bázissal és támogatással kell rendelkeznie (mert egy időben szembesültünk azzal a szükséglettel, hogy olyan rendszereket támogassunk, mint például a MemcacheDB, amelyet már nem fejlesztettek, vagy a disztribúciós tároló MooseFS, amelynek hibakövetése kínai nyelven folyt: nem akartuk, hogy hasonló történetet éljünk át a projektünkben);
- a CAP-tétel megfelelősége: Együttműködés (szükséges) — az adatoknak naprakészeknek kell lenniük, nem akarjuk, hogy az értesítési rendszer ne kapjon új adatokat, és figyelmeztetések terjengenek a projektek adathiányáról; Partíciós Tolerancia (szükséges) — nem akarunk Split Brain rendszert kapni; Elérhetőség (nem kritikus, ha létezik aktív replikáció) — saját kezűleg tudunk áttérni a tartalék rendszerre szükség esetén, kód alapján.
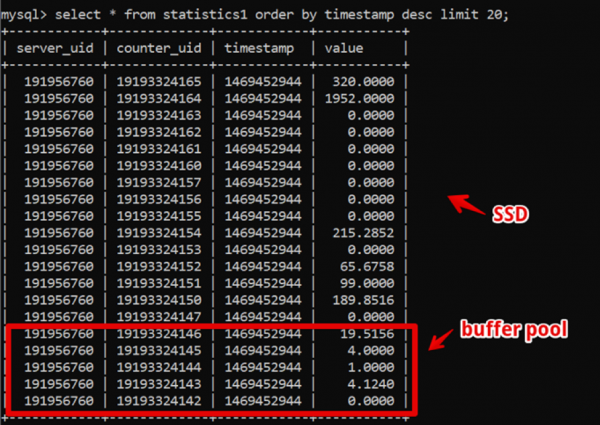
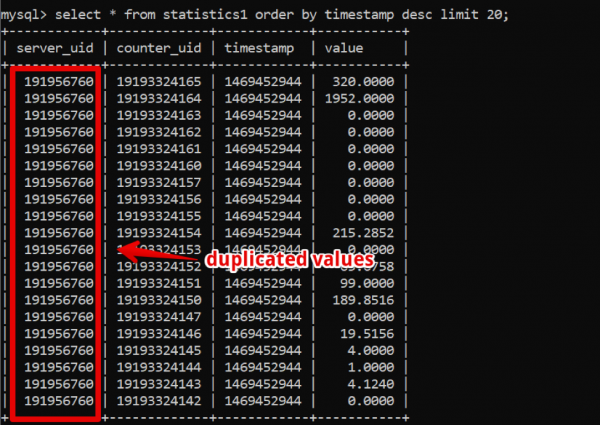
Ami furcsa, de abban az időben a MySQL bizonyult az ideális megoldásnak számunkra. Az adatstruktúránk rendkívül egyszerű volt: szerver id, számláló id, timestamp és érték; a forró adatközlések gyors lekérdezését a nagy buffer pool méret biztosította, míg a történelmi adatok lekérdezését SSD végezte.
Így elértük a friss kétéves adatok lekérdezését másodpercre bontva 200 ms alatt az adatok teljes megjelenítése előtt, és elég sokáig éltünk ebben a rendszerben.
Időközben azonban telt az idő és az adatmennyiség nőtt. 2016-ra az adatok mennyisége több tucat terabájtot ért el, ami a bérelt SSD-tárolók körülményei között jelentős költséget jelentett.
Ekkorra az oszlop alapú adatbázisok aktívan elterjedtek, amikről elkezdtünk komolyan gondolkodni: az oszlop alapú DB-k úgy tárolják az adatokat, ahogy az érthető, oszlopokban, és ha ránézünk az adatainkra, könnyen látható, hogy sok ismétlődő adat van, amit oszlop alapú DB használatával tömöríteni lehetne.
A fő működési rendszerünk azonban továbbra is stabilan működött, és nem akartunk kísérletezni valami másra való áttéréssel.
2017-ben a San José-i Percona Live konferencián a Clickhouse fejlesztői talán először mutatkoztak be. Első pillantásra a rendszer production-ready volt (nos, a Yandex.Metrica egy szigorú produkció), a támogatás gyors és egyszerű volt, és ami a legfontosabb, a használata is egyszerű volt. 2018 óta elkezdtük a folyamatot a váltásra. De addigra sok 'érett' és időben bevált TSDB rendszer létezett, és úgy döntöttünk, hogy jelentős időt szánunk arra, hogy összehasonlítsuk az alternatívákat, hogy megbizonyosodjunk arról, hogy a Clickhouse-hoz képest nincs alternatív megoldás, amely megfelel a követelményeinknek.
A már említett tárolási követelmények mellett újabbak is felmerültek:
- az új rendszernek legalább olyan teljesítményt kell biztosítania, mint a MySQL, ugyanazon a hardveren;
- az új rendszer tárolásának jelentősen kevesebb helyet kell foglalnia;
- Az SQL adatbáziskezelőnek továbbra is egyszerűnek kell lennie a kezelés szempontjából;
- a lehető legkisebb mértékben szeretnénk módosítani az alkalmazást az adatbázis-kezelő váltásakor.
Milyen rendszereket kezdtünk el megvizsgálni
Apache Hive/Apache Impala
A régi, megbízhatatlan Hadoop-stack. Alapvetően ez egy SQL-interfész, amely a saját formátumaiban tárolt adatokra épül az HDFS-en.
Előnyök.
- Stabil üzemeltetés mellett nagyon egyszerű az adatok skálázása.
- Vannak oszlop-alapú megoldások az adatok tárolására (kevesebb helyet foglal).
- Nagyon gyorsan hajtja végre a párhuzamos feladatokat a rendelkezésre álló erőforrásokkal.
Hátrányok.
- Ez Hadoop, és nehéz üzemeltetni. Ha nem vagyunk készen arra, hogy felhőalapú megoldást vegyünk (ami költség szempontjából nem állt rendelkezésre), akkor az egész stack-et adminisztrátoroknak kell összeállítaniuk és karbantartaniuk, amit nagyon nem szeretnénk.
- Az adatok aggregálódnak .
Viszont:
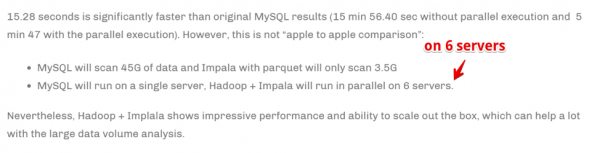
A sebesség a számítási szerverek számának skálázásával érhető el. Egyszerűbben fogalmazva, ha egy nagy cég vagyunk, amely analitikával foglalkozik, és üzleti szempontból kritikus fontosságú, hogy a lehető leggyorsabban aggregáljuk az információt (még ha sok számítási erőforrás felhasználásának árával is jár), ez lehet a választásunk. De nem voltunk készen arra, hogy radikálisan megnöveljük a hardverparkot a feladatok sebességének javítása érdekében.
Druid/Pinot
Ez már sokkal inkább a TSDB-ről szól, de megint csak - Hadoop-stack.
Van .
Ha néhány szóval kellene összefoglalni: a Druid/Pinot jobban teljesít a Clickhouse-nál olyan esetekben, amikor:
- Heterogén adatszerkezettel rendelkezik (ebben az esetben csak a szervermetrikák időbeli sorait rögzítjük, és lényegében ez egy táblázat. De lehetnek más esetek is: berendezések időbeli sorai, gazdasági időbeli sorok stb. — mindegyik saját szerkezetével, amelyeket aggregálni és feldolgozni kell).
- Ezekből az adatokból nagyon sok van.
- Az időbeli sorokkal rendelkező táblázatok és adatok megjelennek és eltűnnek (azaz egy adathalmaz érkezett, elemezték, majd eltávolították).
- Nincs világos kritérium, amely alapján az adatokat partícionálni lehetne.
Ellenkező esetekben a ClickHouse jobban teljesít, és ez a mi esetünk.
clickhousedb_fdw
- SQL-szerű.
- Könnyen kezelhető.
- Az emberek azt mondják, hogy működik.
A tesztelés rövidlistájára kerül.
InfluxDB
Külföldi alternatíva a ClickHouse számára. Hátrányként: a magas rendelkezésre állás csak a kereskedelmi verzióban érhető el, de össze kell hasonlítani.
A tesztelés rövidlistájára kerül.
Cassandra
Egyrészt tudjuk, hogy az ilyen rendszerek, mint például, időbeli metrikus sorok tárolására használják vagy OkMeter. Ugyanakkor van egy speciális vonás.
A Cassandra nem klasszikus értelemben vett oszlopos adatbázis. Inkább sorosnak tűnik, de minden sorban eltérő számú oszlop lehet, ami megkönnyíti az oszlopos megjelenítést. Ebben az értelemben érthető, hogy a 2 milliárd oszlopos korlátozás mellett bizonyos adatokat lehet tárolni oszlopokban (például ugyanazokat az időbeli sorokat). Például a MySQL-ben 4096 oszlop a korlátozás, és könnyen belefuthatunk a 1117 kódú hibába, ha megpróbálunk ugyanezt tenni.
A Cassandra motor is focused on storing large volumes of data in a distributed system without a master, and in the aforementioned CAP theorem, Cassandra leans more towards AP, which means data availability and resilience against partitioning. Therefore, this tool can be perfectly suited if you only need to write to this database and read from it infrequently. It makes sense to use Cassandra as a "cold" storage solution. In other words, as a long-term reliable place to store large amounts of historical data that are rarely needed, but can be retrieved if necessary. However, for the sake of completeness, we will also test it. But, as I mentioned earlier, there is no desire to actively rewrite the code for the chosen database solution, so we will test it somewhat limitedly—without adapting the database structure to the specifics of Cassandra.
Prometheus
Well, out of curiosity, we decided to test the performance of the Prometheus storage—just to understand whether we are faster than the current solutions or slower, and by how much.
Testing methodology and results
So, we tested 5 databases in the following 6 configurations: ClickHouse (1 node), ClickHouse (distributed table on 3 nodes), InfluxDB, MySQL 8, Cassandra (3 nodes), and Prometheus. The testing plan is as follows:
- We upload historical data for a week (840 million values per day; 208 thousand metrics);
- We generate write load (considering 6 load modes, see below);
- Simultaneously with the writing, we periodically perform queries, emulating a user working with graphs. To avoid complicating things too much, we selected data for 10 metrics (exactly how many there are in the CPU graph) for a week.
We load, simulating the behavior of our monitoring agent, which sends values to each metric every 15 seconds. At the same time, we are interested in varying:
- The total number of metrics into which data is written;
- The interval for sending values to one metric;
- The size of the batch.
About the batch size. Since almost all of our test databases do not recommend being loaded with single inserts, we will need a relay that collects incoming metrics, groups them somehow, and writes them into the database using a batch insert.
Ahhoz, hogy jobban megértsük, hogyan értelmezzük később az adatokat, tegyük fel, hogy nem csak egy csomó metrikát küldünk, hanem a metrikák szerverekbe vannak szervezve - 125 metrika per szerver. Itt a szerver egyszerűen egy virtuális entitás - csak hogy megértsük, hogy például 10000 metrika körülbelül 80 szervernek felel meg.
És most, mindezt figyelembe véve, itt vannak a 6 írási terhelési üzemmódunk:
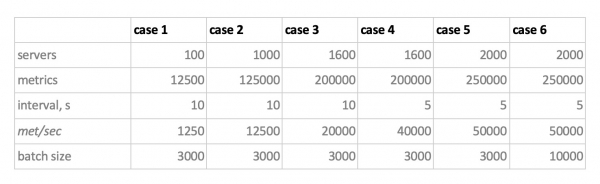
Két dolog van. Először is, a Cassandrának ezek a batch méretek túl nagyok voltak, ott 50 vagy 100-as értékeket használtunk. Másodszor, mivel a Prometheus szigorúan pull módban működik, vagyis saját magától megy és gyűjti az adatokat a metrikaforrásokból (és még a pushgateway, a nevével ellentétben, alapvetően nem változtat a helyzeten), a megfelelő terhelések statikus konfigurációk kombinációjával valósultak meg.
A tesztelési eredmények a következők:
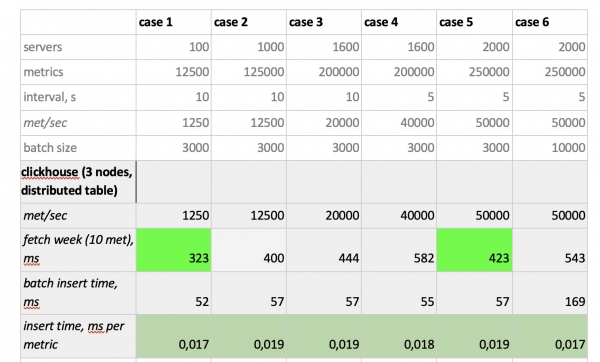
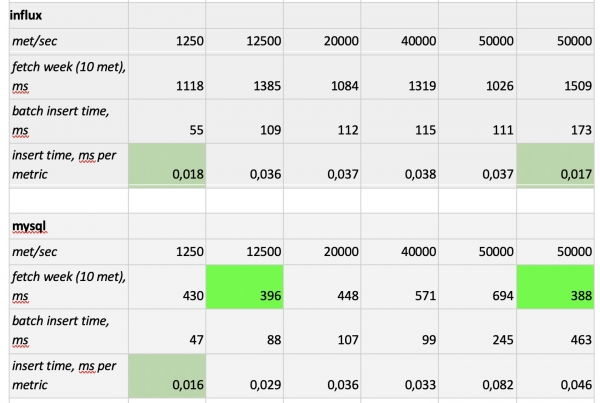
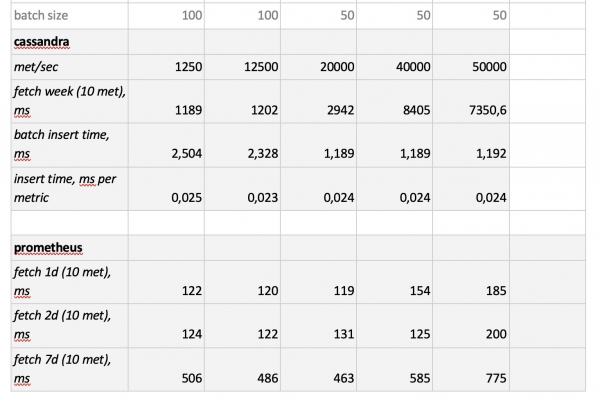
Amit érdemes megemlíteni: a Prometheus-ból fantasztikusan gyors lekérdezések, a Cassandrából borzasztóan lassú lekérdezések, az InfluxDB-ből elfogadhatatlanul lassú lekérdezések; írási sebességben a ClickHouse mindet legyőzte, és a Prometheus nem vesz részt a versenyben, mivel ő maga végzi az inserteket belül, és mi semmit nem mérünk.
Végül: a ClickHouse és az InfluxDB teljesítette a legjobban, de az Influx klasztert csak az Enterprise verzió alapjával lehet felépíteni, ami pénzbe kerül, míg a ClickHouse ingyenes és Oroszországban készült. Logikus, hogy az Egyesült Államokban talán az InfluxDB mellett döntenek, nálunk pedig a ClickHouse mellett.
Forrás: habr.com
