

Helló! A nevem Alekszej Pjankov, a Sportmester fejlesztője vagyok. Ebben elmondom, hogyan indult a Sportmester weboldalának munkája 2012-ben, milyen kezdeményezéseket sikerült "előnyomni", és éppen ellenkezőleg, milyen buktatókat gyűjtöttünk össze.
Ma szeretném megosztani azokat a gondolatokat, amelyek egy másik témára vonatkoznak – a cache rendszer kiválasztására a Java backendhez a weboldal adminisztrációs felületén. Ez a téma különösen fontos számomra – bár a történet csupán 2 hónapig tartott, ezekben a 60 napban 12-16 órát dolgoztunk, egyetlen nap szünet nélkül. Soha nem gondoltam volna, és nem is képzeltem, hogy ennyit lehet dolgozni.
Ezért a szöveget 2 részre bontom, hogy ne terheljem túl a kedves olvasót. Az első rész nagyon könnyű lesz – egy bevezetés, néhány átgondolás a cache-elésről. Ha már tapasztalt fejlesztő vagy, vagy dolgoztál cache-ekkel – technikai szempontból valószínűleg nem lesz új információ az írásban. De egy junior számára egy kis áttekintés segíthet abban, hogy merre nézzen, ha egyszer ilyen helyzetbe kerül.
Amikor a Sportmester új verzióját élesben indítottuk, az adatok megszerzése, hogy finoman fogalmazzak, nem volt éppen kényelmes. Az alapot olyan táblázatok képezték, amelyeket a weboldal korábbi verziójához (Bitrix) készítettek, amelyeket be kellett húzni az ETL-be, átalakítani egy új formába és különféle díszítésekkel ellátni, amelyek egy tucatnyi rendszerből származtak. Ahhoz, hogy az új kép vagy termékleírás a weboldalon megjelenjen, a következő napig kellett várni – az aktualizálás éjszaka, napi egyszer történt.
Kezdetben annyi aggodalom merült fel az első hetekben a termelésbe való átálláskor, hogy a tartalomkezelők kényelmetlenségei apróságnak tűntek. De ahogy minden lecsendesedett, a projekt fejlődése folytatódott - néhány hónap múlva, 2015 elején elkezdtük aktívan fejleszteni az adminfelületet. 2015-ben és 2016-ban minden jól ment, rendszeresen kiadtunk új verziókat, az adminfelület egyre nagyobb részt ölelt fel az adatok előkészítéséből, és készültünk arra, hogy hamarosan csapatunkra bízzák a legfontosabbat és legnehezebbet - a terméknyomvonalat (az összes termékre vonatkozó adatok teljes előkészítése és kezelése). De 2017 nyarán, közvetlenül a terméknyomvonal elindítása előtt, a projekt nagyon nehéz helyzetbe kerül - éppen a gyorsítótárazási problémák miatt. Erről az epizódról szeretnék beszélni ennek a kétrészes publikációnak a második részében.
De ebben a bejegyzésben messziről kezdem, néhány gondolatot foglalok össze - a gyorsítárazás körüli elképzeléseket, amelyeket jó lett volna előre végiggondolni egy nagy projekt előtt.
Amikor felmerül a gyorsítárazás feladata
A gyorsítárazás feladata nem merül fel csak úgy. Mi fejlesztők vagyunk, szoftverterméket írunk, és azt akarjuk, hogy keresett legyen. Ha a termék keresett és sikeres - a felhasználók érkeznek. És jönnek és jönnek. És egyszer csak nagyon sok felhasználó lesz, és ekkor a termék nagy terhelésűvé válik.
A kezdeti szakaszokban nem gondolkodunk a kód optimalizálásában és teljesítményében. A lényeg a funkcionalitás, gyorsan kiadni egy prototípust, és tesztelni a hipotéziseket. És ha a terhelés nő - akkor erősítjük a hardvert. Megnöveljük kétszer-háromszor, ötször, akár tízszer is. Valahol itt a pénzügyek már nem engedik meg. Hány felhasználó érkezik még? Ez nem csak 2-5-10, hanem ha sikeres lesz – az 100-1000-től egészen 100 ezerig terjedhet. Tehát előbb vagy utóbb az optimalizálással foglalkozni kell.
Tegyük fel, hogy egy kód egy része (nevezzük ezt funkciónak) rendkívül lassan működik, és szeretnénk csökkenteni a végrehajtási időt. A funkció lehet adatbázis-hozzáférés, egy bonyolult logika végrehajtása – a lényeg, hogy hosszú ideig tart. Mennyire lehet csökkenteni a végrehajtási időt? Végső soron nullára lehet csökkenteni, nem tovább. De hogyan lehet a végrehajtási időt nullára csökkenteni? A válasz: teljesen kizárni a végrehajtást. Ehelyett azonnal visszaadjuk az eredményt. De hogyan tudjuk meg az eredményt? A válasz: vagy kiszámítjuk, vagy valahol megnézzük. Kiszámítani – az sokáig tart. Megnézni – az például azt jelenti, hogy megjegyezzük azt az eredményt, amelyet a funkció korábban adott ugyanezekkel a paraméterekkel.
Ez tehát azt jelenti, hogy a funkció megvalósítása nem lényeges számunkra. Elég tudni, hogy milyen paraméterektől függ az eredmény. Ha akkor a paraméterek értékeit egy objektumként ábrázoljuk, amely kulcsként használható egy tárolóban – akkor az eredményeket lehet tárolni, és a következő lekérdezéskor vissza lehet állítani őket. Ha ezek a feljegyzések és az eredmények lekérdezése gyorsabban történik, mint a funkció végrehajtása – máris van sebességelőnyünk. A nyereség mértéke elérheti a 100, 1000 vagy akár 100 000-szeres növekedést (10^5 – ez inkább kivétel, de egy rendkívül lassú adatbázis esetén teljesen lehetséges).
A rendszer cache-elésének fő követelményei
Az első követelmény, amely a cache-elési rendszerhez tartozik — az gyors olvasási sebesség, és valamivel kisebb mértékben — az írási sebesség. Ez igaz, de csak addig, amíg nem kezdjük el a rendszert élesbe állítani.
Nézzünk egy ilyen esetet.
Tegyük fel, hogy felkészültünk a jelenlegi terhelésre, és most fokozatosan bevezetjük a cache-elést. Kicsit nő a felhasználók száma, növekszik a terhelés – kiszélesítjük a cache-eket, itt-ott kapcsolódunk. Ez egy ideig tart, és már a nehéz funkciók szinte alig hívódnak meg — az összes fő terhelés a cache-ledésre nehezedik. A felhasználók száma ez idő alatt N-szer nőtt.
Ha az eredeti hardverkészlet 2-5-szörös lehetett, akkor a cache használatával a teljesítményt akár 10-szeresére, vagy jobb esetben 100-szorosára, de akár 1000-szeresére is növelhettük. Vagyis ugyanazon a hardveren – 100-szor több lekérdezést kezelünk. Csodálatos, megérdemeltük a jutalmat!
De most, egy szép pillanatban, véletlenül, a rendszer összeomlott és a cache megsemmisült. Semmi különös – hiszen a cache-t a "magas olvasási és írási sebesség, a többi nem fontos" követelménye alapján választottuk.
A kezdő terheléshez képest a hardver tartalékunk 2-5 szerese volt, míg a terhelés ezen idő alatt 10-100-szor nőtt. A cache segítségével kizártuk a nehéz funkciók hívásait, így minden zökkenőmentesen működött. De most, cache nélkül – mennyivel fog csökkenni a rendszer teljesítménye? Mi fog történni? A rendszer le fog állni.
Még ha a cache nem is pusztult el, csak egy időre kiürült – újra fel kell majd melegíteni, és ez időt fog igénybe venni. Ez idő alatt a fő terhelés a funkciókra fog nehezedni.
Következtetés: a nagy terhelésű projektek működése olyan rendszert igényel, amely nemcsak magas olvasási és írási sebességet biztosít, hanem adatmegőrzést és hibával szembeni ellenállóságot is.
A választás gyötrelmei
Az admin paneles projekt során a választás így történt: először Hazelcast-ot telepítettünk, mivel már ismertük ezt a terméket a fő weboldal tapasztalatai alapján. De itt ez a választás balul sült el – a terhelési profilunkhoz a Hazelcast nemcsak lassan, hanem kifejezetten iszonyúan lassan működik. A termelési bevezetés határidejére pedig addigra már szerződtünk.
Spoiler: elmondom a második részben, hogy pontosan hogyan alakultak a körülmények, hogy ilyen csapdaába estünk, és milyen éles és feszült helyzetbe kerültünk – és hogyan jutottunk el, és hogyan másztunk ki. De most csak annyit mondok, hogy ez egy komoly stressz volt, és "gondolkodni – valahogy nem tudok, rázom a palackot". A "palackot rázom" – ez is egy spoiler, erről kicsit később.
Mit tettünk:
- Összeállítunk egy listát az összes rendszerről, amit a Google és a StackOverflow ajánl. Kicsit több, mint 30.
- Terhelési teszteket írunk, amelyek a termelésre jellemzőek. Ehhez rögzítettük az adatokat, amelyek a rendszerben mennek át a termelési környezetben – egyfajta sniffer az adatok számára, amelyek nincsenek a hálózaton, de a rendszeren belül. A tesztekbe pontosan ezeket az adatokat futtattuk.
- Az egész csapat, mindenki választ egy következő rendszert a listáról, beállítja, elvégzi a teszteket. Ha a teszt nem sikerül, a terhelést nem bírja – kidobjuk, és átmegyünk a következőre a sorban.
- A 17. rendszeren világossá vált, hogy minden reménytelen. Elég a "palack rázásából", itt az ideje komolyan gondolkodni.
De ez az a lehetőség, amikor olyan rendszert kell választani, amely "átnyúlik a sebességen" az előre elkészített tesztekben. Mi van, ha még nincsenek tesztek, és gyorsabban szeretnénk választani?
Modellezünk egy ilyen helyzetet (nehezen elképzelhető, hogy egy középhaladó fejlesztő a vákuumban él, és a választás időpontjában még nem alakította ki a preferenciáját, hogy melyik terméket próbálja ki először — ezért a további gondolatok inkább elméletiak/filozófiaiak/ a juniorok számára).
Miután meghatároztuk az igényeket, elkezdjük kiválasztani a dobozból való megoldást. Miért találjunk ki újra a kereket: elmegyünk és elhozunk egy kész gyorsítótár-rendszert.
Ha csak most kezded és Google-ozol, akkor plusz-mínusz az sorrend, de összességében az irányok a következők lesznek. Először a Redisra fogsz bukkanni, ami mindenütt a köztudatban van. Aztán megtudod, hogy létezik az EhCache, mint a legrégebbi és legmegbízhatóbb rendszer. Továbbá szó esik a Tarantoolról — egy hazai fejlesztés, aminek egyedi megoldásai vannak. És még az Ignite-ról is, mert most emelkedik a népszerűsége és élvezi a SberTech támogatását. A végén még a Hazelcast, mert az enterprise világában gyakran feltűnik a nagy cégek körében.
Ezzel a lista nem merül ki, tucatnyi rendszer létezik. És mi csak egyet csatlakoztatunk. Elvesszük az öt kiválasztott rendszert a "szépségversenyre" és lebonyolítjuk a választást. Ki lesz a győztes?
Redis
Olvassuk el, mit mondanak a hivatalos oldalon.
— opensource projekt. In-memory adatbázist kínál, lehetőséget biztosít on-disk tárolásra, automatikus elosztást partíciókra, magas rendelkezésre állást és helyreállítást hálózati megszakítások után.
Úgy tűnik, hogy minden tökéletes, érdemes integrálni — mindent megtesz, amire szükség van. De csak úgy kíváncsiságból nézzük meg a többi jelöltet is.
EhCache
— "a legszélesebb körben használt gyorsítótár Java-hoz" (a hivatalos weboldal szlogenjének fordítása). Szintén opensource. Itt megértjük, hogy a Redis nem Java-ra van optimalizálva, hanem általános, és egy wrapper szükséges a kommunikációhoz. Az EhCache sokkal kényelmesebb. Mit ígér még a rendszer? Megbízhatóságot, leteszteltséget, teljes funkcionalitást. Nos, és emellett ez a legelterjedtebb. Terabájt adatokat gyorsít.
Elhanyagoltam a Redis-t, kész vagyok választani az EhCache-t.
De a hazaszeretet érzése arra késztet, hogy megnézzem, miben jó a Tarantool.
Tarantool
— bemutatásra kerül a „Valós idejű adatintegrációs platform” jelölés alatt. Nagyon bonyolultan hangzik, ezért részletesen átnézzük az oldalt, és megtaláljuk a hangzatos állítást: „Minden adatot 100%-ban a memóriában tárol”. Ez kérdéseket kell, hogy felvet, hiszen az adatok mennyisége sokkal nagyobb lehet, mint a memória. A kiértelmezés az, hogy itt arra utalnak, hogy a Tarantool nem végez szerializációt az adatok lemezre írásakor a memóriából. Ehelyett alacsony szintű rendszerjellemzőket használnak, amikor a memória egyszerűen a fájlrendszerre mappelve van, meglehetősen jó I/O teljesítménnyel. Összességében csodálatosan és nagyszerűen megoldották.
Nézzük az implementációkat: Mail.ru vállalati gerinc, Avito, Beeline, MegaFon, Alfa Bank, Gazprom…
Ha még voltak kételyeim a Tarantool kapcsán, a Mastercard bevezetési esettanulmánya meggyőzött. Én a Tarantool-t választom.
De végül is…
Ignite
… van még , bejelentve mint „in-memory számítási platform… in-memory sebesség petabájtnyi adaton”. Itt is sok előny van: elosztott in-memory cache, a leggyorsabb key-value tároló és cache, horizontális skálázhatóság, magas rendelkezésre állás, szigorú integritás. Összességében úgy tűnik, hogy a leggyorsabb az Ignite.
Implementációk: Sberbank, American Airlines, Yahoo! Japan. Aztán még megtudom, hogy az Ignite nemcsak a Sberbankban van bevezetve, hanem a SberTech csapata a saját embereit küldi az Ignite csapatához a termék továbbfejlesztésére. Ez teljesen elnyer, és kész vagyok az Ignite-t választani.
Teljesen érthetetlen, hogy miért, megnézem az ötödik pontot.
Hazelcast
Benyitok az oldalra , olvasok. És kiderül, hogy a leggyorsabb megoldás az elosztott cache-elésre – az Hazelcast. Még sokkal gyorsabb, mint a többi megoldás, és egyáltalán ő a vezető az in-memory data grid területén. E háttérrel bármi mást választani – az önmagunk iránti tiszteletlenség. Ráadásul redundáns adatokat használ a klaszter folyamatos működéséhez, adatvesztés nélkül.
Minden, kész vagyok az Hazelcast-t választani.
Összehasonlítás
De ha megnézzük, mind az öt jelölt úgy van bemutatva, hogy mindegyikük a legjobb. Hogyan válasszunk? Megnézhetjük, hogy melyik a legnépszerűbb, kereshetünk összehasonlításokat, és a fejfájás eltűnik.
Találunk egy , válasszuk ki az öt rendszerünket.
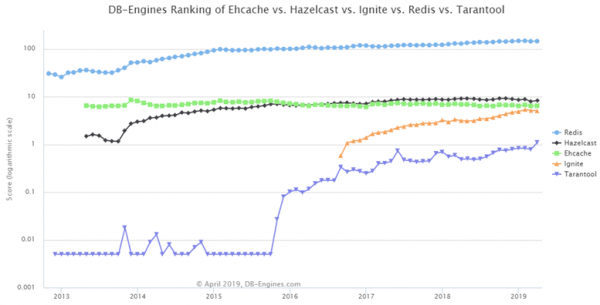
Itt sorba vannak állítva: a tetején a Redis, második helyen a Hazelcast, népszerűsödik a Tarantool és az Ignite, míg az EhCache változatlanul marad.
De nézzük meg a : weblapokra mutatott linken, a rendszer iránti általános érdeklődés, állásajánlatok — nagyszerű! Tehát amikor leáll a rendszerem, azt mondom: «Nem, ez megbízható! Rengeteg állásajánlat van…». Egy ilyen egyszerű összehasonlítás nem elegendő.
Ezek a rendszerek nem csupán gyorsítótárazásra szolgálnak. Rengeteg új funkcióval rendelkeznek, például nemcsak az adatok kerülnek a klienshez feldolgozásra, hanem éppen ellenkezőleg: a kód, amit végre kell hajtani az adatokkal, átkerül a szerverre, ott végrehajtásra kerül, és az eredmény visszatér. Mint különálló gyorsítótárazási rendszert nem is annyira gyakran vizsgálják őket.
Rendben, nem adjuk fel, keressünk közvetlen összehasonlítást a rendszerek között. Vegyük a két legjobb lehetőséget — Redis és Hazelcast. A sebesség érdekel, ezen a téren fogjuk összehasonlítani őket.
Hz vs Redis
Találunk ilyet :
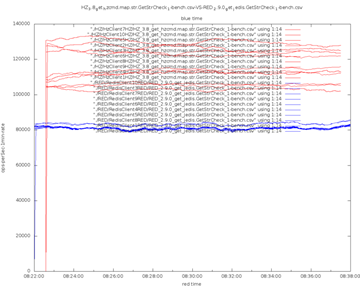
Kék — ez a Redis, piros a Hazelcast. A Hazelcast mindenütt nyer, és ez indoklással is alátámasztva: több szálú, nagymértékben optimalizált, minden szál saját partícióval dolgozik, ezért nincsenek blokkok. A Redis pedig egy szálú, a modern többmagos CPU-tól nem nyer. A Hazelcast aszinkron I/O-t használ, a Redis-Jedis pedig blokkoló socket-eket. Végül is, a Hazelcast bináris protokollt alkalmaz, míg a Redis szövegre orientált, tehát nem hatékony.
Biztos, ami biztos, nézzünk meg még egy összehasonlító forrást. Mit mutat nekünk?
Redis vs Hz
Még egy :
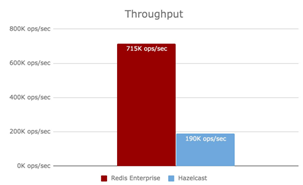
Itt fordítva, piros — ez a Redis. Tehát a Redis teljesítményben nyer a Hazelcast előtt. Az első összehasonlításban a Hazelcast nyert, a másodikban pedig a Redis. nagyon pontosan elmagyarázták, miért nyert a Hazelcast az előző összehasonlításban.
Kiderül, hogy az első eredmény ténylegesen manipulált volt: a Redis a gyári dobozból került elő, míg a Hazelcast tesztesetre lett optimalizálva. Tehát azt kell mondanunk: egyrészt senkinek sem szabad hinni, másrészt ha végül választhatunk rendszert, azt még helyesen be is kell állítanunk. Ezek a beállítások tucatnyi, szinte száz paramétert tartalmaznak.
Rázza meg a palackot
És az egész folyamatot, amit most végrehajtottunk, egy így fogalmazható metaforával tudom megmagyarázni: «Rázza meg a palackot». Tehát most nem kell programozni, most a legfontosabb az, hogy tudjunk olvasni a stackoverflow-n. A csapatomban van egy szakember, aki pontosan így dolgozik kritikus pillanatokban.
Mit csinál? Lát egy működésképtelen dolgot, látja a stack trace-t, kiválaszt belőle pár szót (hogy pontosan melyeket – ez az ő szakértelme), keres a Google-ben, és a válaszok között megtalálja a Stack Overflow-t. Nem olvasva, nem gondolkozva, a válaszok között kiválaszt valamit, ami a leginkább hasonlít a „csinálni azt és ezt” javaslatra (az, hogy melyik választ választja – ez az ő tehetsége, mert nem mindig ez a válasz az, ami a legtöbb like-ot kapta), alkalmazza, nézi: ha valami változott, akkor szuper. Ha nem változott – visszaállítjuk. És ismételjük a futtatás-ellenőrzés-keresés ciklust. Így, intuitív módon, eljut odáig, hogy idővel a kód működik. Nem tudja, miért, nem tudja, mit csinált, nem tudja elmagyarázni. De! Ez a dolog működik. És a „tűz eloltva”. Most nézzük meg, mit csináltunk. Amikor a program működik – ez sokkal könnyebb. És jelentősen spórol az idővel.
Ez a módszer nagyon jól magyarázható egy példával.
Régen nagyon népszerű volt hajót rakni egy palackba. Itt a hajó nagy és törékeny, míg a palack nyaka nagyon szűk, nem lehet belenyomni. Hogyan lehet összeállítani?
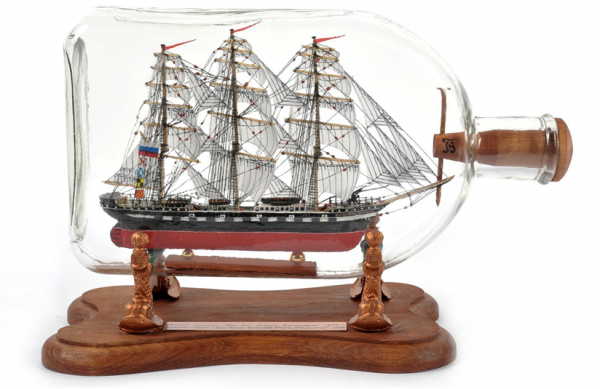
Van egy ilyen módszer, nagyon gyors és nagyon hatékony.
A hajó rengeteg apró dologból áll: pálcákból, kötelekből, vitorlákból, ragasztóból. Mindezt a palackba tesszük.
Két kézzel megfogjuk a palackot, és elkezdjük rázni. Rázogatjuk, rázogatjuk. És általában – teljes káosz lesz, persze. De néha. Néha sikerül egy hajót összehozni! Pontosabban, valami, ami hasonlít egy hajóra.
Megmutatjuk ezt a valamit valakinek: „Szergej, látod!?”. És tényleg, messziről – úgy tűnik, mint egy hajó. De azt tovább nem lehet engedni.
Van egy másik módszer is. A fejlettebb fiúk, így hackers használják.
Adtam egy feladatot egy ilyen srácnak, mindent megcsinált, és eltűnt. És nézed – úgy tűnik, el van készítve. De egy idő múlva, amikor ki kell javítani a kódot – elkezdődik a káosz… Jó, hogy ő már messze eltávolodott. Ezek a fiúk, akik egy palack példáján így csinálnak: látják, hogy ahol a fenék van – az üveg ível. És nem teljesen világos, hogy átlátszó-e vagy sem. Akkor a „hackerek” levágják ezt a feneket, belehelyezik a hajót, a feneket újra ragasztják, és úgy tűnik, mintha így kellene lennie.
A feladat megfogalmazása szempontjából minden rendben van. De miért készítenének egy ilyen hajót, kinek van rá szüksége? Funkcionalitása nincs. Általában az ilyen hajók ajándékok nagyon magas rangú embereknek, akik a polcukra állítják őket, mint valami szimbólumot, mint jelet. És ha egy ilyen személy, egy nagyvállalat vezetője vagy magas rangú hivatalnok, elé kerül egy ilyen silány munka, amelynek levágták a nyakát? Jobb, ha erről soha nem tud. Tehát hogyan készítik ezeket a hajókat, amelyeket fontos személyeknek lehet ajándékozni?
Az egyetlen hely, amely kulcsfontosságú és amivel tényleg semmit sem lehet tenni, az a hajótest. A hajótest éppen a nyakon átmegy. Miközben a hajót a palackon kívül állítják össze. De nem csak össze kell rakni a hajót, ez igazi ékszerkészítési mesterség. A különböző alkatrészekhez speciális karok kerülnek, amelyek lehetővé teszik, hogy később felemeljék őket. Például az vitorlákat összecsukják, óvatosan beviszik, majd csipesz segítségével nagyon precízen és óvatosan megfeszítik és felemelik. Az eredmény egy olyan műalkotás, amelyet tiszta lelkiismerettel és büszkeséggel ajándékozhatnak.
Ha azt akarjuk, hogy a projekt sikeres legyen – a csapatban legalább egy ékszerésznek kell lennie. Annak, aki gondoskodik a termék minőségéről, és figyelembe veszi az összes szempontot, még a stresszes pillanatokban is, amikor a körülmények sürgősséget igényelnek, feláldozva a fontosat. Minden sikeres projekt, amely tartós és időálló, ezen az elven alapul. Van bennük valami nagyon precíz és egyedi, ami minden elérhető lehetőséget kihasznál. A palackban lévő hajó példájánál a hajótest átmegy a nyakán.
Visszatérve a választási feladatunkhoz a cache szerverünket illetően, hogyan lehetne ezt az módszert alkalmazni? Javaslom, hogy a létező rendszerek közül ne rázogassuk a palackot, ne válasszunk, hanem nézzük meg, mi van bennük, amire figyelni kell a rendszer választásánál.
Hol keressek bottlenecket?
Próbáljuk meg nem rázni a palackot, nem sorban végigjárni mindent, hanem nézzük meg, milyen feladatok merülnek fel, ha hirtelen, a mi feladatunkhoz – úgy tervezzük meg ezt a rendszert önállóan. Persze nem fogunk kerékpárt szerelni, de felhasználjuk ezt a sémát, hogy orientálódjunk, mire érdemes figyelni a termékek leírásaiban. Rajzoljuk fel ezt a sémát.
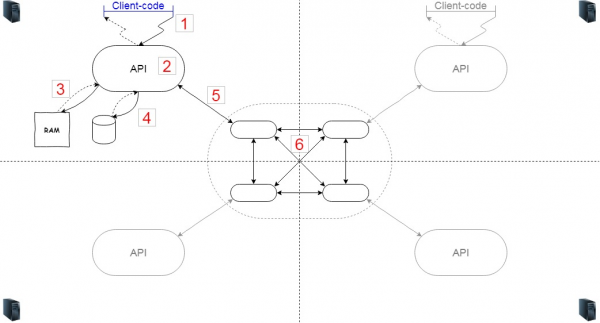
Ha a rendszer elosztott, akkor több szerverünk lesz (6). Tegyük fel, hogy négy (ez kényelmesen elhelyezhető a képen, de persze bármennyi lehet). Ha a szerverek különböző csomópontokon vannak, akkor mindegyiken fut egy bizonyos kód, amely biztosítja, hogy ezek a csomópontok klasztert alkossanak, és szakadás esetén – csatlakozzanak, felismerjék egymást.
Szükség van egy kód-logikára (2) is, amely a cache-elésért felelős. Ezzel a kóddal egy bizonyos API-n keresztül lépnek kapcsolatba a kliensek. A kliens-kód (1) lehet az ugyanazon JVM keretein belül, vagy hozzáférhet a hálózaton keresztül is. Az belső logika azt határozza meg, hogy mely objektumokat tartjuk meg a cache-ben, és melyeket dobjuk ki. A cache tárolásához memóriát (3) használunk, de ha szükséges, egyes adatokat a lemezen is megőrizhetünk (4).
Nézzük meg, hol jelentkezik a terhelés. Valójában minden nyíl és csomópont terhelődni fog. Először is a kliens-kód és az API között, ha ez hálózati interakció, az ingadozás meglehetősen észlelhető lehet. Másodsorban az API keretein belül – ha túl bonyolult logikát alkalmazunk, akkor a CPU-ban ütközhetünk. Jó lenne, ha a logika nem mozgatná feleslegesen a memóriát. És marad a fájlrendszerrel való interakció – a szokásos esetben ez sorosítás / visszaállítás és írás / olvasás.
Ezután a klaszterrel való interakció. Valószínűleg ugyanebben a rendszerben lesz, de lehet külön is. Itt is figyelembe kell venni az adatátvitelt, az adatok sorosításának sebességét és a klaszteren belüli interakciót.
Most, egyrészt – meg tudjuk képzelni, "milyen fogaskerekek fognak forogni" a cache-rendszerben a kódunk által generált kérések feldolgozása során, másrészt – megbecsülhetjük, hogy kódunk hány és milyen kérést generál a rendszer felé. Ez elegendő ahhoz, hogy egy viszonylag ésszerű választást végezzünk – hogy a rendszerünket a felhasználásunkhoz igazítsuk.
Hazelcast
Nézzük meg, hogyan alkalmazható ez a felbontás a mi listánkra. Például a Hazelcastra.
Ahhoz, hogy adatokat rakjunk / vegyünk a Hazelcastból, a kliens kód (1) az API-hoz fordul. A Hz lehetővé teszi, hogy a szervert beágyazott módban futtassuk, és ebben az esetben az API-hívás a JVM-en belüli metódushívás, amit ingyenesnek tekinthetünk.
Ahhoz, hogy a logika működjön (2), a Hz a szérumozott kulcs byte-tömbjéből származó hash-ra támaszkodik – vagyis a kulcs szérumozása mindenképpen megtörténik. Ez elkerülhetetlen költség a Hz számára.
Az evakuálási stratégiák jól vannak megvalósítva, de speciális esetekben sajátokat is csatlakoztathatunk. Ezen a részen nem kell aggódni.
A helyettesítést (4) csatlakoztatni lehet. Kitűnő. Az interakció (5) beágyazott módban szinte azonnal megtörténik. Az adatok cseréje a klaszter csomópontjai között (6) – igen, létezik. Ez hozzájárul a hibatűréshez, bár a sebesség rovására. A Hz Near-cache funkciója csökkentheti az árat – az egyéb csomópontokból származó adatok cacheélve lesznek.
Mit lehet tenni ilyen körülmények között a sebesség növelésére?
Például, hogy elkerüljük a kulcs szérumozását (2) – a Hazelcast fölé egy másik cache-t építhetünk a legforróbb adatokhoz. A Sportmester a célra a Caffeine-t választotta.
A (6) szintű finomhangoláshoz a Hz kétféle tárolást kínál: IMap és ReplicatedMap.
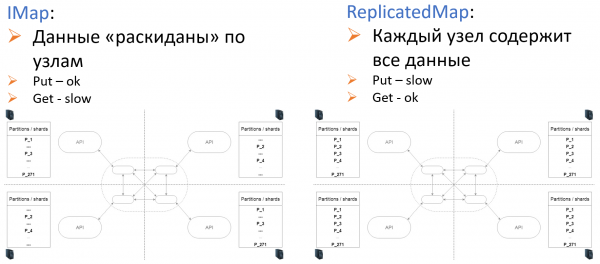
Érdemes elmondani, hogyan került a Hazelcast a Sportmester technológiai stackjébe.
2012-ben, amikor az első prototípuson dolgoztunk a jövőbeli weboldalhoz, a Hazelcast volt az első hivatkozás, amit a kereső adott. Az ismerkedés azonnal megtörtént – lenyűgözött minket, hogy alig két órával azután, hogy csatlakoztattuk a Hz-t a rendszerhez – működött. És jól működött. A nap végére megírtunk néhány tesztet, örültünk. Ennek az energiának épp elég volt ahhoz, hogy túléljük azokat a meglepetéseket, amiket a Hz az idő múlásával tartogatott. Jelenleg a Sportmester csapatának nincs oka arra, hogy lemondjon a Hazelcastról.
De olyan érvek, mint a „kereső első hivatkozása” és a „gyors HelloWorld összeállítás” – ez természetesen kivétel és a választás pillanatának sajátossága. A választott rendszer valódi kihívásai a termelésbe lépéssel kezdődnek, és pontosan erre a szakaszra érdemes figyelni bármely rendszer, így a cache kiválasztásakor is. Elmondható, hogy a Hazelcastot véletlenszerűen választottuk, de később kiderült, hogy helyesen döntöttünk.
A production environment is much more concerned with: monitoring, failure handling on individual nodes, data replication, and scaling costs. That is, attention should be paid to the tasks that will arise during system maintenance — when the load exceeds the planned amount by several times, when we accidentally upload something wrong, or when we need to release a new version of the code, replace data, and do this without customers noticing.
For all these requirements, Hazelcast is definitely suitable.
Folytatjuk
But Hazelcast is not a panacea. In 2017, we chose Hazelcast for caching in the admin panel, simply based on a good impression from past experience. This played a key role in a very nasty joke that put us in a tough situation, from which we 'heroically' extracted ourselves over 60 days. But more on that in the next part.
For now… Happy New Code!
Forrás: habr.com
