

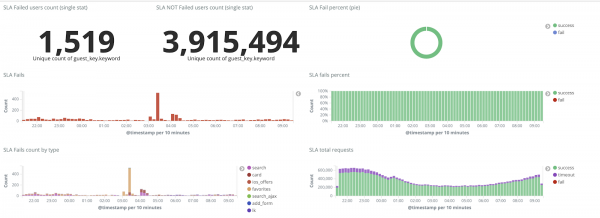
Üdv mindenkinek, a nevem Alekszandr, a CIÁN-nál dolgozom mérnökként, és az infrastruktúra folyamatok rendszeradminisztrációjával és automatizálásával foglalkozom. Az egyik korábbi cikk alá kommentben kérték, hogy meséljünk arról, honnan szerezzük a napi 4 TB logot, és mit csinálunk velük. Igen, sok logunk van, és ezek feldolgozására külön infrastruktúra klasztert hoztunk létre, amely lehetővé teszi számunkra a problémák gyors megoldását. Ebben a cikkben elmesélem, hogyan igazítottuk az elmúlt évben ezt a klasztert a folyamatosan növekvő adatforráshoz.
Mivel kezdtük
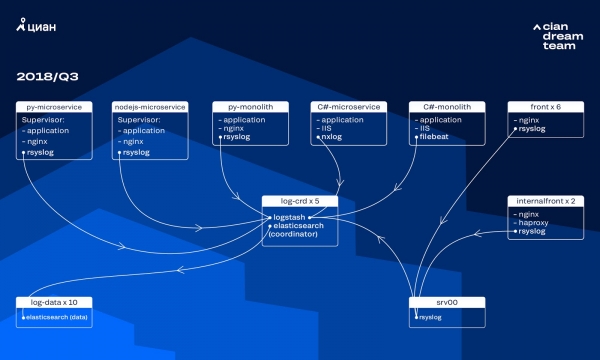
Az utóbbi néhány évben a cian.ru terhelése nagyon gyorsan nőtt, és 2018 harmadik negyedévére az oldal havi látogatottsága elérte a 11,2 millió egyedi felhasználót. Akkoriban kritikus pillanatokban akár 40% logot is elvesztettünk, ami miatt nem tudtunk az incidensekkel gyorsan foglalkozni, és nagyon sok időt és energiát pazaroltunk a megoldásukra. Ezen kívül gyakran nem tudtuk azonosítani a probléma okát, és az idővel megismétlődött. Ez egy olyan pokol volt, amivel valamit kezdeni kellett.
Akkoriban a logok tárolására egy 10 adatnódra épülő klasztert használtunk az ElasticSearch 5.5.2 verziójával, alapértelmezett indexbeállításokkal. Ezt több mint egy évvel ezelőtt vezettük be, mint népszerű és elérhető megoldást: akkoriban a logok áramlása nem volt olyan nagy, nem volt értelme szokatlan konfigurációkat kitalálni.
A bejövő logok feldolgozását a Logstash végezte különböző portokon öt ElasticSearch koordinátoron. Egy index, függetlenül a méretétől, öt partícióból állt. Órás és napi rotációt vezettünk be, ennek eredményeként óránként körülbelül 100 új partíció került a klaszterbe. Amíg a logok száma nem volt túl nagy, a klaszter jól működött, és senki sem figyelt a beállításaira.
A gyors növekedés problémái
A generált logok mennyisége nagyon gyorsan növekedett, mivel két folyamat egymásra rétegződött. Egyrészről egyre több felhasználója lett a szolgáltatásnak. Másrészről aktívan áttértünk a mikroszolgáltatás-architektúrára, szétválasztva régi monolitikus rendszereinket C#-ban és Pythonban. Több tucat új mikroszolgáltatás, amelyek helyettesítették a monolit egyes részeit, lényegesen több logot generáltak az infrastruktúra klaszter számára.
A skálázás vezetett minket ahhoz, hogy a klaszter gyakorlatilag kezelhetetlenné vált. Amikor a naplók 20 ezer üzenet másodpercenként kezdtek érkezni, a gyakori, haszontalan rotáció 6 ezer shard-ra növelte a számot, így egy node-ra több mint 600 shard jutott.
Ez problémákat okozott a memóriakezelésnél, és amikor egy node leállt, az összes shard egyidejű áthelyezése megduplázta a forgalmat és megterhelte a többi node-ot, ami gyakorlatilag lehetetlenné tette az adatok írását a klaszterbe. Ekkor pedig naplóink sem voltak. A probléma esetén szerverrel már a klaszter 1/10-ét elvesztettük. A sok kis méretű index további nehézségeket okozott.
Naplók nélkül nem értettük az incidens okait, és előbb vagy utóbb újra ugyanazokra a gondokra léphettünk, ami csapatunk ideológiájában elfogadhatatlan volt, mivel minden munkamechanizmusunk éppen arra van kiélezve, hogy soha ne ismételjük meg ugyanazokat a problémákat. Ehhez szügségünk volt a naplók teljes terjedelmére és azok szinte valós idejű szállítására, mivel a szolgálatot teljesítő mérnökök nemcsak a metrikák, hanem a naplók figyelmeztetéseit is nyomon követték. A probléma méretének megértéséhez: ekkor a naplók összesen napi szinten körülbelül 2 TB-t tettek ki.
Feladatot tűztünk ki - teljesen kizárni a naplóveszteséget és maximalizálni a naplók klaszterbe való szállításának idejét 15 percre a kényszerhelyzetek alatt (ezen a számértéken a továbbiakban belső KPI-ként támaszkodtunk).
Új rotációs mechanizmus és hot-warm node-ok
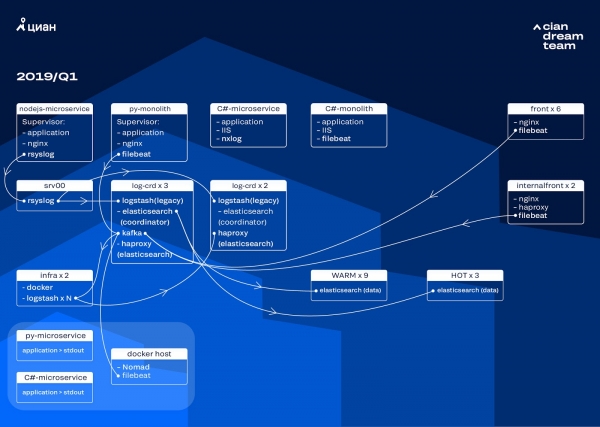
A klaszter átalakítását az ElasticSearch 5.5.2 verzióról 6.4.3 verzióra történő frissítéssel kezdtük. A 5-ös verziójú klaszter ismét leállt, és úgy döntöttünk, hogy leállítjuk és teljesen frissítjük - hiszen naplók amúgy sincsenek. Így ezt az átmenetet mindössze néhány óra alatt végrehajtottuk.
A legjelentősebb átalakulás ezen a ponton a három csomóponttal és egy koordinátorként funkcionáló közbüférrel való Apache Kafka bevezetése volt. Az üzenetközvetítő megszabadított minket a naplók elvesztésétől az ElasticSearch problémák idején. Egyidejűleg két csomópontot adtunk a klaszterhez, és átálltunk a hot-warm architektúrára, három „forró” csomóponttal, amelyek különböző állványokban helyezkedtek el az adatközpontban. Ezekre a csomópontokra átirányítottuk azokat a naplókat, amelyeket semmiképpen nem szabadott elveszíteni — a nginx és az alkalmazások hibanaplói. A többi csomópontra a kisebb naplók mentek — debug, warning stb., és 24 óra elteltével az „fontos” naplók a „forró” csomópontokról átkerültek.
A kis méretű indexek számának növelésének elkerülése érdekében áttértünk az időalapú forgatásról a rollover mechanizmusra. A fórumokon sok információ volt arról, hogy a méret alapú forgatás nagyon megbízhatatlan, ezért úgy döntöttünk, hogy az indexben lévő dokumentumok számán alapuló forgatást használunk. Minden indexet elemezni kellett, és rögzíteni a dokumentumok számát, amely után be kellene lépnie a forgatásnak. Így optimális shard méretet értünk el — legfeljebb 50 GB.
A klaszter optimalizálása
Bár a problémák teljesen nem szűntek meg. Sajnos továbbra is megjelentek kicsi indexek: nem érték el a megadott méretet, nem forogtak, és a három napnál idősebb indexek globális törlése során eltávolították őket, mivel megszüntettük az időalapú forgatást. Ez adatvesztéshez vezetett, mivel az index teljesen eltűnt a klaszterből, és a nem létező indexbe való írás megzavarta a curator logikáját, amit használtunk az irányításhoz. Az írási alias átalakult indexé, és megzavarta a rollover logikát, ami bizonyos indexek ellenőrizetlen növekedéséhez vezetett 600 GB-ig.
Például a forgatási konfigurációhoz:
curator-elk-rollover.yaml

---
actions:
  1:
    action: rollover
    options:
      name: "nginx_write"
      conditions:
        max_docs: 100000000
  2:
    action: rollover
    options:
      name: "python_error_write"
      conditions:
        max_docs: 10000000
Ha a rollover alias hiányzott, hiba lépett fel:
ERROR     alias "nginx_write" not found.
ERROR     Failed to complete action: rollover.  <type 'exceptions.ValueError'>: Unable to perform index rollover with alias "nginx_write".
A problémát a következő iterációra hagytuk, és más kérdéssel foglalkoztunk: áttértünk a Logstash belső naplófeldolgozó logikájára, amely a bejövő naplók (a felesleges információk eltávolítása és az adatok gazdagítása) kezelésével foglalkozik. Dockerbe helyeztük, amelyet a docker-compose segítségével indítunk, és ott üzemeltetjük a logstash-exportert is, amely metrikákat ad át a Prometheusnak a naplók áramlásának valós idejű megfigyeléséhez. Így lehetőségünk volt fokozatosan változtatni a logstash példányok számán a különböző napló típusok feldolgozására.
Míg a klasztert tökéletesítettük, a cian.ru látogatottsága 12,8 millió egyedi felhasználóra nőtt havonta. Ennek következtében úgy alakult, hogy a változtatásaink egy kicsit lemaradtak a termelésbeli változások mögött, és azzal kellett szembenéznünk, hogy a „meleg” csomópontok nem tudták kezelni a terhelést, ami megakasztotta az összes napló futtatását. A „forró” adatokat akadálytalanul megkaptuk, de a többi napló átvitelénél be kellett avatkoznunk, és manuális rollover-t hajtottunk végre az indexek egyenletes elosztása érdekében.
Eközben a logstash példányok skálázása és beállításainak módosítása nehézkessé vált, mivel ez egy lokális docker-compose volt, és minden műveletet manuálisan kellett elvégezni (új végpontok hozzáadásához kézzel kellett végigjárni az összes szervert, és mindenhol végrehajtani a docker-compose up -d parancsot).
A naplók újraelosztása
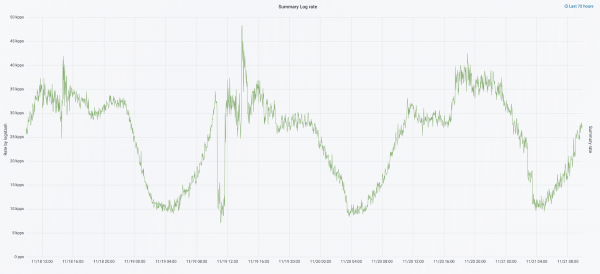
Idén szeptemberben még mindig folytattuk a monolit feltörését, a klaszterre nehezedő terhelés nőtt, és a naplóáram 30 ezer üzenetre közelített másodpercenként.
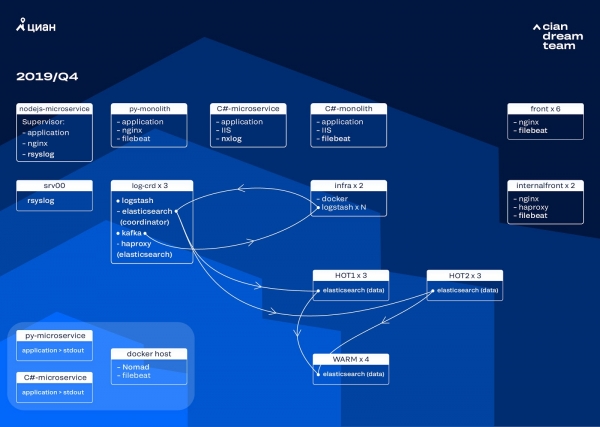
A következő iterációt a hardver frissítésével kezdtük. Öt koordinátorról háromra váltottunk át, kicseréltük az adatcsomópontokat, és nyereséget értünk el mind pénzügyileg, mind tárolókapacitás szempontjából. Két konfigurációt használunk a csomópontokhoz:
- A "forró" csomópontokhoz: E3-1270 v6 / 960Gb SSD / 32 Gb x 3 x 2 (3 a Hot1-hez és 3 a Hot2-höz).
- A "meleg" csomópontokhoz: E3-1230 v6 / 4Tb SSD / 32 Gb x 4.
Ebben az iterációban az access-naplókat tartalmazó indexet átvittük a három „forró” csomópont második csoportjába, amely annyi helyet foglal el, mint a front end nginx naplói. A „forró” csomópontokon most 20 órán keresztül tároljuk az adatokat, majd átkerülnek a „meleg” csomópontokra a többi naplóhoz.
A kis indexek eltűnésének problémáját a forgatásuk átkonfigurálásával oldottuk meg. Mostantól az indexek minden esetben 23 óránként forognak, még akkor is, ha kevés adat van bennük. Ez kissé megnövelte a shardok számát (kb. 800-ra nőtt), de a klaszter teljesítménye szempontjából ez tolerálható.
Ennek következtében a klaszterben hat „forró” és mindössze négy „meleg” csomópont keletkezett. Ez kis késleltetést okoz a nagy időintervallumú lekérdezésekben, de a jövőbeni csomópontok számának növelése megoldja ezt a problémát.
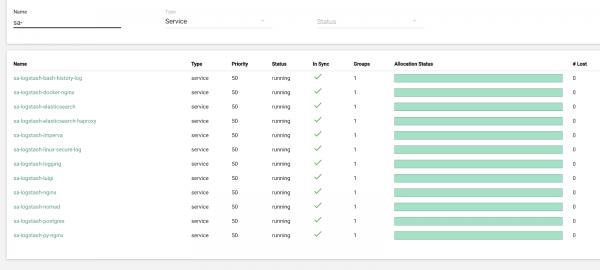
Ebben az iterációban orvosoltuk a félautomatikus skálázás hiányát is. Ehhez beüzemeltük az infrastruktúra Nomad klasztert — hasonlót ahhoz, amely már üzemel a termelésünkben. Jelenleg a Logstash száma automatikusan nem változik a terhelés függvényében, de el fogunk jutni oda is.
Jövőbeli tervek
A megvalósított konfiguráció kiválóan skálázható, és jelenleg 13,3 TB adatot tárolunk — minden logot négy napra visszamenőleg, ami szükséges az éles figyelmeztetések feldolgozásához. Néhány logot metrikává alakítunk, amelyeket a Graphite-ban tárolunk. Az mérnökök munkáját megkönnyítendő, rendelkezünk metrikákkal az infrastruktúra klaszterhez és olyan szkriptekkel, amelyek félautomatikusan javítják a tipikus problémákat. A következő évre tervezett adatcsomópontok számának növelésével a tárolási időt 4 napról 7 napra bővítjük. Ez elegendő lesz a napi munkához, mivel mindig igyekszünk minél gyorsabban kivizsgálni az eseményeket, a hosszú távú vizsgálatokhoz pedig rendelkezésre állnak a telemetriai adatok.
2019 októberében a cian.ru látogatottsága már 15,3 millió egyedi felhasználóra nőtt havonta. Ez komoly tesztet jelentett a logok kézbesítésére vonatkozó architekturális döntés számára.
Jelenleg az ElasticSearch 7-es verzióra való frissítésre készülünk. Igaz, ehhez sok index mappinget frissítenünk kell az ElasticSearch-ben, mivel azok a 5.5-ös verzióról kerültek át, és a 6-os verzióban elavultnak lettek nyilvánítva (a 7-es verzióban egyszerűen már nincsenek). Ez azt jelenti, hogy a frissítés során biztosan lesznek váratlan események, amelyek egy időre logok nélkül hagynak minket. A 7-es verzióból a Kibana-ra várunk a fejlettebb felületével és az új szűrőivel.
Fő célunkat elértük: abbahagytuk a naplófájlok elvesztését és csökkentettük az infrastruktúra klaszter leállásának idejét heti 2-3 leállásról havi pár órás karbantartásra. Mindez a termelési környezetben szinte észrevétlen. Most azonban pontosan meg tudjuk határozni, mi történik a szolgáltatásunkkal, gyorsan meg tudjuk tenni ezt nyugodt körülmények között, és nem kell aggódnunk a naplók elvesztése miatt. Összességében elégedettek vagyunk, boldogok, és készülünk az új kihívásokra, amelyekről később beszámolunk.
Forrás: habr.com
