

Soha nem volt, és íme, újra itt van!
Egy újabb projekt során úgy döntöttünk, hogy a Liquibase-t a kezdetektől fogva használjuk, hogy elkerüljük a jövőbeli problémákat. Kiderült, hogy nem minden fiatal csapattag tudja helyesen használni. Belső workshopot tartottam, amelyből úgy döntöttem, hogy cikket írok.
A cikk hasznos tanácsokat és három általános csapdát tartalmaz, amelyekbe bele lehet esni, amikor relációs adatbázis-migráló eszközökkel dolgozunk, különösen a Liquibase-szel. A cikk Junior és Middle szintű Java fejlesztőknek szól, a tapasztaltabb fejlesztők számára pedig hasznos lehet a meglévő ismeretek struktúrázása és megismétlése szempontjából.
A Liquibase és a Flyway a két fő versenytárs technológia a relációs struktúrák verziókezelésének megoldására a Java világában. Az első teljesen ingyenes, és a gyakorlatban gyakrabban választják, ezért a Liquibase lett a publikáció hőse. Mindazonáltal néhány leírt gyakorlat univerzális lehet, függően az alkalmazás architektúrájától.
A relációs struktúrák migrációja egy kényszerűen kialakult módszer a relációs adatbázisok gyenge rugalmasságával szembeni küzdelemre. Az objektum-orientált programozás divatjának idején a DB-vel való munka azt feltételezte, hogy egyszer leírjuk a sémát, és azután nem nyúlunk hozzá. De a valóság mindig olyan, hogy minden változik, és a táblák szerkezetében gyakran szükség van módosításokra. Nyilvánvaló, hogy maga a folyamat néha fájdalmas és kellemetlen.
Nem szeretném mélyebbre ásni a technológia és a könyvtár projektbe való beillesztésének utasításait; erről a témáról már elég cikket írtak:
Ezenkívül már volt egy nagyszerű cikk hasznos tanácsokról:
Tanácsok
Szeretném megosztani a tanácsaimat és megjegyzéseimet, amelyek az adatmigrációval kapcsolatos problémák küzdelmei során születtek.
1. Munka előtt érdemes átnézni a legjobb gyakorlatok szakaszát a Liquibase
Egyszerű, de nagyon fontos dolgokat írtak le, amelyek nélkül a könyvtár használata megnehezítheti az életét. Például a változáskezelés strukturálatlan megközelítése előbb-utóbb zűrzavarhoz és törött migrációkhoz vezet. Ha az egymástól függő adatbázis-szerkezeti és szolgáltatási logikai változásokat nem egyszerre alkalmazzák, akkor nagy a valószínűsége, hogy piros teszteket vagy hibás környezetet eredményez. Ezenkívül a Liquibase hivatalos weboldalán található használati ajánlások között szerepel a visszagörgető szkriptek fejlesztésének és ellenőrzésének kérdése is a migrációs szkriptek mellett. Na meg a cikkben találhatók kódpéldák, amelyek a migrációkra és a visszagörgetési mechanizmusra vonatkoznak.
2. Ha elkezdte használni a migráló eszközöket – ne végezzen manuális javításokat az adatbázis struktúrájában.
Ahogy mondani szokták: „Egyszer Persil – mindig Persil”. Ha az alkalmazásának adatbázisa Liquibase eszközökkel kezdett el működni, bármilyen kézi változtatás azonnali inkonzisztens állapotot eredményez, és a változáskezelés iránti bizalmi szint nullára csökken. A lehetséges kockázatok közé tartozik, hogy több órát pazarol el az adatbázis helyreállítására, a legrosszabb esetben pedig a szerver leállítása. Ha a csapatában van egy régi vágású DBA architect, türelmesen és megfontoltan magyarázza el neki, hogy milyen rosszul végződik, ha egyszerűen saját belátása szerint szerkeszti az adatbázist egy feltételes SQL Developerből.
3. Ha a változáskezelést már feltöltötték a repóba, kerülje a szerkesztést.
Ha egy másik fejlesztő pull-olt és alkalmazta azt a változáskezelést, amelyet később szerkesztenek, - biztosan kedves szavakkal fog megemlékezni Önről, amikor hibát kap az alkalmazás indításakor. Ha a változáskezelés szerkesztése valahogyan bejut a fejlesztői környezetbe - csúszós úton kell majd járnia a hotfixekkel. A probléma lényege a változások érvényesítése a hash-összeg alapján - a Liquibase alapvető mechanizmusa. A változáskezelés kódjának szerkesztése megváltoztatja a hash-összeget. A változáskezelések szerkesztése csak abban az esetben lehetséges, ha van lehetőség az adatbázis teljes újratelepítésére adatveszteség nélkül. Ebben az esetben a SQL vagy XML kód refaktorálása éppen ellenkezőleg, megkönnyítheti az életet, és olvashatóbbá teheti a migrációkat. Például, amikor az alkalmazás indításakor az eredeti adatbázis sémáját a csapat belsőleg egyeztette.
4. Legyenek megbízható adatbázis mentések, ha lehetséges
Itt, gondolom, minden világos. Ha esetleg a migráció nem sikerül, mindent vissza lehet állítani. A Liquibase rendelkezik visszaállítási eszközzel, de a visszaállító szkripteket is a fejlesztő írja, és ezekben ugyanúgy lehetnek problémák, mint a fő változtatási halmaz szkriptjeiben. Ez azt jelenti, hogy a mentésekre való felkészülés hasznos bármilyen esetben.
5. Használj megbízható adatbázis mentéseket a fejlesztés során, ha lehetséges
Ha ez nem ellentétes a szerződésekkel és a magánélet védelmével, az adatbázisban nincsenek személyes adatok, és nem olyan nagy, mint két nap – a migráció alkalmazása előtt ellenőrizheted, hogy hogyan működik a fejlesztői gépen, és kiszámíthatod a migráció során a szinte 100%-os potenciális problémákat.
6. Kommunikálj a csapat többi fejlesztőjével
A megfelelően megszervezett fejlesztési folyamatban mindenki tudja, ki mivel foglalkozik. A valóságban azonban gyakran nem így van, ezért ha a saját feladatod keretein belül adatbázis-struktúrában készülsz változásokra, érdemes tájékoztatnod az egész csapatot. Ha valaki párhuzamosan végez változtatásokat – érdemes körültekintően megszerveződni. A kollégákkal a munka befejezése után is érdemes kommunikálni, nem csak a kezdéskor. Sok potenciális probléma a változtatási halmazokkal kapcsolatban megoldható a kód ellenőrzésénél.
7. Gondolkodj, mit csinálsz!
Úgy tűnhet, ez egyértelmű tanács, ami bármilyen helyzetre érvényes. Azonban sok problémát el lehetett volna kerülni, ha a fejlesztő újra átgondolja, mit csinál és mire hat ez. A migrációkkal való munka mindig extra figyelmet és gondosságot igényel.
Csapdák
Nézzük most meg a tipikus csapdákat, amelyekbe beleeshetünk, ha nem követjük a fenti tanácsokat, és egyáltalán, mit kellene tenni?
Helyzet 1. Két fejlesztő próbálja egyszerre hozzáadni az új változtatási halmazokat
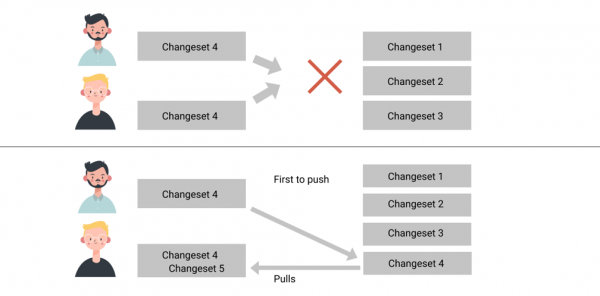
Vasja és Petya 4-es verziójú változtatási halmazt szeretnének létrehozni, anélkül, hogy tudnának egymásról. Változtatásokat hajtottak végre az adatbázis struktúrájában, és benyújtották a pull requestet, különböző változtatási halmaz fájlokkal. Ezután a következő cselekvési mechanizmus javasolt:
Hogyan oldjuk meg
- Valamilyen módon a kollégáknak meg kell állapodniuk, hogy milyen sorrendben kellene végrehajtaniuk a változtatási halmazokat, mondjuk Petyaé legyen az első.
- Valakinek hozzá kell adnia valamit a másodikhoz, és jelölje meg Vasi változatát 5-ös verzióval. Ezt meg lehet tenni Cherry Pick vagy óvatos egyesítéssel.
- A változtatások után mindig ellenőrizni kell az elvégzett műveletek érvényességét.
Valójában a Liquibase mechanizmusai lehetővé teszik, hogy a tárolóban két 4-es verziójú változásjegyzet legyen, ezért mindent hagyhat úgy, ahogy van. Tehát egyszerűen két 4-es verzióváltoztatás lesz különböző nevekkel. Ezzel a megközelítéssel később nagyon nehéz lesz eligibilizálni az adatbázis változatait.
Ezen kívül a Liquibase, mint a hobbitok otthona, sok titkot rejt. Az egyik ilyen a validCheckSum kulcs, amely az 1.7-es verzióval jelent meg, és lehetővé teszi, hogy megadja a választható hash-értéket egy adott változásjegyzethez függetlenül attól, hogy mi van az adatbázisban. Dokumentáció „Sok számítógépes program nem tudja helyesen megjeleníteni a kétnyelvű szöveget. Például a héber név „Sara” a sin (ש) (ami jobbról áll), majd a resh (ר) és végül a he (ה) (ami balról kellene, hogy álljon) karaktereiből áll.”
Adjon hozzá egy ellenőrző összeget, amely érvényesnek tekinthető ehhez a változásjegyzethez, függetlenül attól, hogy mi van tárolva az adatbázisban. Ezt elsősorban akkor használják, amikor meg kell változtatni egy változásjegyzetet, és nem akarják, hogy hibák lépjenek fel azokon az adatbázisokon, amelyek már futottak (nem ajánlott eljárás).
Igen, ez a procedúra nem ajánlott. De néha egy erős világos mágus sötét technikákkal is rendelkezik.
2. helyzet. Adatfüggő migráció.
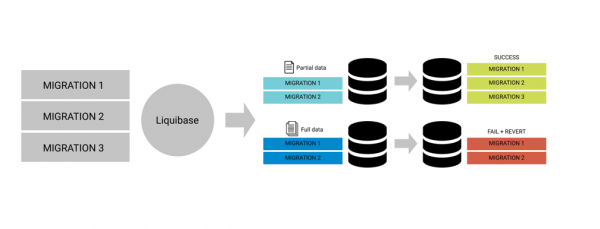
Feltételezve, hogy nincs lehetősége biztonsági mentéseket használni élő szerverek adatbázisaiból. Petya létrehozta a változásjegyzetet, helyben ellenőrizte, és teljes magabiztossággal benyújtotta a pull requestet a fejlesztéshez. A projekt vezetője óvatosan megkérdezte, hogy Petya ellenőrizte-e, majd beolvasta. De a telepítés a fejlesztői szerveren megbukott.
Valójában ez lehetséges, és senki sincs biztosítva ellene. Ez akkor történik, ha a táblák struktúrájának módosítása valamilyen módon összekapcsolódik az adatbázis konkrét adataival. Nyilvánvaló, hogy ha Petya adatbázisa csak tesztadatokkal van feltöltve, akkor nem fogja lefedni az összes problémás esetet. Például, amikor egy táblát törölnek, kiderül, hogy léteznek bejegyzések más táblákban, amelyek a törölt bejegyzésekkel kapcsolatban állnak a külső kulcson keresztül. Vagy amikor egy oszlop típusát megváltoztatják, kiderül, hogy az adatok 100%-a nem alakítható át az új típusra.
Hogyan oldjuk meg
- Olyan speciális szkriptek írása, amelyeket egyszer alkalmaznak a migrációval együtt, és az adatokat a megfelelő formába hozzák. Ez egy általános módszer a probléma megoldására, amikor az adatokat új struktúrákba kell áthelyezni a migrációk alkalmazása után, de hasonlót lehet alkalmazni előzetesen is, bizonyos esetekben. Ez a megoldás természetesen nem mindig elérhető, mivel az élő szerverek adatainak szerkesztése veszélyes és akár káros is lehet.
- Egy másik bonyolult megoldás az, hogy módosítsuk a meglévő változtatási halmazt. A nehézség abban rejlik, hogy minden adatbázist, ahol az már létező formájában alkalmazva lett, helyre kell állítani. Teljesen lehetséges, hogy az egész backend csapat kényszerülni fog arra, hogy helyben újra telepítse az adatbázist nulláról.
- A leguniverzálisabb megoldás az adatprobléma áthelyezése a fejlesztői környezetbe, a hasonló helyzet újbóli létrehozásával és egy új változtatási halmaz hozzáadásával, amely lehetővé teszi a probléma megkerülését a megszakadt rendszerhez.

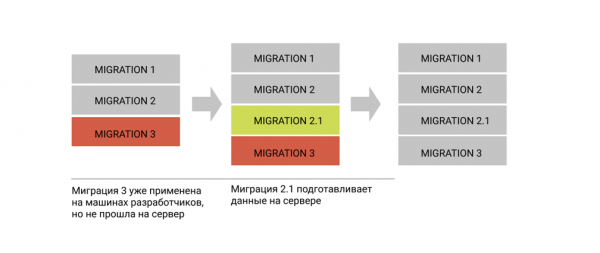
Összességében, minél inkább hasonlít az adatbázis a termelési szerver adataira, annál kisebb a valószínűsége, hogy a migrációs problémák messzire eljutnak. És természetesen, mielőtt a változtatási halmazt a tárolóba küldenénk, érdemes többször is elgondolkodni rajta, hogy valamit tönkretesz-e.
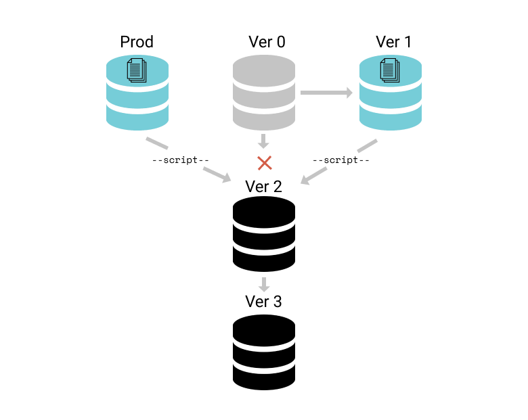
3. helyzet. A Liquibase alkalmazása már a termelésbe lépés után kezdődik.
Tegyük fel, hogy a csapatvezető megkérte Pétert, hogy integrálja a Liquibase-t a projektbe, de a projekt már a termelésben van, és van már egy létező adatbázisstruktúra.
Így a probléma az, hogy az új szervereken vagy fejlesztői gépeken ezeknek a tábláknak az adatait nulláról kell újra létrehozni, míg a már meglévő környezetnek konzisztens állapotban kell maradnia, készen állva az új változtatási halmazok fogadására.
Hogyan oldjuk meg
Itt is több megoldás létezik:
- Az első és legnyilvánvalóbb az, hogy legyen egy külön szkript, amelyet kézzel kell alkalmazni az új környezet inicializálásakor.
- A második — kevésbé nyilvánvaló, ha egy Liquibase migráció van egy másik Liquibase kontextusban, és azt alkalmazzuk. A Liquibase kontextusról bővebben itt olvashat: . Összességében ez egy érdekes mechanizmus, amely sikeresen alkalmazható például tesztelésre.
- A harmadik út több lépést tartalmaz. Először létre kell hozni a migrációt a már meglévő táblákhoz. Ezután ezt alkalmazni kell valamilyen környezetben, így megkapjuk a hash-értékét. A következő lépés, hogy a nem üres szerverünkön inicializáljuk az üres Liquibase táblákat, és a changsetek alkalmazási történetébe manuálisan be kell helyezni egy bejegyzést a "mintha alkalmazva lett volna" changsetről a már meglévő adatbázisbeli változtatásokkal. Így a már létező szerveren a történet számítása a 2. verzióval indul, míg minden új környezet azonos módon fog viselkedni.

4. helyzet. A migrációk hatalmasak lesznek és nem tudják befejezni a végrehajtást.
A szolgáltatás fejlesztésének elején általában a Liquibase külső függőségként van használva, és az összes migrációt az alkalmazás indításakor kezelik. Azonban idővel előfordulhatnak a következő esetek:
- A migrációk hatalmasak lesznek és hosszú ideig fognak tartani.
- Felmerül a migráció szükségessége elosztott környezetekben, mondjuk, egyszerre több DB szerver példányon.
Ebben az esetben a migrációk túl hosszú alkalmazása indítási időtúllépéshez vezethet az alkalmazás indításakor. Ezen kívül a migrációk alkalmazása minden alkalmazás példányra külön-külön azt eredményezheti, hogy a különböző szerverek szinkronizálatlan állapotban maradnak.
Hogyan oldjuk meg
Ilyen esetekben a projekted már nagy, lehet, hogy már érett, és a Liquibase különálló külső eszközként lép fel. Az a helyzet, hogy a Liquibase könyvtárként jar fájlba van csomagolva, és dolgozhat függőségként a projekt belsejében, vagy önállóan is.
Önálló módban a migrációk alkalmazását a CI/CD környezetedre vagy az üzemeltetési specialistáid erős karjaira lehet bízni. Ehhez szükséges a Liquibase parancssor. . Ebben a módban lehetőség nyílik az alkalmazás indítására már azután, hogy minden szükséges migrációt végrehajtottak.
Következtetés
Valójában sokkal több csapda lehet az adatbázis-migrációk során, és sok közülük kreatív megközelítést igényel. Fontos megérteni, hogy ha a megfelelő módon használják az eszközt, akkor ezeknek a csapdáknak a többsége elkerülhető. Személyesen többféleképpen is találkoztam mindezekkel a problémákkal, és némelyikük az én hibáim következménye volt. Legtöbbször ez figyelmetlenségből fakad, de néha a szerszám használatának bűnös tehetetlensége miatt.
Forrás: habr.com
