

Megjegyzés fordítás.: Bemutatjuk Önnek a közelmúltban a Grafana alkotói által üzemeltetett felhőszolgáltatás leállásának technikai részleteit. Ez klasszikus példája annak, hogyan okozhat egy új, látszólag rendkívül hasznos lehetőség, amely a infrastruktúra minőségének javítására hivatott… kárt, ha nem számítunk a szakszerű alkalmazás számos árnyalatára a production környezetben. Csodálatos, amikor ilyen anyagok jelennek meg, amelyek lehetővé teszik, hogy ne csak a saját hibáinkból tanuljunk. Részletek a Grafana Labs termékért felelős alelnökének szövegének fordításában.
Július 19-én, pénteken a Grafana Cloud szolgáltatás Hosted Prometheus körülbelül 30 percre leállt. Elnézést kérek minden ügyféltől, akit a hiba érintett. Feladatunk a megfelelő monitorozó eszközök biztosítása, és tudatában vagyunk annak, hogy ezek hiánya megnehezíti az Ön életét. Nagyon komolyan vesszük ezt az incidenst. Ebben a jegyzetben elmagyarázom, mi történt, hogyan reagáltunk erre, és mit teszünk azért, hogy hasonló ne forduljon elő a jövőben.
Háttér
A Grafana Cloud Hosted Prometheus szolgáltatás a következőn alapul — a CNCF által létrehozott, vízszintesen skálázható, nagy rendelkezésre állású, több-bérlős Prometheus szolgáltatás. A Cortex architektúrája különálló mikroszolgáltatások halmazából áll, amelyek mindegyike saját funkciót lát el: replikáció, tárolás, lekérdezés stb. A Cortex aktívan fejlődik, folyamatosan új lehetőségek jelennek meg, és nő a teljesítménye. Rendszeresen telepítjük az új Cortex kiadásokat a klaszterekbe, hogy az ügyfelek élvezhessék ezeket a lehetőségeket — hála az égnek, a Cortex képes a frissítések végrehajtására leállás nélkül.
A zökkenőmentes frissítésekhez a Cortex Ingester szolgáltatása a frissítés folyamán további Ingester replikát igényel. (Megjegyzés fordítás.: — a Cortex alapvető összetevője. Feladata, hogy folyamatosan gyűjtse a mintákat, csoportosítsa azokat Prometheus chunk-okba, és tárolja az adatbázisban, mint a DynamoDB, BigTable vagy Cassandra. Ez lehetővé teszi a régi Ingester-ek számára, hogy az aktuális adatokat új Ingester-ekhez továbbítsák. Érdemes megjegyezni, hogy az Ingester-ek erőforrás-igényesek. Működésükhöz 4 magra és 15 GB memóriára van szükség egy pod-on, ami a Kubernetes klasztereink esetében a gép alapszintű CPU teljesítményének és memóriájának 25%-át jelenti. Összességében általában sokkal több felhasználatlan erőforrás van a klaszterben, mint 4 mag és 15 GB memória, így könnyen tudjuk indítani ezeket a további Ingester-eket a frissítések során.
Gyakran azonban előfordul, hogy a normál működés során egyik gépen sincsenek ezek a 25%-os felhasználatlan erőforrások. Nem is törekszünk rá: a CPU és a memória mindig hasznos más folyamatokhoz. A probléma megoldására úgy döntöttünk, hogy kihasználjuk . A gondolat az, hogy az Ingester-ek számára magasabb prioritást adunk, mint más (stateless) mikroszolgáltatásoknak. Amikor szükség van egy további (N+1) Ingester elindítására, ideiglenesen kiszorítjuk a többi kisebb pod-ot. Ezek a pod-ok áthelyeződnek más gépek szabad erőforrásaiba, elegendő nagy "üreget" hagyva egy további Ingester indításához.
Csütörtökön, július 18-án négy új prioritási szintet telepítettünk a klasztereinkbe: kritikus, magas, közepes és alacsony. Ezeket körülbelül egy hétig teszteltük egy belső klaszteren, ügyféltartalom nélkül. Alapértelmezés szerint a prioritás nélküli pod-ok közepes prioritást kaptak, míg az Ingester-eknek egy magas kerül. A Kritikus prioritás a megfigyelésre volt fenntartva (Prometheus, Alertmanager, node-exporter, kube-state-metrics stb.). A konfigurációnk nyitott, és a PR megtekinthető Hiba .
Pénteken, július 19-én egy mérnök elindította az új, dedikált Cortex klasztert egy nagy ügyfél számára. Ennek a klaszternak a konfigurációja nem tartalmazta az új pod prioritásokat, ezért minden új pod alapértelmezett prioritást kapott -
A Kubernetes klaszterben nem volt elegendő erőforrás az új Cortex klaszter számára, és a meglévő production Cortex klasztert nem frissítették (az Ingester-ek nem rendelkeztek közepes.
magas prioritással). Mivel az új klaszter Ingester-ei alapértelmezés szerint prioritással rendelkeztek, míg a meglévő production pod-ok teljesen prioritás nélkül működtek, az új klaszter Ingester-ei kiszorították a meglévő production Cortex klaszter Ingester-eit. приоритета). Поскольку Ingester’ы нового кластера по умолчанию имели közepes приоритет, а существующие в production pod’ы работали вообще без приоритета, Ingester’ы нового кластера вытеснили Ingester из существующего production-кластера Cortex.
A ReplicaSet for the evicted Ingester in the production cluster detected an evicted pod and created a new one to maintain the specified number of replicas. The new pod was assigned priority by default, and another 'old' Ingester in production lost its resources. The result was közepes an avalanche process , which led to the eviction of all Ingester pods for the production clusters of Cortex.Ingester nodes are stateful and retain data for the previous 12 hours. This allows us to compress them more effectively before writing to long-term storage. For this, Cortex shards data by series using a Distributed Hash Table (DHT) and replicates each series across three Ingester nodes using quorum consistency in the style of Dynamo. Cortex does not write data to Ingester nodes that are shut down. Thus, when a large number of Ingester nodes leave the DHT, Cortex cannot provide sufficient replication of records, and they 'drop.'
Detection and resolution
New Prometheus alerts based on the error budget (
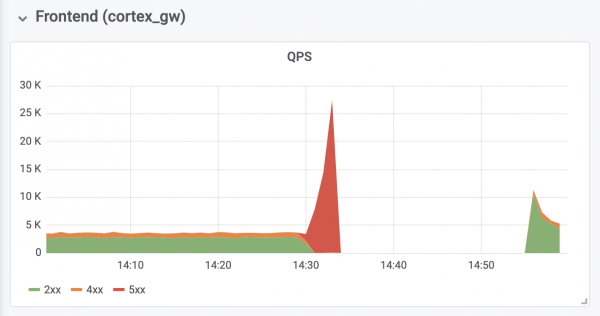
error-budget-based— details will appear in a future article) raised alarms 4 minutes after the beginning of the shutdown. During the next approximately five minutes, we conducted diagnostics and scaled up the underlying Kubernetes cluster to accommodate both new and existing production clusters. Another five minutes later, the old Ingester nodes successfully recorded their data, and the new ones started up, making the Cortex clusters available again.
Another 10 minutes were spent diagnosing and fixing out-of-memory (OOM) errors from the authentication reverse proxy servers in front of Cortex. The OOM errors were caused by a tenfold increase in QPS (which we believe was due to overly aggressive requests from client Prometheus servers).
Consequences
The total downtime lasted 26 minutes. No data was lost. The Ingester nodes successfully uploaded all in-memory data to long-term storage. During the shutdown, client Prometheus servers cached remote
(remote) records using the new remote_write API Callum Styan Production cluster write operations
It is important to learn from this incident and take necessary measures to prevent its recurrence.
Következtetések
Важно извлечь уроки из этого инцидента и предпринять необходимые меры, чтобы избежать его повторения.
Visszatekintve el kell ismernünk, hogy nem lett volna szabad alapértelmezett prioritást megadnunk, amíg az összes ingester a termelésben nem kapott prioritást. közepes Ezen kívül előre meg kellett volna gondolnunk a prioritások magas szintű kezelését. magas Most minden megoldódott. Reméljük, hogy a tapasztalatunk segít más szervezeteknek, akik a podok prioritásának használatát fontolgatják a Kubernetesben. Hozzá fogunk adni egy további ellenőrzési szintet bármilyen további objektum telepítésekor, melyek konfigurációi globálisak a klaszter számára. A jövőben az ilyen változtatásokat több ember fogja értékelni. Ezen kívül a meghibásodáshoz vezető módosítást túl jelentéktelennek tartották ahhoz, hogy külön projekt dokumentuma legyen — ezt csak a GitHub kérdésben beszéltük meg. Ettől kezdve minden ilyen konfigurációt kísérni fog a megfelelő projekt dokumentáció.
Végül automatizáljuk a hitelesítési visszafelé proxy méretezését, hogy megelőzzük az OOM-ot a túlterhelés során, aminek tanúi voltunk, és elemezni fogjuk az alapértelmezett Prometheus beállításokat, amelyek a visszaállítással és a skálázással kapcsolatosak, hogy megelőzzük a jövőbeli hasonló problémákat.óA történt meghibásodásnak voltak pozitív következményei is: miután megkaptuk a szükséges erőforrásokat, a Cortex automatikusan helyreállt további beavatkozás nélkül. Értékes tapasztalatokat szereztünk a
Grafana Loki — a mi új naplóaggregáló rendszerünk — használatával, ami segített biztosítani, hogy az összes ingester megfelelően viselkedett a meghibásodás alatt és után.
A Kubernetes sikeres történetei a termelésben. 10. rész: Reddit Megjegyzés: Bemutatjuk Önöknek a technikai részleteket a közelmúltban tapasztalt leállás okairól az obszervált felhőszolgáltatás esetében, amit a Grafana készítői üzemeltetnek.
Fejlesztési eszközök, amelyek Kubernetesben futnak
Olvasson további információkat a blogunkban:
- «»;
- «»;
- «»;
- «».
Forrás: habr.com
