

Ez a cikk a Unix magjában lévő csővezetékek megvalósítását ismerteti. Kicsit csalódott voltam, hogy a nemrég megjelent cikk címe „„ a belső felépítésről szólt. Érdekelni kezdett, és régi forrásokba mélyedtem, hogy választ találjak. nem A csővezetékek - „valószínűleg a legfontosabb találmány a Unixban” - az alapvető Unix filozófia jellemző vonásai, amelyek a kis programok egyesítését célozzák, valamint a parancssorban megszokott felirat:
Miről van szó?
$ echo hello | wc -c 6
Ez a funkció a mag által biztosított rendszerhívástól függ,
amely a dokumentációs oldalon található csőpipe(7) és :
A csővezeték a
pipe()
A csővezetékek egyirányú csatornát biztosítanak a folyamatok közötti kommunikációhoz. A csővezetéknek van egy bemenete (write end) és egy kimenete (read end). A csővezeték bemenetére írt adatok a kimenetén olvashatók.hívásával jön létre, amely két fájl leírót ad vissza: az egyik a csővezeték bemenetére, a másik a kimenetére vonatkozik.
A fent említett parancs nyomkövetési eredményei a csővezeték létrehozását és az adatfolyamot mutatják, amely egyik folyamattól a másikhoz áramlik:
$ strace -qf -e execve,pipe,dup2,read,write
    sh -c 'echo hello | wc -c'

execve("/bin/sh", ["sh", "-c", "echo hello | wc -c"], …)
pipe([3, 4])                            = 0
[pid 2604795] dup2(4, 1)                = 1
[pid 2604795] write(1, "hellon", 6)    = 6
[pid 2604796] dup2(3, 0)                = 0
[pid 2604796] execve("/usr/bin/wc", ["wc", "-c"], …)
[pid 2604796] read(0, "hellon", 16384) = 6
[pid 2604796] write(1, "6n", 2)        = 2
A szülő folyamat a pipe(), hogy csatlakozott fájl leírókat szerezzen. Az egyik gyermekfolyamat az egyik leíróba ír, míg a másik folyamat a másik leíróból olvassa azokat az adatokat. A shell a dup2 segítségével "átnevezi" a 3-as és 4-es leírókat, hogy megfeleljenek a stdin-nek és stdout-nak.
Csővezetékek nélkül a shellnek az egyik folyamat eredményét fájlba kellett volna írnia, majd átadnia egy másik folyamatnak, hogy az ott olvassa el az adatokat. Ennek következtében több erőforrást és lemezhelyet használtunk volna. Azonban a csővezetékek nem csak azért jók, mert elkerülik a temp fájlok használatát:
Ha egy folyamat próbál olvasni egy üres csővezetékből, akkor a
read(2)blokkolni fog, amíg az adatok elérhetővé nem válnak. Ha egy folyamat próbál írni egy megtelelt csővezetékbe, akkor awrite(2)blokkolva lesz, amíg a szalagról nem olvastak el elegendő adatot a felvétel végrehajtásához.
Mint a POSIX követelmény, ez egy fontos tulajdonság: a felvétel a szalagra akár PIPE_BUF bájt (legalább 512) atomikusnak kell lennie, hogy a folyamatok együttműködhessenek a csőn keresztül olyan módon, ahogyan a normál fájlok (amelyek nem biztosítanak ilyen garanciákat) nem tudnak.
Ha normál fájlt használunk, a folyamat felírhatja az összes kimenetét és átadhatja egy másik folyamatnak. Vagy a folyamatok működhetnek szigorú párhuzamos módban, külső jelzőmechanizmussal (például szemaforral) jelezve egymásnak a felvétel vagy az olvasás befejezését. A csövek megszabadítanak minket ezektől a problémáktól.
Mit keresünk?
Elmagyarázom egyszerűen, hogy könnyebben elképzelhesd, hogyan működhet a cső. Szükséged lesz egy memóriában létrehozott pufferre és valamilyen állapotra. Szükséged lesz funkciókra az adatok hozzáadásához és eltávolításához a pufferről. Szükség lesz valamilyen eszközre, amely lehetővé teszi a funkciók felhívását az olvasási és írási műveletek során a fájlok deszkriptorain. És szükség lesz zárolásokra, hogy végrehajthassuk a fent leírt különleges viselkedést.
Most készen állunk arra, hogy fényes lámpák alatt kihallgassuk a kernel forráskódját, hogy megerősítsük vagy megcáfoljuk homályos mentális modellünket. De mindig készülj fel a meglepetésekre.
Hol keressük?
Nem tudom, hol található a híres könyvem példánya, a ““ a Unix 6 forráskódjával, de a kábelen keresztül online is kereshetünk a még régebbi Unix verziókban.
Az TUHS archívumaiban való barangolás olyan, mint egy múzeum látogatása. Megnézhetjük közös történelmünket, és tisztelettel adózom az összes anyag bitről bitre történő helyreállításához fáradozó éveknek. Élesen tudatában vagyok azoknak a fragmentumoknak is, amelyek még hiányoznak.
Miután kielégítettem a kíváncsiságomat a csövek ősi történetéről, a összehasonlítás kedvéért megnézhetjük a modern kernelt.
Egyébként, cső a rendszerhívások táblázatában a 42. számú. sysent[]. Véletlen egybeesés?
A hagyományos Unix rendszerek (1970–1974)
Nem találtam nyomokat A csővezetékek egyirányú csatornát biztosítanak a folyamatok közötti kommunikációhoz. A csővezetéknek van egy bemenete (write end) és egy kimenete (read end). A csővezeték bemenetére írt adatok a kimenetén olvashatók. sem a (1970 január), sem az (1971 november), sem a nem teljes forráskódban (1972 június).
A TUHS állítja, hogy (1973 február) volt az első verzió, amely csöveket tartalmazott:
A Unix harmadik kiadása volt az utolsó verzió, amelynek magját assembler nyelven írták, de egyben az első verzió is, amely pipákat használt. 1973-ban a harmadik kiadás fejlesztésén dolgoztak, a magot C nyelvre írták át, így született meg a Unix negyedik kiadása.
Az egyik olvasó talált egy dokumentum másolatát, amelyben Doug MacIlroy javasolta a programok „kerti slag” elv szerinti összekapcsolását.
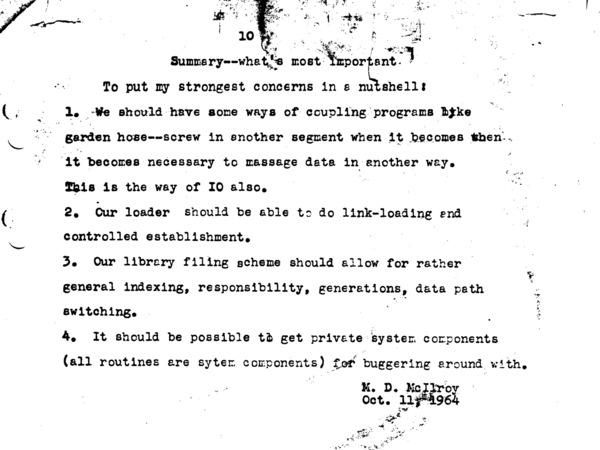
Brian Kernighan "", a pipák megjelenésének történetében is megemlíti ezt a dokumentumot: „… a falamon lógott a Bell Labs-ban eltöltött 30 év alatt”. Íme, , és még egy történet a :
Amikor a Unix megjelent, a korutinok iránti vonzalmam arra késztetett, hogy megkérjem az operációs rendszer szerzőjét, Ken Thompsont, hogy a valamilyen folyamatba írt adatok ne csak az eszközre, hanem egy másik folyamat kimenetére is eljussanak. Ken úgy döntött, hogy ez lehetséges. Azonban minimalista lévén szeretné, ha minden rendszerfunkció jelentős szerepet játszana. Valóban van-e nagy előnye a folyamatok közötti közvetlen írásnak a köztes fájlba történő íráshoz képest? És csak amikor konkrét javaslatot tettem „pipa” néven és a folyamatok interakciójának szintaxisának leírásával, Ken végre felkiáltott: „Megcsinálom!”
És meg is tette. Egy sorsfordító estén Ken megváltoztatta a magot és a shell-t, kijavította néhány standard programot, szabványosítva az adatbeviteli eljárásukat (amelyek a pipából érkezhetnek), valamint átnevezte a fájlokat. Másnap a pipákat széles körben kezdték alkalmazni az alkalmazásokban. A hét végére a titkárnők ezek segítségével nyomtatták ki a dokumentumokat szövegszerkesztőkből. Később Ken az eredeti API-t és a pipák használatához tartozó shell szintaxist tisztább megállapodásokra cserélte, amelyeket azóta is használnak.
Sajnos a Unix harmadik kiadásának forráskódja elveszett. Bár van egy C nyelven írt forráskódunk a negyedik kiadásról, Van nekünk dokumentációs szövegünk a
У нас есть текст документации по A csővezetékek egyirányú csatornát biztosítanak a folyamatok közötti kommunikációhoz. A csővezetéknek van egy bemenete (write end) és egy kimenete (read end). A csővezeték bemenetére írt adatok a kimenetén olvashatók. mindkét kiadás alapján, ezért érdemes a dokumentációban keresni (bizonyos szavak alapján, amelyek "kézzel" vannak aláhúzva, a literals ^H sor, amely után egy alsó vonal következik!). Ez a proto-A csővezetékek egyirányú csatornát biztosítanak a folyamatok közötti kommunikációhoz. A csővezetéknek van egy bemenete (write end) és egy kimenete (read end). A csővezeték bemenetére írt adatok a kimenetén olvashatók. assembly nyelven íródott és csak egy fájldeszkriptort ad vissza, de már megadja a várt alapfunkcionalitást:
A rendszerhívás cső létrehoz egy bemenet-kimeneti mechanizmust, amely csőnéven ismert. A visszaadott fájldeszkriptor használható olvasási és írási műveletekhez. Amikor a csőbe valami beíródik, 504 bájt adatig pufferelődik, majd az írási folyamat felfüggesztődik. Amikor a csőből olvasunk, a pufferelt adatok elérhetők.
A következő évre a kernel C nyelvre lett átírva, és elnyerte a modern formáját a "pipe(fildes)»:
A rendszerhívás cső létrehoz egy bemenet-kimeneti mechanizmust, amely csőnéven ismert. A visszaadott fájldeszkriptorok olvasási és írási műveleteknél használhatók. Amikor valami beíródik a csőbe, az r1-ben (azaz fildes[1]-ben) visszaadott deszkriptor 4096 bájt adatig pufferelődik, majd az írási folyamat felfüggesztődik. A csőből való olvasásnál az r0-ban (azaz fildes[0]-ben) visszaadott deszkriptor elérheti az adatokat.
Várható, hogy a cső meghatározása után két (vagy több) kölcsönhatásban lévő folyamat (amelyeket a következő hívások hoznak létre fork) adatokat fognak átadni a csőből a hívások segítségével. read és write.
A shell-ben van egy szintaxis a lineáris folyamatok tömbjének meghatározására, amelyeket csövek kapcsolnak össze.
Az üres csőből történő olvasási hívások (amely nem tartalmaz pufferelt adatokat), aminek csak egy vége van (az összes író fájldeszkriptort lezárták), "fájl vége"-t adnak vissza. Ilyen helyzetben az írási hívások figyelmen kívül maradnak.
A legkorábbi kapcsolódik (1974 június), de szinte azonos azzal, ami a következő kiadásban megjelent. Csak kommentárok kerültek hozzáadásra, így az ötödik kiadás kihagyható.
A hatodik Unix kiadás (1975)
Kezdjük el olvasni az Unix forráskódját (1975 május). Nagy részben Lions sokkal könnyebb megtalálni, mint a korábbi verziók forrásait:
Sok éven át a könyv Lions Ez volt az egyetlen dokumentum az Unix magjáról, amely a Bell Labs falain kívül elérhető volt. Míg a hatodik kiadás licensze lehetővé tette az oktatók számára a forráskód használatát, a hetedik kiadás licensze ezt kizárta, így a könyv illegális gépelt másolatok formájában terjedt.
Ma már meg lehet vásárolni a könyv újranyomott példányát, amelynek borítóján diákok láthatók egy fénymásoló mellett. Warren-Toome „TUHS” projektjének köszönhetően letöltheti a Szeretném bemutatni, mennyi munkát fektettek a fájl létrehozásába:
Több mint 15 évvel ezelőtt leírtam a forráskód egy példányát, amely a Lions-ban található, mert nem tetszett a másolatom minősége az ismeretlen számú másik másolatból. A TUHS még nem létezett, és nem volt hozzáférésem a régi forrásokhoz. De 1988-ban találtam egy régi, 9 sávos szalagot, amelyen egy biztonsági másolat volt a PDP11 számítógépről. Nehéz volt megérteni, hogy működik-e, de ott volt egy sértetlen /usr/src/ könyvtár, ahol a legtöbb fájl 1979-es évszámmal volt megjelölve, ami már akkor is réginek tűnt. Ez volt a hetedik kiadás vagy annak származéka, amit PWB-nek hívtam.
Ezt a felfedezést alapként használtam és manuálisan szerkesztettem a forrásokat a hatodik kiadás állapotára. Néhány kód maradt változatlan, egyes részeket kissé át kellett írnom, a modern += tokent elavult =+ -re cserélve. Néhány dolgot egyszerűen eltávolítottam, míg másokat teljesen át kellett írni, de nem túl sokat.
Ma már online olvashatjuk a TUHS honlapján a hatodik kiadás forráskódját, amelyhez .
Egyébként első pillantásra a C kód legfőbb jellemzője a tömörség.Nem túl gyakran tudom beilleszteni a kódrészleteket jelentős szerkesztés nélkül, hogy azok viszonylag szűk megjelenítési területen is megjelenjenek a weboldalamon.
Az elején találunk egy magyarázó kommentárt (és igen, ott van még ):
/*
 * Max allowable buffering per pipe.
 * This is also the max size of the
 * file created to implement the pipe.
 * If this size is bigger than 4096,
 * pipes will be implemented in LARG
 * files, which is probably not good.
 */
#define    PIPSIZ    4096
A puffer mérete a negyedik kiadás óta változatlan. De itt, nyilvános dokumentáció nélkül látjuk, hogy valaha a csővezetékek fájlokat használtak tartalék tárolóként!
Ami a LARG fájlokat illeti, azok megfelelnek a amelyet a "nagy címzés algoritmus" használ a feldolgozáshoz. a nagyobb fájlrendszerek támogatásának érdekében. Mivel Ken azt mondta, hogy a használatuk nem javasolt, örömmel hiszek neki.
Itt egy valódi rendszerhívás cső:
/*
 * The sys-pipe entry.
 * Allocate an inode on the root device.
 * Allocate 2 file structures.
 * Put it all together with flags.
 */
pipe()
{
    register *ip, *rf, *wf;
    int r;

    ip = ialloc(rootdev);
    if(ip == NULL)
        return;
    rf = falloc();
    if(rf == NULL) {
        iput(ip);
        return;
    }
    r = u.u_ar0[R0];
    wf = falloc();
    if(wf == NULL) {
        rf->f_count = 0;
        u.u_ofile[r] = NULL;
        iput(ip);
        return;
    }
    u.u_ar0[R1] = u.u_ar0[R0]; /* wf's fd */
    u.u_ar0[R0] = r;           /* rf's fd */
    wf->f_flag = FWRITE|FPIPE;
    wf->f_inode = ip;
    rf->f_flag = FREAD|FPIPE;
    rf->f_inode = ip;
    ip->i_count = 2;
    ip->i_flag = IACC|IUPD;
    ip->i_mode = IALLOC;
}
A kommentár világosan leírja, hogy mi történik itt. De nehéz megérteni a kódot, részben a "" és a regiszterek R0 és R1 átadják a rendszerhívások paramétereit és a visszatérési értékeket.
Próbáljuk az a lemezen elhelyezni , és az – a memóriában elhelyezni két . Ha minden jól megy, akkor beállítjuk a zászlókat, hogy ezeket a fájlokat a cső két végének tekintsük, megadjuk őket ugyanabban az inode-ban (amelynek hivatkozási számlálója 2-re emelkedik), és megjelöljük az inode-ot módosított és használatban álló állapotban. Figyeljen a hibás útvonalainak (error paths) használatára az új inode hivatkozási számlálójának csökkentésére.
pipe() ennek kell durch R0 és R1 visszaadnia a fájleíró számokat olvasásra és írásra. falloc()-t a fájlstruktúrára mutató pointert ad vissza, de "visszaadja" a u.u_ar0[R0] és a fájleíró. Tehát a kód tárolja a r fájleírót olvasásra, és az írási leírót közvetlenül a u.u_ar0[R0] második hívás után adja meg falloc()-t.
Zászló FPIPE, amelyet a cső létrehozásakor beállítottunk, szabályozza a , amely meghívja a konkrét bemeneti-kimeneti I/O alprogramokat:
/*
 * common code for read and write calls:
 * check permissions, set base, count, and offset,
 * and switch out to readi, writei, or pipe code.
 */
rdwr(mode)
{
    register *fp, m;

    m = mode;
    fp = getf(u.u_ar0[R0]);
        /* … */

    if(fp->f_flag&FPIPE) {
        if(m==FREAD)
            readp(fp); else
            writep(fp);
    }
        /* … */
}
Ezután a readp() be. pipe.c adatokat olvas a csőből. De az implementáció nyomon követését a writep()-tólajánlom elkezdeni. Ismétlem, a kód bonyolódott az argumentumok átadásának szabályai miatt, de egyes részletek kihagyhatók.
writep(fp)
{
    register *rp, *ip, c;

    rp = fp;
    ip = rp->f_inode;
    c = u.u_count;

loop:
    /* Ha minden kész, térjünk vissza. */

    plock(ip);
    if(c == 0) {
        prele(ip);
        u.u_count = 0;
        return;
    }

    /*
     * Ha nem mindkét olvasási és írási oldal aktív a
     * csőben, térjünk vissza hibával és jelezzünk is.
     */

    if(ip->i_count i_size1 == PIPSIZ) {
        ip->i_mode |= IWRITE;
        prele(ip);
        sleep(ip+1, PPIPE);
        goto loop;
    }

    /* Írja azt, ami lehetséges, és térjen vissza a ciklushoz. */

    u.u_offset[0] = 0;
    u.u_offset[1] = ip->i_size1;
    u.u_count = min(c, PIPSIZ-u.u_offset[1]);
    c -= u.u_count;
    writei(ip);
    prele(ip);
    if(ip->i_mode & IREAD) {
        ip->i_mode &= ~IREAD;
        wakeup(ip+2);
    }
    goto loop;
}
A csőbe bájtokat szeretnénk írni u.u_count. Először is kérni kell az indexelő leíró blokkolását (lásd alább plock/prele).
Ezután ellenőrizzük az inode hivatkozási számlálóját. Amíg a cső mindkét vége nyitva van, a számlálónak 2-nek kell lennie. Tartjuk egy hivatkozást (a rp->f_inode), így ha a számláló kevesebb mint 2, az azt jelenti, hogy az olvasó folyamat bezárta a cső egyik végét. Más szóval, megpróbálunk egy zárt csőbe írni, ami hiba. Az első hibakód EPIPE és a jel SIGPIPE a Unix hatodik kiadásában jelent meg.
De még ha a cső nyitva is van, az megtelhet. Ebben az esetben feloldjuk a zárat, és alszunk abban a reményben, hogy egy másik folyamat olvasni fog a csőből, és elegendő helyet szabadít fel benne. Felébredve visszatérünk a kezdéshez, újra felrakjuk a zárat, és elindítunk egy új írási ciklust.
Ha a csőben elegendő szabad hely van, akkor adatokat írunk bele a . A paraméter i_size1 az inode-nál (üres cső esetén 0 lehet) jelzi az adatokat, amelyek már benne vannak. Ha van elegendő hely az íráshoz, a csövet a i_size1 tól PIPESIZtól kezdve tölthetjük meg. Ezután felszabadítjuk a zárat, és megpróbálunk felébreszteni bármely folyamatot, amely vár a csőből való olvasási lehetőségre. Visszatérünk az elejére, hogy megnézzük, sikerült-e annyi bájtot írni, amennyire szükségünk volt. Ha nem sikerült, új írási ciklust kezdünk.
Általában az inode i_mode a jogosultságok tárolására szolgál. r, w és xDe a csövek esetén azt jelezzük, hogy egy folyamat várakozik az írásra vagy olvasásra az IREAD és IWRITE bitekkel. A folyamat beállít egy zászlót és meghívja a sleep(), és elvárható, hogy később egy másik folyamat meghívja a wakeup().
A valódi varázslat a sleep() és wakeup(). Ezeket a , a híres "Nem köteles ezt megérteni" (You are not expected to understand this) kommentár forrásában valósítják meg. Szerencsére nem kell értelmeznünk a kódot, csak néhány megjegyzést nézünk meg:
/*
 * Give up the processor till a wakeup occurs
 * on chan, at which time the process
 * enters the scheduling queue at priority pri.
 * The most important effect of pri is that when
 * pri<0 a signal cannot disturb the sleep;
 * if pri>=0 signals will be processed.
 * Callers of this routine must be prepared for
 * premature return, and check that the reason for
 * sleeping has gone away.
 */
sleep(chan, pri) /* … */

/*
 * Wake up all processes sleeping on chan.
 */
wakeup(chan) /* … */
A folyamat, amely meghívja a sleep() egy meghatározott csatornához, később felébreszthető egy másik folyamat által, amely meghívja a wakeup() ugyanarra a csatornára. writep()-tól és readp() koordinálják tevékenységeiket ilyen páros hívások révén. Ne feledje, hogy a pipe.c mindig prioritást ad a PPIPE a meghíváskor: sleep()által, ezért minden sleep() meg tud szakadni egy jelzéskor.
Most minden megvan ahhoz, hogy megértsük a funkciót. readp():
readp(fp)
int *fp;
{
    register *rp, *ip;

    rp = fp;
    ip = rp->f_inode;

loop:
    /* Nagyon konzervatív zárolás. */

    plock(ip);

    /*
     * Ha a fej (olvasás) utolérte
     * a farkat (írás), állítsuk vissza mindkettőt 0-ra.
     */

    if(rp->f_offset[1] == ip->i_size1) {
        if(rp->f_offset[1] != 0) {
            rp->f_offset[1] = 0;
            ip->i_size1 = 0;
            if(ip->i_mode&IWRITE) {
                ip->i_mode =& ~IWRITE;
                wakeup(ip+1);
            }
        }

        /*
         * Ha nincs aktív olvasó és
         * író, térjünk vissza anélkül,
         * hogy teljesítenénk az olvasást.
         */

        prele(ip);
        if(ip->i_count i_mode |= IREAD;
        sleep(ip+2, PPIPE);
        goto loop;
    }

    /* Olvasás és visszaadás */

    u.u_offset[0] = 0;
    u.u_offset[1] = rp->f_offset[1];
    readi(ip);
    rp->f_offset[1] = u.u_offset[1];
    prele(ip);
}
Lehet, hogy könnyebb lesz felfelé olvasni ezt a funkciót. Az "olvasás és visszaadás" ág általában akkor kerül használatra, amikor adat van a csőben. Ebben az esetben ezzel olvasunk annyi adatot, amennyi elérhető a jelenlegi f_offset olvasásból, majd frissítjük a megfelelő eltolás értékét.
A következő olvasás során a cső üres lesz, ha az olvasási eltolás elérte az i_size1 inode értékét. Visszaállítjuk a pozíciót 0-ra, és megpróbáljuk felébreszteni minden folyamatot, amely írni akar a csőbe. Tudjuk, hogy amikor a cső tele lesz, writep()-tól aludni fog az ip+1. Most, hogy a cső üres, fel tudjuk ébreszteni, hogy folytathassa az írás ciklusát.
Ha nincs mit olvasni, akkor readp() beállíthat egy zászlót IREAD és aludhat az ip+2. Tudjuk, hogy fel fogja ébreszteni writep()-tól, amikor adatokat ír a csőbe.
A "readi()" és "writei()" megjegyzések segítenek megérteni, hogy ahelyett, hogy a paramétereket " A "konzervatív" zárolásról szólva), csoport (az inode-ot blokkolják, amíg be nem fejezik a munkát, vagy nem kapnak eredményt (azaz nem hívják meg a
/*
 * Read the file corresponding to
 * the inode pointed at by the argument.
 * The actual read arguments are found
 * in the variables:
 *    u_base        core address for destination
 *    u_offset    byte offset in file
 *    u_count        number of bytes to read
 *    u_segflg    read to kernel/user
 */
readi(aip)
struct inode *aip;
/* … */

/*
 * Write the file corresponding to
 * the inode pointed at by the argument.
 * The actual write arguments are found
 * in the variables:
 *    u_base        core address for source
 *    u_offset    byte offset in file
 *    u_count        number of bytes to write
 *    u_segflg    write to kernel/user
 */
writei(aip)
struct inode *aip;
/* … */
wakeup readp() és writep()-tól plock() prele()). egyszerűen működnek: egy másik híváscsoport segítségével és lehetővé téve számunkra, hogy felébreszthessünk bármely folyamatot, amelynek szüksége van a frissen eltávolított zárolásra: Először nem értettem, miért sleep és prele() nem hívja meg a
/*
 * Lock a pipe.
 * If its already locked, set the WANT bit and sleep.
 */
plock(ip)
int *ip;
{
    register *rp;

    rp = ip;
    while(rp->i_flag&ILOCK) {
        rp->i_flag =| IWANT;
        sleep(rp, PPIPE);
    }
    rp->i_flag =| ILOCK;
}

/*
 * Unlock a pipe.
 * If WANT bit is on, wakeup.
 * This routine is also used to unlock inodes in general.
 */
prele(ip)
int *ip;
{
    register *rp;

    rp = ip;
    rp->i_flag =& ~ILOCK;
    if(rp->i_flag&IWANT) {
        rp->i_flag =& ~IWANT;
        wakeup(rp);
    }
}
prele(ip) előtt a readp() wakeup(ip+1)-t. Az első dolog, amit a saját ciklusában hív, az a plock(ip),ami holtpontot okozhat, ha writep()-tól még nem oldotta fel a zárolását, tehát a kód valamilyen módon helyesen kell működjön. Ha megnézzük a kódot, akkor láthatjuk, hogymások is hasonlóan működnek, de ha megértünk mindent, kínálunk a readp() hasonló megoldásokkal. wakeup(), ezért világos, hogy csak a szunnyadó folyamatot jelöli meg késznek a végrehajtásra, hogy a jövőben sched() valóban elindította. Szóval readp() hívja wakeup(), leveszi a zárolást, beállítja IREAD és hívja sleep(ip+2)— mindez mielőtt writep()-tól újraindítja a ciklust.
Ezzel véget ért a csövek leírása a hatodik kiadásban. Egyszerű kód, messzemenő következményekkel.
(1979 január) új főkiadás volt (négy év után), amelyben sok új alkalmazás és a mag új jellemzői jelentek meg. Emellett jelentős változások történtek a típusképzés, az uniók és a típusos mutatók struktúrákra való használatával kapcsolatban. Azonban gyakorlatilag nem változott. Átugorhatjuk ezt a kiadást.
Xv6, egy egyszerű Unix-szerű mag
Az Xv6 mag létrehozására elérhetőek a Githubon .
, ami a memóriában lévő puffer által van alátámasztva, nem a lemezen lévő inode. Itt csak a "strukturális cső" definícióját és a funkcionalitást adom meg pipealloc() , ami a többi megvalósítás állapotát képezi, amely tartalmazza a funkcionalitásokat:
#define PIPESIZE 512

struct pipe {
  struct spinlock lock;
  char data[PIPESIZE];
  uint nread;     // number of bytes read
  uint nwrite;    // number of bytes written
  int readopen;   // read fd is still open
  int writeopen;  // write fd is still open
};

int
pipealloc(struct file **f0, struct file **f1)
{
  struct pipe *p;

  p = 0;
  *f0 = *f1 = 0;
  if((*f0 = filealloc()) == 0 || (*f1 = filealloc()) == 0)
    goto bad;
  if((p = (struct pipe*)kalloc()) == 0)
    goto bad;
  p->readopen = 1;
  p->writeopen = 1;
  p->nwrite = 0;
  p->nread = 0;
  initlock(&p->lock, "pipe");
  (*f0)->type = FD_PIPE;
  (*f0)->readable = 1;
  (*f0)->writable = 0;
  (*f0)->pipe = p;
  (*f1)->type = FD_PIPE;
  (*f1)->readable = 0;
  (*f1)->writable = 1;
  (*f1)->pipe = p;
  return 0;

 bad:
  if(p)
    kfree((char*)p);
  if(*f0)
    fileclose(*f0);
  if(*f1)
    fileclose(*f1);
  return -1;
}
, ami a többi megvalósítás állapotát képezi, amely tartalmazza a funkcionalitásokat piperead() pipewrite(), pipeclose() és . A tényleges rendszerhívássys_pipe a sysfile.c -ben megvalósított csomagolás. Javaslom, hogy olvasd el az összes kódját. A hatodik kiadás forrásához képest bonyolultságban azonos, de sokkal könnyebben és szívesebben olvasható. Meg lehet találni a Linux 0.01 forráskódját. Tanulságos lenne megvizsgálni a csövek megvalósítását benne.
. Itt az inode-ot használják a cső reprezentálására, de a cső maga modern C nyelven van megírva. Ha átrágtad magad a hatodik kiadás kódján, itt nem lesz nehézséged. Így néz ki a funkció
write_pipe() fs/pipe.c. Здесь для представления конвейера используется inode, но сам конвейер написан на современном C. Если вы продрались через код шестой редакции, то здесь вы не испытаете трудностей. Так выглядит функция write_pipe():
int write_pipe(struct m_inode * inode, char * buf, int count)
{
    char * b=buf;

    wake_up(&inode->i_wait);
    if (inode->i_count != 2) { /* no readers */
        current->signal |= (1< 0) {
        while (PIPE_FULL(*inode)) {
            wake_up(&inode->i_wait);
            if (inode->i_count != 2) {
                current->signal |= (1<i_wait);
        }
        ((char *)inode->i_size)[PIPE_HEAD(*inode)] =
            get_fs_byte(b++);
        INC_PIPE( PIPE_HEAD(*inode) );
        wake_up(&inode->i_wait);
    }
    wake_up(&inode->i_wait);
    return b-buf;
}
Még a struktúrák meghatározásainak megtekintése nélkül is megérthető, hogyan használják az inode hivatkozási számlálóját annak ellenőrzésére, hogy a írási művelet SIGPIPE. Az adatok byte-onkénti kezelése mellett ezt a funkciót könnyen össze lehet hasonlítani a fent említett ötletekkel. Még a logika sleep_on/wake_up nem tűnik annyira idegennek.
A modern Linux, FreeBSD, NetBSD, OpenBSD kernelfejlesztések
Gyorsan átfutottam néhány modern kernelt. Egyikben sem található már disk alapú megvalósítás (nem meglepő módon). A Linuxnak saját megvalósítása van. Habár a három modern BSD kernel számos John Dyson által írt kódra épít, az évek során túl sokat eltértek egymástól.
Ahhoz, hogy olvasni tudjuk fs/pipe.c (Linux alatt) vagy sys/kern/sys_pipe.c (BSD rendszereken) valódi elkötelezettség szükséges. Manapság a kódban a teljesítmény és az olyan funkciók támogatása, mint az vektoros és aszinkron I/O műveletek fontosak. A memóriakezelés, a zárak és a kernel konfiguráció részletei pedig jelentősen eltérnek. Ez nem az, amit az egyetemek az operációs rendszerek bevezető tanfolyamához használnának.
Mindenesetre érdekelt néhány régi minta (például a zárt csőbe írás), mindezekben a különböző, modern kernelfejlesztésekben. Valószínűleg soha nem fogom látni a PDP-11 számítógépet, de van mit tanulni az általam megszületésem óta évek óta írt kódból. SIGPIPE A 2011-ben Divi Kapur által írt " EPIPE The Linux Kernel Implementation of Pipes and FIFOs
" bemutatja, hogyan működnek (ma is) a csövek a Linuxban. Egyillusztrálja a csőmodellek működését, amelynek lehetőségei meghaladják az ideiglenes fájlokét; és bemutatja, hogy mennyire elmozdultak a csövek a Unix 6. kiadásának "nagyon konzervatív zárjától". иллюстрирует конвейерную модель взаимодействия, чьи возможности превышают возможности временных файлов; а также показывает, насколько далеко ушли конвейеры от «очень консервативной блокировки» в ядре Unix шестой редакции.
Forrás: habr.com
