

Helló, Habr! Artem Karamyshev vagyok, a rendszeradminisztrációs csapat vezetője. . Az előző évben sok új termék indítása történt. Célunk az volt, hogy az API-szolgáltatások könnyen méretezhetőek, hibatűrőek és készen álljanak a felhasználói terhelés gyors növekedésére. Platformunk az OpenStackra épül, és szeretném elmondani, milyen hibatűrőséggel kapcsolatos problémákat kellett megoldanunk ahhoz, hogy egy hibatűrő rendszerhez jussunk. Azt hiszem, ez érdekes lesz azok számára is, akik szintén OpenStack alapú termékeket fejlesztenek.
A platform hibatűrése a komponenseinek stabilitásából áll össze. Így fokozatosan végigmegyünk azokon a szinteken, ahol kockázatokat észleltünk és megoldottuk őket.
A történet videóváltozatát, amelynek forrása az Uptime Day 4 konferencián elhangzott előadás, , megtekinthető .
A fizikai architektúra hibatűrése
A MCS ködnek jelenlegi nyilvános része két Tier III szintű adatközpontban található, köztük saját sötét szálat biztosítunk, amely különböző útvonalakon, 200 Gbit/s sávszélességgel van fenntartva. A Tier III szint biztosítja a fizikai infrastruktúra hibatűréséhez szükséges szintet.
A sötét szálat mind fizikai, mind pedig logikai szinten fenntartják. A csatornák fenntartási folyamata iteratív volt, felmerültek problémák, és folyamatosan javítjuk az adatközpontok közötti kapcsolatot.
Például nemrégiben, amikor egy adatközpont közelében egy aknában dolgoztunk, egy gép ásásakor átszakított egy csövet, amelyben mind a fő, mind a tartalék optikai kábel volt. A hibatűrő kapcsolatunk az adatközponttal egy ponton sebezhetővé vált, az aknában. Ennek megfelelően elvesztettük az infrastruktúra egy részét. Levontuk a következtetéseket, intézkedtünk, többek között egy további optikai kábelt fektettünk le a szomszédos aknában.
A dátközpontokban vannak a szolgáltatók jelenlétét jelző pontok, amelyeknek a BGP-n keresztül közvetítjük a prefixeinket. Minden hálózati irányhoz a legjobb metrikát választjuk, ami lehetővé teszi, hogy különböző ügyfelek a legjobb kapcsolatminőséget élvezhessék. Ha az egyik szolgáltató kapcsolata megszakad, újraépítjük az útválasztást a rendelkezésre álló szolgáltatókon keresztül.
Ha a szolgáltató működése leáll, automatikusan átváltunk a következőre. Ha az egyik adatközpont leáll, van egy tükörmásolatunk a szolgáltatásainkról a második adatközpontban, amely átveszi az összes terhelést.
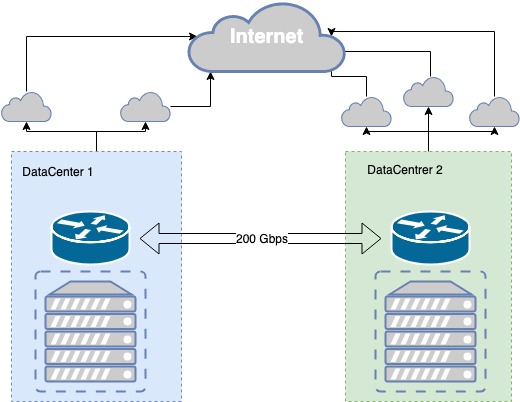
A fizikai infrastruktúra magas rendelkezésre állású
Mit használunk az alkalmazások szintjén a magas rendelkezésre állás biztosítására
Szolgáltatásunk számos nyílt forráskódú komponensre épül.
ExaBGP — olyan szolgáltatás, amely számos funkciót valósít meg a BGP alapú dinamikus útválasztási protokoll használatával. Aktívan használjuk, hogy bejelentsük a fehér IP-címeinket, amelyeken keresztül a felhasználók hozzáférnek az API-hoz.
HAProxy — nagy terhelésű terheléselosztó, amely lehetővé teszi a forgalom nagyon rugalmas szabályainak beállítását az OSI modell különböző szintjein. Ezt használjuk az összes szolgáltatásunk, mint például adatbázisok, üzenetközvetítők, API-szolgáltatások, webszolgáltatások és belső projektjeink terheléselosztására — minden a HAProxy mögött áll.
API alkalmazás — webalkalmazás, amelyet Pythonban írtak, és amellyel a felhasználó kezelheti az infrastruktúráját és a szolgáltatását.
Worker alkalmazás (továbbiakban egyszerűen worker) — az OpenStack szolgáltatásokban ez egy infrastruktúra démon, amely lehetővé teszi az API-parancsok közvetítését az infrastruktúrára. Például a lemez létrehozása a workerben történik, míg a létrehozási kérés az API alkalmazásban zajlik.
OpenStack alkalmazás standard architektúrája
A legtöbb szolgáltatás, amely OpenStack alatt készül, megpróbál egy egységes paradigmát követni. A szolgáltatás általában két részből áll: API-ból és worker-ekből (háttérfeldolgozók). Általában az API egy Python alapú WSGI-app, amely vagy önálló folyamatként (daemon) fut, vagy egy már meglévő webkiszolgáló, például Nginx vagy Apache segítségével. Az API feldolgozza a felhasználói kéréseket, és átadja a további utasításokat a worker alkalmazásnak. Az átadást üzenetbroker végzi, általában RabbitMQ, a többi kevésbé támogatott. Amikor az üzenetek a brokerhez érkeznek, azokat a worker-ek feldolgozzák és szükség esetén választ adnak.
Ez a paradigma elszigetelt közös meghibásodási pontokat feltételez: RabbitMQ és az adatbázis. Ugyanakkor a RabbitMQ egy szolgáltatáson belül izolálva van, és elvileg egyedi lehet minden szolgáltatás számára. Tehát az MCS-nél maximálisan szétválasztjuk ezeket a szolgáltatásokat, minden külön projekt számára külön adatbázist és külön RabbitMQ-t hozunk létre. Ez a megközelítés előnyös, mert ha valamilyen sebezhető ponton hiba lép fel, akkor nem az egész szolgáltatás, hanem csak a része hibásodik meg.
A worker alkalmazások száma semmilyen módon nincs korlátozva, így az API könnyen horizontálisan skálázható a terheléselosztók mögött a teljesítmény és a hibatűrés növelése érdekében.
Néhány szolgáltatásban szükség van a koordinációra a szolgáltatáson belül - amikor bonyolult sorozatos műveletek történnek az API és a worker-ek között. Ebben az esetben egységes koordináló központot használunk, egy klaszterezett rendszert, mint például Redis, Memcache, stb., ami lehetővé teszi, hogy az egyik worker jelezze a másiknak, hogy ez a feladat rá van bízva („kérlek, ne vedd el”). Mi az etcd-t használjuk. Általában a worker-ek aktívan kommunikálnak az adatbázissal, írnak és olvasnak onnan információt. Adatbázisként a mariadb-t használjuk, amely multimaster klaszterben található.
Ez a klasszikus egyedi szolgáltatás az OpenStack számára elterjedt módon van megszervezve. Zárt rendszerként tekinthető, amely számára a skálázás és a hibatűrés módszerei nyilvánvalóak. Például az API hibatűréséhez elegendő, ha egy terheléselosztót helyezünk eléjük. A worker-ek skálázása a számuk növelésével érhető el.
A RabbitMQ és a MariaDB a rendszeren belüli gyenge láncsok. Építkezésük külön témát érdemel. Ebben a cikkben az API megbízhatóságára szeretnék összpontosítani.
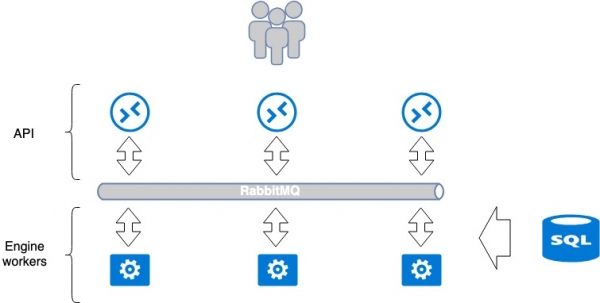
Openstack Application architektúra. A felhőplatform egyensúlyba állítása és megbízhatóságának biztosítása.
Hozzuk létre a HAProxy egyensúlyozót megbízhatóvá az ExaBGP segítségével.
Ahhoz, hogy API-jaink skálázhatóak, gyorsak és megbízhatóak legyenek, egy egyensúlyozót állítottunk eléjük. A HAProxy-ra esett a választásunk. Szerintem rendelkezik minden szükséges jellemzővel a feladatunkhoz: több OSI szintű egyensúlyozás, kezelőfelület, rugalmasság és skálázhatóság, számos egyensúlyozási módszer, session táblák támogatásával.
Az első probléma, amelyet meg kellett oldani, a balancéráló megbízhatósága volt. Csak a balancéráló telepítése is létrehoz egy kiesési pontot: ha a balancéráló elromlik, a szolgáltatás megszűnik. Ennek elkerülésére a HAProxy-t együtt használtuk az ExaBGP-vel.
Az ExaBGP lehetővé teszi a szolgáltatás állapotának ellenőrzési mechanizmusának megvalósítását. Ezt a mechanizmust arra használtuk, hogy ellenőrizzük a HAProxy működését, és problémák esetén leállítsuk a HAProxy szolgáltatást a BGP-ből.
ExaBGP+HAProxy séma.
- Három szerverre telepítjük a szükséges szoftvert, az ExaBGP-t és a HAProxy-t.
- Minden egyes szerveren létrehozzuk a loopback interfészt.
- Mindhárom szerveren beállítjuk ugyanazt a nyilvános IP-címet erre az interfészre.
- A nyilvános IP-cím az ExaBGP-n keresztül kerül bejelentésre az interneten.
A megbízhatóságot az jelenti, hogy ugyanazt az IP-címet hirdetjük három különböző szerveren. Hálózati szempontból ugyanaz a cím, három különböző next hop-ból érhető el. A router három azonos útvonalat lát, az önálló metrikája alapján választja ki a legprioritásosabbat (ez általában ugyanaz a lehetőség), és a forgalom csak az egyik szerverre irányul.
HAProxy működési problémái vagy a szerver kiesése esetén az ExaBGP leállítja az útvonal hirdetését, és a forgalom simán egy másik szerverre vált.
Így sikerült elérni a balancéráló megbízhatóságát.
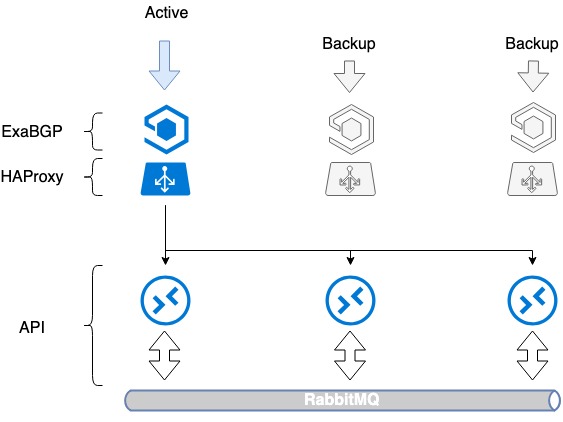
HAProxy egyensúlyozók megbízhatósága.
A séma nem tökéletes: megtanultuk a HAProxy tartalékosítását, de nem tanultuk meg a terhelés elosztását a szolgáltatások között. Ezért a sémát egy kicsit kibővítettük: átálltunk a több nyilvános IP-cím közötti egyensúlyozásra.
DNS-alapú terheléselosztás + BGP
A HAProxy előtt lévő terheléselosztás problémája továbbra is megoldatlan. Ugyanakkor ezt elég egyszerűen meg lehet oldani, ahogyan azt mi is tettük.
Három szerver terheléselosztásához 3 fehér IP-címre és a régi, jó DNS-re lesz szükség. Mindegyik címet a HAProxy-k loopback interfészére kell beállítani, és az interneten be kell jelenteni.
Az OpenStackben az erőforrások kezeléséhez szolgáltatás-katalógust használunk, amelyben meghatározzuk az egyes szolgáltatások API-jának végpontját. Ebben a katalógusban megadjuk a domain nevet — public.infra.mail.ru, amely három különböző IP-címmel DNS-en keresztül feloldódik. Ennek eredményeként terheléselosztást kapunk a három cím között DNS-en keresztül.
A fehér IP-címek bejelentésekor azonban nem kezeljük a szerver kiválasztási prioritásokat, ez nem minősül terheléselosztásnak. Általában egyetlen szerver lesz kiválasztva az IP-címek rangsora alapján, míg a másik két szerver inaktív marad, mivel a BGP-ben nincsenek megadva metrikák.
Megkezdtük az ExaBGP-n keresztül történő útvonalak hirdetését különböző metrikákkal. Minden terheléselosztó három fehér IP-címet jelent be, de ezek közül az egyik, a terheléselosztónk fő IP-címe, a legalacsonyabb metrikával kerül hirdetésre. Így amíg mindhárom terheléselosztó működik, az első IP-címre érkező kérések az első terheléselosztóra érkeznek, a második IP-címre érkezők a másodikra, a harmadik pedig a harmadikra.
Mi történik abban a pillanatban, amikor az egyik terheléselosztó leáll? Ha bármelyik terheléselosztó kiesik, a fő címét továbbra is a másik kettő hirdeti, és a forgalom újra lesz elosztva közöttük. Így a DNS-en keresztül azonnal több IP-címet adunk a felhasználónak. A DNS-en történő terheléselosztás és a különböző metrikák révén egyenletes terheléselosztást kapunk az összes három terheléselosztón. Ezzel együtt nem veszítjük el a hibátűrést.
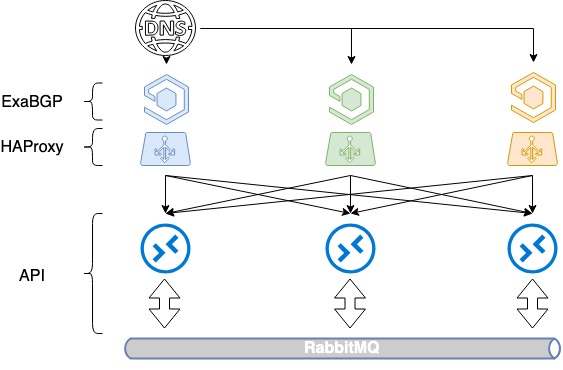
HAProxy terheléselosztás DNS + BGP alapú
Interakció az ExaBGP és HAProxy között
Tehát, megvalósítottuk a hibátűrést a szerver leállása esetére az útvonalbejelentések megállítása alapján. Azonban a HAProxy más okok miatt is leállhat, mint a szerver meghibásodása: adminisztrációs hibák, a szolgáltatáson belüli hibák. Szükség van egy másik mechanizmusra, hogy a hibás terheléselosztót eltávolítsuk a terhelés alól ezekben az esetekben.
Ezért a korábbi sémát bővítve megvalósítottuk a heartbeat-et az ExaBGP és a HAProxy között. Ez a szoftveres megoldás lehetővé teszi az ExaBGP és a HAProxy közötti interakciót, amikor az ExaBGP testreszabott szkripteket használ az alkalmazások állapotának ellenőrzésére.
Ehhez az ExaBGP konfigurációjában be kell állítani a health checkert, amely ellenőrzi a HAProxy állapotát. Esetünkben a HAProxy-ban health backend-et állítottunk be, míg az ExaBGP oldaláról egy egyszerű GET kéréssel ellenőrzünk. Ha a bejelentés megszűnik, akkor valószínűleg a HAProxy nem működik, és azt nem kell bejelenteni.
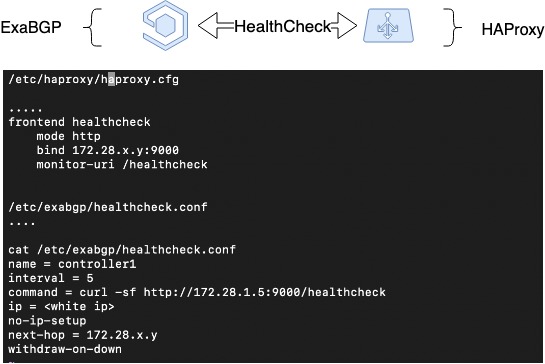
HAProxy Health Check
HAProxy Peers: ülések szinkronizálása
A következő lépés az ülés szinkronizálása volt. A központosított terheléselosztók használata során nehézséget jelent az ügyfélülések információinak megőrzése. Azonban a HAProxy az egyik kevés terheléselosztó, amely lehetővé teszi ezt a Peers funkcióján keresztül — lehetőséget biztosít különböző HAProxy folyamatok közötti ülés táblák továbbítására.
Különböző terheléselosztási módszerek léteznek: egyszerűek, mint például , és kiterjesztettek, amikor az ügyfélülést megjegyzik, és minden alkalommal ugyanarra a szerverre irányítják, mint korábban. Mi a második változatot szerettük volna megvalósítani.
A HAProxy-ban az ügyfélülések megőrzésére stick-tables mechanizmusa szolgál. Ezek megőrzik az ügyfél eredeti IP-címét, a választott célcímet (backend) és némi segédinformációt. Általában a stick-táblákat az IP-forrás + IP-cél pár megőrzésére használják, ami különösen hasznos az olyan alkalmazások esetén, amelyek nem tudják továbbítani a felhasználói ülés kontextusát egy másik terheléselosztóhoz való átkapcsoláskor, például körkörös terheléselosztás üzemmódban.
Ha a stick-táblát megtanítjuk arra, hogy mozogjon a különböző HAProxy folyamatok között (amelyek közötti terheléselosztás történik), a terheléselosztóink egy stick-táblákból álló egyesített halmazzal tudnak dolgozni. Ez lehetővé teszi az ügyfél hálózatának zökkenőmentes váltását, ha az egyik terheléselosztó meghibásodik, az ügyfélülések a korábban választott backendeken folytatódnak.
A helyes működés érdekében meg kell oldani a terheléselosztó forrás IP-címének problémáját, ahonnan az ülés létrejött. Esetünkben ez dinamikus cím a loopback interfészen.
A peers megfelelő működése csak bizonyos körülmények között valósul meg. Más szóval, a TCP-időknek elég hosszúaknak kell lenniük, vagy a váltásoknak elég gyorsnak, hogy a TCP-munkamenet ne szakadhasson meg. Ennek ellenére lehetővé teszi a zökkenőmentes váltást.
IaaS szolgáltatásunk hasonló technológián alapul. Ez a , amelyet Octavia-nak hívnak. Két HAProxy folyamatra épül, és eleve tartalmazza a peers támogatását. Ebben a szolgáltatásban kiválóan teljesítettek.
A képen diagramon látható a peers táblák mozgatása a három HAProxy példány között, és bemutatásra került a konfiguráció, hogy ezt hogyan lehet beállítani:
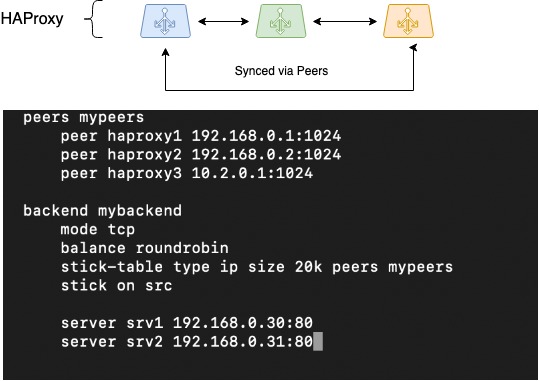
HAProxy Peers (munkamenetek szinkronizálása)
Ha hasonló rendszert valósítasz meg, a működését alaposan tesztelni kell. Nem garantált, hogy ez 100%-osan fog működni. De legalább nem fogsz elveszíteni stick táblákat, amikor emlékezni kell a kliens forrás IP-jére.
A párhuzamos kérések korlátozása ugyanattól a kliens-től
Bármely nyilvános elérhetőségű szolgáltatás, beleértve az API-jainkat, kaphat kérdésekkel kapcsolatos lavinákat. Az okok teljesen különbözőek lehetnek, a felhasználói hibáktól a célzott támadásokig. Időről időre DDoS támadások érnek minket IP-címek alapján. A kliensek gyakran hibáznak a scriptjeikben, mini-DDoS-t eredményezve.
Akárhogy is, szükséges a kiegészítő védelem biztosítása. Nyilvánvaló megoldás a kérések számának korlátozása az API-hoz, hogy ne pazaroljuk a processzornyi időt a kártékony kérések feldolgozására.
Az ilyen korlátozások megvalósításához rate limits-t alkalmazunk, amelyeket HAProxy alapú stick táblák segítségével valósítunk meg. A limitek beállítása meglehetősen egyszerű, és korlátozza a felhasználót az API-hoz intézett kérések számában. Az algoritmus megjegyzi a forrás IP-t, ahonnan a kérelmek érkeznek, és korlátozza a párhuzamos kérések számát egy felhasználónál. Természetesen számításba vettük az API terhelésének átlagos profilját minden szolgáltatásnál, és körülbelül 10-szer nagyobb limitet állítottunk be. Továbbra is figyelemmel kísérjük a helyzetet, és kézben tartjuk a dolgokat.
Hogyan néz ez ki a gyakorlatban? Vannak ügyfeleink, akik folyamatosan használják az API-jainkat az automatikus skálázás érdekében. Reggel körülbelül kétszáz-háromszáz virtuális gépet hoznak létre, és este közelebb eltávolítják őket. Az OpenStack keretein belül egy virtuális gép létrehozása, valamint PaaS szolgáltatásokkal együtt, legalább 1000 API-kérés, mivel a szolgáltatások közötti interakció is API-n keresztül történik.
Az ilyen feladatok áthelyezése jelentős terhelést okoz. Ezt a terhelést felmértük, összegyűjtöttük a napi csúcsokat, megemeltük őket tízszeresére, és ez lett a rate-limitünk. Figyelemmel kísérjük a helyzetet. Gyakran látunk botokat és szkenner programokat, amelyek azt próbálják kideríteni, van-e CGA-szkriptünk, amit futtatni lehet, ezeket aktívan blokkoljuk.
Hogyan lehet észrevétlenül frissíteni a kódalapot
Az elérhetőség biztosítása érdekében ugyanúgy foglalkozunk a kódkiadás folyamatainak megbízhatóságával. A kiadások során előfordulhatnak hibák, de ezek hatását a szolgáltatások elérhetőségére minimalizálni lehet.
Folyamatosan frissítjük szolgáltatásainkat, és biztosítanunk kell a kódalap frissítési folyamatát felhasználói hatások nélkül. Ezt a feladatot sikerült megoldanunk a HAProxy kezelési lehetőségeinek és a Graceful Shutdown végrehajtásának felhasználásával a szolgáltatásainkban.
Ehhez a feladathoz szükséges a terheléselosztó kezelése és a szolgáltatások "helyes" leállítása:
- A HAProxy esetében a kezelés a stats-fájl segítségével történik, amely gyakorlatilag egy socket, és a HAProxy konfigurációjában van meghatározva. Parancsokat közvetlenül a stdio-n keresztül lehet hozzá átadni. De a konfigurációk ellenőrzésének fő eszköze az ansible, így rendelkezik egy beépített modul a HAProxy kezelésére, amit aktívan használunk.
- Szolgáltatásaink és Engine-jünk nagy része támogatja a graceful shutdown technológiát: leállításkor várják a folyamatban lévő feladatok teljes befejezését, legyen az http-kérés vagy valamilyen háttérfeladat. Ugyanez történik a worker-rel is. Tud minden feladatáról, amit végez, és akkor áll le, amikor mindent sikeresen befejezett.
E két tényezőnek köszönhetően a telepítési algoritmusunk biztonságos módon a következőképpen néz ki.
- A fejlesztő új kódcsomagot állít össze (nálunk ez RPM), teszteli a fejlesztési környezetben, teszteli a staging környezetben, és ott hagyja a staging tárolóban.
- A fejlesztő feladatot ad a telepítéshez, a lehető legrészletesebb leírással az "artefaktumokról": az új csomag verziója, az új funkciók leírása és egyéb részletek a telepítésről, ha szükséges.
- A rendszeradminisztrátor megkezdi a frissítést. Elindítja az Ansible playbook-ot, ami a következőket teszi:
- Leveszi a csomagot a stage tárolóból, és frissíti a csomag verzióját a terméktárolóban.
- Összeállítja a frissítendő szolgáltatás hátterét.
- Kikapcsolja az első frissítendő szolgáltatást a HAProxy-n, és várja a folyamatainak befejezését. Az ésszerű leállításnak köszönhetően biztosak vagyunk benne, hogy az összes folyamatban lévő ügyfélkérés sikeresen befejeződik.
- Miután az API teljesen leállt, a workerök is leálltak, a HAProxy kikapcsolódott, következik a kód frissítése.
- Az Ansible elindítja a szolgáltatásokat.
- Minden szolgáltatásnál meghív egy bizonyos "kapcsolót", ami unit tesztelést végez a korábban meghatározott kulcsteszteken. Alapvető ellenőrzés történik az új kódon.
- Ha az előző lépésben nem találtak hibát, akkor a backend aktiválásra kerül.
- Átmegyünk a következő háttérszolgáltatásra.
- Minden háttérszolgáltatás frissítése után funkcionális teszteket futtatnak. Ha ezek nem elegendőek, a fejlesztő megnézi bármilyen új funkcionalitást, amit létrehozott.
Ezzel a telepítés befejeződött.
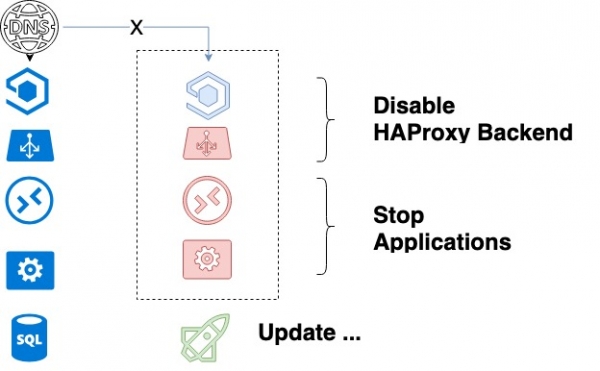
A szolgáltatás frissítési ciklusa
Ez a séma nem lenne működőképes, ha nem lenne egy szabályunk. Egyszerre támogatjuk a régi és az új verziót a live rendszerben. Előre, a szoftver fejlesztési szakaszában el van vetve, hogy még ha változások is lesznek a szolgáltatás adatbázisában, nem fognak eltörni a korábbi kódot. Ennek eredményeként fokozatosan frissül a kód alapja.
Zárás
A megbízható WEB-architektúrával kapcsolatos gondolataimat osztva, szeretném még egyszer hangsúlyozni a kulcsfontosságú pontjait:
- fizikai hibatűrés;
- hálózati hibatűrés (terheléselosztók, BGP);
- a használt és fejlesztett szoftver hibatűrése.
Kívánok mindenkinek stabil működési időt!
Forrás: habr.com
