

Kép:
Az elektronikus kereskedelemhez kapcsolódó aggregátoroldalak számára elengedhetetlen, hogy naprakész információkat tartsanak fenn. Ellenkező esetben eltűnik a legfontosabb előnyük - a legrelevánsabb adatok egy helyen való megtekintésének lehetősége.
E feladat megoldásához web-scraping technikát kell alkalmazni. Ennek lényege, hogy létrehoznak egy speciális szoftvert - crawlját, amely végigjárja a szükséges webhelyeket egy listából, begyűjti az információkat tőlük, és feltölti az aggregátoroldalra.
A probléma az, hogy a weboldalak tulajdonosai, akiktől az aggregátorok adatokat nyernek, gyakran nem szeretnék könnyen hozzáférhetővé tenni azokat. Ezt meg lehet érteni – ha az online boltban lévő ár az aggregátoroldalon magasabb lesz, mint a konkurenciáé, amely szintén ott van – a vállalkozás vásárlókat veszít.
A scraping ellenállás módszerei
Ezért gyakran az ilyen weboldalak tulajdonosai ellenállnak a scrapingnek – azaz az adataik letöltésének. Képesek azonosítani azokat a kéréseket, amelyeket a botok, crawlját küldenek IP-cím alapján. Általában ezek a szoftverek úgynevezett szerver IP-ket használnak, amelyeket könnyen ki lehet számítani és blokkolni.
Továbbá, a kérések blokkolása helyett gyakran más módszert is alkalmaznak – azonosított botok számára irreleváns információt mutatnak. Például a termékek árait túlértékelik vagy alábecsülik, vagy módosítják a leírásaikat.
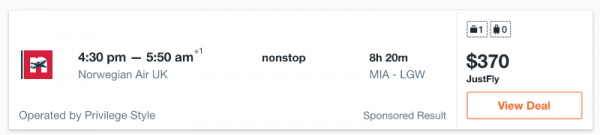
Ezen a téren gyakran emlegetett példa a repülőjegy árak. Valóban, a légitársaságok és utazási ügynökségek gyakran eltérő eredményeket mutathatnak ugyanazokhoz a járatokhoz az IP-címtől függően. Valós eset: repülőjárat keresése Miamiból Londonba ugyanarra a dátumra a kelet-európai és ázsiai IP-címmel eltérő eredményeket ad.
Kelet-európai IP-cím esetén az ár így néz ki:
Ázsiai IP-cím esetén pedig így:
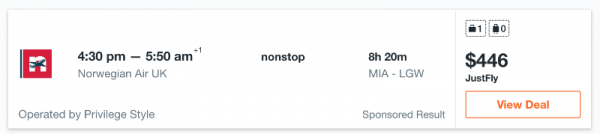
Amint látható, az azonos repülőjegy ára jelentősen eltér – a különbség 76 dollár, ami valóban sok. Az aggregátor webhelyének nem lehet rosszabb annál, ha hibás információkat közöl, mivel a felhasználók nem fogják használni. Ezen kívül, ha az aggregatoron egy termék ára van, és amikor a kereskedő webhelyére lépünk, az megváltozik – ez is negatívan befolyásolja a projekt hírnevét.
Megoldás: rezidens proxyk használata
Az adatgyűjtési problémák elkerülésére rezidens proxyk alkalmazásával van lehetőség. A szerver IP-ket a hoszting szolgáltatók biztosítják. Az IP cím egy adott szolgáltatónak való hozzátartozását viszonylag könnyű meghatározni – minden IP-nek van ASN-száma, amely tartalmazza ezt az információt.
Számos szolgáltatás létezik az ASN-számok elemzésére. Gyakran integrálják őket olyan anti-bot rendszerekkel, amelyek blokkolják a crawler-ek hozzáférését, vagy manipulálják a válaszként küldött adatokat.
Az ilyen rendszerek megkerülésére rezidens IP-címek segítenek. Ezeket az internet szolgáltatók a lakástulajdonosoknak adják ki, a kapcsolódó adatbázisokban megfelelő jelzésekkel. Léteznek olyan speciális rezidens proxy szolgáltatások, amelyek lehetővé teszik a rezidens IP-címek használatát. – éppen egy ilyen szolgáltatás.
A crawler-ek, amelyek az aggregátor oldalakról küldenek kérelmeket rezidens IP-kről, úgy tűnnek, mintha átlagos felhasználóktól érkeznének egy adott régióból. És az átlagos látogatókat senki sem blokkolja – online bolt esetén potenciális ügyfelekről van szó.
Ennek eredményeként az Infatica rotáló proxyinak használata lehetővé teszi az aggregátor webhelyek számára, hogy garantáltan pontos adatokat kapjanak, elkerüljék a blokkolásokat és a parsing nehézségeit.
További cikkek a rezidens proxyk üzleti használatáról:
Forrás: habr.com
