

Helló, Habr olvasók. Ma elindul az első csoport oktatása a tanfolyamon . Ennek kapcsán szeretnénk mesélni nektek arról, hogyan zajlott a nyílt webinárium a tanfolyamról.
A beszéltünk arról, hogy milyen kihívásokkal szembesültek az SQL-adatbázisok a felhő és a Kubernetes korában. Egyúttal megvizsgáltuk, hogyan alkalmazkodnak és mutálódnak az SQL adatbázisok e kihívások hatására.
A webinárt vezette , a Google Cloud Practice Delivery Manager az EPAM Systems-nél.
Amikor a fák kicsik voltak…
Először is emlékezzünk vissza, hogyan indult a DBMS-ek választása a múlt század végén. Igaz, ez nem lesz nehéz, mivel a DBMS-ek választása abban az időben kezdődött és végződött Oracle.
A 90-es évek végén és a 2000-es évek elején lényegében nem volt különösebb választási lehetőség, ha az ipari méretű SQL adatbázisokról beszélünk. Igen, létezett IBM DB2, Sybase és még néhány egyéb adatbázis, amelyek feltűntek és eltűntek, de összességében nem voltak olyan észlelhetők az Oracle mellett. Ennek megfelelően az akkori mérnökök képességei valamilyen módon annak az egyetlen választásnak voltak alárendelve, amely létezett.
Az Oracle DBA-nak tudnia kellett:
- telepíteni az Oracle Servert a disztribúcióból;
- beállítani az Oracle Servert:
- init.ora;
- listener.ora;
— létrehozni:
- táblázatokat;
- sémákat;
- felhasználókat;
— végrehajtani biztonsági mentést és helyreállítást;
— végrehajtani a körmonitorozást;
— küzdeni az alul optimalizált lekérdezésekkel.
Eközben az Oracle DBA-tól különösen nem követelték meg:
- hogy tudja kiválasztani az optimális DBMS-t vagy egyéb tárolási és feldolgozási technológiát;
- biztosítani a magas rendelkezésre állást és a vízszintes skálázhatóságot (ez nem mindig volt a DBA kérdése);
- jól ismerje a szakterületet, az infrastruktúrát, az alkalmazási architektúrát, az operációs rendszert;
- megvalósítani az adatok betöltését és kiürítését, az adatok migrálását különböző DBMS-ek között.
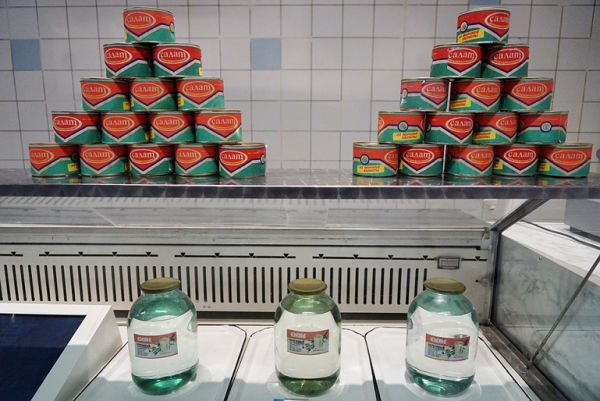
Összességében, ha abban az időszakban a választásra gondolunk, az hasonlít az 1980-as évek végének szovjet boltjának választásához:
A mi időnk
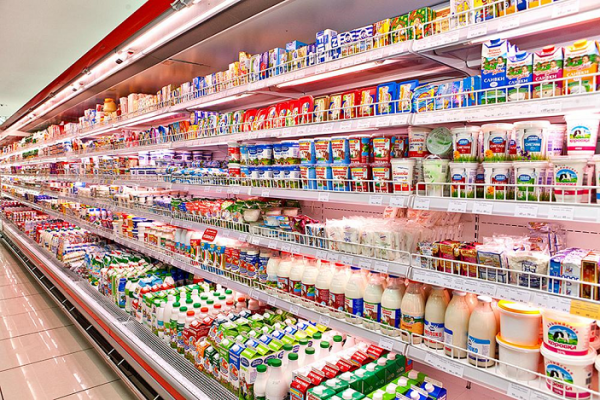
Azóta, természetesen, a fák megnőttek, a világ megváltozott, és valahogy így alakult:
Megváltozott a DBMS piac is, amit jól mutat a Gartner friss jelentése:
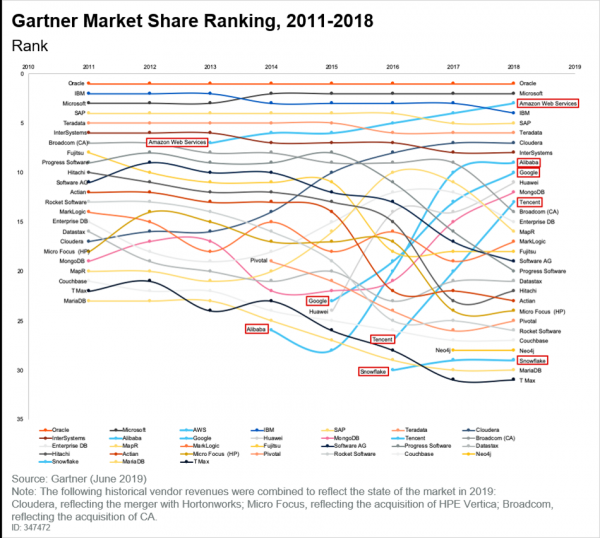
És itt nem lehet figyelmen kívül hagyni, hogy az felhők betöltötték a piaci résüket, amelyek népszerűsége nő. Ha elolvassuk ugyanazt a Gartner-jelentést, a következő következtetéseket látjuk:
- Sok megrendelő a felhőbe való áttérés útján jár.
- Az új technológiák először a felhőben jelennek meg, és nem biztos, hogy valaha is átkerülnek a hagyományos infrastruktúrába.
- A pay-as-you-go árazási modell már megszokottá vált. Mindenki csak azért szeretne fizetni, amivel valóban él, és ez már nem trend, hanem egyszerűen ténymegállapítás.
Mi újból?
Ma mindannyian a felhőben vagyunk. Azok a kérdések, amelyek felmerülnek bennünk, a választás kérdései. És a választék hatalmas, még akkor is, ha csak a helyben telepített adatbázis-kezelő rendszerek (On-premises) lehetőségeiről beszélünk. Emellett ott vannak a menedzselt szolgáltatások és a SaaS is. Tehát a választás évről évre egyre bonyolultabbá válik.
A választási kérdések mellett működnek a korlátozó tényezők:
- ár. Sok technológia továbbra is pénzbe kerül;
- készségek. Ha nyílt forráskódú szoftverről beszélünk, akkor felmerül a készségek kérdése, mivel a ingyenes szoftverek használatához elegendő kompetenciára van szükség az emberektől, akik telepítik és üzemeltetik azokat;
- funkcionalitás. Nem minden szolgáltatás, amely elérhető a felhőben és mondjuk ugyanazon Postgres alapjaira épül, rendelkezik a helyben telepített Postgreshez hasonló funkciókkal. Ez lényeges tényező, amelyet tudni és érteni kell. Ráadásul ez a tényező fontosabbá válik, mint néhány rejtett lehetőség ismerete egy adott adatbázis-kezelő rendszerről.
Mit várnak el most a DA/DE-től:
- jó megértés az adott területről és az alkalmazási architektúráról;
- az a képesség, hogy helyesen válassza ki a megfelelő adatbázis-kezelő technológiát a kitűzött feladat figyelembevételével;
- az a képesség, hogy az adott korlátok figyelembevételével optimális megoldást találjon a választott technológia végrehajtására;
- az a képesség, hogy adatokat áthelyezzen és migráljon;
- az a képesség, hogy a kiválasztott megoldásokat megvalósítsa és üzemeltesse.
Az alábbi példa a GCP alapján bemutatja, hogyan történik az egyes technológiák kiválasztása az adatok szerkezete alapján:
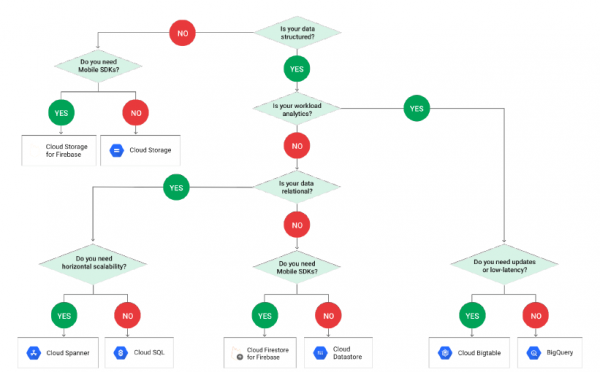
Vegye figyelembe, hogy a diagramon nincsen PostgreSQL, és ennek az az oka, hogy a Cloud SQL terminológiája mögé rejlik. Amikor belépünk a Cloud SQL-be, újra választanunk kell:Érdemes megjegyezni, hogy ez a választás nem mindig egyértelmű, ezért az alkalmazás fejlesztői gyakran az intuíciójukra támaszkodnak.
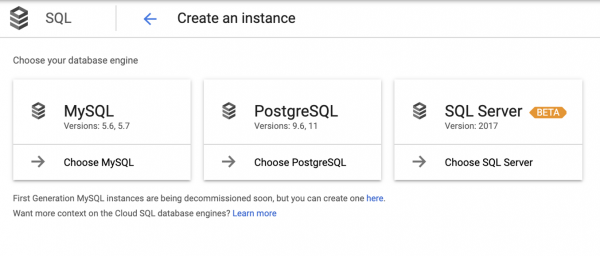
Érdemes megjegyezni, hogy ez a választás nem mindig egyértelmű, ezért az alkalmazás fejlesztői gyakran az intuíciójukra támaszkodnak.
Összesen:
- Minél messzebb haladunk, annál aktuálisabbá válik a választás kérdése. És még ha csak a GCP-t nézzük is, a kezelt szolgáltatásokban és a SaaS-ban a RDBMS említése csak a negyedik lépésnél jelenik meg (ott a Spanner is ott van). Plusz, a PostgreSQL választása csak az ötödik lépésben jelentkezik, a MySQL és az SQL Server mellett, tehát rengeteg minden van, de választani kell.
- Ne feledkezzünk meg a kísértésekkel szembeni korlátozásokról. A legtöbben a Spanner-t akarják, de az drága. Végül a tipikus kérés nagyjából így néz ki: „Kérjük, csinálják meg nekünk a Spanner-t, de a Cloud SQL áráért, hát önök profik!”
De mit kell tenni?
Anélkül, hogy a végső igazságot hirdetnénk, a következőket mondanánk:
Meg kell változtatni a tanulási megközelítést:
- nem érdemes úgy tanítani, mint ahogy a DBA-kat korábban tanították;
- egy termék ismerete már nem elég;
- és nem lehet több tucatot ismerni egy szinten.
Tudni kell nemcsak a terméket, hanem:
- az alkalmazási eseteit;
- a különböző telepítési módszereket;
- minden módszer előnyeit és hátrányait;
- hasonló és alternatív termékeket, hogy tudatos és optimális döntéseket hozhassunk, és ne mindig a megszokott termék mellett döntsünk.
Emellett képesnek kell lennünk adatok migrálására és megértsük az ETL integráció alapvető elveit.
Valós eset
Nemrégiben egy mobilalkalmazás backendjét kellett fejleszteni. Amikor elkezdtük a munkát rajta, a backend már ki volt dolgozva és készen állt a bevezetésre, a fejlesztőcsapat körülbelül két évet töltött e projekten. Az alábbi feladatokat tűzték ki:
- CI/CD kiépítése;
- az architektúra felülvizsgálata;
- az egész rendszer üzembe helyezése.
Magának az alkalmazásnak mikroszolgáltatás-alapúnak kellett lennie, a Python/Django kódot a nulláról írták meg, azonnal a GCP-re. A célközönség két régióval – az Egyesült Államokkal és az EU-val – számolt, a forgalmat a globális terheléselosztó kezeli. Minden munkaterhelés és számítási igény a Google Kubernetes Engine-n dolgozott.
Ami az adatokat illeti, három struktúra volt:
- Cloud Storage;
- Datastore;
- Cloud SQL (PostgreSQL).
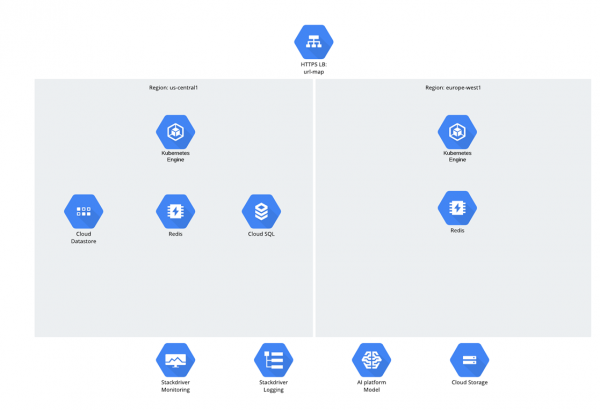
Felmerülhet a kérdés, miért választottuk a Cloud SQL-t? Őszintén szólva, az utóbbi években ez a kérdés egy kis kínos szünetet okoz – úgy tűnik, hogy az emberek elkezdtek szégyenkezni a relációs adatbázisok miatt, de ennek ellenére továbbra is aktívan használják őket ;-).
A mi esetünkben a Cloud SQL a következő okok miatt lett választva:
- Ahogy említettük, az alkalmazás Django segítségével készült, és van benne egy modell, amely az SQL-adatbázisból származó állandó adatokat Python-objektumokká alakít (Django ORM).
- Magában a keretrendszerben elegendő végső adatbázis-kezelő rendszer található:
- PostgreSQL;
- MariaDB;
- MySQL;
- Oracle;
- SQLite.
Ennek megfelelően a PostgreSQL-t intuitív módon választották ki a listából (nos, mégsem választunk Oracle-t, igaz?).
Ami hiányzott:
- az alkalmazás csak 2 régióban volt telepítve, a tervekben pedig egy 3. régió (Ázsia) szerepelt;
- az adatbázis az észak-amerikai régióban (Iowa) volt;
- az ügyfél részéről aggályok merültek fel a hozzáférési késések kapcsán Európából és Ázsiából, valamint szolgáltatási megszakadások az adatbázis leállása esetén. Mivel a Django képes párhuzamosan dolgozni több adatbázissal, és megosztani őket olvasás és írás szerint, az alkalmazásban nem volt túl sok írás (több mint 90% - olvasás). Összességében, ha lehetséges volt volna
read-replika létrehozása a fő adatbázisból Európában és Ázsiában, ez kompromisszumos megoldást jelentett volna. De mi olyan nehéz ebben?A nehézség abban rejlett, hogy az ügyfél nem akarta elhagyni a managed services és a Cloud SQL használatát. A Cloud SQL jelenlegi lehetőségei korlátozottak. A Cloud SQL támogatja a magas rendelkezésre állást (HA) és a Read Replica-t (RR), de a RR csak egy régióban elérhető. Amerikai régióban létrehozott adatbázist nem lehet read-replikává alakítani európai régióban a Cloud SQL segítségével, bár a PostgreSQL ezt nem akadályozza. A Google munkatársaival folytatott levelezés nem vezetett eredményre, és azzal végződött, hogy „tudjuk a problémát, és dolgozunk rajta, idővel megoldást találunk”.
Ha a Cloud SQL lehetőségeit pontokba szedjük, az körülbelül így nézne ki:
1. Magas rendelkezésre állás (HA):
egy régión belül;
- lemezreplikációval;
- a PostgreSQL mechanizmusait nem használják;
- automatikus és kézi kezelés — failover/failback lehetséges;
- az adatbázis átkapcsolásakor néhány percig nem elérhető.
- 2. Read Replica (RR):
hot standby;
- lemezreplikációval;
- PostgreSQL streaming replikáció.
- Emellett, ahogy az lenni szokott, a technológia kiválasztásakor mindig találkozunk valamilyen
korlátozással — az ügyfél nem akarta szaporítani az entitásokat, és IaaS-t használni, csak a GKE-n keresztül;:
- az ügyfél nem szeretné a self service PostgreSQL/MySQL telepítését.
- az ügyfél nem szeretné, ha önkiszolgáló PostgreSQL/MySQL rendszert kellene kiépíteni;
- Mellesleg a Google Spanner jól jöhetett volna, ha nem lett volna olyan drága, bár a Django ORM nem tud vele dolgozni, de egyébként egy jó dolog.
Tekintettel a helyzetre, az ügyféltől egy kérdés érkezett: »Képesek lennének valami hasonlót csinálni, ami olyan, mint a Google Spanner, de Django ORM-mel is működik?«
Megoldási lehetőség № 0
Az első, ami eszembe jutott:
- maradjunk a CloudSQL keretein belül;
- a régiók közötti beépített replikáció semmilyen formában nem lesz elérhető;
- megpróbálni csatlakoztatni egy replikát a meglévő Cloud SQL by PostgreSQL-hez;
- valahol és valahogy elindítani egy PostgreSQL példányt, de legalább a mastert ne érintsük.
Sajnos kiderült, hogy ezt nem lehet megvalósítani, mivel nincs hozzáférés a hoszthoz (az egy teljesen más projektben van) – pg_hba és így tovább, és még superuser hozzáférés sincs.
Megoldási lehetőség № 1
Néhány további gondolkodás után és az előző körülmények figyelembevételével a gondolatmenet némileg megváltozott:
- továbbra is próbálkozunk a CloudSQL keretein belül maradni, de áttérünk MySQL-re, mivel a Cloud SQL by MySQL-nek van külső mastere, amely:
— proxy külső MySQL-hez;
— MySQL példányként néz ki;
— az adatok migrációjára lett kitalálva más felhőkből vagy helyszíni megoldásokból.
Mivel a MySQL replikáció beállítása nem igényel hozzáférést a hoszthoz, elvileg minden működött, de nagyon instabil és kényelmetlen volt. Amikor tovább haladtunk, még félelmetesebb lett, mert az egész struktúrát terraformmal állítottuk fel, és hirtelen kiderült, hogy a külső master nem támogatott a terraform által. Igen, a Google-nek van CLI-je, de valamiért itt is minden másodszor működött – néha létrejött, néha nem. Valószínűleg azért, mert a CLI-t az adatok külső migrációjára fejlesztették ki, nem replikák számára.
Igazából itt vált világossá, hogy a Cloud SQL egyáltalán nem megfelelő. Ahogy mondani szokták, mindent megpróbáltunk, amit csak tudtunk.
Megoldási lehetőség № 2
Mivel nem tudtunk a Cloud SQL keretein belül maradni, próbáltuk megfogalmazni az igényeket egy kompromisszumos megoldáshoz. Az igények a következőek voltak:
- működés Kubernetesben, a Kubernetes (DCS, …) és a GCP (LB, …) erőforrásainak és lehetőségeinek maximális kihasználása;
- nincs szükségtelen tehertétel a felhőben, mint például HA proxy;
- lehetőség HA PostgreSQL vagy MySQL futtatására a fő régióban; a többi régióban – a fő régió RR-jéből származó HA másolata a megbízhatóság érdekében;
- multi master (nem igazán akartunk kapcsolódni hozzá, de ez nem volt annyira fontos)
.
E követelmények eredményeként végre felbukkant a láthatáron pmegfelelő DBMS és kötés opciók:
- MySQL Galera;
- CockroachDB;
- PostgreSQL eszközök
:
— pgpool-II;
— Patroni.
MySQL Galera
A MySQL Galera technológiát a Codership cég fejlesztette ki, és az InnoDB pluginja. Jellemzők:
- több mester;
- szinkron replikáció;
- bármelyik csomópontból történő olvasás;
- bármelyik csomópontra történő írás;
- beépített HA mechanizmus;
- van Helm chart a Bitnami-tól.
CockroachDB
A leírása alapján ez egy teljesen lenyűgöző dolog, amely egy Go nyelven íródott open source projekt. A fő résztvevő a Cockroach Labs (amely a Google korábbi dolgozóiból alakult). Ez a relációs DBMS eredetileg elosztott (doz horizontális skálázás 'doz dobozban') és hibamentesnek lett megalkotva. A szerzői célját azzal határozták meg, hogy 'a SQL funkciógazdagságát ötvözzék a NoSQL megoldásokra jellemző horizontális elérhetőséggel'.
A kellemes bónusz — támogatja a PostgreSQL kapcsolódási protokollt.
Pgpool
Ez egy PostgreSQL feletti réteg, valójában egy új entitás, amely kezeli az összes kapcsolatot. Van saját terheléselősítője és elemzője, BSD licenc alapján licencelt. Széles lehetőségeket biztosít, de kicsit rémisztőnek tűnik, mivel az új entitás jellege forrást jelenthet némi extra kalandra.
Patroni
Ez az utolsó, amire a figyelmem vetődött, és ahogyan kiderült, nem hiába. A Patroni egy open source eszköz, amely tulajdonképpen egy Python demon, amely automatikusan kezeli a PostgreSQL klasztereket különböző replikációs típusokkal és automatikus szerepkör átváltással. Nagyon érdekes dolognak bizonyult, mivel jól integrálódik a kubernetes-szel és nem hoz létre új entitásokat.
Mi lett a végső választás
A választás nem volt egyszerű:
- CockroachDB — tűz, de ijesztő;
- MySQL Galera — szintén nem rossz, sok helyen használják, de MySQL;
- Pgpool — sok felesleges entitás, nem túl jó integráció a felhővel és K8s-szel;
- Patroni — kiváló integráció a K8s-szel, nincs felesleges entitás, jól integrálódik a GCP LB-vel.
Ennek megfelelően a választás a Patronira esett.
Következtetések
Itt az ideje összefoglalni a rövid következtetéseket. Igen, az IT-infrastruktúra világa jelentősen megváltozott, és ez csak a kezdet. És míg korábban a felhők csak egy másik típusú infrastruktúrák voltak, most mindez megváltozott. Ráadásul az újítások a felhőkben folyamatosan jelennek meg, és valószínűleg csak a felhőkben fognak megjelenni, és csak később, startupok révén, kerülnek át On-premises.
Ami az SQL-t illeti, az SQL továbbra is fontos marad. Ez azt jelenti, hogy a PostgreSQL-t és a MySQL-t ismerni és velük dolgozni kell, de talán még fontosabb, hogy tudjuk őket helyesen alkalmazni.
Forrás: habr.com
