

Miután megvolt a karácsonyi Olivier saláta, nem volt mit tennem, ezért úgy döntöttem, letöltöm az összes cikket a Habrhabról (és a kapcsolódó platformokról) a számítógépemre, és kutatni fogok.
Számos érdekes történet született. Az első az a cikkek formátumának és témáinak fejlődése a webhely 12 éves fennállása alatt. Például elég figyelemre méltó egyes témák dinamikája. Folytatás a hajtás alatt.
A lekérdezés folyamata
A Habr fejlődésének megértéséhez végig kellett nézni az összes cikket és kiemelni belőlük a metaadatokat (például a dátumokat). A böngészés könnyen ment, mert az összes cikk linkje a következő formátumban van: "habrahabr.ru/post/337722/", és a számok szigorúan sorrendben vannak. Tudva, hogy az utolsó bejegyzés száma kicsit kevesebb mint 350 ezer, egyszerűen végigmentem az összes lehetséges dokumentum id-jén egy ciklussal (a kód Pythonban):
import numpy as np
from multiprocessing import Pool
with Pool(100) as p:
    docs = p.map(download_document, np.arange(350000))
Funkció download_document megpróbálja letölteni a megfelelő id-vel rendelkező oldalt és megpróbálja kinyerni a tartalmi információt a html struktúrából.
import requests
from bs4 import BeautifulSoup

def download_document(pid):
    """ Letölt és feldolgoz egy Habr dokumentumot és annak hozzászólásait """
    # dokumentum letöltése
    r = requests.get('https://habrahabr.ru/post/' +str(pid) + '/')
    # dokumentum elemzése
    soup = BeautifulSoup(r.text, 'html5lib') # html.parser helyett
    doc = {}
    doc['id'] = pid
    if not soup.find("span", {"class": "post__title-text"}):
        # ez előfordul, ha a cikk nem létezett vagy törölték
        doc['status'] = 'title_not_found'
    else:
        doc['status'] = 'ok'
        doc['title'] = soup.find("span", {"class": "post__title-text"}).text
        doc['text'] = soup.find("div", {"class": "post__text"}).text
        doc['time'] = soup.find("span", {"class": "post__time"}).text
        # egyéb mezők létrehozása: témák, címkék, megtekintések, hozzászólások, szavazatok, stb.
        # ...
    # az eredmény mentése egy külön fájlba
    fname = r'files/' + str(pid) + '.pkl'
    with open(fname, 'wb') as f:
        pickle.dump(doc, f)
A lekérdezés folyamata során felfedeztem néhány új dolgot.
Először is, azt mondják, hogy haszontalan több folyamatot indítani, mint amennyi mag van a processzorban. De az én esetemben kiderült, hogy a korlátozó erőforrás nem a processzor, hanem a hálózat, és 100 folyamat gyorsabban működik, mint 4 vagy például 20.
Másodszor, egyes bejegyzésekben különleges karakterkombinációk találkoztak — például az ilyen eufemizmusok, mint a "%&#@". Kiderült, hogy html.parser, amit először használtam, reagál a kombóra &# érzékenyen úgy, hogy a html entitás kezdete. Már majdnem fekete mágiát akartam végrehajtani, de a fórumon azt tanácsolták, hogy egyszerűen váltsam meg a lekérdezőt.
Harmadszor, sikerült letöltenem az összes publikációt, kivéve hármat. A 65927, 162075 és 275987 sorszámú dokumentumokat azonnal törölte a víruskeresőm. Ezek a cikkek a következőkről szólnak: a JavaScript lánc, amely rosszindulatú PDF-et tölt be, SMS-zsaroló böngészőbővítmények, és a CrashSafari.com webhely, ami visszaindítja az iPhone-okat. Még egy cikket a víruskereső később észlelt, miközben a rendszert vizsgáltam: a 338586 poszt a kisállatkereskedés webhelyén található szkriptekről, amelyek a felhasználó processzorát használják a kriptovaluta bányászathoz. Tehát a víruskereső munkája teljesen megfelelőnek tekinthető.
"Élő" cikkekből mindössze a potenciális maximum fele – 166307 darab – maradt. A többire a Habr a következő lehetőségeket adja: "az oldal elavult, törölték, vagy nem létezett". Hát, előfordul.
A cikkek letöltése után technikai munka következett: például a közzétételi dátumokat át kellett konvertálni a "’21 december 2006 10:47" formátumból a normál datetime, és a "12,8k" megtekintést 12800-ra. Ezen a ponton néhány további kellemetlenség is felmerült. A legviccesebb az szavazatok számával és az adatok típusával kapcsolatos: néhány régi bejegyzésnél egész szám túlcsordulás történt, és 65535 szavazatot kaptak.
Ennek eredményeként a cikkek szövege (kép nélkül) 1,5 gigabyte-ot foglalt el, a hozzászólások metaadatokkal együtt még 3-at, és körülbelül száz megabyte-ot a cikkek metaadatai. Ezt teljes egészében a RAM-ban tudtam tartani, ami kellemes meglepetés volt számomra.
A cikkek elemzését nem magukkal a szövegekkel kezdtem, hanem a metaadatokkal: dátumok, címkék, hubok, megtekintések és "lájkok". Kiderült, hogy ez is sokat elárulhat.
A Habr fejlődésének trendjei
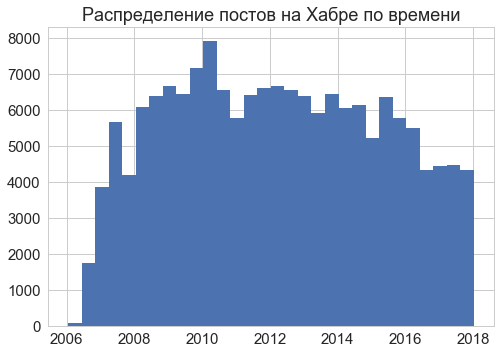
A weboldalon 2006 óta publikálnak cikkeket; a legintenzívebben 2008-2016 között.
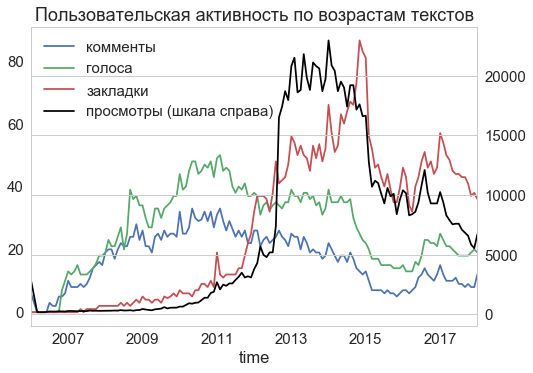
Azt nem könnyű megítélni, mennyire aktívan olvasták ezeket a cikkeket különböző időpontokban. A 2012-es és fiatalabb szövegeket aktívan kommentelték és értékelték, de az újabb szövegeknek több megtekintése és könyvjelzője volt. Ezek a mutatók egyszerre viszont (duplájára csökkentek) csak 2015-ben viselkedtek egyformán. Lehetséges, hogy a gazdasági és politikai válsághelyzetben az olvasók figyelme az informatikai blogokról a fájdalmasabb kérdésekre irányult.
A cikkek mellett további 6 millió kommentárt is letöltöttem. Az összesen 240 ezer kommentár azonban letiltásra került ("ufó érkezett és itt közzétette ezt az üzenetet"). A kommentárok hasznos tulajdonsága, hogy időpontot is megjelölnek. A kommentek idejét tanulmányozva nagyjából megérthetjük, mikor olvassák a cikkeket.
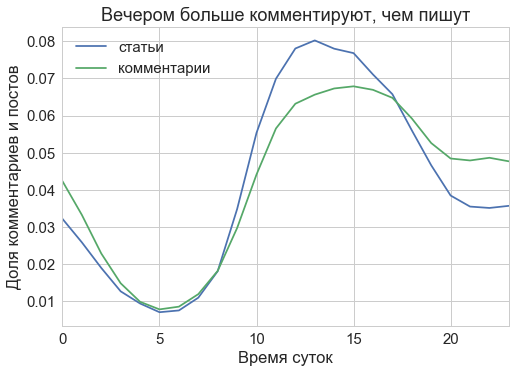
Kiderült, hogy a cikkek nagy részét és a kommentárokat valamikor 10 és 20 óra között írják, tehát egy tipikus moszkvai munkanapon. Ez jelentheti azt is, hogy a Habr-t szakmai célokra olvassák, és hogy ez egy jó mód a munkán való halogatásra. Érdekes, hogy ez a napi időeloszlás a Habr megalapítása óta stabilan fennáll.
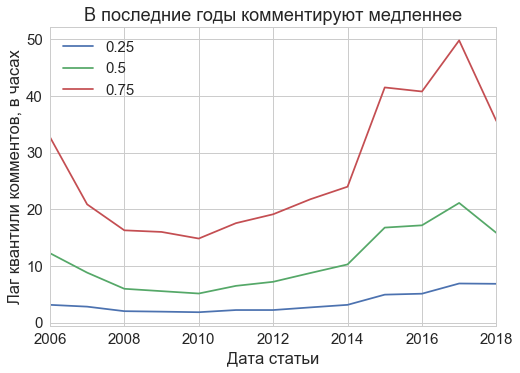
Azonban a kommenthez rendelt időbélyeg legnagyobb előnye nem a napszak, hanem a cikk "aktív életének" időtartama. Számításaim szerint, az egy cikk publikálását követő idő, amíg komment érkezik, a medián komment (zöld vonal) körülbelül 20 órával érkezik, tehát az első napon az összes komment több mint felét közlik. Két nap alatt az összes komment 75%-át hagyják ott. Ez korábban még gyorsabb volt – például 2010-ben a kommentek fele már az első 6 órában megérkezett.
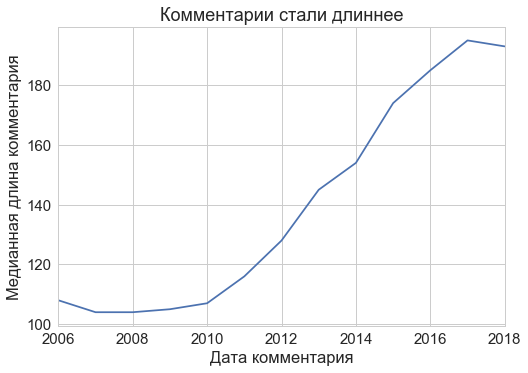
Meghökkentett, hogy a kommentek hossza megnőtt: a Habr létezése alatt a kommentek átlagos karaktereinek száma majdnem megduplázódott!
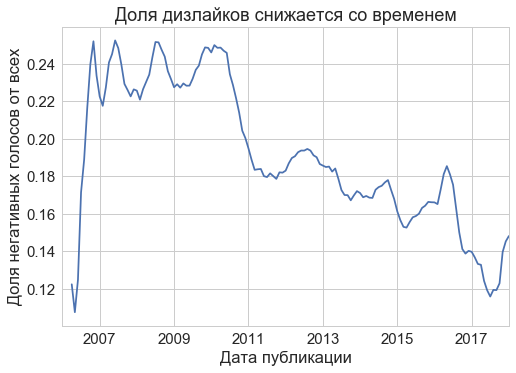
Egyszerűbb visszajelzés, mint a kommentek – ezek a szavazatok. A Habr-on más forrásokkal ellentétben nemcsak pozitív, hanem negatív szavazatokat is adhatunk. Ez utóbbi lehetőséget azonban a olvasók nem használják olyan gyakran: a jelenlegi diszlájk arány körülbelül 15% az összes leadott szavazatból. Korábban nagyobb volt, de az idő múlásával az olvasók kedvesebbé váltak.
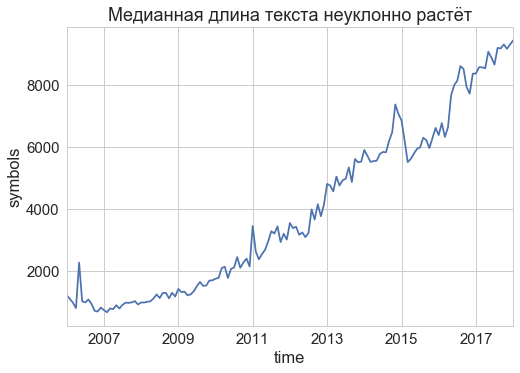
Az idő múlásával a szövegek is változtak. Például a szövegek tipikus hossza folyamatosan növekszik a weboldal indulásától kezdve, a válságok ellenére is. Egy évtized alatt a szövegek majdnem tízszer hosszabbá váltak!
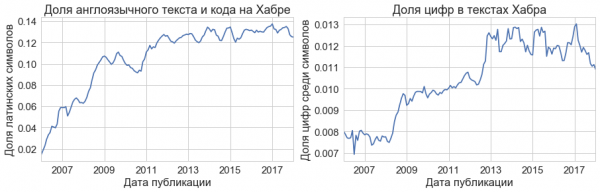
A szövegek stílusa (első közelítésben) szintén változott. A Habr első éveiben például megnőtt a kód és a számok aránya a szövegekben:
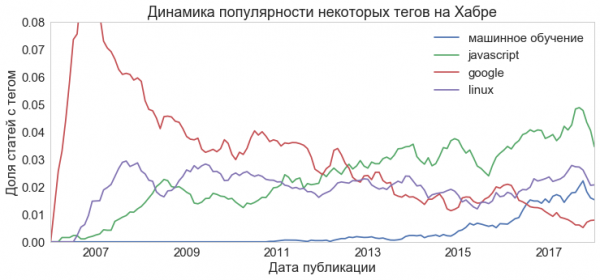
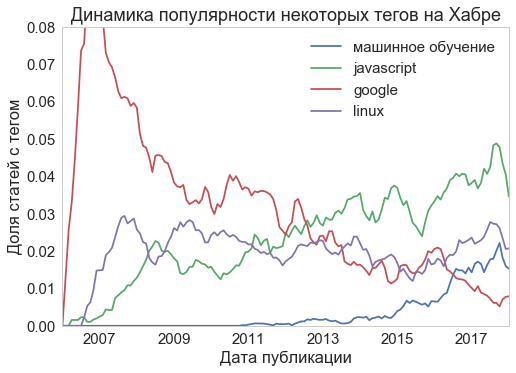
Miután megértettem a weboldal általános dinamikáját, úgy döntöttem, hogy mérni fogom, hogyan változott különböző témák népszerűsége. A témákat automatikusan ki lehet emelni a szövegekből, de kezdetnek érdemes kihasználni a már készen megírt címkéket, amelyeket a cikkek szerzői adtak meg. Négy tipikus trendet ábrázoltam a grafikonon. A "Google" téma eredetileg dominált (valószínűleg főként az SEO-optimalizálás miatt), de évről évre veszített a súlyából. A Javascript népszerű téma volt és fokozatosan továbbra is népszerű, ám a gépi tanulás csak az utolsó években kezdett gyorsan növekedni. A Linux viszont évtizedek óta egyaránt aktuális maradt.
Természetesen érdekelt, mely témák vonzzák a legtöbb olvasói aktivitást. Megszámoltam a médiai nézettséget, szavazatokat és kommenteket minden témában. Íme, amit kaptam:
- A legnépszerűbb témák: arduino, webdesign, webfejlesztés, hírlevél, linkek, css, html, html5, nginx, algoritmusok.
- A leg"likeolhatóbb" témák: vk, humor, jquery, opera, c, html, webfejlesztés, html5, css, webdesign.
- A legbeszélgetettebb témák: opera, skype, szabadúszás, vk, ubuntu, munka, nokia, nginx, arduino, firefox.
Mellesleg, mivel összehasonlítom a témákat, elkészíthetem a rangsorukat a gyakoriság alapján (és összehasonlíthatom az eredményeket a ).
- A Hub minden éve alatt a legnépszerűbb címkék (csökkenő sorrendben): google, android, javascript, microsoft, linux, php, apple, java, python, programozás, startupok, fejlesztés, ios, startup, közösségi média.
- 2017-ben a legnépszerűbbek voltak: javascript, python, java, android, fejlesztés, linux, c++, programozás, php, c#, ios, gépi tanulás, informatikai biztonság, microsoft, react.
Ezeknek a ranglistáknak az összehasonlításakor figyelembe vehetjük például a Python győzelmét és a php kihalását, vagy a startup témák "naplementéjét" és a gépi tanulás fellendülését.
Nem minden címke a Habr-on rendelkezik ilyen egyértelmű tematikus árnyalattal. Íme például egy tucat címke, amelyek csupán egyszer fordultak elő, de számomra szórakoztatónak tűntek. Tehát: "ötlet a fejlődés motorja", "indítás lemezképről", "Iowa állam", "drámaírás", "szuperaljás", "gőzgép", "mit csináljunk szombaton", "nekem róka a húsdarálóban", "és úgy alakult, mint mindig", "nem sikerült vicces címkéket kitalálni". A cikkek tematikájának meghatározásához a címkék nem elegendőek — tematikai modellezést kell végezni a cikkek szövegén.
Részletesebb elemzés a cikkek tartalmáról a következő posztban lesz. Először is, egy modellt akarok építeni, amely prognosztizálja a cikk megtekintéseinek számát a tartalmának függvényében. Másodszor, szeretném megtanítani a neurális hálót szövegeket generálni, olyan stílusban, mint a Habr szerzői. Szóval iratkozzatok fel 🙂
P.S. Íme a cenzúrázott változat .
Forrás: habr.com
