

Azt mondják, hogy az életben mindent meg kell próbálni, legalább egyszer. Ha megszoktad a relációs adatbázis-kezelő rendszerek használatát, akkor érdemes gyakorlatban megismerkedni a NoSQL-lal, már csak az általános fejlődés érdekében is. Jelenleg, mivel ez a technológia gyors fejlődésen megy keresztül, sok ellentmondó vélemény és heves vita zajlik róla, ami különösen fokozza az érdeklődést.
Ha mélyebben belemerülünk a viták lényegébe, láthatjuk, hogy ezek a helytelen megközelítésből adódnak. Azok, akik a NoSQL adatbázisokat pontosan ott használják, ahol szükség van rájuk, elégedettek és élvezik ennek a megoldásnak az előnyeit. A kísérletezők, akik ezt a technológiát paneleciumként használják oda, ahol az nem alkalmazható, csalódással találkoznak, elveszítve a relációs adatbázisok erősségeit anélkül, hogy jelentős előnyökre tennének szert.
Beszámolok a Cassandra adatbázis-kezelő rendszeren alapuló megoldásunk bevezetésének tapasztalatairól: mivel szembesültünk, hogyan oldottuk meg a nehéz helyzeteket, sikerült-e hasznot húzni a NoSQL használatából, és hol kellett további erőfeszítéseket/befektetéseket eszközölnünk.
Az alapfeladat egy olyan rendszer kiépítése volt, amely rögzíti a hívásokat egy adott tárolóban.
A rendszer működési elve a következő. Bemenetként fájlok érkeznek egy meghatározott struktúrával, amely a hívás struktúráját írja le. Ezután az alkalmazás biztosítja, hogy ez a struktúra a megfelelő oszlopokba kerüljön mentésre. A mentett hívásokat ezután a forgalomfogyasztás megjelenítésére használják az előfizetők számára (díjak, hívások, egyenleg történelem).
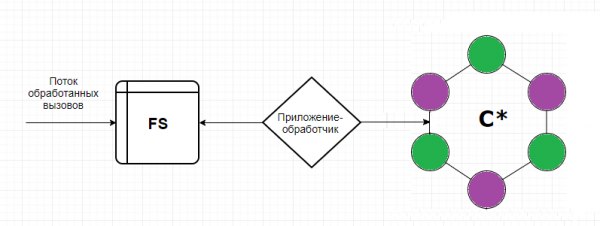
A Cassandra választásának oka világos – mint a géppuska, gyorsan ír, könnyen méretezhető és hibabiztos.
Tehát nézzük, mit adott nekünk a tapasztalat
Igen, egy kiesett csomópont nem tragédia. Ez a Cassandra hibabiztosságának lényege. De a csomópont lehet aktív, miközben a teljesítménye csökkenhet.Mint kiderült, ez azonnal visszatükröződik az egész klaszter teljesítményében.
A Cassandra nem nyújt védelmet ott, ahol az Oracle a megszorításaival segített.Ha a fejlesztő nem értette ezt meg előre, akkor a Cassandra számára beérkező duplikátum épp úgy elfogadható, mint az eredeti. Ha megérkezett, akkor behelyezzük.
A „do-it-yourself” Cassandra nem tetszett a biztonsági szakembereknek: nincsenek naplózási lehetőségek a felhasználói műveletekről, a jogok elhatárolása sem.A hívásokkal kapcsolatos információk személyes adatoknak minősülnek, ami azt jelenti, hogy minden ilyen adat lekérését/megváltoztatását naplózni kell, lehetőséggel a további auditálásra. Továbbá, fel kell ismerni a szükségességet, hogy különböző szinteken kell elkülöníteni a jogokat a különböző felhasználók számára. Egy egyszerű üzemeltetési mérnök és egy szuperadmin, aki szabadon törölheti az összes keyspace-t – ezek különböző szerepek, farklı felelősség, tudás. Ilyen jogelhatárolás nélkül az adatok értéke és integritása gyorsan kérdésessé válik, még az ANY konzisztencia szint mellett is.
Nem vettük figyelembe, hogy a hívások esetében komoly elemzésre, valamint időszakos mintavételekre van szükség különböző feltételek alapján. Mivel a kiválasztott feljegyzéseket később törölni és felülírni kell (a feladat keretein belül folyamatosan kell frissítenünk az adatokat, ha kezdetben helytelenül érkeztek hozzánk az adatok), a Cassandra itt nem a barátunk. A Cassandra olyan, mint egy malom – kényelmes beletenni, de belőle számítani nem lehet.
Szembesültünk az adatok tesztkörnyezetbe való átvitelének problémájával. (5 nod teszteléskor a 20 ellenében a produkcióban). Dumpot ilyen esetben nem lehet használni.
Az alkalmazás adatainak sémájának frissítésének problémája, amely a Cassandrába ír. A visszaállítás rengeteg sírkövet generál, ami kiszámíthatatlan módon csökkentheti a teljesítményt.A Cassandra optimalizálva van a írásokra, és mielőtt ír, nem gondol túl sokat. Minden létező adattal kapcsolatos művelet nála is írás. Tehát, ha törölünk felesleget, akkor csak még több írást generálunk, és csak egy részük lesz sírkövekkel megjelölve.
Időkorlátok az adatbeillesztés során. A Cassandra az írások terén kiváló, de időnként a beérkező adatfolyam jelentősen meg tudja zavarni.Ez akkor történik, amikor az alkalmazás elkezdi körbejárni azokat a feljegyzéseket, amelyeket valamilyen okból nem lehet beilleszteni. És szükségünk lesz egy igazi DBA-ra, aki figyelemmel kíséri a gc.log-ot, a system és debug naplókat a lassú lekérdezések szempontjából, a compaction pending metrikákat.
Több adatközpont a klaszterben. Hol olvassunk és hova írjunk?
Lehetséges az olvasást és írást szétválasztani? Ha igen, akkor a közelben lévő DC-nek írásra vagy olvasásra kell lennie? És nem jöhet létre nálunk valós split brain, ha rosszul választjuk meg a konzisztencia szintjét? Sok a kérdés, számos felfedezetlen beállítás és lehetőség, amelyet olyan szívesen kipróbálnánk.
Hogyan oldottuk meg
Annak érdekében, hogy a node ne teljesítménycsökkenést szenvedjen, letiltottuk a SWAP-ot.. Most, ha memóriahiány lép fel, a node-nek le kell állnia, nem pedig nagy gc szüneteket kell létrehoznia.
Tehát már nem bízhatunk a logikában az adatbázisban. Az alkalmazás fejlesztői újra képzik magukat, és kezdik aktívan biztosítani a saját kódjukat. Tökéletes, világos szétválasztás az adatok tárolása és feldolgozása között.
Támogatást vásároltunk a DataStax-tól. A dobozos Cassandra fejlesztése már befejeződött (az utolsó commit 2018 februárjában történt). Ugyanakkor a Datastax nagyszerű szolgáltatást és számos módosított megoldást kínál, amelyek alkalmazkodnak a meglévő informatikai rendszerekhez.
Még azt is meg szeretném jegyezni, hogy a Cassandra nem igazán kényelmes a lekérdezésekhez. Nyilvánvaló, hogy a CQL óriási lépés a felhasználók felé (a Trift-hez képest). De ha vannak osztályok, amelyek hozzászoktak a kényelmes joinokhoz, a szabad szűréshez bármilyen mezőn, és a lekérdezés optimalizálásához, és ezek az osztályok azon dolgoznak, hogy kezeljék a panaszokat és a hibákat, akkor a Cassandra alapú megoldás számukra ellenséges és ostobának tűnik. Kezdtük elgondolkodni, hogyan készíthetnek társaink lekérdezéseket.
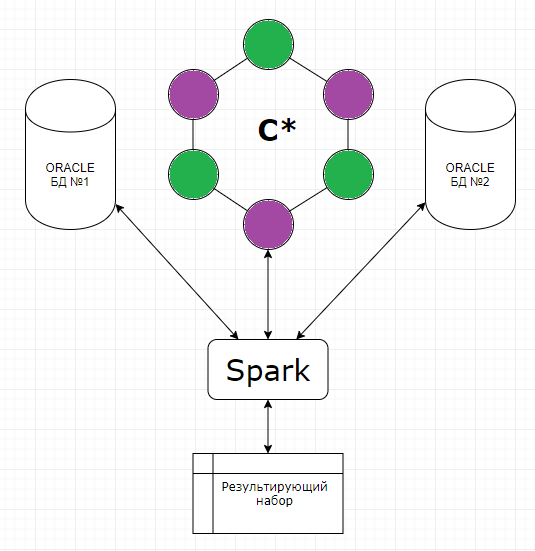
Két lehetőséget vizsgáltunk. Az első lehetőség, hogy a hívásokat nemcsak a C*-ben, hanem az archív Oracle adatbázisban is rögzítjük. Csak ellentétben a C*-vel, ebben az adatbázisban a hívások csak a aktuális hónapra vonatkoznak (a hívások tárolási mélysége elegendő a repacifikálási esetekhez). Itt azonnal feltűnt egy következő probléma: ha szinkron módon írunk, akkor elveszítjük az összes C*-hez kapcsolódó előnyt a gyors beszúrás miatt, ha aszinkron, akkor nincs garancia arra, hogy minden szükséges hívás egyáltalán bekerül az Oracle-ba. Egy előny viszont volt, ami jelentős: a megszokott PL/SQL Developer marad a rendszer használatának, azaz gyakorlatilag megvalósíthatjuk a "Fasád" mintát. Alternatív lehetőség. Kialakítunk egy mechanizmust, ami a hívásokat exportálja a C*-ből, adatokat húz a megfelelő Oracle táblákból, csatlakoztatja a kapott kiválasztásokat és megadja az eredményt, amit aztán valahogy felhasználunk (visszagördítünk, újra ismétlünk, elemezünk, csodálkozunk). Hátrányok: a folyamat viszonylag soklépcsős, ráadásul hiányzik egy interfész az üzemeltetési munkatársak számára.
A végén mégis a második lehetőség mellett döntöttünk. Az eltérő bankokból származó kiválasztásokhoz Apache Sparkot használtunk. A mechanizmus lényege egy Java-kódra redukálódott, amely a megadott kulcsok (előfizető, a hívás időpontja – az alrész kulcsai) alapján adatokat vonszol a C*-ből, valamint a dúsításhoz szükséges adatokat bármely más adatbázisból. Ezt követően csatlakoztatja őket a saját memóriájában, és az eredményt a végső táblába adja ki. A Sparknál elkészítettük a webes felületet, ami teljesen használható lett az üzemeltetés szempontjából.
Az adatok frissítésével kapcsolatos feladat megoldása során a prom-teszt több megoldást is figyelembe vett. Mind a Sstloader átkonvertálás, mind a teszt zónára két részre bontott klaszter alternatívája szóba került, amelyek felváltva kapcsolódnak a prom klaszterhez, így tápellátást nyújtanak. A teszt frissítésekor tervezett volt, hogy felcseréljük őket: az a rész, amelyik a tesztben működött, törlésre került, és bevezetésre került a promba, míg a másik külön dolgozik az adatokkal. Azonban újragondolva a helyzetet ésszerűbben értékeltük a migrálandó adatokat, és rájöttünk, hogy maguk a hívások – egy következetlen entitás a tesztekhez, amely szükség esetén gyorsan generálható, és a prom adathalmaza önállóan nem értékes a tesztre való átvitelhez. Van néhány összegyűjtő objektum, amelyet érdemes átkonvertálni, de ez mindössze néhány tábla, amelyek nem túl nehezek. Tehát számunkra mint megoldás újra a Spark segített, amelynek segítségével írtunk és aktívan használtunk egy adatátviteli szkriptet a prom és a teszt táblái között.
Jelenlegi telepítési politikánk lehetővé teszi számunkra a visszagombolás nélküli munkát. A prom előtt kötelező tesztelni, ahol a hiba nem olyan drága. Sikertelenség esetén mindig törölhetjük a namespace-t és újra telepíthetjük az egész sémát az elejéről.
A Cassandra folyamatos elérhetőségének biztosításához DBA szükséges, és nem csak ő. Mindenkinek, aki az alkalmazással dolgozik, meg kell értenie, hogy hol és hogyan ellenőrizheti az aktuális helyzetet, valamint hogyan diagnosztizálhatja a problémákat időben. Ehhez aktívan használjuk a DataStax OpsCentert (munkaterhelések adminisztrációja és monitorozása), a Cassandra Driver rendszeres teljesítménymutatóit (írási timeoutok száma a C*-ben, olvasási timeoutok száma a C*-ből, maximális késleltetés stb.), figyeljük az alkalmazás működését, amely a Cassandrát használja.
Amikor a korábbi kérdésen gondolkodtunk, rájöttünk, hol lehet a legfőbb kockázat. Ez a megjelenítési formák, amelyek adatokkal látják el azokat a független lekérdezéseket a tárolóra. Így meglehetősen inkonzisztens információkat kaphatunk. De ez a probléma akkor is releváns lenne, ha csak egy adatközponttal dolgoznánk. Tehát a legértelmesebb itt természetesen egy külső alkalmazásbeli batch adatlekérdező funkció létrehozása, amely biztosítja az adatok beszerzését egy egységes időszakban. Ami a teljesítmény szempontjából az olvasás és írás szétválasztását illeti, itt egy kockázat megállított minket, miszerint a kapcsolat esetleges elvesztése esetén a DC-k között két teljesen inkonzisztens klasztert kaphatunk.
Ennek eredményeként jelenleg az EACH_QUORUM írási konzisztencia szintet és a LOCAL_QUORUM olvasási szintet választottuk.
Rövid benyomások és következtetések
Annak érdekében, hogy értékeljük a kapott megoldást az operatív támogatás és a jövőbeli fejlődés szempontjából, úgy döntöttünk, hogy megfontoljuk, hol lehet még alkalmazni egy ilyen fejlesztést.
Ha hirtelen kellene mondani, akkor az adatok értékelése az olyan programok számára, mint a "Fizess, amikor kényelmes" (információt töltünk a C*-ba, számítás a Spark scriptek alapján), a panaszok nyilvántartása irányonkénti aggregálással, valamint a szerepek tárolása és a jogosultságok számítása a szerepmátrix szerint.
Ahogy látjuk, a repertoár széles és sokféle. És ha választani kell a NoSQL támogatói/ellenzői között, akkor mi a támogatókhoz csatlakozunk, mivel megkaptuk a saját előnyeinket, pontosan ott, ahol vártuk.
Még a Cassandra dobozból való változata is lehetővé teszi a vízszintes skálázást valós időben, teljesen fájdalommentesen megoldva az adatok növelésének kérdését a rendszerben. Sikerült egy külön keretbe kiemelni egy nagyon magas terhelésű aggregálási mechanizmust a hívások számára, valamint szétválasztani az alkalmazás sémáját és logikáját, megszabadulva a személyre szabott munkák és objektumok írásának hibás gyakorlatától az adatbázisban. Lehetőséget kaptunk arra, hogy válasszunk és beállítsunk, hogy mely DC-ken végezzük a számítást, és melyeken az adatok írását, biztosítva magunkat a különböző csomópontok, valamint az egész DC-esések esetén.
Új projektekhez alkalmazva az architektúránkat, lévén már van némi tapasztalatunk, szeretnénk azonnal figyelembe venni a fent említett árnyalatokat, és elkerülni bizonyos hibákat, hogy simábbá tegyük azokat a nehézségeket, amelyeket kezdetben nem tudtunk elkerülni.
Például, időben követni a Cassandra legfrissebb frissítéseit, mert sok olyan probléma, amit kaptunk, már ismeretes volt és javították őket.
Ne ültessük a DB-t és a Spark-ot ugyanazokra a node-okra (vagy szigorúan külön válasszuk meg a felhasználható erőforrások mennyisége szerint), mivel a Spark több memóriát is felhasználhat, mint amennyi megengedett, és gyorsan elérhetjük a problémát a listánk első helyén.
Fejlesszük a monitorozást és az üzemeltetési kompetenciát már a projekt tesztelési fázisában. Kevesebb potenciális felhasználónkat számítsuk be kezdetben a lehető legjobban, mert ennek végeredménye a DB szerkezetén fog múlni.
Többször is vizsgáljuk meg a létrejött séma optimalizálásának lehetőségeit. Ki kell emelni, hogy mely mezőket lehet sorosítani. Meg kell értenünk, hogy milyen további táblákat kell létrehoznunk, hogy a lehető legpontosabban és optimálisan figyelembe vegyük, majd a kérésre megadjuk a szükséges információt (például figyelembe véve, hogy ugyanazokat az adatokat különböző táblákban tárolhatjuk, különböző kritériumok alapján, jelentősen csökkenthetjük a processzoridőt a lekérdezések során).
Nem rossz azonnal tervezzünk TTL-t és a régi adatok törlését.
Adatok kiadásakor a Cassandrától az alkalmazás logikájának FETCH elv szerint kell működnie, hogy ne minden sort töltsünk be egyszerre a memóriába, hanem részletekben válasszunk ki.
Ideális lenne a projekt átültetése előtt az ismertetett megoldásba ellenőrizni a rendszer megbízhatóságát, sorozatos stresszteszteket végezve, például adatvesztés egy adatközpontban, a megsérült adatok helyreállítása egy adott időszakban, hálózati problémák az adatközpontok között. Az ilyen tesztek nemcsak azt fogják lehetővé tenni, hogy értékeljük az ajánlott architektúra előnyeit és hátrányait, hanem jó bemelegítő gyakorlatot is adnak az azt végző mérnököknek, és az így megszerzett készség messze nem lesz felesleges, ha a rendszerek hibái megismétlődnek a gyakorlatban.
Ha kritikus információval dolgozunk (például a számlázáshoz szükséges adatok, a felhasználói tartozások kiszámítása), érdemes figyelmet fordítani olyan eszközökre is, amelyek csökkenthetik az adatbázis-kezelő rendszer sajátosságaiból fakadó kockázatokat. Például használhatjuk a nodesync (Datastax) segédprogramot, ha optimalizáljuk a használati stratégiánkat, hogy a konzisztencia érdekében ne generáljunk felesleges terhelést a Cassandrán és csak bizonyos táblákhoz használjuk egy adott időszakban.
Mi a helyzet hat hónap használat után a Cassandraval? Összességében nincs megoldatlan probléma. Komoly balesetek és adatvesztés sem történt. Igen, voltak olyan problémák, amelyek eddig nem jelentkeztek, és ezeket kompenzálni kellett, de végül ez nem befolyásolta jelentősen az architekturális döntésünket. Ha nyitott vagy új dolgok kipróbálására, és nem szeretnél csalódni, készülj fel arra, hogy ingyen semmi sincs. Sokat kell majd tanulmányoznod, belemerülnöd a dokumentációba, és több saját hibába ütköznöd, mint a régi örökölt megoldásban, és semmilyen elmélet nem árulja el előre, hogy pontosan milyen problémák várnak rád.
Forrás: habr.com
