

Sokan találkoznak az Elasticsearch-szel. De mi történik, amikor azt akarod, hogy nagy mennyiségű naplót tárolj vele? És mindezt úgy, hogy fájdalommentesen átvészelj bármilyen központ leállását? Milyen architektúrára van szükség, és milyen buktatók várnak rád?
Az Odnoklassniki-nél az Elasticsearch segítségével döntöttünk a naplókezelés problémájának megoldásáról, és most megosztjuk a Habr-on szerzett tapasztalatainkat: az architektúráról és a buktatókról.
Pjotr Zajcev vagyok, rendszergazdaként dolgozom az Odnoklassniki-nél. Korábban is admin voltam, Manticore Search, Sphinx kereső, Elasticsearch-hoz volt tapasztalatom. Elképzelhető, ha megjelenik valami újabb …kereső, valószínűleg azzal is fogok dolgozni. Emellett több nyílt forráskódú projektben is részt veszek önkéntesként.
Amikor az Odnoklassniki-hez érkeztem, felelőtlenül azt mondtam az interjún, hogy tudok dolgozni az Elasticsearch-szel. Miután belemerültem és megoldottam néhány egyszerűbb feladatot, kaptam egy nagyobb feladatot a naplókezelő rendszer reformjával kapcsolatban, ami akkoriban létezett.
Követelmények
A rendszerrel szemben támasztott követelményeket a következőképpen fogalmaztuk meg:
- Frontendként a Graylog-ot kellett használni. Mert a cégnek már volt tapasztalata a termékkel kapcsolatban, a programozók és tesztelők ismerték, hozzászoktak és kényelmesen használták.
- Adatmennyiség: átlagosan 50-80 ezer üzenet másodpercenként, de ha valami elromlik, akkor a forgalom semmiben nem korlátozott, ez lehet 2-3 millió sor másodpercenként.
- Miután megbeszéltük az ügyfelekkel a keresési lekérdezések feldolgozási sebességére vonatkozó követelményeket, rájöttünk, hogy egy ilyen rendszer tipikus használati mintája az, hogy az emberek a legutóbbi két nap naplóit keresik, és nem akarnak egy másodpercnél tovább várni az eredményre a megfogalmazott kérésükre.
- Az adminok ragaszkodtak ahhoz, hogy a rendszer szükség esetén könnyen skálázható legyen, anélkül, hogy mélyen bele kelljen merülniük abba, hogyan is működik.
- Így az egyetlen karbantartási feladat, amelyre ezeknek a rendszereknek periódikusan szükségük volt, az volt, hogy kicseréljünk valamilyen hardware-t.
- Ezen kívül az Odnoklassniki-ban kiváló technikai hagyomány van: bármilyen szolgáltatást, amit indítunk, képesnek kell lennie arra, hogy túlélje a központ leállását (hirtelen, tervezett és teljesen bármikor).
A projekt megvalósításának legutolsó követelménye a legnagyobb küzdelmünket okozta, erről még részletesebben beszélek.
Környezet
N négy adatközpontban dolgozunk, eközben az Elasticsearch adatcsomópontok csak háromban helyezkedhetnek el (több nem műszaki okból).
Ezekben a négy adatközpontban körülbelül 18 ezer különböző naplóforrás található — hardverek, tárolók, virtuális gépek.
Fontos jellemző: a klaszter indítása tárolókban történik nem fizikai gépeken, hanem . A tárolóknak 2 magot garantálunk, hasonlóan a 2.0Ghz v4-hez, a többi mag kihasználása lehetőség szerint, ha azok inaktívak.
Más szavakkal:
Topológia
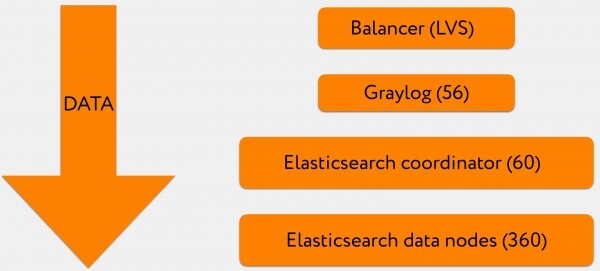
Az általános megoldás nekem kezdetben így tűnt:
- 3-4 VIP áll a Graylog domain A-nyilvántartása mögött, ez az a cím, ahová a naplók érkeznek.
- minden VIP LVS egyensúlyozóként működik.
- Ezek után a naplók egy Graylog gyűjtőbe jutnak, az adatok egy része GELF formátumban, másik része syslog formátumban tér vissza.
- A továbbiakban mindez nagy kötegekben íródik az Elasticsearch koordinátorok gyűjtőjébe.
- Ezek pedig, viszont, kérdéseket küldenek az írásra és olvasásra a megfelelő adatcsomópontokhoz.
Terminológia
Lehetséges, hogy nem mindenki jártas a terminológiában, ezért szeretném egy kicsit részletesebben kifejteni.
Az Elasticsearch-ben többféle nód létezik — master, coordinator, data node. Két másik típus is van különböző naplóátalakításokra és különböző klaszterek közötti kapcsolatra, de mi csak a felsoroltakat használtuk.
Master
Pingeli az összes klaszterben lévő nódot, fenntartja az aktuális klaszter térképet és megosztja azt a nódok között, kezeli az eseménylogikát, különböző cluster wide háztartási feladatokat végez.
Coordinator
Egyetlen feladatot lát el: fogadja az ügyfelektől érkező olvasási vagy írási kérelmeket és irányítja ezt a forgalmat. Ha az írási kérelem, valószínűleg meg fogja kérdezni a master-t, hogy melyik shard releváns indexbe kell tenni, és továbbirányítja a kérelmet.
Data node
Tárolja az adatokat, és végrehajtja a külsőből érkező keresési kérelmeket és a rajta lévő shardokon végrehajtott műveleteket.
Graylog
Ez olyan, mint a Kibana és Logstash egyesítése az ELK stackben. A Graylog ötvözi a felhasználói felületet és a logfeldolgozó pipeline-t. A Graylog mögött a Kafka és a Zookeeper működik, amelyek biztosítják a Graylog klaszter kapcsolatosságát. A Graylog képes a naplókat (Kafka) gyorsítótárazni az Elasticsearch elérhetetlensége esetére, és ismételni a sikertelen írási és olvasási kéréseket, valamint csoportosítani és címkézni a szabályok szerinti naplókat. Mint a Logstash, a Graylognak is van ittféle funkciója, amely lehetővé teszi a sorok módosítását mielőtt azokat az Elasticsearchbe írnánk.
Ezen kívül a Graylog beépített szolgáltatás-felfedezéssel rendelkezik, amely lehetővé teszi, hogy egyetlen elérhető Elasticsearch node alapján megszerezzük az egész klaszter térképét, és szűrjük azt egy adott címke alapján, ami lehetővé teszi a kérések irányítását meghatározott konténerek felé.
Látványilag így néz ki:

Ez egy képernyőfelvétel egy konkrét példányról. Itt keresési kifejezéssel hisztogramot állítunk elő, releváns sorokat jelenítve meg.
Indexek
A rendszerarchitektúrára visszatérve, szeretnék részletesebben beszélni arról, hogyan építettük fel az indexmodelt, hogy minden rendben működjön.
A korábban bemutatott ábrán ez a legalacsonyabb szint: az Elasticsearch adatcsomópontok.
Az index egy nagy virtuális entitás, amely az Elasticsearch shardjaiból áll. Maguk a shardok nem mások, mint Lucene indexek. Minden Lucene index pedig egy vagy több szegmensből áll.
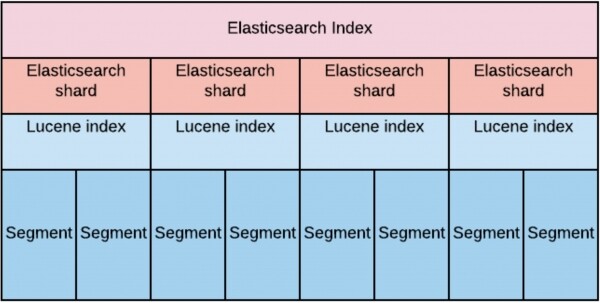
A tervezés során azt számoltuk, hogy ahhoz, hogy a nagy adatmennyiség gyors olvasási igényeit kielégítsük, egyenletesen kell "elkenni" ezeket az adatokat az adatcsomópontok között.
Ez abban nyilvánult meg, hogy az indexre (replikákkal) vonatkozó shardok száma szigorúan meg kellett, hogy egyezzen a data node-ok számával. Egyrészt, hogy biztosítsuk a replikációs faktort, amely kettőre van állítva (tehát elveszíthetjük a klaszter felét). Másrészt, hogy a kérések olvasását és írását legalább a klaszter felén tudjuk kezelni.
A tárolási időt először 30 napban határoztuk meg.
A shardok eloszlását grafikus formában a következőképpen lehet ábrázolni:
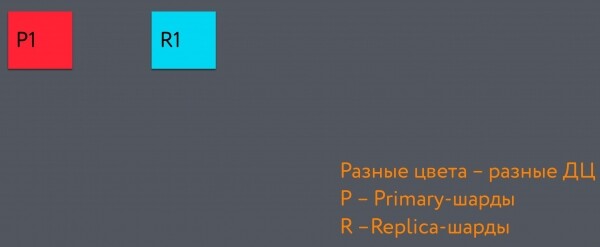
Az egész sötétszürke téglalap az indexet jelenti. A baloldali piros négyzet az elsődleges shard, amely az index első shardja. A kék négyzet pedig a replikás shard. Ezek különböző adatközpontokban találhatók.
Amikor hozzáadunk még egy shardot, az a harmadik adatközpontba kerül. Végül tehát azt a struktúrát kapjuk, amely lehetővé teszi az adatközpont elvesztését anélkül, hogy az adatok következetlenségét szenvednének el.
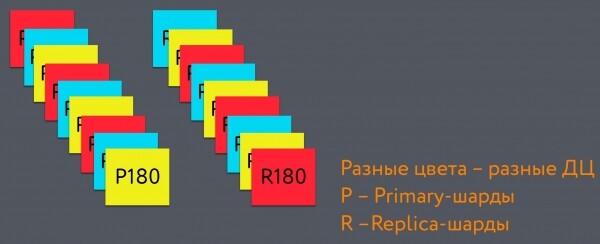
Az indexek forgatását, azaz új index létrehozását és a legöregebb törlését 48 órára állítottuk be (az index használati mintázata alapján: az utolsó 48 órában keresnek a leggyakrabban).
Ez az indexforgatási időintervallum a következő okokkal függ össze:
Amikor egy konkrét adat-nódára keresési kérés érkezik, a teljesítmény szempontjából előnyösebb, ha csak egy shardot kérdezünk le, ha annak mérete hasonlít a nód hípje méretéhez. Ez lehetővé teszi a "forró" indexrész hípben tartását és gyors hozzáférést. Amikor sok "forró része" van, a keresési sebesség romlik.
Amikor a nód egy shardon elkezdi végrehajtani a keresési kérést, a fizikai gép hyper-threading magjainak számával megegyező számú szálat oszt ki. Ha a keresési kérdés sok shardot érint, a szálak száma arányosan nő. Ez hátrányosan befolyásolja a keresés sebességét, és negatívan hat az új adatok indexelésére.
A keresési késleltetés biztosítása érdekében SSD-t döntöttünk használni. A gyors kérésfeldolgozáshoz, amelyeken ezek a konténerek futottak, legalább 56 maggal kellett rendelkezniük a gépeknek. Az 56-os számot mint kielégítő minimumot választottuk, amely meghatározza a szálak számát, amelyet az Elasticsearch a működés során létrehoz. Az Elasticsearch-nél sok thread pool paraméter közvetlenül függ a rendelkezésre álló magok számától, ami viszont közvetlen hatással van a klaszterhez szükséges nódok számának arányára, a "kevesebb mag — több nód" elv szerint.
Végül azt kaptuk, hogy egy átlagos shard körülbelül 20 gigabájt méretű, és egy indexre 360 shard jut. Ha ezeket 48 óránként forgatjuk, akkor 15 shardunk van. Minden index 2 napnyi adatot tartalmaz.
Adatok írási és olvasási sémái
Nézzük meg, hogyan kerülnek az adatok rögzítésre ebben a rendszerben.
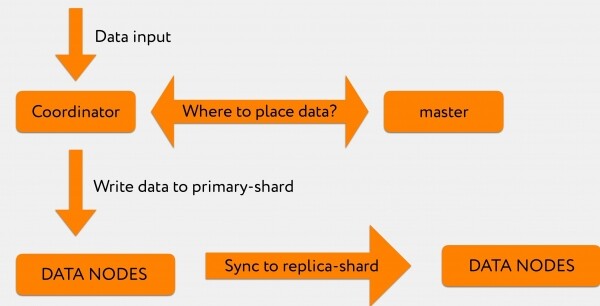
Tegyük fel, hogy a Graylogból egy kérés érkezik a koordinátorhoz. Például 2-3 ezer sor indexelését szeretnénk végrehajtani.
A koordinátor, miután megkapta a Greylogtól a kérdést, megkérdezi a mestert: „A kiosztás kérésében kifejezetten meg lett határozva az index, de hogy melyik shardba írjunk - az nincs megadva.”
A mester válaszol: „Írd be ezt az információt a 71-es shardba”, majd az információ közvetlenül a megfelelő adatcsomópontba kerül, ahol a 71-es primary-shard található.
Ezt követően a tranzakciók naplója replikálódik a replica-shardba, amely már egy másik adatközpontban található.
A Graylogból a koordinátorhoz keresési kérés érkezik. A koordinátor az index alapján továbbítja, miközben az Elasticsearch round-robin elv alapján osztja el a kéréseket a primary-shard és a replica-shard között.
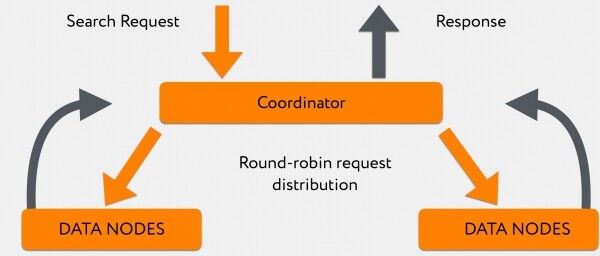
Összesen 180 csomópont válaszol, és míg válaszolnak, a koordinátor összegyűjti az információt, amelyet már a gyorsabb adatcsomópontok „kidobtak” neki. Ezután, amikor minden információ megérkezett, vagy a kérést timeoutosra érte, mindent közvetlenül az ügyfélnek ad át.
Ez a rendszer átlagosan a legutóbbi 48 órás keresési kéréseket 300-400 ms alatt dolgozza fel, kivéve azokat a kéréseket, amelyek leading wildcardot tartalmaznak.
„Virágocskák” az Elasticsearch-szel: Java beállítás
Ahhoz, hogy mindez úgy működjön, ahogyan eredetileg akartuk, nagyon sokáig hangoltuk a legkülönfélébb dolgokat a klaszterben.
A felfedezett problémák első része a Java alapértelmezett beállításaival volt összefüggésben az Elasticsearch-ban.
Első probléma
Nagyon sok üzenetet láttunk arról, hogy a Lucene szintjén, amikor background jobok futnak, a Lucene szegmensek egyesítése hibával végződik. A naplókban látszott, hogy ez OutOfMemoryError hiba. A telemetria szerint láttuk, hogy a heap szabad, és nem volt világos, miért bukik meg ez a művelet.
Kiderült, hogy a Lucene indexek egyesítése a heap-on kívül történik. A konténerek meglehetősen szigorúan korlátozottak a felhasználható erőforrásokban. Ezekbe az erőforrásokba csak a heap fért bele (a heap.size körülbelül egyenlő volt a RAM-mal), míg egyes off-heap műveletek memória-allokációs hibával estek el, ha valami oknál fogva nem fért bele a ~500MB-ba, ami a limit előtt maradt.
A megoldás meglehetősen triviális volt: a konténer számára rendelkezésre álló RAM mennyiségét megnöveltük, ezután pedig elfeledkeztünk arról, hogy valaha ilyen problémáink voltak.
Második probléma
Néhány nappal a klaszter elindítása után észrevettük, hogy az adatcsomópontok időnként kiesnek a klaszterből, majd 10-20 másodperc múlva újra belépnek.
Amikor elkezdtük megvizsgálni, kiderült, hogy az Elasticsearch-ban lévő off-heap memória gyakorlatilag semmilyen módon nem ellenőrizhető. Amikor több memóriát adtunk a konténernek, lehetőségünk nyílt különféle információkkal feltölteni a közvetlen puffer medencéket, és ezek csak akkor tisztultak meg, amikor az Elasticsearch explicit GC-t indított.
Bizonyos esetekben ez a művelet meglehetősen hosszan tartott, és ezalatt a klaszter már megjelölte ezt a csomópontot, mint amelyik már kilépett. Ezt a problémát jól leírták. .
A megoldás a következő volt: korlátoztuk a Java lehetőségét, hogy a memória legnagyobb részét az off-heap műveletekhez használja. Ezt 16 gigabájt (-XX:MaxDirectMemorySize=16g) korlátozásra állítottuk be, így az explicit GC sokkal gyakrabban hívódott meg, és jelentősen gyorsabban futott, így nem destabilizálta a klasztert.
Harmadik probléma
Ha azt hiszed, hogy a "csomópontok, amelyek a legnagyobb váratlansággal hagyják el a klasztert" problémái ezzel véget értek, tévedsz.
Amikor az indexek működésének konfigurálásán dolgoztunk, a mmapfs mellett döntöttünk, hogy az új shardok esetén, amelyek nagy szegmentáltsággal rendelkeznek. Ez eléggé durva hiba volt, mert a mmapfs használatakor a fájl a RAM-ba van térképezve, és ezután a térképezett fájllal dolgozunk. Emiatt, amikor a GC megpróbálja leállítani a szálakat az alkalmazásban, nagyon hosszú ideig jutunk el a safepoint-hoz, és ez alatt az alkalmazás nem válaszol a mester kérdéseire arról, hogy él-e. Ennek következtében a mester azt hiszi, hogy a csomópont már nem része a klaszternek. Ezután 5-10 másodperc múlva a garbage collector végrehajtódik, a csomópont újjáéled, újra belép a klaszterbe és megkezdi a shardok inicializálását. Ez nagyon emlékeztetett arra a "termelésre, amire megérdemeltük", és nem volt alkalmas semmi komolyra.
Az ilyen viselkedés megszüntetése érdekében először átálltunk a standard niofs-re, majd amikor az ötödik Elastic verziókról a hatodikra migráltunk, kipróbáltuk a hybridfs-t, ahol ez a probléma nem jelentkezett. A tárolás típusairól bővebben olvashatsz. .
Negyedik probléma
Aztán volt még egy nagyon érdekes probléma, amelyet rekord idő alatt kezeltünk. Két-három hónapon keresztül próbáltuk fogni, mert a mintázata teljesen érthetetlen volt.
Néha a koordinátoraink Full GC körüli állapotba kerültek, általában valahol dél után, és onnan már nem tértek vissza. Miközben a GC késlekedéseket naplóztuk, ez úgy nézett ki: minden rendben, rendben, rendben, majd hirtelen minden drámaian rossz lett.
Először azt gondoltuk, hogy van egy rosszindulatú felhasználó, aki valamilyen lekérdezést indít, amely kiüti a koordinátort a munkára készen álló állapotból. Nagyon sokáig naplóztuk a lekérdezéseket, próbálva kideríteni, mi történik.
Végül kiderült, hogy amikor egy felhasználó egy hatalmas lekérdezést indít, és az egy adott Elasticsearch koordinátorhoz jut el, néhány csomópont lassabban válaszol, mint a többiek.
A koordinátor addig, amíg várja az összes csomópont válaszát, felhalmozza a már válaszoló csomópontoktól érkező eredményeket. A GC számára ez azt jelenti, hogy nagyon gyorsan megváltozik a heap használati mintázata. A választott GC pedig nem tudott megbirkózni ezzel a feladattal.
Az egyetlen megoldás, amit találtunk, hogy megváltoztassuk a klaszter viselkedését ilyen helyzetben, a JDK13-ra való migrálás és a Shenandoah szemétgyűjtő használata volt. Ez megoldotta a problémát, a koordinátoraink többé nem omlottak össze.
Ekkor véget értek a Java-val kapcsolatos problémák és megkezdődtek a teljesítménybeli problémák.
A „gyümölcsök” az Elasticsearch-től: teljesítménybeli problémák
A teljesítménybeli problémák azt jelentik, hogy a klaszterünk stabilan működik, de az indexelendő dokumentumok mennyiségének csúcsain és a manőverek során a teljesítmény nem elegendő.
Az első tapasztalt tünet: bizonyos „robbanások” során a termelésben, amikor hirtelen nagy mennyiségű napló generálódik, a Graylog gyakran megjeleníti az es_rejected_execution indexelési hibát.
Ez azért történt, mert a thread_pool.write.queue egy adatcsomóponton, mielőtt az Elasticsearch feldolgozná az indexelési lekérést és az információt a shardra mentené, alapértelmezés szerint csak 200 lekérdezést tud tárolni. Érdekes módon erről a paraméterről nagyon keveset beszélnek. Csak a maximális szálak számát és az alapértelmezett méretet említik.
Természetesen elkezdtük állítani ezt az értéket, és a következőket állapítottuk meg: a mi beállításunknál a 300 lekérdezésig viszonylag jól tárolódik, de ennél magasabb érték már újra Full GC-be terel bennünket.
Továbbá, mivel üzenettömbök érkeznek egyetlen kérés keretében, szükség volt a Graylog finomítására, hogy ne gyakran és apró kötegekben írjon, hanem hatalmas kötegekben vagy három másodpercenként, ha a köteg még mindig nem teljes. Ilyen esetben az információ, amelyet az Elasticsearch-be írunk, nem válik elérhetővé két másodperc múlva, hanem öt után (ami számunkra teljesen megfelelő), de csökken a többszörös próbálkozások száma, amelyekre szükség van, hogy átkonvertáljunk egy nagyobb információkészletet.
Ez különösen fontos azokban a pillanatokban, amikor valami leállt valahol, és erről hevesen értesít minket, hogy ne kapjunk teljesen spammelt Elastic-et, és egy idő elteltével a Graylog csomópontok offline állapotba kerüljenek a túlterhelt pufferek miatt.
Továbbá, amikor ezek a robbantások történtek a termelésben, programozóktól és tesztelőktől érkeztek panaszok: abban a pillanatban, amikor nagyon szükségük volt ezekre a naplókre, azok nagyon lassan érkeztek.
Kezdtünk utána járni. Egyrészt világos volt, hogy a keresési lekérdezések és az indexelési kérdések lényegében ugyanazon fizikai gépeken futnak, és így vagy úgy, bizonyos lehullásokra lehet számítani.
De ezt részben el lehetett kerüli, mivel az Elasticsearch hatodik verzióiban megjelent egy algoritmus, amely lehetővé teszi a lekérdezések releváns adatcsomópontok közötti elosztását nem véletlenszerű round-robin elven (az indexelést végző konténer, amely a primary-shard-ot kezeli, nagyon elfoglalt lehet, nem lesz lehetőség a gyors válaszadásra), hanem a lekérdezést egy kevésbé terhelt konténerre irányítani, amely a replica-shard-ot kezeli, és jelentősen gyorsabban válaszol. Más szóval, előálltunk a use_adaptive_replica_selection: true beállítással.
Az olvasási kép így kezd kinézni:
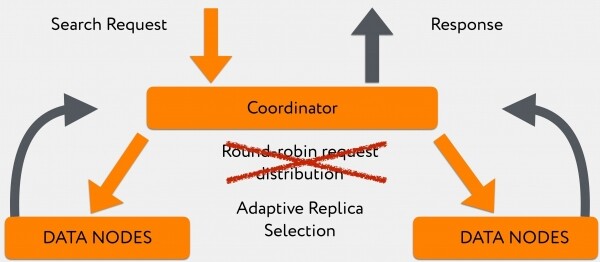
Az algoritmusra való áttérés lehetővé tette a lekérdezési idő jelentős javulását azokban a pillanatokban, amikor nagy mennyiségű napló íródott.
Végül, a fő probléma a adatközpont fájdalommentes leállítása volt.
Mit vártunk el a klasztertől az egyik adatközponttal való kapcsolat elvesztése után:
- Ha az elérhetetlen adatközpontban tartózkodik az aktuális mester, akkor azt ismételt választással egy másik csomópontba fogja visszakonfigurálni egy másik adatközpontban.
- A mester gyorsan eltávolítja a klaszterből az összes elérhetetlen csomópontot.
- Alapján a megmaradtaknak megérti: az eltűnt adatközpontban voltak olyan primary shardok, gyorsan felnöveli a kiegészítő replica shardokat a megmaradt adatközpontokban, és folytatódik az adatok indexálása.
- Ennek eredményeként a klaszter írási és olvasási sávszélessége fokozatosan csökken, azonban összességében minden működni fog, még ha lassan is, de stabilan.
Kiderült, hogy valami ilyesmire vágytunk:
De a következőt kaptuk:
Hogyan történt ez?
Az adatközpont leállása pillanatában a mester szerepe volt a szűk keresztmetszet.
Miért?
Az a helyzet, hogy a mesternél van egy TaskBatcher, amely a klaszterben bizonyos feladatok és események elosztásáért felelős. Bármelyik node hibája, bármely shard promotálása replica-ból primary-ra, bármely shard létrehozására vonatkozó feladat — mindez először a TaskBatcherbe kerül, ahol sorrendben és egy szálon dolgozzák fel.
Az egyik adatközpont leállítása pillanatában úgy tűnt, hogy az összes élő adatnode a fennmaradó adatközpontokban kötelességének érzi, hogy értesítse a mestert, hogy "elvesztek ilyen-olyan shardok és ilyen-olyan adatnode-ok".
Ekkor az életben maradt data node-ok teljes információt küldtek a jelenlegi mesternek, és megpróbálták várni, hogy megkapják a visszaigazolást, hogy ő azt elfogadta. Ezt azonban nem várták meg, mivel a mester gyorsabban kapta a feladatokat, mint ahogy válaszolni tudott. A node-ok a timeout miatt megismételték a kéréseket, míg a mester közben már nem is próbált válaszolni, teljesen el volt foglalva a kérések prioritás szerinti rendezésével.
Terminális formában úgy nézett ki, hogy az adatnode-ok annyira spamezték a mestert, hogy az full GC állapotba került. Ezután a mester szerepe átlépett egy következő node-ra, és ugyanaz történt vele, míg végül a klaszter teljesen szétesett.
Méréseket végeztünk, és a 6.4.0 verzió előtt, ahol ezt javították, elegendő volt egyszerre mindössze 10 adatnode-ot leállítani a 360-ból, hogy teljesen leállítsuk a klasztert.
A következőképpen nézett ki:
A 6.4.0 verzió után, ahol ezt a rémisztő hibát javították, az adatnode-ok már nem ölték meg a mestert. De ettől még nem lett "okosabb". Nevezetesen: amikor 2, 3 vagy 10 (bármennyi, ami nem egy) adatnode-ot állítunk le, a mester kap egy első üzenetet, amely azt mondja, hogy az A node leállt, és próbálja erről tájékoztatni a B, C és D node-okat.
Jelen pillanatban ezt csak azzal a technikával lehet kezelni, hogy beállítunk egy időkorlátot arra, hogy mennyi ideig próbálhatunk valakinek mesélni valamiről, ez körülbelül 20-30 másodperc, így irányítva a adatközpont kilépési sebességét a klaszterből.
Alapvetően ez megfelel azoknak a követelményeknek, amelyeket eredetileg a projekt keretein belül támasztottak a végtermékkel szemben, de a „tiszta tudomány” szempontjából ez egy hiba. Ezt egyébként a fejlesztők sikeresen javították a 7.2-es verzióban.
Ami azt illeti, amikor egy adatcsomópont kilépett, úgy tűnt, hogy fontosabb információt terjeszteni a kilépéséről, mint hogy elmondjuk az egész klaszternak, hogy rajta voltak bizonyos primary-shard-ek (hogy promotálhassuk a replica-shard-et egy másik adatközpontba elsődlegessé, ahol információkat lehetett írni).
Ezért amikor minden „elcsendesedik”, a kilépett adatcsomópontokat nem azonnal jelölik meg frissítetlenként. Ennek megfelelően várnunk kell, amíg az összes ping időkorlátja elérhetővé válik a kilépett adatcsomópontokhoz, és csak ezután kezd a klaszter mesélni arról, hogy ott, ott és ott folytatni kell az információk rögzítését. Részletesebben erről lehet olvasni .
Végül a adatközpont közlésének művelete ma körülbelül 5 percet vesz igénybe csúcsidőben. Egy ilyen nagy és nehézkes gépezethez képest ez meglehetősen jó eredmény.
Ezért arra a következtetésre jutottunk, hogy
- 360 adatcsomópontunk van 700 gigabájtos meghajtókkal.
- 60 koordinátor a forgalom irányítására ezek az adatcsomópontok között.
- 40 mester, akik örökségként maradtak hátra az 6.4.0 előtti verziókból — a adatközpont kilépésének átvészelésére lelkileg készen álltunk, hogy néhány gépet elveszítsünk, hogy garantáltan még a legrosszabb forgatókönyv esetén is legyen mesteri kvórumunk.
- Bármely kísérlet a szerepek egy konténerben való egyesítésére azzal a problémával szembesült, hogy előbb vagy utóbb a csomópont a terhelés alatt meghibásodott.
- Az egész klaszterben 31 gigabájt méretű heap.size van használatban: minden kísérlet a méret csökkentésére azt eredményezte, hogy a nehéz keresési lekérések vezető wildcard-dal vagy megöltek néhány csomópontot, vagy a circuit breaker az Elasticsearch-ben beszüntetődött.
- Ezen kívül a keresési teljesítmény biztosítása érdekében igyekeztünk a klaszterben a lehető legkisebb számú objektumot tartani, hogy a lehető legkevesebb eseményt dolgozhassunk fel a legszűkebb helyen, amely a mesterünkben alakult ki.
Végül a megfigyelésről
Ahhoz, hogy minden így működjön, ahogy terveztük, figyelemmel kísérjük a következőket:
- Minden adatcsomópont jelentést küld a felhőnkbe arról, hogy létezik, és hogy rajta ilyen-olyan shardok találhatók. Amikor valahol leállítunk valamit, a klaszter 2-3 másodpercen belül jelent, hogy az A központban leállítottuk a 2., 3. és 4. csomópontot — ez azt jelenti, hogy más adatközpontokban semmilyen körülmények között nem állíthatunk le olyan csomópontokat, amelyeken shardok vannak egyedüli példányban.
- A mester viselkedésének ismeretében nagyon figyelmesen követjük a függőben lévő feladatok számát. Mert még egy egyedülállóan álló feladat is, ha nem időben időtúllépésre kerül, elméletileg egy vészhelyzetben azzá válhat, ami miatt nem tudjuk végrehajtani például a replica shard promócióját primaryvá, ami miatt leáll az indexelés.
- A garbage collector késleltetéseit is nagyon figyelmesen nézzük, mert már korábban nagy nehézségeink voltak ezzel az optimalizálás során.
- A szálakra vonatkozó elutasítások, hogy előre láthassuk, hol található a „szűk keresztmetszet”.
- No és a standard metrikák, mint a heap, RAM és I/O.
A monitoring kiépítésénél mindenképpen figyelembe kell venni az Elasticsearch Thread Pool sajátosságait. leírja a keresés, indexelés beállításának lehetőségeit és alapértelmezett értékeit, de teljesen elhallgat a thread_pool.management-ról. Ezek a szálak kezelik például az _cat/shards típusú kéréseket és egyéb hasonlóakat, amelyeket kényelmesen használhatunk a monitoring írása során. Minél nagyobb a klaszter, annál több ilyen kérés kerül végrehajtásra egy időegység alatt, és a fent említett thread_pool.management nemcsak, hogy nincs képviselve a hivatalos dokumentációban, de alapértelmezés szerint 5 szálra van korlátozva, ami nagyon gyorsan elfogy, és ezután a monitoring már nem működik helyesen.
Végül szeretném elmondani: sikerült! Olyan eszközt tudtunk adni a programozóinknak és fejlesztőinknek, amely szinte bármilyen helyzetben képes gyorsan és megbízhatóan információt szolgáltatni arról, ami történik a termelésben.
Igen, elég nehéz volt, de ennek ellenére sikerült a kívánságainkat beleilleszteni a már létező termékekbe, amelyekhez nem kellett javítanunk vagy átírnunk őket a saját igényeinknek megfelelően.
Forrás: habr.com
