

Miről fogunk beszélni:
Hogyan hozhatunk létre gyorsan közös tárolót két szerver számára drbd+ocfs2 megoldások alapján.
Kinek lesz ez hasznos:
Ez a útmutató hasznos lesz rendszeradminisztrátoroknak és mindenkinek, aki tárolási megoldást keres vagy ki szeretné próbálni a megoldást.
Milyen megoldásokról mondtunk le, és miért
Gyakran találkozunk olyan helyzettel, amikor egy kis webklaszterben egy közös tárolót kell megvalósítanunk, amely jó olvasási-írási teljesítménnyel bír. Különböző közös tárolási megoldásokat próbáltunk ki projektjeink számára, de kevés dolog felelt meg több szempontból azonnal. Most elmondjuk, miért.
- A Glusterfs nem volt megfelelő számunkra olvasási és írási teljesítmény szempontjából; problémák merültek fel, amikor nagy mennyiségű fájl egyidejű olvasására került sor, és a CPU terhelése is magas volt. A fájlok olvasási problémáját közvetlenül a brickekből való kéréssel meg lehetett volna oldani, de ez nem mindig alkalmazható, és összességében nem helyes.
- A Ceph túlzott bonyolultsága miatt nem tetszett nekünk, ami káros lehet a 2-4 közötti projekteken, szerverek, különösen, ha a projektet később karbantartják. Ismét komoly teljesítménykorlátok is vannak, amelyek külön tároló klaszterek létrehozására kényszerítenek, mint a glusterfs esetében.
- Egyetlen nfs szerver használata közös tároló létrehozásához kérdéseket vet fel a megbízhatóság szempontjából.
- Az s3 egy remek, népszerű megoldás bizonyos feladatok számára, de nem fájlrendszer, ami korlátozza a felhasználási területet.
- lsyncd. Ha már a „nem fájlrendszerekről” beszélünk, érdemes megemlíteni ezt a népszerű megoldást is. Nemcsak az a probléma, hogy nem alkalmas kétirányú adatcserére (de ha nagyon akarjuk, megoldható), de ráadásul nem működik stabilan nagy mennyiségű fájl esetén. Kellemes kiegészítő, hogy egyszálú. Az ok az alkalmazás architektúrájában rejlik: inotify-t használ a figyelt objektumok monitorozására, amelyeket indításkor és újraolvasáskor közelít. Az adatátvitelhez rsync-et használ.
Útmutató: hogyan hozzunk létre közös tárolót drbd+ocfs2 alapján
Az egyik legkényelmesebb megoldás számunkra az ocfs2+drbdösszeállítás volt. Most elmondjuk, hogyan lehet gyorsan létrehozni egy közös tárolót két számára. szerverek az adatmegoldások alapján. De először néhány szó az összetevőkről:
DRBD — a Linux alapértelmezett tárolási rendszere, amely lehetővé teszi az adatok blokkszintű replikációját a szerverek között. Fő alkalmazása hibamentes tárolók létrehozásában rejlik.
OCFS2 — egy fájlrendszer, amely lehetővé teszi, hogy több rendszer megossza ugyanazt a tárolót. A Linux mellett érkezik, és egy kernelmodulból, valamint userspace eszközökből áll a fájlrendszer kezelésére. Az OCFS2 nemcsak DRBD-fel használható, hanem iSCSI-n is, több csatlakozással. A példánkban DRBD-t használunk.
Minden művelet az Ubuntu Server 18.04 minimális konfigurációjában történik.
1. lépés. A DRBD beállítása:
A fájlban /etc/drbd.d/drbd0.res írjuk le virtuális blokkeszközünket /dev/drbd0:
resource drbd0 {
    syncer { rate 1000M; }
    net {
        allow-two-primaries;
        after-sb-0pri discard-zero-changes;
        after-sb-1pri discard-secondary;
        after-sb-2pri disconnect;
    }
    startup { become-primary-on both; }
    on drbd1 {
        meta-disk internal;
        device /dev/drbd0;
        disk /dev/vdb1;
        address 10.10.10.192:7789;
}
    on drbd2 {
        meta-disk internal;
        device /dev/drbd0;
        disk /dev/vdb1;
        address 10.10.10.193:7789;
}
}
meta-disk internal — ugyanazokat a blokk eszközöket használni a metainformációk tárolására
device /dev/drbd0 — a /dev/drbd0 útvonalat drbd esetén használni.
disk /dev/vdb1 — a /dev/vdb1 használata
syncer { rate 1000M; } — gigabites sávszélességet használni
allow-two-primaries — fontos opció, amely lehetővé teszi, hogy a módosításokat két primary szerveren elfogadják
after-sb-0pri, after-sb-1pri, after-sb-2pri — opciók, amelyek a csomópont tevékenységéért felelősek split brain észlelésekor. A részletek a dokumentációban találhatók.
become-primary-on both — mindkét csomópontot primary-ra állítja.
Ebben az esetben két teljesen azonos VM-ünk van, 10 gigabites sávszélességgel rendelkező dedikált virtuális hálózattal.
A példánkban a klaszter két csomópontjának neve drbd1 és drbd2. A megfelelő működés érdekében az /etc/hosts fájlban a neveknek és IP címeknek párosítaniuk kell egymást.
10.10.10.192 drbd1
10.10.10.193 drbd2
2. lépés. A csomópontok beállítása:
Mindkét szerveren végrehajtjuk:
drbdadm create-md drbd0 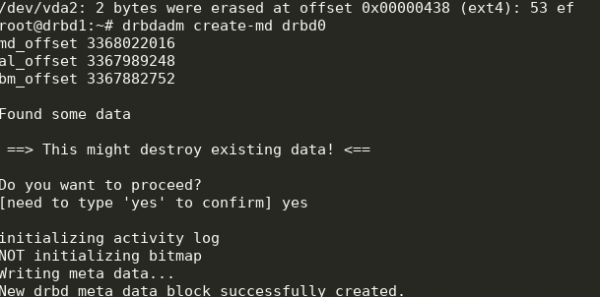
modprobe drbd
drbdadm up drbd0
cat /proc/drbd
A következőt kapjuk:
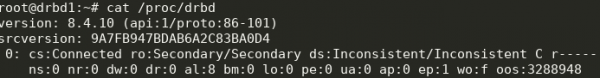
A szinkronizálás elindítható. Az első csomóponton végre kell hajtani:
drbdadm primary --force drbd0Nézzük meg a státuszt:
cat /proc/drbd 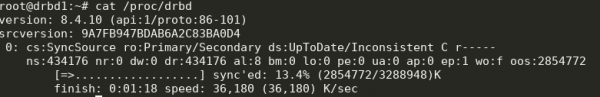
Remek, elindult a szinkronizálás. Várjuk meg a befejezést, és láthatjuk az eredményt:
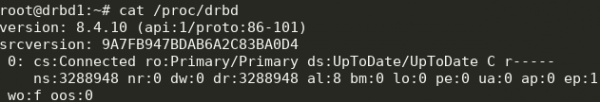
3. lépés. A szinkronizálás elindítása a második csomóponton:
drbdadm primary --force drbd0
A következőt kapjuk:
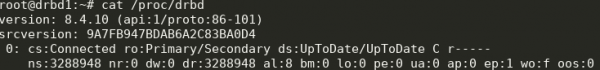
Most már mindkét szerverről írhatunk a drbd-be.
4. lépés. Az ocfs2 telepítése és beállítása.
Egyszerű konfigurációt fogunk használni:
cluster:
     node_count = 2
     name = ocfs2cluster

node:
     number = 1
     cluster = ocfs2cluster
     ip_port = 7777
     ip_address = 10.10.10.192
     name = drbd1

node:
     number = 2
     cluster = ocfs2cluster
     ip_port = 7777
     ip_address = 10.10.10.193
     name = drbd2
Ezt fel kell jegyezni /etc/ocfs2/cluster.conf mindkét noden.
FS-t hozunk létre drbd0-n bármelyik noden:
mkfs.ocfs2 -L "testVol" /dev/drbd0
Itt a testVol címkéjű FS-t hoztuk létre drbd0-n, alapértelmezett paraméterekkel.
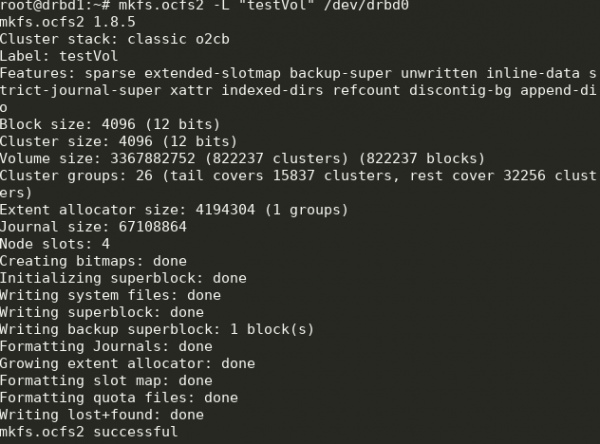
A /etc/default/o2cb fájlban be kell állítani (ahogy a konfigurációs fájlban van):
O2CB_ENABLED=true
O2CB_BOOTCLUSTER=ocfs2cluster
és mindkét noden végre kell hajtani:
o2cb register-cluster ocfs2clusterEzt követően engedélyezzük a szükséges unitokat és hozzáadjuk az automatikus indításhoz:
systemctl enable drbd o2cb ocfs2
systemctl start drbd o2cb ocfs2
Ebből egy része már elindul a beállítás során.
5. lépés. Csatolási pontok hozzáadása a fstab-hoz mindkét noden:
/dev/drbd0 /media/shared ocfs2 defaults,noauto,heartbeat=local 0 0Könyvtár /media/shared mielőtt ez létre lenne hozva.
Itt a noauto opciót használjuk, ami azt jelenti, hogy az FS nem fog csatolódni indításkor (én inkább a network FS-t systemd-n keresztül csatolom) és a heartbeat=local, ami azt jelenti, hogy minden noden a heartbeat szolgáltatást használjuk. Létezik egy global heartbeat is, ami inkább nagyobb klaszterekhez illeszkedik.
Ezután csatolhatjuk /media/shared és ellenőrizhetjük a tartalom szinkronizálását.
Kész! Ennek eredményeként egy jobbára hibatűrő tárolót kapunk a skálázhatóság és a megfelelő teljesítmény lehetőségével.
Forrás: habr.com
