

Helló, Habr-lakók! Ez a könyv bármely fejlesztő számára hasznos lesz, aki szeretné megérteni az áramlás alapú feldolgozást. A elosztott programozás megértése segít jobban megismerni a Kafka-t és a Kafka Streams-t. Jó lenne ismerni a Kafka keretrendszert is, de nem kötelező: minden szükséges információt el fogok mondani. A tapasztalt Kafka fejlesztők és az újoncok is, ennek a könyvnek köszönhetően, érdekes áramlásfeldolgozó alkalmazásokat hozhatnak létre a Kafka Streams könyvtárral. A Java fejlesztők, akik már ismerik az olyan fogalmakat, mint a sorosítás, elsajátítják, hogyan alkalmazzák tudásukat a Kafka Streams alkalmazások létrehozására. A könyv forráskódja Java 8 nyelven íródott, és jelentősen használja a Java 8 lambda kifejezéseit, így érdemes a lambda funkciók használatát (még más programozási nyelven is) megtanulni.
Részlet. 5.3. Aggregálás és ablakos műveletek
Ebben a részben a Kafka Streams legígéretesebb részeinek a megismerésének szenteljük magunkat. Eddig a következő Kafka Streams-aspektusokat vizsgáltuk:
- feldolgozási topológia létrehozása;
- állapot használata az áramlás alapú alkalmazásokban;
- adatfolyamok összevonása;
- különbségek az eseményfolyamok (KStream) és a frissítési folyamok (KTable) között.
A következő példákban ezeket az elemeket egyesítjük. Ezen kívül megismerkedhet az ablakos műveletekkel – egy újabb nagyszerű lehetőséggel az áramlás alapú alkalmazások számára. Az első példánk egy egyszerű aggregálás lesz.
5.3.1. Az iparágak szektorai közötti részvénykereskedelmi aggregálás
Az aggregálás és csoportosítás életfontosságú eszközök az áramlás alapú adatok kezelésében. Az egyedi rekordok nyomon követése gyakran nem elegendő. A további információk kinyeréséhez szükséges az adatok csoportosítása és kombinálása.
Ebben a példában át fogja élni egy intranap kereskedő szerepét, akinek nyomon kell követnie a részvények forgalmát több iparágban. Kifejezetten öt olyan cég érdekel, amelyek a legmagasabb részvényforgalommal rendelkeznek minden egyes iparágban.
Ehhez az aggregáláshoz több lépést kell végrehajtanunk az adatok szükséges formára alakításához (általános értelemben szólva).
- Hozzon létre egy forrást a téma alapján, amely nyers információkat publikál a részvénykereskedelemről. Át kell alakítanunk a StockTransaction típust ShareVolume típusúvá. Azért, mert a StockTransaction objektum tartalmazza az eladások metaadatait, nekünk csak a eladott részvények számadataira van szükségünk.
- Csoportosítsa a ShareVolume adatokat a részvények szimbólumai szerint. A szimbólumok szerinti csoportosítás után ezeket az adatokat az részvények eladási mennyiségeinek közbenső összegeivé tudjuk sűríteni. Érdemes megjegyezni, hogy a KStream.groupBy metódus egy KGroupedStream példányt ad vissza. A KTable példányt a KGroupedStream.reduce metódusának hívásával kaphatjuk meg.
Mi az a KGroupedStream interfész
A KStream.groupBy és a KStream.groupByKey metódusok egy KGroupedStream példányt adnak vissza. A KGroupedStream az eseményfolyam közbenső reprezentációja a kulcsok szerinti csoportosítás után. Nem arra készült, hogy közvetlenül dolgozzunk vele. Ehelyett a KGroupedStream-et aggregáló műveletekhez használják, amelyek eredménye mindig KTable. Mivel az aggregáló műveletek eredménye KTable, és ezekben állapot-tároló alkalmazásra kerül sor, lehet, hogy nem minden frissítés jut tovább a csővezetékben.
A KTable.groupBy metódus egy hasonló KGroupedTable-t ad vissza — a frissítések kulcs szerinti újracsoportosított eseményfolyamának közbenső reprezentációja.
Tartsunk egy kis szünetet, és nézzük meg az 5.9. ábrát, amely megmutatja, amit eddig elértünk. Ez a topológia már ismerősnek kell lennie a számodra.
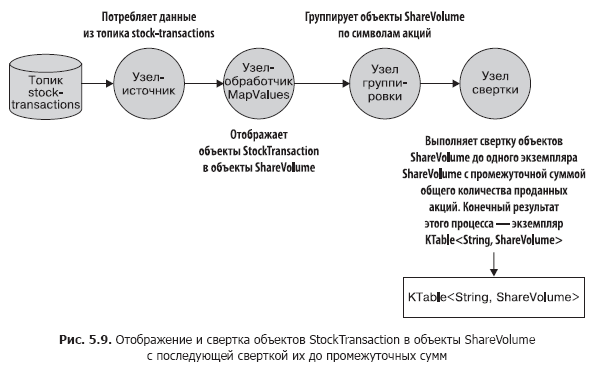
Most nézzük meg a kódot ehhez a topológiához (megtalálható a src/main/java/bbejeck/chapter_5/AggregationsAndReducingExample.java fájlban) (5.2. lista).
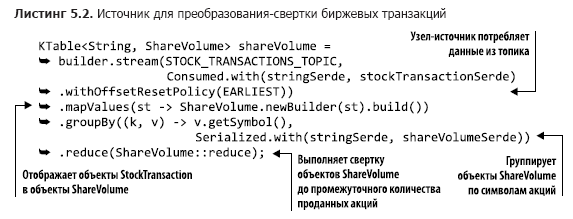
A megadott kód tömör és számos lépést hajt végre néhány sorban. A builder.stream metódus első paraméterében észreveheted a számodra új dolgot: az AutoOffsetReset.EARLIEST enumerált típus értékét (létezik még a LATEST is), amelyet a Consumed.withOffsetResetPolicy metódussal adunk meg. Ezen enumerált típus segítségével megadhatod az eltolások visszaállításának stratégiáját minden KStream vagy KTable esetében, és ez prioritást élvez a konfigurációs eltolás visszaállítási paraméterével szemben.
GroupByKey és GroupBy
A KStream interfészen két módszer található a rekordok csoportosítására: a GroupByKey és a GroupBy. Mindkettő KGroupedTable-t ad vissza, így feltehető a kérdés: mi a különbség közöttük és mikor használjuk melyiket?
A GroupByKey módszert alkalmazzuk, amikor a KStream kulcsai már nem üresek. Ráadásul a 'rekeszelés újraigénylése' jelző sosem volt beállítva.
A GroupBy módszer azt feltételezi, hogy a csoportosításhoz megváltoztattad a kulcsokat, így a rekeszelés újraigénylésének jelzője true-ra van állítva. A GroupBy után végrehajtott műveletek, mint pl. összekapcsolás, aggregálás stb., automatikusan újbóli rekeszelést eredményeznek.
Összegzés: a lehető legkisebb alkalommal használjuk a GroupByKey-t a GroupBy helyett.
A mapValues és groupBy módszerek magukért beszélnek, nézzük meg most a sum() metódust (a src/main/java/bbejeck/model/ShareVolume.java fájlban található) (5.3. listing).
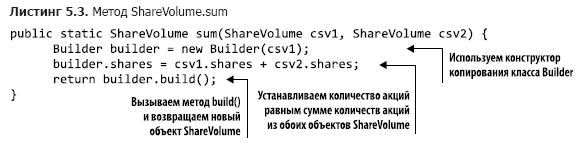
A ShareVolume.sum visszaadja a részvények forgalmának köztes összegét, míg az összes számítási lánc eredménye egy KTable objektumot képvisel. Most már érthető, hogy a KTable milyen szerepet játszik. Amikor a ShareVolume objektumok beérkeznek, a megfelelő KTable objektumban tárolódik az utolsó frissítés. Fontos ne felejtsük el, hogy a frissítések mindegyike tükröződik a korábbi shareVolumeKTable-ben, de nem minden kerül továbbküldésre.
Ezt követően ezzel a KTable-lal aggregálást végzünk (a részvények eladásának mennyisége szerint), hogy megkapjunk öt olyan vállalatot, amelyek a legnagyobb részvénykereskedelemmel rendelkeznek minden iparágban. Tevékenységeink a legelső aggregáláshoz hasonlóak lesznek.
- Továbbra is hajtsunk végre egy újabb groupBy műveletet egyes ShareVolume objektumok iparágak szerinti csoportosítására.
- Foglalkozzunk a ShareVolume objektumok összesítésével. Ezúttal az aggregáló objektum egy fix méretű prioritású sor. Ebben a fix méretű sorban csak az öt legnagyobb eladott részvényszámú cég tárolódik.
- Jelezzük a korábbi pontból származó sorokat sztring értékként, és adjuk vissza az öt legjobban eladott cég részvények száma szerint az iparágak szerint.
- Írjuk bele az eredményeket sztring formátumban a témába.
A 5.10. ábra a bejövő adatok áramlásának topológiáját mutatja. Ahogy látod, a második feldolgozási kör elég egyszerű.
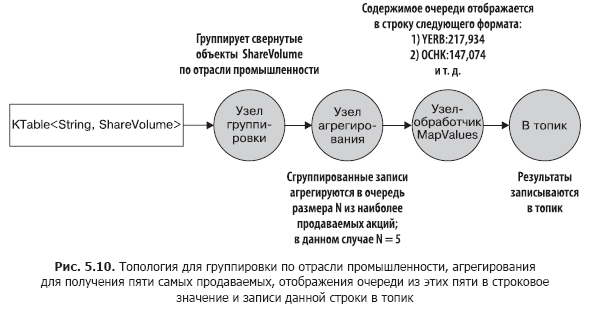
Most már, világosan megértve a második feldolgozási kör felépítését, áttérhetünk az alapkódjára (a fájlban találja: src/main/java/bbejeck/chapter_5/AggregationsAndReducingExample.java) (5.4. lista).
Ebben az inicializálóban van egy fixedQueue változó. Ez egy felhasználói objektum — adapter a java.util.TreeSet-hez, amely az N legnagyobb eredmény nyomon követésére szolgál, csökkenő sorrendben a sold részvények száma szerint.
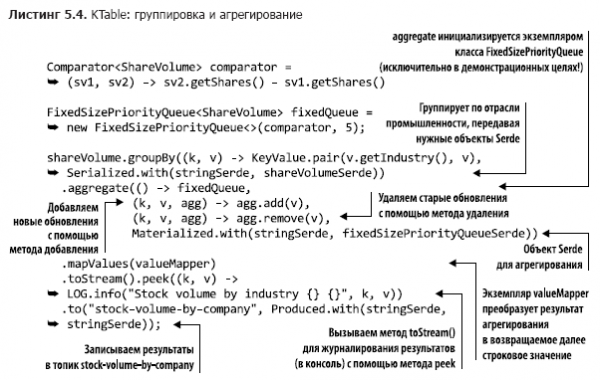
Már találkoztál a groupBy és mapValues hívásokkal, ezért nem állunk meg náluk (a KTable.toStream metódust hívjuk, mivel a KTable.print metódus elavult). De még nem láttál KTable-verziót az aggregate() metódusból, így egy kicsi időt szánunk a megvitatására.
Ahogy emlékszel, a KTable-t az jellemzi, hogy az azonos kulcsú rekordokat frissítéseknek tekinti. A KTable lecseréli a régi rekordot az újra. Az aggregálás hasonló módon történik: az utolsó azonos kulcsú rekordok aggregálódnak. Amikor egy új rekord érkezik, hozzáadódik a FixedSizePriorityQueue példányhoz a szummázó (a második paraméter az aggregate hívásában), de ha már létezik egy másik rekord ugyanezzel a kulccsal, akkor a régi rekordot eltávolítja a kivonó (a harmadik paraméter az aggregate hívásában).
Ez mindent jelent, hogy az aggregátorunk, a FixedSizePriorityQueue, valójában nem aggregálja az azonos kulcsú értékeket, hanem tárolja a legjobban eladott részvények N legmagasabb mennyiségének csúszó összegét. Minden egyes érkező rekord tartalmazza az eddig eladott részvények összesített számát. A KTable információt ad arról, hogy mely cégek részvényeit adják el a legjobban, a csúszó aggregálásra pedig minden frissítésnél nincs szükség.
Két fontos dolgot tanultunk meg:
- értékek csoportosítása a KTable-ban a közös kulcsuk szerint;
- hasznos műveletek végrehajtása ezeken a csoportosított értékeken, mint például az összegzés és az aggregálás.
Ezeknek a műveleteknek a végrehajtásának képessége fontos a Kafka Streams alkalmazáson átáramló adatok értelmének megértéséhez és annak kiderítéséhez, hogy milyen információkat hordoznak.
Összekapcsoltuk a könyv korábban tárgyalt néhány kulcsfogalmát. A 4. fejezetben arról beszéltünk, mennyire fontos a hibatűrő, lokális állapot a streamelő alkalmazás számára. Az ebben a fejezetben bemutatott első példa megmutatta, miért annyira lényeges a lokális állapot – lehetőséget biztosít arra, hogy nyomon követhessük, milyen információkat láttunk már. A lokális hozzáférés lehetővé teszi a hálózati késleltetések elkerülését, így az alkalmazás teljesítménye javul és ellenállóbbá válik a hibákkal szemben.
Bármilyen aggregációs vagy csomagolási művelet végrehajtása során meg kell adni az állapot tároló nevét. Az aggregációs és csomagolási műveletek KTable példányt adnak vissza, a KTable pedig az állapot tárolót használja a régi eredmények újakkal való helyettesítésére. Ahogy láttuk, nem minden frissítés kerül tovább a csővezetékben, és ez fontos, mert az aggregáló műveletek célja a végső információk visszanyerése. Ha nem alkalmazunk lokális állapotot, a KTable minden aggregáló és csomagoló eredményt továbbít majd.
Most a konkrét időintervallumokon belüli műveletek, például az aggregációk végrehajtására fogunk összpontosítani – az úgynevezett ablakos műveletekre.
5.3.2. Ablakos műveletek
Az előző részben megismertük a „csúszó” aggregációt és csomagolást. Az alkalmazás folyamatosan csomagolta az értékpapírok értékesítési volumenét, majd aggregálta az öt legjobban eladott tőzsdei értékpapírt.
Néha szükség van az ilyen folyamatos aggregációkra és csomagolásokra. Máskor csak egy adott időintervallumra van szükség. Például meg kell számolni, hány tőzsdei tranzakció történt egy adott cég részvényeivel az utolsó 10 percben. Vagy hogy hány felhasználó kattintott az új hirdetési bannerre az utolsó 15 percben. Az alkalmazás ilyen műveleteket többször is végrehajthat, de az eredmények csak az adott időintervallumokra (időablakokra) vonatkoznak.
A vásárló szerint számolt tőzsdei tranzakciók
A következő példában több kereskedő – legyenek azok nagyobb szervezetek vagy ügyes pénzügyi elemzők – tőzsdei tranzakcióinak nyomon követésével foglalkozunk.
Két lehetséges oka van ennek a nyomon követésnek. Az egyik az, hogy tudni kell, mit vásárolnak/eladnak a piac vezetői. Ha ezek a nagy játékosok és tapasztalt befektetők lehetőségeket látnak, érdemes követni a stratégiájukat. A másik ok az, hogy észrevegyük az esetleges illegális tranzakciók jeleit, amelyek belső információk felhasználásával történnek. Ehhez elemezni kell a nagy értékű eladási hullámok korrelációját a fontos sajtóközleményekkel.
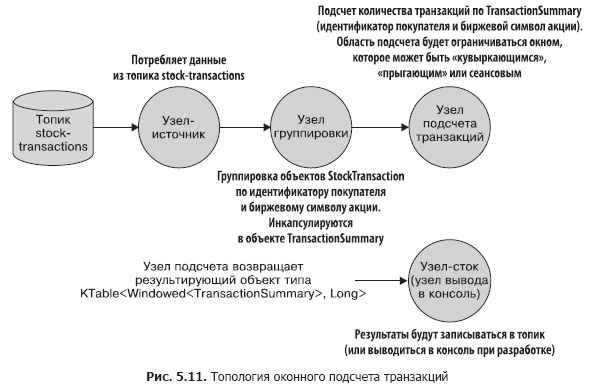
Ez a nyomon követés a következő lépésekből áll:
- adatfolyam létrehozása a stock-transactions témából;
- a bejövő rekordok csoportosítása a vásárló azonosítója és a részvény szimbóluma szerint. A groupBy metódus meghívása visszaad egy KGroupedStream osztály példányt;
- a KGroupedStream.windowedBy metódus használatával egy időablakkal korlátozott adatfolyam visszaadása, ami lehetővé teszi az ablakos aggregálást. Az ablak típusa alapján visszaadódik egy TimeWindowedKStream vagy egy SessionWindowedKStream;
- a tranzakciók számlálása az aggregálási művelethez. Az ablakos adatfolyam határozza meg, hogy egy adott rekord szerepel-e a számlálásban;
- az eredmények rögzítése a témában vagy azok kiírása a konzolra a fejlesztés során.
A program topológiája egyszerű, de egy áttekinthető ábra nem árt. Nézzük meg az 5.11. ábrát.
Ezután megvizsgáljuk az ablakos műveletek funkcionalitását és a megfelelő kódot.
Ablak típusok
A Kafka Streams-ben három típusú ablak létezik:
- ülés alapú;
- «tumbling» (felboruló);
- csúszó/«hopping» (sliding/hopping).
Hogy melyiket válasszuk, az az üzleti követelményektől függ. A «felboruló» és a «hopping» ablakok időben korlátozottak, míg a session ablakok korlátozása a felhasználói tevékenységeken alapul - a sesion(-ök) hossza kizárólag attól függ, hogy a felhasználó mennyire aktívan viselkedik. A legfontosabb, hogy ne felejtsük el, hogy minden ablak típus a rekordok dátum/idő jelölésein alapul, nem a rendszeridőn.
Ezután minden ablak típusával megvalósítjuk a topológiánkat. A teljes kódot csak az első példában mutatjuk be, a többi ablak típusnál semmi nem változik, csak az ablak művelet típusa.
Szezonális ablakok
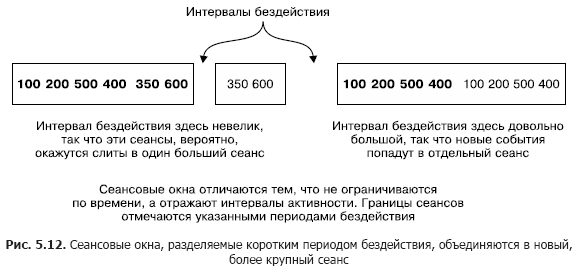
A munkamenet ablakok jelentősen eltérnek a többi típustól. Ezeket nem annyira időben korlátozzák, mint inkább a felhasználó (vagy annak a tevékenysége, akit követni szeretnél) aktivitásával. A munkamenet ablakokat tétlenségi időszakok határolják.
A 5.12-es ábra szemlélteti a munkamenet ablakok fogalmát. A kisebb munkamenet összeolvad a bal oldali munkamenettel. A jobboldali munkamenet viszont különálló lesz, mivel egy hosszabb tétlenségi időszakot követ. A munkamenet ablakok a felhasználói tevékenységek alapján épülnek fel, de időbélyegeket alkalmaznak a rekordok azonosításához, hogy melyik munkamenethez tartozik a rekord.
Munkamenet ablakok használata a tőzsdei tranzakciók nyomon követésére.
A munkamenet ablakok segítségével információt gyűjtünk a tőzsdei tranzakciókról. A munkamenet ablakok megvalósítása a 5.5-ös listingben található (amely a src/main/java/bbejeck/chapter_5/CountingWindowingAndKTableJoinExample.java fájlban található).
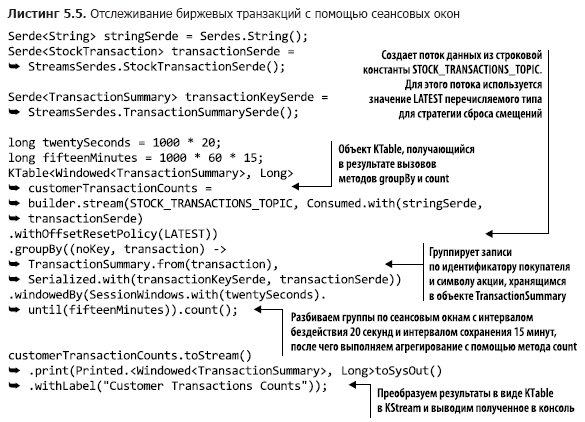
Ennek a topológiának a legtöbb műveletét már találkoztátok, ezért nincs szükség arra, hogy újra átbeszéljük őket. De van itt néhány új elem, amelyet most meg fogunk vitatni.
A groupBy műveletnél általában végrehajtanak valamilyen aggregáló műveletet (aggregálás, redukálás vagy számolás). Végrehajtható halmozott aggregálás, amely a futó összeggel működik, vagy ablakozott aggregálás, amely figyelembe veszi a rekordokat egy adott időablakban.
Az 5.5-ös listing kódja a munkamenet ablakokban lévő tranzakciók számának figyelését végzi. A 5.13-as ábrán ezeket a lépéseket lépésről lépésre elemzik.
A windowedBy(SessionWindows.with(twentySeconds).until(fifteenMinutes)) hívás révén 20 másodperces tétlenségi időszakkal és 15 perces megőrzési intervallummal rendelkező munkamenet ablakot hozunk létre. A 20 másodperces tétlenségi idő azt jelenti, hogy az alkalmazás bármilyen rekordot be fog vonni, amely a jelenlegi (aktív) munkamenet végétől vagy kezdetétől számított 20 másodpercen belül érkezik.
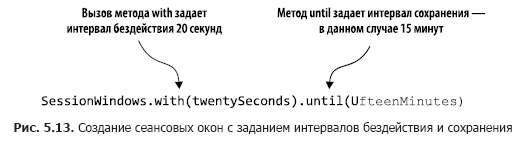
Ezután megadjuk, hogy melyik aggregációs műveletet kell végrehajtani az ülésablakban – esetünkben a count. Ha a bejövő rekord túlmutat az inaktivitási időtartamon (bármelyik oldalról a dátum/idő bélyeg mellett), akkor az alkalmazás új ülés létrehozását indítja. A megőrzési időtartam azt jelenti, hogy az ülést meghatározott ideig fenntartjuk, lehetővé téve a késlekedett adatokat, amelyek az ülés inaktivitási időtartamán kívül esnek, de még mindig csatlakoztathatók. Emellett az új ülés kezdete és vége, amely a fúzió eredményeként jön létre, a legkorábbi és legkésőbbi dátum/idő bélyeghez igazodik.
Nézzünk meg néhány rekordot a count módszerből, hogy lássuk, hogyan működnek az ülések (5.1. táblázat).
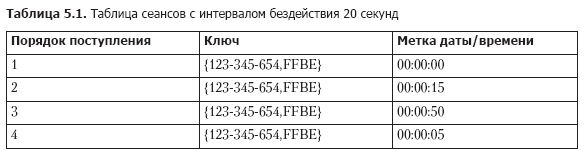
Amikor rekordok érkeznek, már létező üléseket keresünk ugyanazzal a kulccsal, ahol a befejezés ideje kisebb, mint az aktuális dátum/idő bélyeg – inaktivitási időtartam és a kezdési időpont nagyobb, mint az aktuális dátum/idő bélyeg + inaktivitási időtartam. E tekintetben a 5.1. táblázat négy rekordja egyetlen üléssé egyesül a következő módon.
1. Először érkezik 1. rekord, így a kezdési idő egyenlő a befejezési idővel, amely 00:00:00.
2. Ezután érkezik 2. rekord, és megkeressük az üléseket, amelyek 23:59:55-kor érnek véget és 00:00:35-kor kezdődnek. Megtaláljuk az 1. rekordot, és egyesítjük az 1. és 2. üléseket. Az 1. ülés kezdési idejét (korábbi) és a 2. ülés befejezési idejét (későbbi) vesszük, tehát új ülésünk 00:00:00-kor kezdődik és 00:00:15-kor ér véget.
3. Megérkezik a 3. rekord, az üléseket 00:00:30 és 00:01:10 között keressük, de egyet sem találunk. Hozzáadunk egy második ülést a 123-345-654,FFBE kulcshoz, amely 00:00:50-kor kezdődik és ér véget.
4. Megérkezik a 4. rekord, és az üléseket 23:59:45 és 00:00:25 között keressük. Ezúttal mindkét ülést – 1 és 2 – megtaláljuk. A három ülést egyesítjük egybe, a kezdési idő 00:00:00, a befejezési idő pedig 00:00:15.
A jelen fejezetből érdemes megjegyezni a következő fontos részleteket:
- az ülések nem állandó méretű ablakok. Az ülés időtartamát az adott időintervallumon belüli aktivitás határozza meg;
- az adatok dátum/idő bélyegzői meghatározzák, hogy egy esemény a meglévő ülésbe esik-e vagy az inaktivitási időszakba.
Ezután a következő ablakfajtáról fogunk beszélni – a „lahorgó” ablakokról.
„Lahorgó” ablakok
A "tumbling" window captures events that occur within a specific time interval. Imagine you need to capture all stock transactions of a certain company every 20 seconds, collecting all events during that period. At the end of the 20-second interval, the window "tumbles" and moves to a new 20-second observation window. Figure 5.14 illustrates this situation.
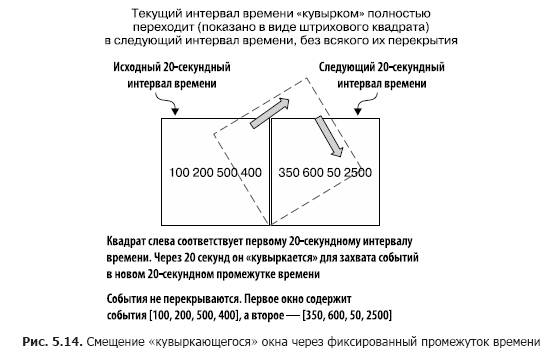
As you can see, all events that have occurred in the last 20 seconds are included in the window. Once this time interval is over, a new window is created.
Listing 5.6 contains code demonstrating the use of "tumbling" windows to capture stock transactions every 20 seconds (it can be found in the file src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java).
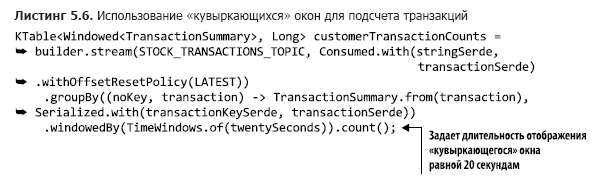
Thanks to this small change in the TimeWindows.of method call, a "tumbling" window can be used. In this example, there is no call to the until() method, so the default retention interval of 24 hours will be used.
Finally, it's time to move on to the last of the window options — "hopping" windows.
Sliding ("hopping") windows
Sliding/"hopping" windows are similar to "tumbling" ones, with one small difference. Sliding windows do not wait for the time interval to end before creating a new window to process recent events. They start new calculations after a waiting interval that is shorter than the window duration.
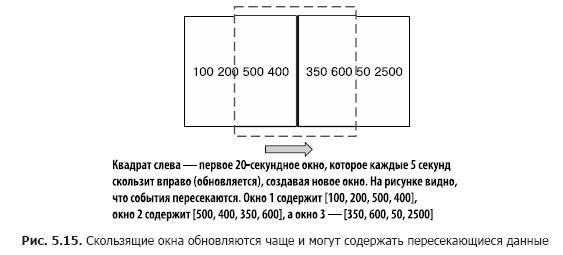
To illustrate the differences between "tumbling" and "hopping" windows, let's return to the example of counting stock transactions. Our goal remains to count the number of transactions, but we do not want to wait for the entire time interval before updating the counter. Instead, we will update the counter at shorter intervals. For example, we will still count the number of transactions every 20 seconds, but update the counter every 5 seconds, as shown in fig. 5.15. This way, we end up with three result windows that have overlapping data.
Listing 5.7 contains code for specifying sliding windows (it can be found in the file src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java).
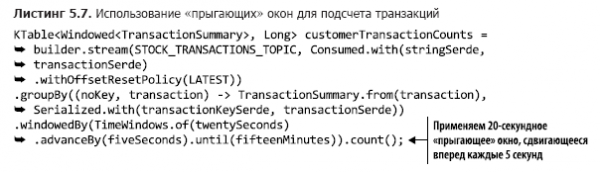
A "rolling" window can be transformed into a "jumping" one by adding a call to the advanceBy() method. In the given example, the retention interval is 15 minutes.
In this section, you have seen how to limit aggregation results with time windows. In particular, keep in mind the following three things from this section:
- the size of session windows is limited not by the time interval, but by user activity;
- "rolling" windows give insight into events within a specified time period;
- the duration of "jumping" windows is fixed, but they are often updated and may contain overlapping records across all windows.
Next, we will learn how to convert a KTable back into a KStream for joining.
5.3.3. Joining KStream and KTable objects
In chapter 4, we discussed joining two KStream objects. Now we need to learn how to join a KTable and a KStream. This may be necessary for the following simple reason. KStream is a stream of records, while KTable is a stream of record updates, but sometimes it may be needed to add additional context to the record stream using updates from the KTable.
Let’s take data about the number of stock transactions and join it with stock news based on the corresponding industries. Here’s what you need to do to achieve this, considering the existing code.
- Convert the KTable object concerning the number of stock transactions into a KStream by replacing the key with the key representing the industry corresponding to the stock symbol.
- Create a KTable object reading data from the stock news topic. This new KTable will be categorized by industries.
- Join news updates with information about the number of stock transactions by industries.
Now let's see how to implement this action plan.
Converting KTable to KStream
To convert a KTable to a KStream, the following needs to be done.
- Call the KTable.toStream() method.
- Use the KStream.map method to replace the key with the name of the industry, then extract the TransactionSummary object from the Windowed instance.
We will link these operations in a chain as follows (the code can be found in the file src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (listing 5.8).
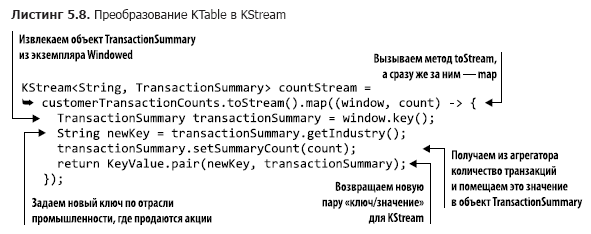
Mivel a KStream.map műveletet hajtjuk végre, a visszatérő KStream példány automatikusan újraszektionálódik, amikor kapcsolatba kerül.
Befejeztük a transzformációs folyamatot, most KTable objektumot kell létrehoznunk a tőzsdei hírek olvasásához.
KTable létrehozása a tőzsdei hírekhez
Szerencsére a KTable objektum létrehozásához elegendő egyetlen sor kód (ez a kód a src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java fájlban található) (5.9-es listázás).
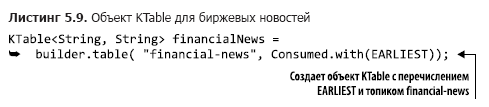
Érdemes megjegyezni, hogy nem szükséges semmilyen Serde objektumot megadni, mivel a beállításokban karakterlánc Serde-ket használnak. Az EARLIEST enumeráció alkalmazásának köszönhetően a tábla a legkorábbi bejegyzésekkel telik meg.
Most áttérhetünk az utolsó lépésre — a kapcsolatra.
A hírek frissítéseinek összekapcsolása a tranzakciószámmal
A kapcsolat létrehozása nem bonyolult. Bal oldali összekapcsolást fogunk alkalmazni arra az esetre, ha a megfelelő iparágban nincsenek tőzsdei hírek (a szükséges kód a src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java fájlban található) (5.10-es listázás).
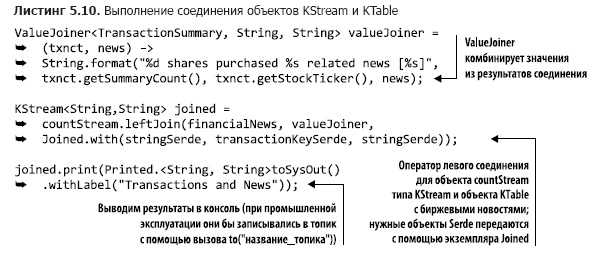
Ez a leftJoin operador elég egyszerű. A 4. fejezetből származó összekapcsolásokkal ellentétben a JoinWindow metódust nem használják, mivel KStream-KTable kapcsolat létrehozásakor minden kulcshoz csak egy bejegyzés tartozik a KTable-ben. Ez a kapcsolat időkorlát nélküli: a bejegyzés lehet a KTable-ben, vagy hiányozhat. A fő megállapítás: KTable objektumok segítségével ritkábban frissített referenciadataival gazdagíthatjuk a KStream-t.
Most egy hatékonyabb módszert fogunk megvizsgálni, amellyel gazdagíthatjuk a KStream eseményeit.
5.3.4. GlobalKTable objektumok
Ahogy látható, szükség van az eseményfolyamok gazdagítására vagy kontextusok hozzáadására. A 4. fejezetben két KStream objektum összekapcsolását láttuk, míg az előző részben a KStream és KTable összekapcsolását. Minden ezekben az esetekben szükséges a folyamat újraszektionálása, amikor a kulcsokat új típusra vagy értékre térképezzük. Néha a szekcionálás kifejezetten történik, máskor pedig a Kafka Streams automatikusan végzi. Az újraszekcionálás szükséges, mivel a kulcsok megváltoztak, és a bejegyzéseknek új szekciókban kell státuszt kapniuk, különben a kapcsolat lehetetlenné válik (ez a 4. fejezetben, az „Adatok újraszektionálása” című szakaszban volt tárgyalva, a 4.2.4. alszakaszban).
A többszörös szekcionálásnak ára van
A többszörös szekcionálás költségeket von maga után — további erőforrásköltségeket a közbenső témák létrehozásához, a megismételt adatok tárolásához egy másik témában; ez a késleltetés növekedését is jelenti az írási és olvasási folyamatok során. Ezen kívül, ha több aspektus vagy dimenzió szerint kell csatlakozni, akkor a kapcsolatokat láncba kell szervezni, új kulcsokkal kell megjeleníteni a bejegyzéseket, és újra kell végezni a többszörös szekcionálást.
Kapcsolódás kisebb adathalmazokhoz
Bizonyos esetekben a csatlakoztatni kívánt hivatkozási adatok volumene viszonylag kicsi, így a teljes másolataik elférnek lokálisan minden csomóponton. Az ilyen helyzetekhez a Kafka Streams-ben GlobalKTable osztály áll rendelkezésre.
A GlobalKTable példányok egyediek, mivel az alkalmazás minden adatot replikál minden csomóponton. Mivel minden csomóponton megtalálható minden adat, nincs szükség arra, hogy az eseményfolyamot a hivatkozási adatok kulcsa szerint szekcionáljuk, hogy az minden szekció számára elérhető legyen. A GlobalKTable objektumok segítségével kulcs nélküli csatlakoztatásokat is végezhetünk. Térjünk vissza az egyik korábbi példánkhoz, hogy bemutathassuk ezt a képességet.
KStream objektumok csatlakoztatása GlobalKTable objektumokkal
Az 5.3.2 alfejezetben ablakos aggregációt hajtottunk végre a tőzsdei tranzakciókról a vásárlók szerint. Az aggregálás eredményei a következőképpen néztek ki:
{customerId='074-09-3705', stockTicker='GUTM'}, 17
{customerId='037-34-5184', stockTicker='CORK'}, 16
Bár ezek az eredmények megfeleltek a kitűzött célnak, hasznosabb lenne, ha a vásárló neve és a cég teljes neve is megjelenne. A vásárló nevének és a cég nevének hozzáadása érdekében a szokásos csatlakoztatásokat lehet alkalmazni, de ez két kulcsleképezést és újabb szekcionálást igényel. A GlobalKTable segítségével elkerülhetjük ezeket a költségeket.
Ehhez a 5.11-es listingből a countStream objektumot fogjuk használni (a megfelelő kód megtalálható a src/main/java/bbejeck/chapter_5/GlobalKTableExample.java fájlban), és összekapcsoljuk két GlobalKTable objektummal.
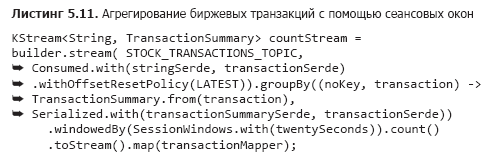
Már beszéltünk erről korábban, így nem fogom megismételni. De megjegyzem, hogy a toStream().map funkcióban szereplő kód az olvashatóság érdekében objektum-funkcióvá van absztrahálva, nem beágyazott lambda-kifejezéssé.
A következő lépés a GlobalKTable két példányának bejelentése (a bemutatott kód a src/main/java/bbejeck/chapter_5/GlobalKTableExample.java fájlban található) (5.12. listázás).
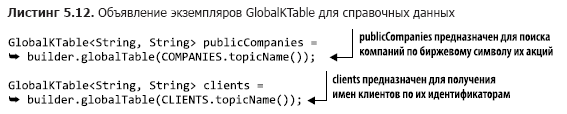
Vegye figyelembe, hogy a témák neveit felsorolt típusok segítségével írják le.
Most, hogy minden komponenst előkészítettünk, meg kell írni a csatlakozási kódot (amely a src/main/java/bbejeck/chapter_5/GlobalKTableExample.java fájlban található) (5.13. listázás).
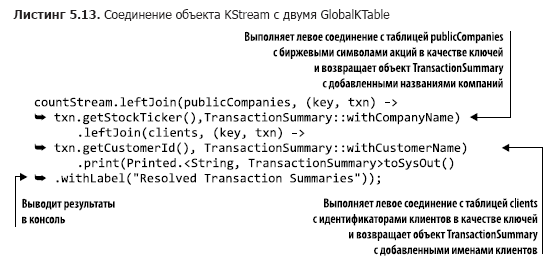
Bár a kódban két csatlakozás található, azok láncba vannak szervezve, mivel külön-külön egyikük eredményei sem kerülnek felhasználásra. Az eredmények az egész művelet végén jelennek meg.
A fenti csatlakozási művelet végrehajtásakor az alábbi típusú eredményeket fogja kapni:
{customer='Barney, Smith' company="Exxon", transactions= 17}A lényeg nem változott, de ezek az eredmények érthetőbbek.
Ha a 4. fejezetet is számoljuk, már láttad a csatlakozások néhány típusát működés közben. Ezek a 5.2. táblázatban szerepelnek. Ez a táblázat az 1.0.0 verziójú Kafka Streams-re alkalmazható csatlakozási lehetőségeket tükrözi; a jövőbeli kiadásokban valószínűleg történnek változások.
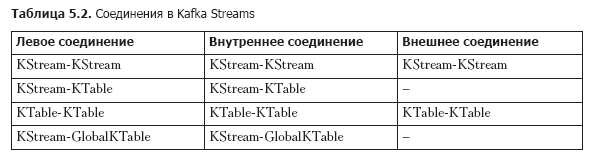
Összegzésül emlékeztetném a lényeget: az eseményfolyamokat (KStream) és a frissítési folyamokat (KTable) helyi állapot felhasználásával lehet összekapcsolni. Ezenkívül, ha a referenciaadatok mérete nem túl nagy, a GlobalKTable objektummal is élhetünk. A GlobalKTable minden szakaszt replikál a Kafka Streams alkalmazás összes csomópontjára, ezáltal biztosítva, hogy az összes adat elérhető legyen, függetlenül attól, hogy melyik szakaszhoz tartozik a kulcs.
Következő lépésben meg fogjuk nézni a Kafka Streams azon lehetőségét, amely lehetővé teszi az állapotváltozások megfigyelését anélkül, hogy adatokat kellene fogyasztani a Kafka témából.
5.3.5. Lekérdezhető állapot
Már végeztünk néhány műveletet állapotokkal, és mindig az eredményeket a konzolra írtuk (fejlesztési célokra) vagy a témába rögzítettük (ipari célokra). Az eredmények témába való írásakor a Kafka fogyasztót kell használni azok megtekintésére.
Ezekből a témákból kiolvasható adatok a materializált nézetek (materialized views) egy formájának tekinthetők. Céljainkhoz a Wikipedia definícióját használhatjuk a materializált nézetről: „… egy adatbázis fizikai objektuma, amely egy lekérdezés végrehajtásának eredményeit tartalmazza. Például lehet távoli adatok helyi másolata, vagy sorok és/vagy oszlopok részhalmaza egy táblázatból, vagy aggregálással nyert pivot táblázat” (https://en.wikipedia.org/wiki/Materialized_view).
A Kafka Streams lehetővé teszi interaktív lekérdezések (interactive queries) végrehajtását az állapot tárolókra, ami lehetővé teszi ezen materializált nézetek közvetlen olvasását. Fontos megjegyezni, hogy az állapot tárolóra való lekérdezés „csak olvasási” műveletet jelent. Ennek köszönhetően nem kell izgulnia, hogy véletlenül összezavarja az állapotot az adatok alkalmazás általi feldolgozása során.
A közvetlen lekérdezések lehetősége az állapot tárolókhoz nagy jelentőséggel bír. Ez lehetővé teszi, hogy információs paneleket hozzunk létre anélkül, hogy először adatokat kellene szerezni a Kafka fogyasztótól. Az alkalmazás hatékonyságát is növeli, mivel nem szükséges újra írni az adatokat:
- mivel az adatok lokalitása lehetővé teszi, hogy gyorsan hozzáférjünk hozzájuk;
- elkerülhető az adatok duplikációja, mivel nem íródnak ki egy külső tárolóba.
A legfontosabb dolog, amit szeretnék, ha megjegyezne: a lekérdezéseket közvetlenül az állapotból lehet végezni az alkalmazásból. Az a lehetőség, amit ez nyújt, felbecsülhetetlen. Ahelyett, hogy adatokat fogyasztana a Kafka-ból és feljegyzéseket tárolna az adatbázisban az alkalmazás számára, közvetlen lekérdezéseket végezhet az állapot tárolókra ugyanazzal az eredménnyel. A közvetlen lekérdezések kevesebb kódot (nincs fogyasztó) és kevesebb szoftvert igényelnek (nincs szükség adatbázis táblára az eredmények tárolásához).
Ebben a fejezetben jelentős mennyiségű információt tárgyaltunk, ezért most átmenetileg leállítjuk a beszélgetést az állapot tárolók interaktív lekérdezéseivel kapcsolatban. De ne aggódjon: a 9. fejezetben egy egyszerű alkalmazást fogunk létrehozni – egy információs irányítópultot interaktív lekérdezésekkel. Az interaktív lekérdezések bemutatásához és a Kafka Streams alkalmazásokba való beépítés lehetőségeihez néhány példát fogunk felhasználni ebből és az előző fejezetből.
Összefoglaló
- A KStream objektumok az eseményfolyamokat jelképezik, amelyek összehasonlíthatók az adatbázisba való bejegyzésekkel. A KTable objektumok a frissítések folyamait képviselik, és inkább hasonlítanak az adatbázis frissítéseire. A KTable objektumok mérete nem növekszik; a régi bejegyzéseket újakkal helyettesítik.
- A KTable objektumok szükségesek az aggregáló műveletekhez.
- Az ablakműveletek segítségével az aggregált adatokat időkeretekre lehet bontani.
- A GlobalKTable objektumok lehetővé teszik a referenciadatok elérését az alkalmazás bármely pontjáról, függetlenül a szekciók szerinti felosztástól.
- KStream, KTable és GlobalKTable objektumok közötti összekapcsolások lehetségesek.
Eddig a KStream magas szintű DSL használatával készítettük a Kafka Streams alkalmazásokat. Bár a magas szintű megközelítés lehetővé teszi, hogy tiszta és tömör programokat készítsünk, használata bizonyos kompromisszumokat jelent. A DSL KStream használata a kód tömörségének növelését, de a kontroll csökkentését jelenti. A következő fejezetben megvizsgáljuk az alacsony szintű csomópont-feldolgozó API-t, és kipróbálunk más kompromisszumokat. A programok hosszabbak lesznek, mint eddig, de lehetőségünk nyílik szinte bárminemű feldolgozó csomópont létrehozására, amire csak szükségünk lehet.
→ A könyv részletesebben is megismerhető itt:
→ A Habr látogatói számára 25% kedvezmény a kuponnal — Kafka Streams
→ A nyomtatott könyv kifizetését követően elektronikus könyvet küldünk e-mailben.
Forrás: habr.com
