

Ez a redundancia
A redundancia kódokat* széles körben alkalmazzák a számítógépes rendszerekben az adatok tárolásának megbízhatóságának növelésére. A Yandexnél számos projektben használják őket. Például a redundancia kódok alkalmazása a replikáció helyett a belső objektum tárolónkban milliókat takarít meg anélkül, hogy csökkentené a megbízhatóságot. De a széleskörű elterjedés ellenére ritkán található érthető leírás arról, hogyan működnek a redundancia kódok. Azok, akik szeretnék megérteni, körülbelül a következővel találkoznak (a ):
A nevem Vadim, a Yandexnél az MDS belső objektum tároló fejlesztésével foglalkozom. Ebben a cikkben egyszerű szavakkal fogom leírni a redundancia kódok (Reed-Solomon kódok és LRC) elméleti alapjait. Elmondom, hogyan működik ez, bonyolult matematika és ritka kifejezések nélkül. A végén példákat hozok a redundancia kódok Yandexbeli használatára.
Néhány matematikai részletet nem fogok részletesen tárgyalni, de linkeket fogok adni azok számára, akik szeretnének mélyebben elmerülni a témában. Megjegyzem továbbá, hogy egyes matematikai meghatározások nem lehetnek szigorúak, mivel a cikk nem matematikusoknak készült, hanem mérnököknek, akik szeretnék megérteni a kérdés lényegét.
* Az angol nyelvű szakirodalomban a redundancia kódokat gyakran erasure code-nak nevezik.
1. A redundancia kódok lényege
A redundancia kódok lényege rendkívül egyszerű: az adatok tárolása (vagy továbbítása) úgy, hogy azok ne vesszenek el hibák (például lemezhibák, adatátviteli hibák stb.) esetén.
A legtöbb* redundancia kódban az adatokat n blokkra osztják, és m redundancia blokkot számítanak hozzájuk, így összesen n + m blokkból áll. A redundancia kódokat úgy építik fel, hogy n adatblokk helyreállítható legyen csak n + m blokk egy részének felhasználásával. Ezután csak a blokk kódokkal foglalkozunk, vagyis azokkal, amelyekben az adatokat blokkokra osztják.
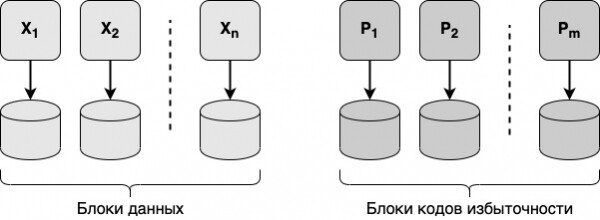
Ahhoz, hogy helyreállítsuk az összes n adatblokkot, minimum n az n + m blokkból szükséges, mivel nem lehet n blokkot előállítani, ha csak n-1 blokkunk van (ebben az esetben 1 blokkot a „levegőből” kellene szerezni). Elégségesek-e n tetszőleges blokk az n + m blokk közül az összes adat helyreállításához? Ez a redundancia kódjainak típusától függ, például a Reed-Solomon kódok lehetővé teszik, hogy tetszőleges n blokk segítségével helyreállítsuk az összes adatot, míg az LRC redundancia kódok ezt nem mindig teszik lehetővé.
Adattárolás
Az adattároló rendszerekben általában minden adatblokk és redundancia kód blokk külön lemezen tárolódik. Így, ha egy tetszőleges lemez meghibásodik, az eredeti adatok még mindig helyreállíthatók és olvashatók. Az adatok akár több lemez egyidejű meghibásodása esetén is helyreállíthatók.
Adatátvitel
A redundancia kódok megbízható adatátvitelre használhatók megbízhatatlan hálózatokon. Az átvitt adatokat blokkokra bontják, és ehhez kódokat számítanak. Az adatblokkok mellett a redundancia kód blokkjait is átviszik a hálózaton. Ha hibák lépnek fel tetszőleges blokkokban (akár bizonyos számú blokkig), az adatokat akkor is hibamentesen át lehet vinni a hálózaton. A Reed-Solomon kódokat például optikai kommunikációs vonalakon és műholdas kommunikációban használják az adatok átvitelére.
* Vannak olyan redundancia kódok is, amelyek nem bontják blokkokra az adatokat, például a Hamming-kódok és a CRC kódok, amelyeket széles körben használnak az Ethereum hálózatokban történő adatátvitelhez. Ezek a zajtűrő kódok hibák észlelésére szolgálnak, nem azok javítására (a Hamming-kód részben hibák javítására is alkalmas).
2. Reed-Solomon kódok
A Reed-Solomon kódok a legszélesebb körben elterjedt redundancia kódok közé tartoznak, amelyeket még az 1960-as években találtak ki, és először az 1980-as években alkalmaztak széles körben a CD-k sorozatgyártásában.
A Reed-Solomon kódok megértéséhez két kulcskérdés tartozik: 1) hogyan állítsunk elő redundancia kód blokkokat; 2) hogyan állítsuk helyre az adatokat redundancia kód blokkok segítségével. Keressük meg a válaszokat ezekre.
A további egyszerűsítés érdekében tegyük fel, hogy n=6 és m=4. Más sémák hasonlóan kezelhetők.
Hogyan állítsunk elő redundancia kód blokkokat
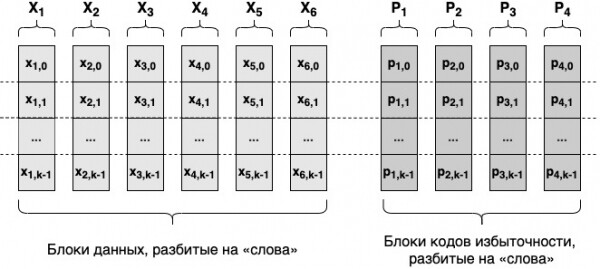
Minden paritásblokkot függetlenül kell kezelni. Minden paritásblokk kiszámításához az összes n adatblokkot használjuk. Az alábbi ábrán az X1-X6 az adatblokkok, a P1–P4 pedig a paritásblokkok.
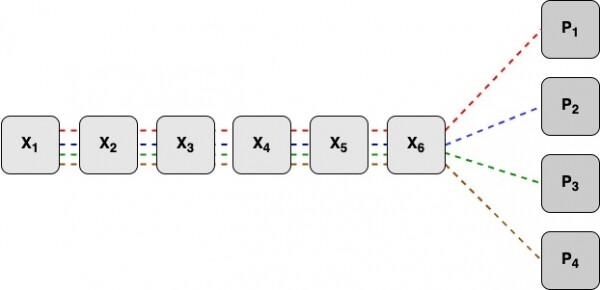
Minden adatblokk azonos méretű kell legyen, a kiegyenlítést zéró bitek használatával lehet elérni. A létrejövő paritásblokkok ugyanolyan méretűek lesznek, mint az adatblokkok. Minden adatblokkot szavakra bontunk (például 16 bitre). Tegyük fel, hogy az adatblokkokat k szóval osztottuk fel. Ekkor az összes paritásblokkot szintén k szóra bontják.
Az i-edik paritásblokk szavának kiszámításához az összes adatblokk i-edik szavát használják. Ezen a képleten keresztül számítják ki:
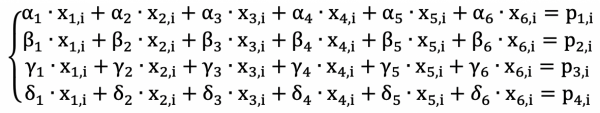
Itt az x értékek az adatblokkok szavai, a p értékek a paritásblokkok szavai, minden alfa, béta, gamma és delta - különlegesen megválasztott számok, amelyek az összes i-ra érvényesek. Azonnal meg kell említeni, hogy ezek az értékek nem szokványos számok, hanem Galois-mezők elemei. A +, -, *, / műveletek nem a megszokott műveletek, hanem a Galois-mezők elemein végzett speciális műveletek.
Miért szükségesek a Galois-mezők
Első pillantásra úgy tűnik, hogy ez egyszerű: az adatokat blokkokra bontjuk, a blokkokat szavakra, majd az adatblokkok szavaival számítjuk ki a paritásblokkok szavait - így kapjuk meg a paritásblokkokat. Általában ez így működik, de a részletekben rejlik a buktató:
- Amint azt említettem, a szó mérete fix, a mi példánkban 16 bit. A Reed-Solomon kódokhoz tartozó képletek olyanok, hogy a szokásos egész számok használata esetén a p számításának eredménye nem ábrázolható a megengedett méretű szóval.
- Az adatok visszaállításakor a fenti képleteket egy egyenletrendszerként kezelik, amelyet meg kell oldani az adatok helyreállításához. A megoldási folyamat során előfordulhat, hogy egészeket kell osztani egymással, aminek eredménye egy valós szám, amit nem lehet pontosan ábrázolni a számítógép memóriájában.
Ezek a problémák megakadályozzák, hogy a Reed-Solomon kódok egész számokat használjanak. A probléma megoldása egyedi, a következőképpen lehet leírni: találjuk ki azokat a speciális számokat, amelyeket a megfelelő hosszúságú szavakkal (például 16 bit) lehet ábrázolni, és amelyekkel végzett összes művelet (összeadás, kivonás, szorzás, osztás) szintén a számítógép memóriájában a megfelelő hosszúságú szavakkal lesz ábrázolva.
Az ilyen »speciális« számokat a matematika régóta tanulmányozza, mezőknek hívják őket. A mező olyan elemek halmaza, amelyekre meghatározott összeadási, kivonási, szorzási és osztási műveletek vonatkoznak.
A Galois-mezők* olyan mezők, amelyek esetében minden műveletnek (+, -, *, /) egyértelmű és egyedi eredménye van bármely két mezőelem számára. A Galois-mezőket a 2 hatványainak számához lehet felépíteni: 2, 4, 8, 16 stb. (valójában bármely prímszám p hatványai, de a gyakorlatban csak a 2 hatványai érdekelnek minket). Például, 16 bit méretű szavak esetén ez a mező 65 536 elemet tartalmaz, bármely pár esetében megtalálható az összes művelet (+, -, *, /) eredménye. Az x, p, alfa, béta, gamma, delta értékek a fenti egyenletekben a számítások számára Galois-mezőelemeknek tekinthetők.
Tehát rendelkezésünkre áll egy egyenletrendszer, amely segítségével redundancia kódblokkokat tudunk létrehozni egy megfelelő számítógépes program írásával. Ezen egyenletek segítségével az adatok helyreállítását is végre lehet hajtani.
* Ez nem szigorú definíció, inkább egy leírás.
Hogyan lehet visszaállítani az adatokat
A helyreállításra akkor van szükség, ha az n + m blokkból néhány blokknak hiányzik. Ez lehet adatblokk vagy redundancia kódblokk is. Az adatblokk és/vagy a redundancia kódblokkok hiánya azt jelenti, hogy a fenti egyenletekben az adott x és/vagy p változók ismeretlenek.
A Reed-Solomon kódok egyenletei egy egyenletrendszerként tekinthetők, ahol minden alfa, béta, gamma, delta — konstans értékek, minden x és p, a rendelkezésre álló blokkoknak megfelelően — ismert változók, míg a többi x és p — ismeretlen.
Például, tegyük fel, hogy az 1., 2., 3. adatblokkok és a 2. redundancia kódblokk nem elérhető, akkor az i. szavak csoportjára a következő egyenletrendszer vonatkozik (az ismeretlenek pirossal megjelölve):
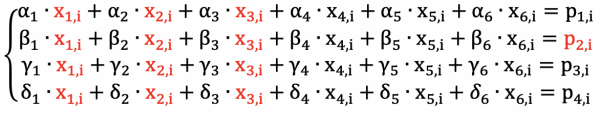
Rendelkezünk négy ismeretlent tartalmazó, négy egyenletből álló rendszerrel, tehát meg tudjuk oldani, és vissza tudjuk állítani az adatokat!
Ez a rendszer számos következtetést von le az adatok helyreállításáról a Reed-Solomon kódok esetében (n adatblokk, m redundáns kódbloock):
- Az adatok bármely m blokk vagy annál kevesebb elvesztése esetén visszaállíthatók. Ha m+1 blokk vagy több veszik el, az adatokat nem lehet visszaállítani: nem lehet megoldani m egyenletet m + 1 ismeretlennel.
- Még egy blokk adat visszaállításához is bármely n megmaradt blokkot használni kell, bármely redundáns kódot felhasználva.
Mit érdemes még tudni
A fenti leírásban számos fontos kérdést érintettem, amelyek mélyebb matematikai megértést igényelnek. Így például nem beszélek a következőkről:
- A Reed-Solomon kódok egyenletrendszerének (egyetlen) megoldással kell rendelkeznie bármely ismeretlen kombináció esetén (legfeljebb m ismeretlennel). E követelmény alapján választják ki az alfa, béta, gamma és delta értékeket.
- Meg kell tanulni automatikusan felépíteni (attól függően, hogy mely blokkok nem elérhetők) és megoldani az egyenletrendszert.
- Fel kell építeni a Galois-mezőt: a szó méretének ismeretében képesnek kell lennünk meghatározni bármely művelet (+, -, *, /) eredményét bármely két elem esetén.
A cikk végén hivatkozások találhatók az ezekhez a fontos kérdésekhez kapcsolódó irodalomra.
Az n és m kiválasztása
Hogyan válasszuk meg az n-t és m-t a gyakorlatban? A gyakorlatban az adattároló rendszerek redundáns kódokat használnak a helymegtakarítás érdekében, ezért m-t mindig n alatt választják. A pontos értékek számos tényezőtől függenek, beleértve:
- Az adatok tárolásának megbízhatósága. Minél nagyobb m, annál több lemez meghibásodását tudja elviselni, tehát a megbízhatóság magasabb.
- A tárolás redundanciája. Minél magasabb az m / n arány, annál nagyobb lesz a tárolás redundanciája, és annál drágább lesz a rendszer.
- A kérések feldolgozási ideje. Minél nagyobb a n + m összeg, annál hosszabb időt vesz igénybe a kérésekre adott válasz. Mivel az adatok olvasásához (visszaállítás közben) n blokkot kell olvasni, amelyek n különböző lemezen tárolódnak, az olvasási időt a leglassabb lemez határozza meg.
Ezenkívül az adatok több adatközpontban való tárolása további korlátokat szab n és m kiválasztására: ha egy adatközpont leáll, az adatoknak továbbra is olvashatónak kell lenniük. Például, ha az adatokat 3 adatközpontban tárolják, a következő feltételnek kell teljesülnie: m >= n/2, különben lehetséges, hogy az adatok nem lesznek olvashatóak egy adatközpont leállása esetén.
3. LRC — Helyi Rekonstrukciós Kódok
Az adatok Reed-Solomon kódokkal való helyreállításához n tetszőleges adatblokkot kell használni. Ez nagyon jelentős hátrány a disztribúlt adattároló rendszerek számára, mivel egy meghibásodott lemezről való adathelyreállítás során a legtöbb másik lemezről is adatokat kell olvasni, ezzel pedig nagy további terhelést okozva a lemezeken és a hálózaton.
A leggyakrabban előforduló hibák — az egyik adatblokk elérhetetlensége egy lemez meghibásodása vagy túlterheltsége miatt. Van-e mód a helyreállítási folyamat fölösleges terhelésének csökkentésére ilyen (leggyakoribb) esetben? Kiderül, hogy van: erre kifejezetten a LRC többletkódjai léteznek.
Az LRC (Helyi Rekonstrukciós Kódok) — a Microsoft által a Windows Azure Storage alkalmazásához kifejlesztett többletkódok. Az LRC ötlete rendkívül egyszerű: az összes adatblokkot két (vagy több) csoportra kell bontani, és az egyes csoportok számára külön számítani a többletkódok egy részét. Így a többletkódok egy része az összes adatblokk (az LRC-ben globális többletkódnak nevezik) segítségével kerül kiszámításra, míg egy részét az adatok egyik két csoportjának segítségével (ezeket helyi többletkódoknak hívják).
Az LRC három számmal jelölhető: n-r-l, ahol n — az adatblokkok száma, r — a globális többletkód blokkok száma, l — a helyi többletkód blokkok száma. Egy adatblokk elérhetetlensége esetén az adatok olvasásához csak n/l blokkot kell olvasni — ez l-szer kevesebb, mint a Reed-Solomon kódoknál.
Például vegyük az LRC 6-2-2 sémát. X1–X6 — 6 adatblokk, P1, P2 — 2 globális többletkód blokk, P3, P4 — 2 helyi többletkód blokk.
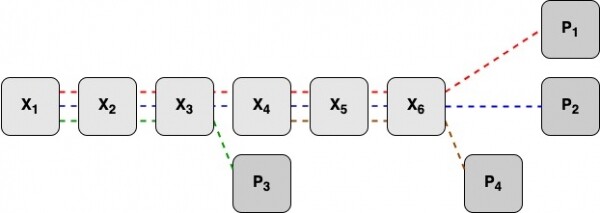
A P1, P2 többletkód blokkokat az összes adatblokk segítségével számítják. A P3 többletkód blokk az X1–X3 adatblokkok segítségével, a P4 többletkód blokk pedig az X4–X6 adatblokkok segítségével kerül kiszámításra.
A többi LRC-ben történik, hasonlóan a Reed-Solomon kódokhoz. A hibajavító kódok szavainak kiszámításához az alábbi egyenletek szükségesek:
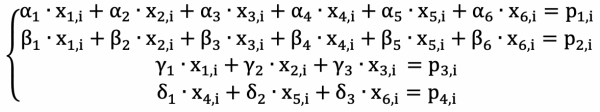
Az alfa, béta, gamma és delta számok meghatározásához több feltételt kell teljesíteni, amelyek biztosítják az adatok helyreállításának lehetőségét (vagyis az egyenletrendszer megoldását). Részletesebben erről olvashat itt: .
A gyakorlatban a P3, P4 helyi redundancia kódok számításához is alkalmazzák az XOR műveletet.
Az LRC egyenletrendszeréből számos következtetés adódik:
- Bármely egy adatblokk helyreállításához elegendő n/l blokkot (n/2 a példa esetén) elolvasni.
- Ha r + l blokk nem elérhető, és mindezek a blokkok egy csoportba tartoznak, akkor az adatokat nem lehet helyreállítani. Ezt könnyen meg lehet magyarázni egy példán. Tegyük fel, hogy az X1–X3 és P3 blokkok nem elérhetőek: ez r + l blokkokat jelent egy csoportban, ami a mi esetünkben 4. Akkor van egy 3 egyenletből álló rendszere 4 ismeretlennel, amit nem lehet megoldani.
- Minden más esetben, amikor r + l blokk elérhetetlen (amikor minden csoportból legalább egy blokk elérhető), az LRC-ben az adatok helyreállíthatók.
Így az LRC előnyben van a Reed-Solomon kódokkal szemben az adatok helyreállításában egyes hibák után. A Reed-Solomon kódokhoz viszonyítva egy adatblokk helyreállításához n blokkra van szükség, míg LRC-hez elegendő n/l blokk (n/2 a példa esetén). Másrészt az LRC hátrányban van a Reed-Solomon kódokkal szemben a megengedett hibák maximális számában. A fentiekben a Reed-Solomon kódok bármely 4 hiba mellett képesek helyreállítani az adatokat, míg az LRC-nél 4 hibából 2 kombináció esetén lehetetlen az adatok helyreállítása.
A fontosabb kérdés a konkrét helyzettől függ, de gyakran az LRC által biztosított redundáns terhelés csökkentése felülmúlja a kicsit alacsonyabb tárolási megbízhatóságot.
4. Egyéb redundancia kódok
A Reed-Solomon és LRC kódokon kívül sok más redundancia kód is létezik. Különböző redundancia kódok különféle matematikát alkalmaznak. Íme néhány egyéb redundancia kód:
- Redundancia kód XOR operátorral. Az XOR műveletet n adatblokkon hajtják végre, így 1 redundancia blokk keletkezik, azaz n+1 séma (n adatblokk, 1 redundancia kód). Használják , ahol az adatblokkokat és a redundancia kódokat ciklikusan minden lemezen tárolják az adattárolóban.
- Az even-odd algoritmus, amely az XOR műveleten alapul. Lehetővé teszi 2 redundáns kódblokk létrehozását, azaz az n+2 séma szerint.
- A STAR algoritmus, amely az XOR műveleten alapul. Lehetővé teszi 3 redundáns kódblokk létrehozását, azaz az n+3 séma szerint.
- A Pyramide kódok — további redundáns kódok a Microsoft-tól.
5. Használat a Yandexben
A Yandex számos infrastruktúra projektje alkalmaz redundáns kódokat az adatok megbízható tárolására. Íme néhány példa:
- A MDS belső objektum tárolója, amelyről az írás elején beszéltem.
- — A Yandex MapReduce rendszere.
- (Yandex DataBase) — elosztott newSQL adatbázis.
A MDS-ben LRC redundáns kódokat használnak, 8-2-2 séma szerint. A redundáns kódokkal ellátott adatokat 12 különböző lemezen tárolják, különböző szervereken, 3 különböző adatközpontban: 4 szerver minden adatközpontban. További információ erről: .
Az YT-ben a Reed-Solomon kódokat (6-3 séma), amelyeket elsőként valósítottak meg, és az LRC redundáns kódokat (12-2-2 séma) használják, ahol az LRC az preferált tárolási mód.
Az YDB-ben even-odd alapú redundáns kódok találhatók (4-2 séma). Az YDB redundáns kódjairól már .
A különböző redundáns kódok alkalmazása eltérő követelményeknek köszönhető, amelyeket a rendszerek támasztanak. Például az MDS-ben az LRC által tárolt adatok hármas adatközpontban helyezkednek el. Fontos számunkra, hogy az adatok olvashatók maradjanak, amikor bármelyik adatközpont leáll, ezért a blokkokat úgy kell elosztani az adatközpontok között, hogy bármelyik adatközpont elérhetetlensége esetén a nem elérhető blokkok száma ne haladja meg a megengedettet. A 8-2-2 sémában minden adatközpontban 4 blokk helyezhető el, így bármely adatközpont lekapcsolása esetén 4 blokk lesz elérhetetlen, és az adatok olvashatóak maradnak. Bármilyen sémát is válasszunk a 3 adatközpont elosztásához, a redundancia tárolásának minimuma mindig (r + l) / n >= 0,5, azaz a tárolási redundancia minimum 50% lesz.
Az YT helyzete más: minden YT klaszter teljes egészében egy adatközpontban helyezkedik el (különböző klaszterek különböző adatközpontokban), ezért ott nincs ilyen korlátozás. A 12-2-2 séma 33%-os redundanciát biztosít, tehát az adatok tárolása olcsóbbá válik, emellett 4 lemez egyidejű lekapcsolását is túlélhetik, akárcsak a MDS séma.
Még sok olyan jellemző van a redundáns kódok adatstorálási és -feldolgozási rendszerekben való alkalmazásáról, mint például az adatok helyreállításának bonyodalmai, a helyreállítás időtartamának hatása a lekérdezések végrehajtási idejére, valamint az adatok rögzítésének sajátosságai. Külön szeretnék beszélni ezekről és más gyakorlati alkalmazások jellemzőiről, ha a téma érdekes.
6. Hivatkozások
- Cikkek sorozata Reed-Solomon kódokról és Galois mezőkről:
Ezek a matematikát érthető nyelven, részletesebben tárgyalják. - Cikk a Microsofttól az LRC-ről:
A 2. szakaszban röviden kifejtik az elméletet, majd a gyakorlatban alkalmazott LRC tapasztalatait vizsgálják. - Even-odd séma:
- STAR séma:
- Pyramid kódok:
- MDS alapú redundáns kódok:
- YT alapú redundáns kódok:
- YDB alapú redundáns kódok:
Forrás: habr.com
