

Szeretnék bemutatni egy érdekes mechanizmust a disztribútt rendszerek konfigurációjának kezelésében. A konfiguráció közvetlenül a fordítható nyelven (Scala) található, biztonságos típusok használatával. Ebben a bejegyzésben egy ilyen konfiguráció példáját elemezzük, és különböző szempontokat vizsgálunk meg a fordítható konfiguráció általános fejlesztési folyamatba történő integrálásával kapcsolatban.
()
Bevezetés
Egy megbízható disztribútt rendszer felépítése azt jelenti, hogy minden csomóponton helyes konfigurációt kell alkalmazni, amely szinkronizálva van a többi csomóponttal. Általában DevOps technológiákat (terraform, ansible vagy hasonlót) használnak a konfigurációs fájlok automatikus generálására (gyakran mindegyik csomóponthoz saját fájlokat). Azt is szeretnénk biztosítani, hogy minden interakcióban részt vevő csomóponton azonos protokollok (beleértve az azonos verziót is) legyenek használatban. Ellenkező esetben a disztribútt rendszerünkben inkompatibilitás állna fenn. A JVM világában egy ilyen követelmény következményeként elengedhetetlen, hogy mindenhol ugyanazt a protokollüzeneteket tartalmazó könyvtárverziót használjuk.
Mi a helyzet a disztribútt rendszerek tesztelésével? Természetesen feltételezzük, hogy minden komponens esetében rendelkezésre állnak unit tesztek, mielőtt átmenünk az integrációs tesztelésre. (Annak érdekében, hogy a tesztelési eredményeket a futási időre extrapolálhassuk, biztosítanunk kell, hogy a tesztelési szakaszban és a futási időben azonos könyvtárkészlet álljon rendelkezésre.)
Integrációs tesztek során gyakran egyszerűbb, ha minden csomópontban egységes classpath-ot használunk. Csak annyit kell biztosítanunk, hogy ugyanaz a classpath szerepeljen a futási időben is. (Bár lehetséges különböző csomópontokat eltérő classpathokkal futtatni, ez bonyolítja az egész konfigurációt és nehézségeket okoz a telepítésben és az integrációs tesztekben.) Jelen bejegyzés keretein belül azt feltételezzük, hogy minden csomópontban azonos classpath-ot használnak.
A konfiguráció az alkalmazással együtt fejlődik. A különböző evolúciós szakaszok azonosítására verziókat használunk. Nyilvánvalóan logikus lenne külön verziókat azonosítani a konfigurációkhoz is. Maga a konfiguráció pedig belekerülne egy verziókezelő rendszerbe. Ha a production környezetben van egyetlen konfiguráció, akkor egyszerűen egy verziószámot használhatunk. Ha azonban több production példány van használatban, akkor több konfigurációs ágra és egyéb címkére (például ágcímre) lesz szükségünk.
Ezáltal egyértelműen azonosíthatjuk a pontos konfigurációt. Minden konfigurációs azonosító egyértelműen megfelel egy adott elosztott csomópontok, portok, külső erőforrások, könyvtárverziók kombinációjának. Ebben a bejegyzésben azt feltételezzük, hogy csak egy ág van, és az azonosítás a konfiguráció szokásos módon történik, három, ponttal elválasztott számmal (1.2.3).
A modern környezetekben a konfigurációs fájlokat ritkán hozzák létre manuálisan. Gyakrabban generálják őket a telepítés során, és ezután már nem nyúlnak hozzájuk (hogy ). Felmerül a jogos kérdés, miért használunk még mindig szövegformátumot a konfiguráció tárolására? Egy életképes alternatíva a hagyományos kód használata a konfigurációhoz, amely a fordítás során előnyöket nyújt a ellenőrzések révén.
Ebben a bejegyzésben éppen azt a gondolatot vizsgáljuk, hogy a konfigurációt beépített artefaktumban mutassuk be.
Fordított konfiguráció
Ebben a részben egy statikus, fordítható konfiguráció példáját vizsgáljuk. Két egyszerű szolgáltatás valósul meg — egy echo szolgáltatás és az echo szolgáltatás ügyfele. Ezekből a szolgáltatásokból két különböző rendszer variációt építünk fel. Az egyik variációban mindkét szolgáltatás egy csomóponton helyezkedik el, a másikban pedig különböző csomópontokon.
A tipikus elosztott rendszer több csomópontot tartalmaz. A csomópontokat valamilyen típusú értékek segítségével lehet azonosítani. NodeId:
case class NodeId(hostName: String)vagy
object Singleton
type NodeId = Singleton.type
vagy akár
object Singleton
type NodeId = Singleton.type
A csomópontok különböző szerepeket töltenek be, rajtuk szolgáltatások futnak, és TCP/HTTP kapcsolatok létesíthetők közöttük.
A TCP connection requires at least a port number. We would also like to reflect the protocol supported on that port to ensure that both the client and server are using the same protocol. We will describe the connection using such a class:
case class TcpEndPoint[Protocol](node: NodeId, port: Port[Protocol])ahol Port — simply an integer Int indicating the acceptable value range:
type PortNumber = Refined[Int, Closed[_0, W.`65535`.T]]Refined types
See the library és . In short, the library allows adding constraints to types, which are checked at compile time. In this case, the acceptable values for the port number are 16-bit integers. Using the refined library for the compiled configuration is not mandatory but enhances the compiler's ability to validate the configuration.
For HTTP (REST) protocols, in addition to the port number, we may also require the path to the service:
type UrlPathPrefix = Refined[String, MatchesRegex[W.`"[a-zA-Z_0-9\/]*"`.T]]
case class PortWithPrefix[Protocol](portNumber: PortNumber, pathPrefix: UrlPathPrefix)
Phantom types
To identify the protocol at compile time, we use a type parameter that is not used within the class. This approach is due to the fact that we do not use a protocol instance at runtime, but we would like the compiler to check protocol compatibility. By specifying the protocol, we cannot pass an incompatible service as a dependency.
One of the common protocols is REST API with JSON serialization:
sealed trait JsonHttpRestProtocol[RequestMessage, ResponseMessage]ahol RequestMessage — request type, ResponseMessage — response type.
Of course, other protocol descriptions that provide the required accuracy can also be used.
For the purposes of this post, we will use a simplified version of the protocol:
sealed trait SimpleHttpGetRest[RequestMessage, ResponseMessage]Here, the request is a string added to the URL, and the response is the returned string in the body of the HTTP response.
The service configuration is described by the service name, ports, and dependencies. These elements can be represented in Scala in several ways (for example, HList-s, algebraic data types). For the purposes of this post, we will use the Cake Pattern and represent modules using traits. (The Cake Pattern is not a mandatory element of the described approach; it's just one of the possible implementations.)
Dependencies between services can be represented as methods that return the ports of other nodes: EndPoints of other nodes:
  type EchoProtocol[A] = SimpleHttpGetRest[A, A]

  trait EchoConfig[A] extends ServiceConfig {
    def portNumber: PortNumber = 8081
    def echoPort: PortWithPrefix[EchoProtocol[A]] = PortWithPrefix[EchoProtocol[A]](portNumber, "echo")
    def echoService: HttpSimpleGetEndPoint[NodeId, EchoProtocol[A]] = providedSimpleService(echoPort)
  }
Az echoszolgáltatás létrehozásához elegendő csupán a portszám és annak megadása, hogy ez a port támogatja az eho protokollt. Nem is kellett volna konkrét portot megadnunk, mivel a trait-ek lehetővé teszik számunkra, hogy implementáció nélkül deklaráljunk metódusokat (absztrakt metódusokat). Ebben az esetben a konkrét konfiguráció létrehozásakor a fordítótól elvárható lett volna, hogy biztosítsuk az absztrakt metódus implementációját és a portszámot. Mivel megvalósítottuk a metódust, a konkrét konfiguráció létrehozásakor nem kell másik portot megadnunk. Az alapértelmezett érték fog használatban lenni.
A kliens konfigurációjában a függőséget az echoszolgáltatástól deklaráljuk:
  trait EchoClientConfig[A] {
    def testMessage: String = "test"
    def pollInterval: FiniteDuration
    def echoServiceDependency: HttpSimpleGetEndPoint[_, EchoProtocol[A]]
  }
A függőség ugyanolyan típusú, mint az exportált szolgáltatás echoService. Különösen, az eho kliensben megköveteljük ugyanazt a protokollt. Ezért, amikor két szolgáltatást kapcsolunk össze, biztosak lehetünk benne, hogy minden megfelelően működni fog.
Szolgáltatások megvalósítása
A szolgáltatás indításához és leállításához funkcióra van szükség. (A szolgáltatás leállításának lehetősége kritikus fontosságú a tesztelés szempontjából.) Ismét több különböző megvalósítása lehet egy ilyen funkciónak (például használhatnánk konfigurációs típuson alapuló osztályokat). A jelen bejegyzés céljából a Cake Pattern-t fogjuk alkalmazni. A szolgáltatást a következő osztály segítségével fogjuk képviselni, cats.Resource, mivel ez az osztály már tartalmazza az erőforrások biztonságos garantált felszabadításának eszközeit problémák esetén. Az erőforrás megszerzéséhez meg kell adnunk a konfigurációt és a kész runtime-környezetet. A szolgáltatás indító funkciója a következőképpen nézhet ki:
  type ResourceReader[F[_], Config, A] = Reader[Config, Resource[F, A]]

  trait ServiceImpl[F[_]] {
    type Config
    def resource(
      implicit
      resolver: AddressResolver[F],
      timer: Timer[F],
      contextShift: ContextShift[F],
      ec: ExecutionContext,
      applicative: Applicative[F]
    ): ResourceReader[F, Config, Unit]
  }
ahol
Konfiguráció— a konfiguráció típusa ehhez a szolgáltatáshozAddressResolver— a futási objektum, amely lehetővé teszi más csomópontok címeinek megismerését (lásd később)
és a könyvtár más típusai cats:
F[_]— a hatás típusa (a legegyszerűbb esetbenF[A]egyszerű funkció lehet() => A. A jelen bejegyzésben a következőt fogjuk használnicats.IO.)Reader[A,B]— többé-kevésbé a funkció szinonimájaA => Bcats.Resource— erőforrás, amely megszerezhető és felszabadíthatóTimer— időzítő (lehetővé teszi, hogy egy ideig aludjunk, és mérjük időszakokat)ContextShift— analógExecutionContextApplicative— a hatás típusának osztálya, amely lehetővé teszi különböző hatások összekapcsolását (majdnem monáda). Összetettebb alkalmazások esetén valószínűleg jobban tesszük, haMonad/ConcurrentEffect.
E funkciós aláírás segítségével több szolgáltatást megvalósíthatunk. Például egy szolgáltatást, amely semmit sem csinál:
  trait ZeroServiceImpl[F[_]] extends ServiceImpl[F] {
    type Config  Resource.pure[F, Unit]( ()) )
  }
(Lásd. , amelyben más szolgáltatások is megvalósulnak — ,
és .)
A csomópont egy olyan objektum, amely több szolgáltatást indíthat el (az erőforrások láncolatának elindítását a Cake Pattern biztosítja):
object SingleNodeImpl extends ZeroServiceImpl[IO]
  with EchoServiceService
  with EchoClientService
  with FiniteDurationLifecycleServiceImpl
{
  type Config = EchoConfig[String] with EchoClientConfig[String] with FiniteDurationLifecycleConfig
}
Felhívjuk figyelmét, hogy meg kell határoznunk a pontos konfigurációs típust, amely erre a csomópontra szükséges. Ha elfelejtjük megadni valamelyik konfigurációs típust, amely egy adott szolgáltatáshoz szükséges, fordítási hiba léphet fel. Ezenkívül nem tudjuk elindítani a csomópontot, ha nem biztosítunk egy olyan objektumot, amelynek megfelelő típusa van, minden szükséges adatokkal.
csomópontnevek feloldása
A távoli csomóponthoz való csatlakozáshoz valódi IP-cím szükséges. Lehetséges, hogy a cím később válik ismertté, mint a konfiguráció egyéb részei. Ezért szükség van egy funkcióra, amely a csomópont azonosítóját címmé alakítja:
case class NodeAddress[NodeId](host: Uri.Host)
trait AddressResolver[F[_]] {
  def resolve[NodeId](nodeId: NodeId): F[NodeAddress[NodeId]]
}
Többféle módon is megvalósíthatjuk ezt a funkciót:
- Ha a címek előre ismertek a telepítés előtt, akkor generálhatunk Scala-kódot a
címekkel, majd elindíthatjuk a buildet. Ez a fordítást és a teszteléseket is magában foglalja.
Ebben az esetben a funkció statikusan ismertté válik, és a kódban megjeleníthető a leképezéskéntMap[NodeId, NodeAddress]. - Egyes esetekben a valós cím csak a csomópont elindítása után válik ismertté.
Ebben az esetben megvalósíthatunk egy "felfedező szolgáltatást" (discovery), amely az összes többi csomópont előtt elindul, és az összes csomópont regisztrálja magát ebben a szolgáltatásban, és kérni fogja a többi csomópont címét. - Ha módosíthatjuk
/etc/hosts, akkor előre definiált hosztneveket használhatunk (példáulmy-project-main-nodeésecho-backend) és egyszerűen társíthatjuk ezeket a neveket
az IP-címekkel a telepítés során.
A jelen bejegyzés keretében nem vizsgáljuk meg ezeket az eseteket részletesebben. A mi
játékmintánkban az összes csomópontnak egy IP-címe lesz — 127.0.0.1.
Most nézzük meg a disztribúciós rendszer két változatát:
- Minden szolgáltatás egy csomóponton van.
- És az echo-szolgáltatás és az echo-ügyfél különböző csomópontokon.
Konfiguráció egy :
Konfiguráció egy csomópontra
object SingleNodeConfig extends EchoConfig[String]
  with EchoClientConfig[String] with FiniteDurationLifecycleConfig
{
  case object Singleton \/\/ az egyes csomópont azonosítója
  \/\/ szerver konfiguráció
  type NodeId = Singleton.type
  def nodeId = Singleton

  \/** Típusbiztos szolgáltatásport-specifikáció. *\/
  override def portNumber: PortNumber = 8088

  \/\/ ügyfél konfiguráció

  \/** A szolgáltatást ugyanarról a hosztról fogjuk használni. *\/
  def echoServiceDependency = echoService

  override def testMessage: UrlPathElement = "hello"

  def pollInterval: FiniteDuration = 1.second

  \/\/ életciklus-vezérlő konfiguráció
  def lifetime: FiniteDuration = 10500.milliseconds \/\/ további 0,5 másodperc, hogy 10 kérést küldhessünk, ne 9-et.
}
Az objektum a kliens és a szerver konfigurációját valósítja meg. Ezen kívül használják az életciklus konfigurációját, hogy egy időintervallum letelte után elmúlik az élettartam befejezze a programot. (A Ctrl-C is működik és helyesen felszabadítja az összes erőforrást.)
Ugyanazt a trait-beállítást és implementációkat használhatjuk egy olyan rendszer létrehozásához, amelyből :
Konfiguráció két csomóponthoz
  object NodeServerConfig extends EchoConfig[String] with SigTermLifecycleConfig
  {
    type NodeId = NodeIdImpl

    def nodeId = NodeServer

    override def portNumber: PortNumber = 8080
  }

  object NodeClientConfig extends EchoClientConfig[String] with FiniteDurationLifecycleConfig
  {
    \/\/ NB! függőségi specifikáció
    def echoServiceDependency = NodeServerConfig.echoService

    def pollInterval: FiniteDuration = 1.second

    def lifetime: FiniteDuration = 10500.milliseconds \/\/ további 0,5 másodperc, hogy 10 kérést küldhessünk, ne 9-et.

    def testMessage: String = "dolly"
  }
Fontos! Figyeljen arra, hogyan történik a szolgáltatások összekapcsolása. Az egyik csomópont által megvalósított szolgáltatást mint a másik csomópont függőségi metódusának megvalósítását adjuk meg. A függőség típusa a fordító által ellenőrizve van, mivel tartalmazza a protokoll típusát. A futtatás során a függőség a célcsomópont helyes azonosítóját fogja tartalmazni. Ezzel az eljárással ugyanis a port számát pontosan egyszer adjuk meg, és mindig garantáltan a helyes portra hivatkozunk.
Két csomópontú rendszer megvalósítása
Ezekhez a konfigurációkhoz változatlanul használjuk ugyanazokat a szolgáltatásimplementációkat. Az egyetlen eltérés, hogy most két olyan objektumunk van, amelyek különböző szolgáltatáscsomagokat valósítanak meg:
  object TwoJvmNodeServerImpl extends ZeroServiceImpl[IO] with EchoServiceService with SigIntLifecycleServiceImpl {
    type Config = EchoConfig[String] with SigTermLifecycleConfig
  }

  object TwoJvmNodeClientImpl extends ZeroServiceImpl[IO] with EchoClientService with FiniteDurationLifecycleServiceImpl {
    type Config = EchoClientConfig[String] with FiniteDurationLifecycleConfig
  }
Az első csomópont a szerver megvalósításáért felelős, és csak szerver konfigurációra van szüksége. A második csomópont a klienst valósítja meg, és egy másik konfigurációs részt használ. Továbbá mindkét csomópontnak szüksége van az életciklus kezelésére. A szervercsomópont korlátlan ideig működik, amíg le nem állítják SIGTERMa klienscsomópont pedig néhány idő elteltével leáll. Lásd: .
Átfogó fejlesztési folyamat
Nézzük meg, hogyan befolyásolja ez a konfigurálási megközelítés az átfogó fejlesztési folyamatot.
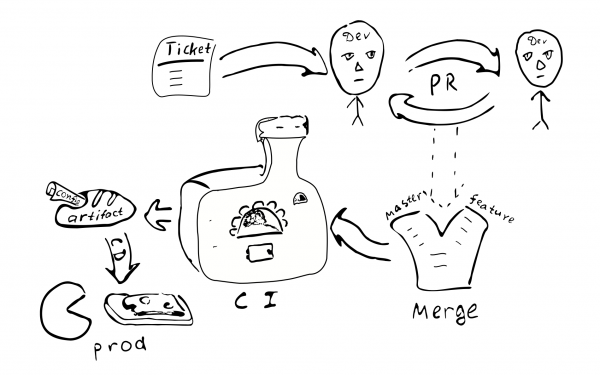
A konfigurációt a többi kóddal együtt lefordítják, és létrejön egy artefaktum (.jar). Nyilvánvalóan érdemes a konfigurációt külön artefaktumban elhelyezni. Ennek oka, hogy számos konfigurációnk lehet ugyanazon kód alapján. Ismét generálhatók artefaktumok a különböző konfigurációs ágazatokhoz. A konfigurációkkal együtt megmarad a konkrét könyvtárak verzióitól való függőség, és ezek a verziók örökre megmaradnak, bármeddig is döntenénk a konfiguráció ezen verziójának telepítéséről.
Bármely konfigurációváltozás kódváltozássá alakul. Így tehát minden ilyen
változást a szokásos minőségbiztosítási folyamat fog átfogni:
Hiba jelentés a hibakövetőben -> PR -> Felülvizsgálat -> Összevonás a megfelelő ágakkal ->
integráció -> telepítés
A fordítható konfigurációk bevezetésének fő következményei:
A konfigurációt a megosztott rendszer minden node-ján egyeztetni kell. Mivel minden node egyetlen forrásból kapja a konfigurációt,
nehéz csak az egyik node konfigurációját megváltoztatni. Ezért a "konfigurációs eltérések" (configuration drift) valószínűsége alacsony.
Egyre nehezebb kis változtatásokat eszközölni a konfiguráción.
A konfigurációs változások többsége egy általános fejlesztési folyamat keretein belül történik, és felülvizsgálat alá fog kerülni.
Szükséges egy külön tároló a production konfiguráció tárolására? Ebben a konfigurációban lehetnek jelszavak és egyéb titkos információk, amelyekhez szeretnénk korlátozni a hozzáférést. Ebből a szempontból érdemes lehet a végső konfigurációt külön tárolóban tárolni. A konfigurációt két részre lehet osztani: egy nyilvános konfigurációs paraméterekre és egy korlátozott hozzáférésű paraméterekre. Ez lehetővé teszi a legtöbb fejlesztő számára a nyilvános paraméterekhez való hozzáférést. Ilyen szétválasztást könnyen el lehet érni köztes trait-ek használatával, amelyek tartalmazzák az alapértelmezett értékeket.
Lehetséges változatok
Próbáljuk meg összehasonlítani a fordított konfigurációt néhány elterjedt alternatívával:
- Szövegfájl a célgépünkön.
- Központosított kulcs-érték tároló (
etcd/zookeeper). - A rendszer olyan összetevői, amelyek újrakonfigurálhatók/újraindíthatók anélkül, hogy a folyamatot újra kellene indítani.
- A konfiguráció tárolása az artefaktumon kívül és verzióellenőrzés alatt.
A szövegfájlok jelentős rugalmasságot nyújtanak a kisebb változtatások szempontjából. A rendszeradminisztrátor beléphet a távoli node-ra, módosíthatja a megfelelő fájlokat és újraindíthatja a szolgáltatást. Nagy rendszerek esetében azonban ez a rugalmasság nem mindig kívánatos. A nagyobb módosítások nem hagynak nyomokat más rendszerekben. Senki sem végez felülvizsgálatot a változtatásokon. Nehéz megállapítani, ki és miért végezte el a módosítást. A változtatások nincsenek tesztelve. Ha a rendszer megosztott, a rendszergazda elfelejtheti elvégezni a megfelelő módosítást más node-okon.
(Azt is meg kell említeni, hogy a fordítható konfiguráció alkalmazása nem zárja ki a szöveges fájlok jövőbeli használatát. Elegendő egy elemző és érvényesítő hozzáadása, amely a kimeneten ugyanazt a típust adja, Konfiguráció, és lehet használni a szöveges fájlokat. Ebből közvetlenül következik, hogy a fordítható konfigurációs rendszer bonyolultsága valamivel kisebb, mint a szöveges fájlokat használó rendszeré, mivel a szöveges fájlokhoz további kódra van szükség.)
A központosított kulcs-érték tároló jó mechanizmus a meta-paraméterek elosztott alkalmazásban való terjesztésére. Meg kell határoznunk, hogy mik a konfigurációs paraméterek és mik az egyszerű adatok. Legyen egy funkciónk, C => A => B, amelynek paraméterei C ritkán változnak, míg az adatok A — gyakran. Ebben az esetben elmondhatjuk, hogy C — konfigurációs paraméterek, míg A — adatok. Úgy tűnik, hogy a konfigurációs paraméterek abban különböznek az adatoktól, hogy általában ritkábban változnak, mint az adatok. Az adatok általában egy forrásból származnak (a felhasználótól), míg a konfigurációs paraméterek egy másikból (a rendszer adminisztrátorától).
Ha a ritkán változó paramétereket úgy kell frissíteni, hogy a program újraindítása nélkül tegyük, az gyakran a program bonyolultságához vezethet, mivel valamilyen módon el kell juttatnunk a paramétereket, tárolnunk, elemeznünk és ellenőriznünk kell, valamint kezelnünk kell a hibás értékeket. Ezért, a program bonyolultságának csökkentése érdekében, érdemes csökkenteni a program futása során megváltoztatott paraméterek számát (vagy egyáltalán nem támogatni azokat).
A jelen cikk szempontjából megkülönböztetjük a statikus és dinamikus paramétereket. Ha a szolgáltatás működési logikája megköveteli a paraméterek változtatását a program működése során, akkor ezeket dinamikus paramétereknek nevezzük. Ellenkező esetben a paraméterek statikusak, és kompilálható konfigurációval beállíthatók. A dinamikus rekonstrukcióhoz szükség lehet a program egyes részeinek új paraméterekkel történő újraindítására, akárcsak az operációs rendszer folyamatainak újraindításakor. (Véleményünk szerint érdemes elkerülni az valós idejű rekonstrukciót, mivel ez a rendszer bonyolultságát növeli. Ha lehetséges, a legjobb, ha az operációs rendszer standard lehetőségeit használjuk a folyamatok újraindítására.)
A statikus konfiguráció használatának egyik fontos aspektusa, amely miatt az emberek a dinamikus rekonstrukciót fontolgatják, az az időtartam, amelyre a rendszernek szüksége van a konfiguráció frissítése utáni újraindulásra (downtime). Valóban, ha módosítani kell a statikus konfigurációt, újra kell indítanunk a rendszert, hogy az új értékek érvénybe lépjenek. A downtime problémája különböző súlyossággal jelentkezik a különböző rendszerek esetében. Bizonyos esetekben a leállás ütemezhető egy minimális terheltségű időszakra. Ha folytonos szolgáltatást kell biztosítani, akkor megvalósítható . Ezért, amikor újra kell indítanunk a rendszert, párhuzamos példányt indítunk el, átkapcsoljuk a terheléselosztót erre, és várjuk, amíg a régi kapcsolatok befejeződnek. Miután az összes régi kapcsolat befejeződött, kikapcsoljuk a régi rendszer példányát.
Most vizsgáljuk meg a konfiguráció tárolásának kérdését az artefaktumon belül vagy azon kívül. Ha a konfigurációt az artefaktumon belül tároljuk, akkor legalább biztosíthatjuk annak helyességét az artefaktum összeállítása során. Ha a konfiguráció egy nem ellenőrzött artefaktumon kívül található, nehéz nyomon követni, ki és miért módosította ezt a fájlt. Mennyire fontos ez? Véleményünk szerint sok termelési rendszer számára fontos a stabil és magas színvonalú konfiguráció megléte.
A műtárgy verziója lehetővé teszi annak meghatározását, hogy mikor készült, milyen értékeket tartalmaz, milyen funkciók vannak bekapcsolva/kikapcsolva, és ki felelős a konfiguráció bármilyen módosításáért. Természetesen a konfiguráció műtárgyban való tárolása bizonyos erőfeszítéseket igényel, ezért tudatos döntést kell hozni.
Pro és kontra
Szeretném kiemelni az ajánlott technológia előnyeit és hátrányait.
Előnyök
Az alábbiakban a laza konfigurációs rendszer főbb lehetőségeinek listája található:
- Statikus konfigurációellenőrzés. Lehetővé teszi, hogy biztosak legyünk abban, hogy
a konfiguráció helyes. - Gazdag konfigurációs nyelv. Más konfigurálási módszerek általában maximum stringváltozók behelyettesítésére korlátozódnak. Scala használatával széleskörű nyelvi lehetőségek válik elérhetővé a konfiguráció javítására. Például használhatjuk
a trait-eket alapértelmezett értékekhez, csoportosíthatjuk a paramétereket objektumok segítségével, hivatkozhatunk egyszeri deklarációjú (DRY) val-okra, amelyek a környező hatósugaron belül vannak. Bármilyen osztályt közvetlenül a konfigurációban is instanciálhatunk (Seq,Térkép, egyedi osztályok). - DSL. A Scalában számos nyelvi lehetőség létezik, amelyek megkönnyítik a DSL létrehozását. Ezeket a lehetőségeket felhasználva megvalósíthatunk egy olyan konfigurációs nyelvet, amely kényelmesebb lenne a célcsoport felhasználói számára, így a konfiguráció legalább olvasható lenne a szakterület szakemberei számára. A szakemberek például részt vehetnek a konfiguráció ellenőrzési folyamatában.
- Integráció és szinkronizáció a csomópontok között. Az egyik előnye annak, hogy az egész elosztott rendszer konfigurációja egyetlen pontban van tárolva, az, hogy minden értéket pontosan egyszer deklarálnak, majd újra felhasználják mindenhol, ahol szükséges. A fantom típusok használata a portok deklarálása során garantálja, hogy az összes érvényes konfigurációval rendelkező rendszer csomópontjai kompatibilis protokollokat használnak. A csomópontok közötti egyértelmű kötelező függőségek garantálják, hogy az összes szolgáltatás összekapcsolódik.
- Magas szintű változtatásminőség. A konfiguráció módosítása közös fejlesztési folyamat alapján lehetővé teszi a magas színvonalú konfigurációs minőséget is.
- Párhuzamos konfigurációfrissítés. A konfigurációs változtatások után automatikus telepítés biztosítja, hogy minden csomópont frissüljön.
- Az alkalmazás leegyszerűsítése. Az alkalmazás nem igényel parsingot, a konfiguráció ellenőrzését vagy helytelen értékek kezelését. Ezzel csökken az alkalmazás komplexitása. (Néhány, a mi példánkban megfigyelt konfigurációs bonyolultság nem a fordítható konfiguráció jellemzője, hanem egy tudatos döntés, amely a nagyobb típusbiztonságra való törekvés vezérelte.) Könnyedén visszatérhetünk a szokásos konfigurációhoz — csak a hiányzó részeket kell megvalósítani. Így például elkezdhetjük a fordítható konfigurációval, és később, amikor tényleg szükség van rá, valósíthatjuk meg a felesleges részeket.
- Verziós konfiguráció. Mivel a konfigurációs változások ugyanazt a sorsot követik, mint bármely más változtatás, az eredmény egy unikális verzióval rendelkező artefakt lesz. Ez lehetővé teszi számunkra, hogy például visszatérjünk egy korábbi konfigurációs verzióhoz, ha szükséges. Még egy évvel ezelőtti konfigurációt is használhatunk, és a rendszer ugyanúgy fog működni. A stabil konfiguráció növeli a prediktabilitást és a megbízhatóságot a disztribúciós rendszerben. Mivel a konfiguráció a fordítási szakaszban rögzítve van, nehezen manipulálható a production környezetben.
- Modularitás. Az ajánlott keretrendszer moduláris, és a modulok különböző variációkban kombinálhatók különböző rendszerek létrehozására. Különösen egy variációban egy csomóponton való futtatásra, míg egy másikban több csomóponton való futtatásra lehet konfigurálni a rendszert. Több konfigurációt is létrehozhatunk a rendszer production példányaihoz.
- Tesztelés. Az egyes szolgáltatások mock-objektumokra való cserélésével több tesztelésre alkalmas verziót kaphatunk a rendszerből.
- Integrációs tesztelés. Az egységes konfiguráció megléte az egész elosztott rendszerben lehetővé teszi az összes komponens vezérelt környezetben történő futtatását az integrációs tesztelés keretében. Könnyen modellezhető például egy olyan helyzet, amikor bizonyos csomópontok elérhetetlenné válnak.
Hátrányok és korlátok
A lefordítható konfiguráció eltér más konfigurálási megközelítésektől, és bizonyos alkalmazások számára nem megfelelő. Az alábbiakban néhány hátrányt sorolunk fel:
- Statikus konfiguráció. Néha szükség van arra, hogy gyorsan módosítsuk a konfigurációt a produkciós környezetben, megkerülve minden védelmi mechanizmust. E megközelítés keretein belül ez nehezebb lehet. Legalább a fordítás és az automatikus telepítés így is szükséges. Ez egyszerre előnyös jellemzője a megközelítésnek és hátrány néhány esetben.
- Konfiguráció generálása. Ha a konfigurációs fájl automatikus eszközzel készül, akkor további erőfeszítésekre lehet szükség a build script integrálásához.
- Eszközkészlet. Jelenleg a konfigurációval foglalkozó eszközök és módszerek szöveges fájlokra épülnek. Nem minden ilyen eszköz/módszer lesz elérhető lefordítható konfiguráció esetén.
- Változások szükségesek a gondolkodásmódban. A fejlesztők és a DevOps szakemberek megszokták a szöveges fájlokat. A konfiguráció lefordításának ötlete meglehetősen váratlan és szokatlan lehet, és elutasítást okozhat.
- Magas színvonalú fejlesztési folyamat szükséges. A lefordítható konfiguráció kényelmes használatához teljes mértékben automatizált build és telepítési folyamat (CI/CD) szükséges. Ellenkező esetben kényelmetlen lesz.
Fókuszáljunk a vizsgált példa néhány, a lefordítható konfiguráció ötletéhez nem kapcsolódó korlátjára is:
- Ha felesleges konfigurációs információt biztosítunk, amelyet a csomópont nem használ, akkor a fordító nem tudja segíteni a megvalósítás hiányának felfedezését. E problémát úgy lehet megoldani, hogy elhagyjuk a Cake Pattern-t, és szigorúbb típusokat használunk, például
HListvagy algebrai adattípusokat (case class-okat) a konfiguráció képviseletére. - A konfigurációs fájlban olyan sorok találhatók, amelyek nem tartoznak ténylegesen a konfigurációhoz: (
csomag,importálás, objektumok nyilatkozatai;felülírja a defParaméterekhez, amelyeknek alapértelmezett értékeik vannak). Részben elkerülhető ez, ha saját DSL-t valósítunk meg. Továbbá, más konfigurálási formák (például XML) is bizonyos korlátozásokat szabnak a fájl struktúrájára. - A bejegyzés keretein belül nem vizsgáljuk a hasonló csomópontok klaszterének dinamikus újrakonfigurálását.
Zárás
Ebben a bejegyzésben megvizsgáltuk a konfiguráció forráskódba való ábrázolásának ötletét a Scala típusrendszerének fejlettebb lehetőségeivel. Ez a megközelítés különböző alkalmazásokban alkalmazható az XML vagy szöveges fájlok alapú hagyományos konfigurálási módszerek helyettesítésére. Annak ellenére, hogy példánk Scala-ban készült, ugyanezek az ötletek más fordított nyelvekre (például Kotlin, C#, Swift, ...) is átvihetők. Ezt a megközelítést az egyik következő projektben ki lehet próbálni, és ha nem működik, visszatérhetünk a szöveges fájlokhoz, kiegészítve a hiányzó részleteket.
Természetesen a fordítható konfiguráció magas szintű fejlesztési folyamatot igényel. Cserébe magas minőséget és megbízhatóságot biztosít a konfigurációk számára.
A vizsgált megközelítést lehet bővíteni:
- Makrókat lehet használni a fordítás során történő ellenőrzések végrehajtására.
- DSL-t lehet megvalósítani, hogy a konfiguráció felhasználók által hozzáférhető módon jelenjen meg.
- Dinamikus erőforrás-menedzsment is megvalósítható automatikus konfiguráció-beállítással. Például, amikor a klaszter csomópontjainak száma megváltozik, szükséges, hogy (1) minden csomópont egy kicsit eltérő konfigurációt kapjon; (2) a klaszter menedzser értesítést kapjon az új csomópontokról.
Köszönetnyilvánítások
Szeretném megköszönni Andrej Szaksonovnak, Pavel Popovnak és Anton Nehaevnak a cikk vázlatának konstruktív kritikáját.
Forrás: habr.com
