

Egyre többször érkeznek olyan kérések az ügyfelektől: „Olyan szeretnénk, mint az Amazon RDS, de olcsóbban”; „Olyan RDS-t szeretnénk, ami mindenhol működik, bármilyen infrastruktúrán.” Egy ilyen managed megoldás Kubernetes-en való megvalósítása érdekében megvizsgáltuk a PostgreSQL legnépszerűbb operátorainak jelenlegi állapotát (Stolon, a Crunchy Data és Zalando operátorai), és eldöntöttük, hogy melyiket választjuk.
Ez a cikk a minket érintő tapasztalatainkat összegzi, elméleti szempontból (megoldások áttekintése) és gyakorlati oldalról (mi lett kiválasztva és mi valósult meg belőle). De először határozzuk meg, hogy milyen követelmények merülnek fel a potenciális RDS helyettesítőkkel szemben...
Mi is az RDS?
Amikor az emberek az RDS-ről beszélnek, tapasztalataink szerint egy olyan managed adatbázis-szolgáltatást értenek, amely:
- könnyen beállítható;
- lehetővé teszi a snapshotokkal való munkát és azokból való helyreállítást (lehetőleg a PITR támogatásával); );
- gazdag bővítési listával rendelkezik;
- auditálási és felhasználó- / hozzáféréskezelési funkciókat biztosít.
- Általánosságban elmondható, hogy a feladat megvalósításának megközelítései nagyon eltérőek lehetnek, azonban a feltételes Ansible útja számunkra nem vonzó. (Hasonló következtetésre jutottak a 2GIS munkatársai is az
éppen fellépett próbálkozásuk során, hogy létrehozzanak egy „eszközt a megbízható PostgreSQL klaszter gyors telepítéséhez.”) az egyik előadásában.
: A viszonylag egyszerű operátorok gyors létrehozásához ajánljuk figyelmetekbe a mi Open Source segédprogramunkat, , in .
NBA PostgreSQL-hez több népszerű K8s operátor létezik: Crunchy Data PostgreSQL Operátor;
Zalando Postgres Operátor.
- Nézzük meg őket közelebbről.
- Operátor kiválasztása
- A fent említett fontos lehetőségeken kívül mi — mint infrastruktúra üzemeltetési mérnökök a Kubernetes-ben — a következőkre is számítottunk az operátoroktól:
Git alapú telepítés és
Custom Resources
pod anti-affinity támogatás;
- node affinity vagy node selector beállítása; ;
- finomhangolási lehetőségek jelenléte;
- érthető technológiák és még parancsok is.
- tolerációk telepítése;
- finomhangolási lehetőségek megléte;
- érthető technológiák és még parancsok is.
Anélkül, hogy minden egyes pont részleteibe bocsátkoznánk (kérdezzetek a megjegyzésekben, ha kérdések maradnak a cikk elolvasása után), az összefoglalásban megemlítem, hogy ezek a paraméterek szükségesek a klaszter csomópontjainak specializációjának finomabb leírásához, hogy azokat konkrét alkalmazásokhoz rendelhessük. Így optimális egyensúlyt érhetünk el a teljesítmény és a költségek között.
Most pedig nézzük magukat a PostgreSQL operátorokat.
1. Stolon
az olasz Sorint.lab cégtől mint valamilyen referencia az adatbáziskezelő operátorai között. Ez egy elég régi projekt: az első nyilvános kiadására még 2015 novemberében került sor(!), a GitHub-repozitórium pedig majdnem 3000 csillaggal és 40+ közreműködővel büszkélkedhet.
Valóban, a Stolon nagyszerű példa a jól megtervezett architektúrára:
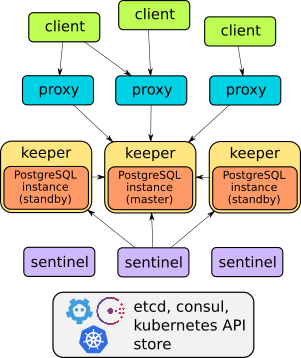
Ennek az operátornak a részletei a beszámolóban ismerhetők meg, vagy . Általánosságban elmondható, hogy mindent tud, amit leírtunk: failover, proxy az ügyfelek átlátható hozzáféréséhez, biztonsági másolatok… Ráadásul a proxy egyetlen szolgáltatás végpontján keresztül biztosít hozzáférést - ellentétben a később bemutatott két másik megoldással (azoknak két szolgáltatásuk van az adatbázishoz való hozzáféréshez).
Viszont a Stolon , ezért nem lehet úgy telepíteni, hogy egyszerűen és gyorsan - „mint a forró zsemle” - példányokat hozzunk létre a Kubernetes-ben. Az irányítás a stolonctl, a telepítés pedig Helm diagramon keresztül történik, a felhasználói beállításokat pedig ConfigMap-ben definiáljuk.
Egyrészt tehát úgy tűnik, hogy az operátor nem igazán operátor (hiszen nem használ CRD-t). Másrészt viszont ez egy rugalmas rendszer, amely lehetővé teszi az erőforrások testreszabását a K8s-ben, ahogy neked kényelmes.
Összegzésképpen, számunkra nem tűnt optimálisnak, hogy minden adatbázishoz külön diagramot hozzunk létre. Ezért alternatívákat kezdtünk keresni.
2. Crunchy Data PostgreSQL Operátor
, egy fiatal amerikai startuppól, ésszerű alternatívának tűnt. Publikus története 2017 márciusában kezdődött az első kiadással, azóta a GitHub-repozitórium kissé kevesebb mint 1300 csillagot és 50+ közreműködőt kapott. A legutóbbi szeptemberi kiadást a Kubernetes 1.15—1.18, OpenShift 3.11+ és 4.4+, GKE és VMware Enterprise PKS 1.3+ környezetében tesztelték.
A Crunchy Data PostgreSQL Operátor architektúrája is megfelel a megjelölt követelményeknek:
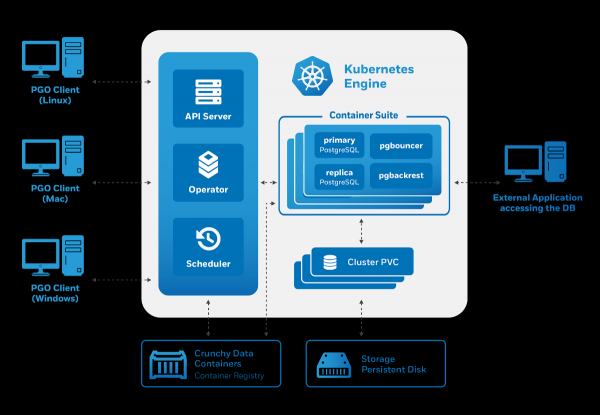
Az irányítás a pgo, azonban a Crunchy Data generálja a Custom Resources-t a Kubernetes számára. Ezért, mint potenciális felhasználókat, az üzemeltető örömmel üdvözölt minket:
- van kezelés CRD-n keresztül;
- kényelmes felhasználókezelés (szintén CRD-n keresztül);
- integráció más komponensekkel — specializált konténerképek gyűjteménye PostgreSQL számára, valamint a működéséhez szükséges eszközök (beleértve a pgBackRest, pgAudit, contrib-ból származó kiterjesztések stb.).
Azonban a Crunchy Data operátorának használatára tett kísérletek néhány problémát felfedtek:
- Nem volt lehetőség toleranciákra — csak nodeSelector volt elérhető.
- A létrehozott pod-ok a Deployment részét képezték, annak ellenére, hogy stateful alkalmazást telepítettünk. A StatefulSet-tel ellentétben a Deployment-ek nem tudnak lemezeket létrehozni.
Ez az utolsó hátrány vicces pillanatokhoz vezetett: a tesztkörnyezetben sikerült 3 replikát indítani egy lemezzel helyi tároló, aminek következtében az operátor azt jelezte, hogy 3 replika működik (bár ez nem volt igaz).
E népszerű operátor egy másik különlegessége, hogy készen áll a különböző segédrendszerekkel való integrációra. Például könnyen telepíthető a pgAdmin és a pgBounce, valamint előre beállított Grafana és Prometheus is szerepel a tervek között. A közelmúltban kiemelik a projekt, , amely miatt az operátor hasznos vizualizációt kínál a PgSQL metrikákhoz "dobozból".
Mindazonáltal a generált Kubernetes-nyersanyagok furcsa választása arra kényszerített minket, hogy más megoldásokat keressünk.
3. Zalando Postgres Operator
A Zalando termékei előttünk ismertek: van tapasztalatunk a Zalenium használatával, és természetesen kipróbáltuk — népszerű HA megoldásuk PostgreSQL-hez. A vállalat megközelítéséről a az egyik szerzője, Alexey Klyukin, beszélt a és tetszett nekünk.
Ez a legfiatalabb megoldás a cikkben tárgyaltak között: az első kiadás 2018 augusztusában történt. Azonban, még a viszonylag kevés hivatalos kiadás ellenére a projekt nagy utat járt be, már túlszárnyalta a Crunchy Data megoldását a 1300+ csillaggal a GitHub-on és a maximális számú közreműködővel (70+).
A "motorháztető alatt" a tesztelt és igazolt megoldásokkal dolgozik ez az operátor:
- Patroni és a kezeléshez,
- — a biztonsági mentésekhez,
- — a kapcsolatkezeléshez.
Így van bemutatva a Zalando operátorának architektúrája:
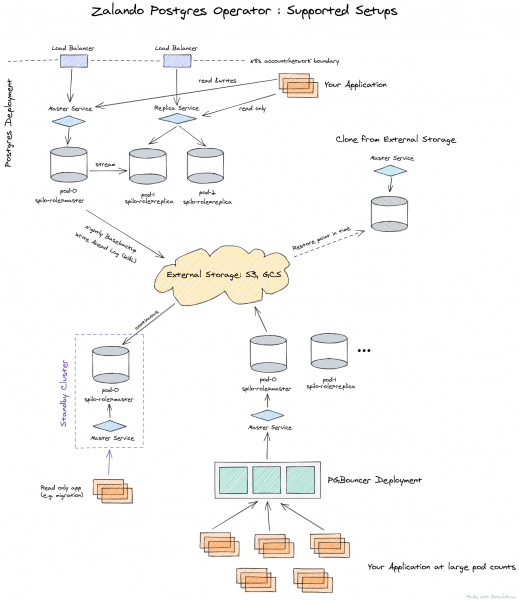
A vezérlő teljes mértékben a Custom Resources segítségével kezelhető, automatikusan létrehoz egy StatefulSet-et az olyan konténerekből, amelyeket ezután testreszabhatunk különböző sidecar-ok hozzáadásával a pod-okhoz. Mindez jelentős előny a Crunchy Data vezérlőjéhez képest.
Mivel a Zalando megoldását választottuk a három mérlegelt opciónk közül, az alábbiakban bemutatjuk annak lehetőségeit, az alkalmazási gyakorlat mellett.
Gyakorlat a Zalando Postgres Operátorral
Az operátor telepítése nagyon egyszerű: csak le kell tölteni a legfrissebb verziót a GitHub-ról, és alkalmazni kell a YAML fájlokat a könyvtárból . Alternatívaként használhatja is .
A telepítés után foglalkoznia kell a . Ezeket a ConfigMap-en keresztül állítják be postgres-operator azon a névterületen, ahová telepítette az operátort. Miután a tárolók be vannak állítva, elindíthatja az első PostgreSQL klasztert.
Például a standard telepítésünk a következőképpen néz ki:
apiVersion: acid.zalan.do/v1
kind: postgresql
metadata:
 name: staging-db
spec:
 numberOfInstances: 3
 patroni:
   synchronous_mode: true
 postgresql:
   version: "12"
 resources:
   limits:
     cpu: 100m
     memory: 1Gi
   requests:
     cpu: 100m
     memory: 1Gi
 sidecars:
 - env:
   - name: DATA_SOURCE_URI
     value: 127.0.0.1:5432
   - name: DATA_SOURCE_PASS
     valueFrom:
       secretKeyRef:
         key: password
         name: postgres.staging-db.credentials
   - name: DATA_SOURCE_USER
     value: postgres
   image: wrouesnel/postgres_exporter
   name: prometheus-exporter
   resources:
     limits:
       cpu: 500m
       memory: 100Mi
     requests:
       cpu: 100m
       memory: 100Mi
 teamId: staging
 volume:
   size: 2Gi
Ez a manifeszt egy 3 példányból álló klasztert telepít, sidecar formájában , amelyből az alkalmazás metrikáit szerezzük be. Mint látható, minden nagyon egyszerű, és ha szeretnénk, gyakorlatilag korlátlan számú klasztert hozhatunk létre.
Érdemes figyelni a webes adminisztrációs panelra — . Ez az operátorral együtt szállítva érkezik, és lehetővé teszi klaszterek létrehozását és törlését, valamint a biztonsági mentések kezelését, amelyeket az operátor készít.
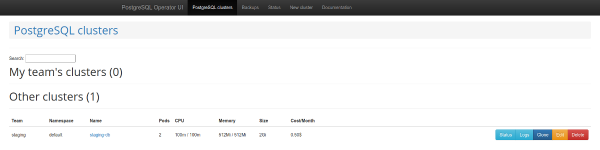
PostgreSQL klaszterek listája
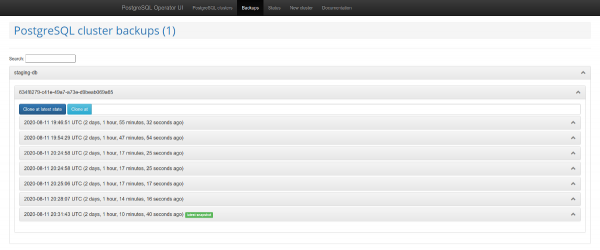
Biztonsági mentések kezelése
Egy másik érdekes funkció a . Ez a mechanizmus automatikusan létrehozza a PostgreSQL szerepköröket, a kapott felhasználónév-lista alapján. Ezután az API lehetővé teszi, hogy visszaadja azoknak a felhasználóknak a listáját, akik számára automatikusan létrehozzák a szerepköröket.
Problémák és megoldásuk
Azonban az operátor használata hamarosan néhány jelentős hátrányra derített fényt:
- a nodeSelector támogatásának hiánya;
- a biztonsági mentések letiltásának lehetetlensége;
- az adatbázisok létrehozásának funkció használatakor nem jelennek meg az alapértelmezett jogosultságok;
- időnként hiányzik a dokumentáció, vagy elavult állapotban van.
Szerencsére sok közülük megoldható. Kezdjük a végével — problémák a Microsoft dokumentációjával összhangban konfiguráljuk. Az egyetlen megjegyzés az, hogy az Ubuntu disztribúciót már letöltöttük, és a következő lépésben fogjuk telepíteni. A fő konfigurálás az "Windows alrendszer Linuxhoz" és a "Virtuális gép platform" kiegészítő komponenseinek aktiválására, valamint a beállítások alkalmazásához szükséges újraindításra korlátozódik:.
Valószínűleg azzal fog találkozni, hogy nem mindig világos, hogyan kell megadni a biztonsági mentést és hogyan kell csatlakoztatni a biztonsági mentési tárolót az Operator UI-hoz. Erről a dokumentáció csak felületesen beszél, a valódi leírás pedig :
- secretet kell készíteni;
- átadni az operátornak a paraméterben
pod_environment_secret_nameaz operátor beállításainak CRD-jében vagy ConfigMap-ban (attól függően, hogyan döntött az operátor telepítéséről).
Azonban, mint kiderült, jelenleg ez lehetetlen. Éppen ezért összegyűjtöttük néhány további harmadik fél által készített megoldással. Részletekért lásd alább.
Ha átadjuk az operátornak a biztonsági mentés paramétereit, mégpedig — wal_s3_bucket és az AWS S3 hozzáférési kulcsokat, akkor mindent biztonsági menteni fog: nem csak a production adatbázisokat, hanem a staginget is. Ez nekünk nem volt elfogadható.
A Spilo paramétereinek leírásában, ami az alap Docker-borító PgSQL-hez az operátor használata során, kiderült: a WAL_S3_BUCKET paramétert üresen lehet átadni, ezzel letiltva a biztonsági mentéseket. Sőt, a nagy örömünkre találtunk egy amit azonnal elfogadtunk a forkunkba. Most már elegendő egyszerűen hozzáadni enableWALArchiving: false az PostgreSQL klaszter erőforráshoz.
Igen, lett volna lehetőség másképp csinálni, két operátort indítva: egyet stagingre (mentés nélkül), és egyet productionra. De így elegendő volt egy.
Rendben, megtanultuk átadni a hozzáférést az S3-hoz az adatbázisok számára, és a biztonsági mentések elkezdtek a tárolóba kerülni. Hogyan lehet működésbe hozni a biztonsági mentési oldalak az Operator UI-ban?
Az Operator UI-ban 3 változót kell hozzáadni:
-
SPILO_S3_BACKUP_BUCKET -
AWS_ACCESS_KEY_ID -
AWS_SECRET_ACCESS_KEY
Ezután a biztonsági mentések kezelése elérhetővé válik, ami az esetünkben megkönnyíti a staginggel való munkát, lehetővé téve, hogy productionból készleteket juttathassunk oda további szkriptek nélkül.
Mint még egy pozitívum, említést nyert a Teams API-val való munka és az operátor segítségével történő adatbázisok és szerepkörök létrehozásának széles lehetősége. Azonban az előállított szerepkörök nem rendelkeztek alapértelmezett jogokkal.Ennek megfelelően az olvasási joggal rendelkező felhasználó nem tudta olvasni az új táblákat.
Miért van ez így? Annak ellenére, hogy a kódban szükségesek, GRANTezek messze nem mindig alkalmazásra kerülnek. Két módszer létezik: syncPreparedDatabases és syncDatabases. A syncPreparedDatabases — annak ellenére, hogy a szekcióban preparedDatabases van egy feltétel defaultRoles és defaultUsers a szerepkörök létrehozásához — az alapértelmezett jogok nem kerülnek alkalmazásra. Jelenleg egy javítócsomag előkészítésén dolgozunk, amely automatikusan alkalmazza ezeket a jogokat.
És az utolsó dolog a számunkra releváns fejlesztésekben — , amely Node Affinity-t ad a létrehozott StatefulSet-hez. Az ügyfeleink gyakran próbálják csökkenteni a költségeket spot példányok használatával, és ezeken nyilvánvalóan nem érdemes adatbázis szolgáltatásokat elhelyezni. Ezt a kérdést toleranciák révén is meg lehetett volna oldani, de a Node Affinity megléte nagyobb biztonságot ad.
Mi lett az eredmény?
A fent említett problémák megoldásának eredményeként forkoltuk a Postgres Operator-t a Zalando-tól , ahol hasznos javításokkal építjük. A még nagyobb kényelem érdekében pedig összegyűjtöttük a .
A forkolt PR-ek listája:
- ;
- ;
- ;
- .
Jó lenne, ha a közösség támogatná ezeket a PR-eket, hogy a következő operator verzióval (1.6) bekerülhessenek az upstreambe.
Bónusz! Sikerült történet a production migrációjáról
Ha Patroni-t használ, az operatorra élő production-ra lehet migrálni minimális leállással.
A Spilo lehetővé teszi a standby klaszterek létrehozását S3 tárolóknál a , amikor a PgSQL bináris napló először S3-ba kerül mentésre, majd egy replikával letölthető. De mi a teendő, ha nem a Wal-E már az öreg infrastruktúrában van? Ennek a problémának a megoldása már a hvg.hu-n.
Segítségként jön a PostgreSQL logikai replikáció. Ám nem akarunk belemerülni a publikációk és előfizetések létrehozásának részleteibe, mert… a tervünk kudarcot vallott.
A helyzet az, hogy az adatbázisban volt néhány leterhelt tábla több millió sorral, amelyek ráadásul folyamatosan töltődtek fel és törlődtek. a copy_data, amikor egy új replikának a mesterrel való tartalom másolása egyszerűen nem tartott lépést a mesterrel. A tartalom másolása egy hétig működött, de sosem érte utol a mestert. Végül a probléma megoldásában segített kollegáink az Avito-tól: az adatokat át lehet vinni a pg_dump. Leírom a mi (kicsit módosított) változatunkat ennek az algoritmusnak.
Az ötlet abban rejlik, hogy létrehozzunk egy kikapcsolt előfizetést, amely egy adott replikációs slotra van kötve, majd kijavítsuk a tranzakciós számot. Rendelkezésre álltak replikák a production működéséhez. Ez fontos, mert a replikák segítenek konzisztens dumpot létrehozni, és folytatni a változtatások nyerését a mestertől.
A következő parancsokban, amelyek a migrációs folyamatot írják le, az alábbi jelöléseket fogjuk használni a hosztokhoz:
- master — a forrás szerver;
- replica1 — a régi production-on lévő stream replika;
- replica2 — az új logikai replika.
A migrációs terv
1. Készítsük el a publikációt az összes táblához a master-en a schémában public adatbázis dbname:
psql -h master -d dbname -c "CREATE PUBLICATION dbname FOR ALL TABLES;"
2. Hozzunk létre replikációs slotot a master-en:
psql -h master -c "select pg_create_logical_replication_slot('repl', 'pgoutput');"
3. Állítsuk le a replikációt a régi replikán:
psql -h replica1 -c "select pg_wal_replay_pause();"
4. Szerezzük meg a tranzakciós számot a mestertől:
psql -h master -c "select replay_lsn from pg_stat_replication where client_addr = 'replica1';"
5. Készítsünk dumpot a régi replikáról. Több szálon fogjuk csinálni, ami felgyorsítja a folyamatot:
pg_dump -h replica1 --no-publications --no-subscriptions -O -C -F d -j 8 -f dump/ dbname
6. Töltsük fel a dumpot az új szerverre:
pg_restore -h replica2 -F d -j 8 -d dbname dump/
7. A dump feltöltése után elindíthatjuk a replikációt a stream replikán:
psql -h replica1 -c "select pg_wal_replay_resume();"
8. Hozzuk létre az előfizetést az új logikai replikán:
psql -h replica2 -c "create subscription oldprod connection 'host=replica1 port=5432 user=postgres password=secret dbname=dbname' publication dbname with (enabled = false, create_slot = false, copy_data = false, slot_name='repl');"
9. Szerezzük meg oid az előfizetéshez:
psql -h replica2 -d dbname -c "select oid, * from pg_subscription;"
10. Tegyük fel, hogy megkaptuk oid=1000. Alkalmazzuk a tranzakciós számot az előfizetésre:
psql -h replica2 -d dbname -c "select pg_replication_origin_advance('pg_1000', 'AA/AAAAAAAA');"
11. Indítsuk el a replikációt:
psql -h replica2 -d dbname -c "alter subscription oldprod enable;"
12. Ellenőrizzük az előfizetés státuszát, a replikációnak működnie kell:
psql -h replica2 -d dbname -c "select * from pg_replication_origin_status;"
psql -h master -d dbname -c "select slot_name, restart_lsn, confirmed_flush_lsn from pg_replication_slots;"
13. Miután a replikáció elindult és az adatbázisok szinkronba kerültek, végrehajtható a váltás.
14. A replikáció leállítása után ki kell javítani a szekvenciákat. Ezt jól leírják .
E tervnek köszönhetően a váltás minimális késleltetéssel zajlott le.
Zárás
A Kubernetes operátorok lehetővé teszik különböző műveletek egyszerűsítését, a K8s-erőforrások létrehozására redukálva őket. Azonban, miután lenyűgöző automatizálást értünk el velük, érdemes észben tartani, hogy ez váratlan árnyalatokat is hozhat, ezért bölcsen válasszuk meg az operátorokat.
A PostgreSQL számára legnépszerűbb három Kubernetes-operátor vizsgálatát követően a Zalando projektjére esett a választásunk. Bár bizonyos nehézségeket át kellett hidalnunk, az eredmény valóban örömteli volt, ezért tervezzük, hogy ezt a tapasztalatot néhány más PgSQL telepítésre is kiterjesztjük. Ha van tapasztalata hasonló megoldásokkal kapcsolatban — örömmel várjuk a részleteket a megjegyzések között!
P.S.
Olvasson további információkat a blogunkban:
- «»;
- «»;
- «».
Forrás: habr.com
