

Üdvözöljük újra! A cikk címe önmagáért beszél. A kurzus kezdete előtt ajánljuk, hogy nézzük meg, kik is azok a adatmérnökök. A cikk tele van hasznos hivatkozásokkal. Jó olvasást!
Egyszerű útmutató arról, hogyan ragadhatjuk meg a Data Engineering hullámát és hogyan kerülhetjük el, hogy elragadjon minket.
Úgy tűnik, hogy manapság mindenki adatkutató (Data Scientist) szeretne lenni. De mi a helyzet az Adatmérnökséggel (Data Engineering)? Lényegében ez egyfajta hibrid adat-analitikus és adatkutató; az adatkapcsoló főként a munkafolyamatok, feldolgozási vonalak és ETL- folyamatok kezeléséért felel.A funkciók fontosságát figyelembe véve ez jelenleg egy újabb népszerű szakmai zsargon, amely gyorsan terjed.
A magas fizetés és a hatalmas kereslet csupán egy része annak, ami miatt ez a munka rendkívül vonzó! Ha szeretne a hősök sorába lépni, sosem késő elkezdeni tanulni. Ebben a posztban összegyűjtöttem minden szükséges információt, hogy segítsen az első lépések megtételében.
Tehát, kezdjük el!
Mi az Adatmérnökség?
Őszintén szólva, nincs jobb magyarázat, mint ez:
«A tudós új csillagot fedezhet fel, de nem tudja azt létrehozni. Kérnie kell az mérnököt, hogy tegye meg helyette.»
–Gordon Lindsay Glegg
Így hát, az adatmérnök szerepe meglehetősen jelentős.
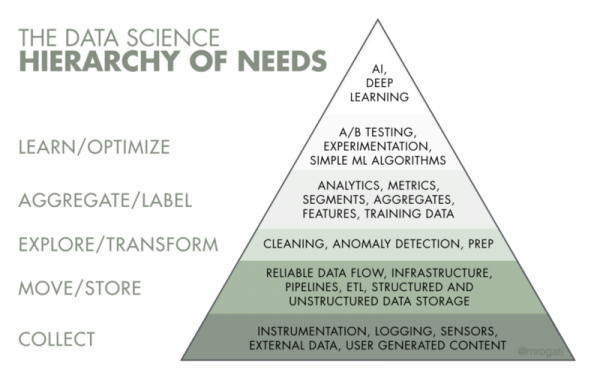
A névből adódóan az adatmérnökség az adatokkal foglalkozik, mégpedig azok szállításával, tárolásával és feldolgozásával. Ennek megfelelően az mérnökök fő feladata megbízható infrastruktúra biztosítása az adatok számára. Ha megnézzük az AI igényhierarchiáját, az adatmérnökség az első 2–3 lépést foglalja magában: adatgyűjtés, mozgatás és tárolás, adatok előkészítése.
Mivel foglalkozik az adatmérnök?
A Big Data megjelenésével a felelősségi kör drámaian megváltozott. Míg korábban ezek a szakemberek nagy SQL-lekérdezéseket írtak és adatokat transzformáltak olyan eszközökkel, mint az Informatica ETL, Pentaho ETL, Talend, addig most az adatmérnökökkel szembeni követelmények megnövekedtek.
A legtöbb cég, amely adatmérnöki pozíciókat hirdet, az alábbi elvárásokat támasztja:
- Kiváló SQL és Python ismeret.
- Tapasztalat felhőplatformokkal, különösen az Amazon Web Services-szel.
- Előny, ha van Java/Scala ismerete.
- Jó ismeret az SQL és NoSQL adatbázisokról (adatmodellzés, adatkezelés).
Tartsd észben, hogy ezek csak a legfontosabb dolgok. Ez a lista alapján feltételezhetjük, hogy az adatfeltárók a szoftverfejlesztés és a backend szakértői.
Például, ha egy vállalat nagy mennyiségű adatot kezd generálni különböző forrásokból, a te feladatod mint adatfeltáró az információk gyűjtésének, feldolgozásának és tárolásának megszervezése.
A használt eszközök listája eltérhet, mindez az adatok mennyiségétől, a beérkezés sebességétől és az eltérő formátumoktól függ. A legtöbb vállalat valójában nem találkozik nagy adatokkal, ezért az úgynevezett adat-tároló központosított tárolójaként SQL adatbázis (PostgreSQL, MySQL stb.) használható egy kis skripttel, amely az adatokat a tárolóba irányítja.
Az IT óriások, mint a Google, Amazon, Facebook vagy a Dropbox magasabb követelményeket támasztanak: a Python, Java vagy Scala ismerete.
- Tapasztalat a nagy adatokkal: Hadoop, Spark, Kafka.
- Algoritmusok és adatstruktúrák ismerete.
- A elosztott rendszerek alapjainak megértése.
- A vizualizációs eszközökkel, mint a Tableau vagy az ElasticSearch, kapcsolatos tapasztalat nagy előny lesz.
Ezért egyértelmű elmozdulás tapasztalható a nagy adatok felé, különösen a magas terhelések mellett történő feldolgozásukban. Ezeknek a cégeknek megnövekedett követelményeik vannak a rendszer megbízhatóságával kapcsolatban.
Adatfeltárók Vs. adatkutatók
Oké, ez egy egyszerű és szórakoztató összehasonlítás volt (semmi személyes), de valójában sokkal bonyolultabb a helyzet.
Először is tudnod kell, hogy sok homályos terület van az adatkutatók és az adatfeltárók szerepeinek és készségeinek megkülönböztetésében. Szóval könnyen zavarba jöhetsz abban, hogy milyen készségekre van szükség az eredményes adatfeltáráshoz. Természetesen vannak bizonyos készségek, amelyek átfedik egymást a két szerep között. De számos ellentétes készség is létezik.
Az adatok tudománya komoly dolog, de egy olyan világ felé haladunk a funkcionális adatok tudományával, ahol a gyakorlók képesek saját elemzéseiket végezni. A data pipeline-ok és az integrált adatszerkezetek működtetéséhez adatfeltárókra van szükséged, nem tudósokra.
Az adatfeltáró keresettebb, mint az adatkutató?
Igen, mert mielőtt elkészítheted a sárgarépa tortát, először összegyűjtened, megtisztítanod és készletezned kell a sárgarépát!
A dátumgépész jobban ért a programozáshoz, mint bármely adatkutató, de amikor statisztikáról van szó, minden pont az ellenkezője.
De itt van a dátumgépész előnye:
nélküle/nélküle a prototípus modell értéke, amely gyakran borzalmas minőségű kódrészlet egy Python fájlban, az adatkutatótól származik, és valahogyan eredményt ad, nulla felé törekszik.
Dátumgépész nélkül ez a kód soha nem válik projekté, és egyetlen üzleti probléma sem lesz hatékonyan megoldva. Az adatgépész megpróbálja mindezt termékké alakítani.
Alapvető ismeretek, amelyeket a dátumgépésznek tudnia kell
Tehát ha ez a munka felébreszti benned a világosságot, és tele vagy lelkesedéssel - képes vagy megtanulni ezt, elsajátíthatod az összes szükséges készséget, és igazi rockcsillag lehetsz az adatfejlesztés területén. Igen, ezt megteheted még programozási vagy egyéb technikai tudás nélkül is. Ez nehéz, de lehetséges!
Mik az első lépések?
Át kell látnod, hogy mi a mi.
Először is, a Dátumgépészet a számítástudományhoz tartozik. Konkrétan - értened kell a hatékony algoritmusokat és adatszerkezeteket. Másodszor, mivel a dátumgépészek az adatokkal dolgoznak, szükség van az adatbázisok alapelveinek megértésére és az alapjukban lévő struktúrákra.
Például a szokásos B-fás SQL adatbázisok a B-Fa adatszerkezeten alapulnak, valamint a modern elosztott adattárolók az LSM-Fán és más hashtáblák módosításain.
* Ezek a lépések Adil Hashtamov csodálatos cikkén alapulnak . Tehát ha tudsz oroszul, támogasd ezt az írót, és olvasd el .
1. Algoritmusok és adatszerkezetek
A megfelelő adatszerkezet használata jelentősen javíthatja az algoritmus teljesítményét. Ideális esetben mindannyiunknak iskoláskorban kellene tanulnunk az adatszerkezeteket és algoritmusokat, de ez ritkán kerül előtérbe. Mindenesetre soha nem késő megismerkedni vele.
Íme néhány kedvenc ingyenes kurzusom az adatszerkezetek és algoritmusok tanulmányozásához:
Plusz ne felejtsd el Thomas H. Cormen klasszikus algoritmusmunkáját — . Ez a tökéletes kézikönyv, amikor szükséged van egy kis felfrissítésre.
- A készségeid fejlesztéséhez használd a .
. Belemerülhetsz az adatbázisok világába a Carnegie Mellon Egyetem lenyűgöző YouTube videóival is:
- .
- .
2. SQL tanulmányozása
Az életünk mind adatokból áll. A médiából a kapcsolatfelvételhez egy nyelven kell "beszélned" velük.
Az SQL (Structured Query Language — Strukturált Lekérdező Nyelv) az adatok területén használt kommunikációs nyelv. Akárki bármit mond, az SQL régóta él, él, és még nagyon sokáig élni fog.
Ha régóta a fejlesztés terén dolgozol, valószínűleg észrevetted, hogy az SQL közelgő haláláról szóló pletykák időről időre felbukkannak. A nyelvet az 1970-es évek elején fejlesztették ki, és a mai napig rendkívül népszerű az elemzők, fejlesztők és egyszerű rajongók körében.
SQL ismerete nélkül az adatfeldolgozásban nem sokra mész, mivel elkerülhetetlen, hogy lekérdéseket készíts az adatok kinyerésére. Minden modern nagy adat tároló SQL-t támogat:
- Amazon Redshift
- HP Vertica
- Oracle
- SQL Server
… és még sok más.
A nagy mennyiségű adat elemzésére, amelyek elosztott rendszerekben, például HDFS-ben találhatók, SQL mechanizmusokat találtak ki: Apache Hive, Impala stb. Látod, nem fog eltűnni.
Hogyan tanulj meg SQL-t? Csak gyakorold.
Ehhez ajánlanám, hogy nézd meg a nagyszerű, ráadásul ingyenes, .
E tanfolyamok jellemzője az interaktív környezet, ahol közvetlenül a böngészőben írhatsz és futtathatsz SQL lekérdéseket. A nem lesz felesleges. És ezeket a tudásokat alkalmazhatod a az Adatbázisok részlegében.
3. Python és Java/Scala programozás
Miért érdemes megtanulni a Python programozási nyelvet, már írtam a . Ami a Java-t és Scalát illeti, a hatalmas adatmennyiségek tárolására és feldolgozására szolgáló eszközök többsége ezeken a nyelveken lett megírva. Például:
- Apache Kafka (Scala)
- Hadoop, HDFS (Java)
- Apache Spark (Scala)
- Apache Cassandra (Java)
- HBase (Java)
- Apache Hive (Java)
Ahhoz, hogy megértsd, hogyan működnek ezek az eszközök, ismerned kell azokat a nyelveket, amelyekben írták őket. A Scala funkcionális megközelítése hatékonyan segít a párhuzamos adatfeldolgozási feladatok megoldásában. A Python sajnos nem büszkélkedhet a sebességével és a párhuzamos feldolgozásával. Összességében a több nyelv és programozási paradigma ismerete jótékony hatással van a problémamegoldási megközelítések széles körére.
Ha bele akarsz merülni a Scala nyelvébe, olvashatsz a nyelv szerzőjétől. A Twitter is közzétett egy jó bevezető útmutatót — .
A Pythonról azt gondolom, hogy a a legjobb középszintű könyv.
4. Eszközök a nagy adatokkal való munkához
Íme a legnépszerűbb eszközök listája a nagy adatok világában:
- Apache Spark
- Apache Kafka
- Apache Hadoop (HDFS, HBase, Hive)
- Apache Cassandra
További információk a nagy adatblokkok építéséről találhatók ebben a csodálatos . A legnépszerűbb eszközök a Spark és a Kafka. Ezért érdemes őket tanulmányozni, és lehetőleg megérteni, hogyan működnek belülről. Jay Kreps (a Kafka társszerzője) 2013-ban egy monumentális munkát jelentetett meg , amúgy a táblázat főbb ötleteit használták fel az Apache Kafka létrehozásához.
- Bevezetésként szolgálhat a Hadoophoz .
- Számomra a legátfogóbb útmutató az Apache Sparkhoz — .
5. Felhőplatformok
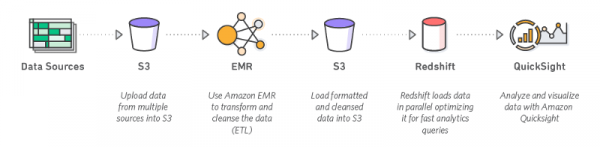
Legalább egy felhőplatform ismerete alapvető követelmény a adatmérnöki pozícióra való pályázók számára. A munkáltatók az Amazon Web Services-t részesítik előnyben, a második helyen a Google felhőplatformja áll, és a dobogó harmadik fokán a Microsoft Azure végzett.
Jól kell tájékozódnod az Amazon EC2, AWS Lambda, Amazon S3, DynamoDB terén.
6. Elosztott rendszerek
A nagy adatokkal való munka függetlenül működő számítógépek klasztereinek meglétét igényli, amelyek közötti kapcsolat a hálózaton keresztül valósul meg. Minél nagyobb a klaszter, annál nagyobb a valószínűsége, hogy a tagjainak egyik csomópontja hibát jelez. Ahhoz, hogy nagyszerű adat szakértővé válj, elmélyülten kell foglalkoznod a problémákkal és a meglévő megoldásokkal az elosztott rendszerek terén. Ez a terület régi és összetett.
Andrew Tanenbaum a terület úttörőjének számít. Azok számára, akik nem félnek a elmélettől, ajánlom a könyvét , kezdők számára talán bonyolultnak tűnhet, de valóban segít a készségeid tökéletesítésében.
Azt gondolom a legjobb bevezető könyv. Egyébként Martinnek van egy nagyszerű . Munkája segít rendszerezni a modern infrastruktúra építésével kapcsolatos ismereteket a nagyméretű adatok tárolására és feldolgozására.
Azok számára, akik szeretnek videókat nézni, a Youtube-on van egy kurzus .
7. Adatcsatornák
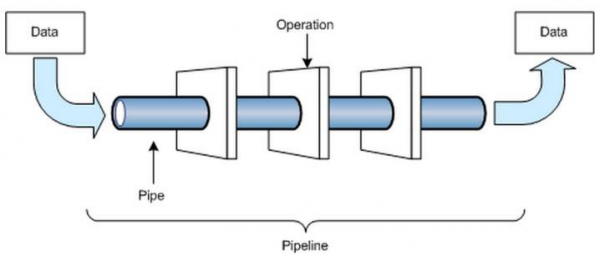
Az adatcsatornák nélkülözhetetlenek egy adatmérnök számára.
Az adatmérnök többször úgynevezett adatcsatornát épít, ami azt jelenti, hogy egy folyamatot hoz létre az adatok egy helyről a másikra történő szállítására. Ez lehet felhasználói forgatókönyvek, amelyek egy külső szolgáltatás API-jához kapcsolódnak, SQL-lekérdezéseket készítenek, kiegészítik az adatokat, és azokat egy központosított tárolóba (adatazár) vagy egy strukturálatlan adathordozóba (adataóceán) helyezik.
Összefoglalva: az adatmérnök fő ellenőrzőlistája
Összefoglalva: jó megértésre van szükség a következőkről:
- Információs rendszerek;
- Szoftverfejlesztés (Agile, DevOps, Tervezési technikák, SOA);
- Elosztott rendszerek és párhuzamos programozás;
- Adatbázisok alapjai – tervezés, kivitelezés, üzemeltetés és hibaelhárítás;
- Kísérletek tervezése – A/B tesztelések koncepciók igazolására, megbízhatóság, rendszerek teljesítményének meghatározására, valamint megbízható módszerek kidolgozására a jó megoldások gyors biztosításához.
Ezek csak néhány követelmény ahhoz, hogy adatmérnök lehess, így tanulmányozz és ismerd meg az adatkezelési rendszereket, információs rendszereket, folyamatos kézbesítést / telepítést / integrációt, programozási nyelveket és egyéb informatikai témákat (nem minden tantárgyban).
És végül, de nem utolsósorban, amit mondani szeretnék.
A Data Engineering pálya nem olyan egyszerű, mint amilyennek látszik. Nem kímél, frusztráló, és készen kell állni erre. Az út során vannak olyan pillanatok, amelyek arra ösztönözhetnek, hogy mindent feladj. De ez valójában egy kemény munka és tanulási folyamat.
Csak ne szépítse meg az elején. Az egész utazás lényege, hogy minél többet tanuljon és felkészüljön az új kihívásokra.
Íme egy remek kép, amellyel találkoztam, és amely jól szemlélteti ezt a pillanatot:
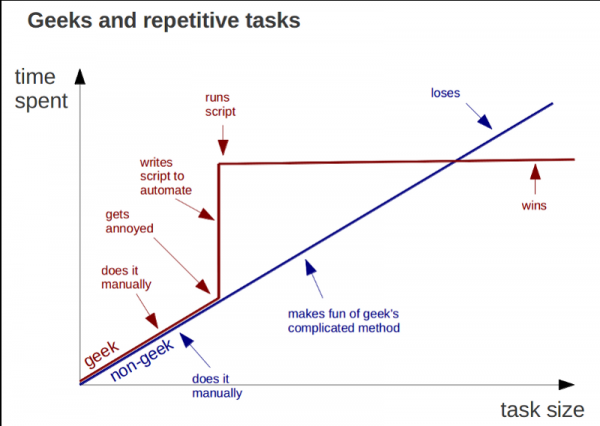
Igen, és ne felejtsen el elkerülni a kiégést és pihenjen. Ez is nagyon fontos. Sok sikert!
Mi a véleményetek a cikkről, barátok? Meghívunk a , amely már ma 20:00-kor kerül megrendezésre. A webinárium keretein belül arról beszélgetünk, hogyan építhetünk hatékony és skálázható adatfeldolgozási rendszert egy kisvállalat vagy startup számára minimális költségekkel. Gyakorlásképpen megismerkedünk a Google Cloud adatfeldolgozó eszközeivel. Találkozunk!
Forrás: habr.com
