

A CI/CD implementálásának tipikus feltétele a Kubernetesben: az alkalmazásnak képesnek kell lennie arra, hogy a teljes leállás előtt ne fogadjon új ügyfélkéréseket, de a legfontosabb dolog, hogy sikeresen befejezze a már meglévőket.
Ennek a feltételnek a betartása lehetővé teszi a nullás leállás elérését a telepítés során. Azonban, még a nagyon népszerű kombinációk (mint például NGINX és PHP-FPM) használata esetén is előfordulhatnak olyan nehézségek, amelyek hibapróblémákhoz vezetnek minden telepítés során...
Elmélet. Hogyan él a pod
Részletesen a pod életciklusáról már publikáltunk . A vizsgált téma kontextusában minket a következő érdekel: abban a pillanatban, amikor a pod átlép a Terminatingállapotba, új kéréseket már nem fogad el (a pod a szolgáltatás végpontjainak listájából). Így a telepítés során a leállás elkerülése érdekében csak a megfelelő alkalmazásleállítási problémát kell megoldanunk.
Fontos megjegyezni, hogy az alapértelmezett grace period : ezután a pod terminálva lesz, és az alkalmazásnak addigra el kell végeznie az összes kérés feldolgozását. Megjegyzés: bár bármely kérés, amely több mint 5-10 másodpercig tart, már problémás, és a graceful shutdown nem segít rajta...
Ahhoz, hogy jobban megértsük, mi történik, amikor a pod leáll, elegendő megvizsgálni a következő ábrát:
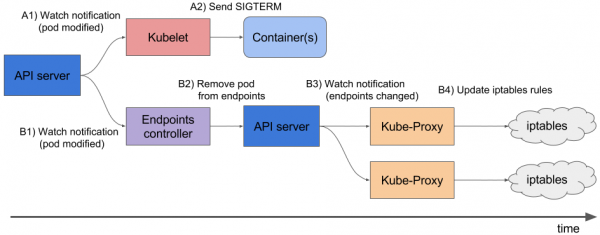
A1, B1 — A pod állapotváltozásainak fogadása
A2 — SIGTERM jeladás küldése
B2 — A pod eltávolítása a végpontokból
B3 — Változások fogadása (a végpontok listája megváltozott)
B4 — Az iptables szabályainak frissítése
Vegye figyelembe: a pod végpont eltávolítása és a SIGTERM jeladás párhuzamosan történik, nem egymás után. Mivel az Ingress nem azonnal kapja meg a frissített végpontlistát, az ügyfelektől új kérések érkeznek a podra, ami 500-as hibákhoz vezet a pod terminálása alatt. (erről a kérdésről részletesebb anyagot már ). E problémát a következő módokon kell kezelni:
- A válasz fejlécében küldjön Connection: close-t (ha ez HTTP-alkalmazásra vonatkozik).
- Ha nincs lehetőség a kód módosítására, akkor a cikk további részében leírt megoldás lehetővé teszi a kérések feldolgozását a graceful period végéig.
Elmélet. Hogyan zárja le a folyamatokat az NGINX és a PHP-FPM
NGINX
Kezdjük az NGINX-szel, mert vele minden viszonylag egyértelmű. A teória mélyére hatolva megtudjuk, hogy az NGINX-nek van egy főfolyamatja és több „munkás” - ezek az alfolyamatok, amelyek a klienskéréseket kezelik. Kényelmes lehetőség áll rendelkezésre: a következő parancs segítségével nginx -s leállíthatjuk a folyamatokat gyors leállítási vagy gördülékeny leállítási módban. Nyilvánvaló, hogy minket az utolsó változat érdekel.
Ezután minden egyszerű: hozzá kell adni a a parancsnak, amely a gördülékeny leállítási jelet küldi. Ezt meg lehet tenni a Deploymentben, a konténer blokkjában:
       lifecycle:
          preStop:
            exec:
              command:
              - /usr/sbin/nginx
              - -s
              - quit
Most, amikor a pod leállásra kerül, az NGINX konténerének naplóiban ezt fogjuk látni:
2018/01/25 13:58:31 [notice] 1#1: signal 3 (SIGQUIT) received, shutting down
2018/01/25 13:58:31 [notice] 11#11: gracefully shutting down
És ez azt fogja jelenteni, amire szükségünk van: az NGINX vár a kérések teljesítésére, majd megöli a folyamatot. Mindazonáltal, alább egy elterjedt probléma is tárgyalásra kerül, amely miatt még a parancs megléte ellenére is nginx -s quit a folyamat helytelenül áll le.
És ezen a ponton befejeztük az NGINX-et: legalább a naplók alapján megérthetjük, hogy minden úgy működik, ahogy kell.
Hogyan állnak a dolgok a PHP-FPM-mel? Hogyan hajtja végre a gördülékeny leállítást? Nézzük meg közelebbről.
PHP-FPM
A PHP-FPM esetében kevesebb információ áll rendelkezésre. Ha az szerint nézzük, akkor abban a következő POSIX-jelek szerepelnek:
-
Néhány szó a parancsok kimenetéről,SIGTERM— gyors leállítás; -
SIGQUIT— gördülékeny leállítás (amire szükségünk van).
A fennmaradó jelek erre a feladatra nem szükségesek, ezért a továbbiakra nem térünk ki. A folyamat helyes leállításához a következő preStop-hókot kell írni:
        lifecycle:
          preStop:
            exec:
              command:
              - /bin/kill
              - -SIGQUIT
              - "1"
Első pillantásra ez minden, ami szükséges a gördülékeny leállításhoz mindkét konténerben. Mégis, a feladat bonyolultabb, mint amilyennek látszik. A következőkben két esetet tárgyalunk, amelyekben a gördülékeny leállítás nem működött, és átmeneti elérhetetlenséget okozott a projektben a telepítés során.
Gyakorlat. Lehetséges problémák a gördülékeny leállítással kapcsolatban
NGINX
Először is hasznos tudni: a parancs végrehajtása mellett nginx -s quit Van egy másik lépés is, amit érdemes figyelembe venni. Találkoztunk a problémával, amikor az NGINX a SIGQUIT jelzés helyett mégis SIGTERM-et küldött, így a kérések nem zárultak le megfelelően. Hasonló esetek találhatók például . Sajnos a viselkedés konkrét okát nem tudtuk megállapítani: gyanú merült fel az NGINX verziójával kapcsolatban, de ez nem igazolódott be. A tünetek abban nyilvánultak meg, hogy az NGINX konténer logjaiban a következő üzenetek voltak láthatóak: „open socket #10 left in connection 5”, majd a pod leállt.
Ezt a problémát megfigyelhetjük például a szükséges Ingress válaszaiban:
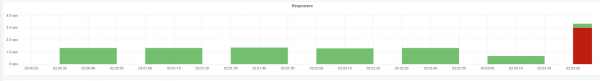
A státuszkódok mérőszámai a telepítés pillanatában
Ebben az esetben éppen 503-as hiba kódot kapunk az Ingress-től: nem tud hozzáférni az NGINX konténerhez, mivel az már nem elérhető. Ha megnézünk az NGINX konténer logjait, az alábbiakat láthatjuk:
[alert] 13939#0: *154 open socket #3 left in connection 16
[alert] 13939#0: *168 open socket #6 left in connection 13
A stopp jel megváltoztatása után a konténer megfelelően kezd el leállni: ezt az is megerősíti, hogy már nem észlelünk 503-as hibát.
Ha hasonló problémával találkozik, érdemes utánanézni, hogy milyen stopp jelzést használnak a konténerben, és hogyan néz ki a preStop-hook. Előfordulhat, hogy az ok pontosan itt rejlik.
PHP-FPM... és nem csak
A PHP-FPM problémája egyszerűen leírható: nem várja meg a gyermekfolyamatok befejezését, hanem azokat leállítja, ami 502-es hibákhoz vezet a telepítések és más műveletek során. A bugs.php.net oldalon 2005 óta több hibaüzenet található (például és ), amelyekben ezt a problémát írják le. A logokban valószínűleg nem fog látni semmit: a PHP-FPM a saját folyamata befejeződését hibaüzenetek vagy külső értesítések nélkül hirdeti.
Érdemes pontosítani, hogy maga a probléma kisebb vagy nagyobb mértékben függhet az alkalmazástól, és például nem nyilvánulhat meg a monitorozás során. Ha mégis szembesül vele, akkor először a következő egyszerű workaround jut eszünkbe: adjunk hozzá egy preStop-hook-ot a sleep(30)parancsnak. Ez lehetővé teszi, hogy befejezzük az összes korábbi kérést (újakat már nem fogadunk, mivel a pod már a következő állapotban van Terminating), és 30 másodperc elteltével a pod maga leáll a SIGTERM.
Ezért a lifecycle a konténer számára így fog kinézni:
    lifecycle:
      preStop:
        exec:
          command:
          - /bin/sleep
          - "30"
Azonban a 30 másodperces határidő megadása miatt sleep mi jelentősen megnöveljük a telepítési időt, mivel minden pod leállításra kerül minimum 30 másodperc, ami nem ideális. Mit tehetünk ezzel kapcsolatban?
Forduljunk az alkalmazás végrehajtásáért felelős oldalhoz. Ebben az esetben ez PHP-FPM, ami alapértelmezés szerint nem figyeli a child-folyamatainak végrehajtását: a mester-folyamat azonnal leáll. Ezt a viselkedést a process_control_timeoutdirektíva módosításával lehet megváltoztatni, amely az alfolyamatok számára a mesterből érkező jelzések várakozási időkorlátját adja meg. Ha az érték 20 másodpercre van állítva, ez a legtöbb, a konténerben végrehajtott kérés lefedésére fog szolgálni, és miután azok befejeződtek, a mester-folyamat leáll.
Ezzel az információval térjünk vissza az utolsó problémánkhoz. Ahogy már említettük, a Kubernetes nem monolitikus platform: a különböző komponensei közötti interakcióra időre van szükség. Ez különösen releváns, amikor az Ingress-ek és más kapcsolódó komponensek működését vizsgáljuk, mivel ezen késedelem miatt a telepítés pillanatában könnyen 500-as hibák robbanásához vezethet. Például a hiba előfordulhat az upstream felé küldött kérés szakaszában, de a komponensek közötti interakció „időbeli késése” meglehetősen rövid — kevesebb, mint egy másodperc.
Ezért, összességében az előbb említett direktívával process_control_timeout a következő szerkezet használatára lehet lehetőség lifecycle:
lifecycle:
  preStop:
    exec:
      command: ["/bin/bash","-c","/bin/sleep 1; kill -QUIT 1"]
Ebben az esetben a késedelmet a parancs által kompenzáljuk sleep és nem növeljük meg túlságosan a telepítési időt: hiszen érzékelhető a különbség a 30 másodperc és az egy másodperc között?.. Valójában a „fő feladatot” éppen process_control_timeout, és lifecycle csak biztosítékként használják a késedelem esetére.
Általánosságban elmondható, hogy a leírt viselkedés és a megfelelő workaround nemcsak a PHP-FPM-re vonatkozik. Hasonló helyzet más programozási nyelvek vagy keretrendszerek használatakor is felmerülhet. Ha más módon nem lehet megoldani a graceful shutdown-t — például a kód újbóli írásával, hogy az alkalmazás helyesen kezelje a leállítási jeleket — a fent említett módszert lehet alkalmazni. Bár nem a legszebb megoldás, de működik.
Gyakorlat. Terhelési tesztelés a pod működésének ellenőrzésére
A terhelési tesztelés az egyik módszer a konténerek működésének ellenőrzésére, mivel ez az eljárás közelíti a valós harci körülményekhez, amikor a felhasználók belépnek az oldalra. A fenti ajánlások teszteléséhez használhatók : nagyszerűen kielégíti minden igényünket. Az alábbiakban tippek és ajánlások találhatók a tesztelés elvégzéséhez, vizuális példával — a Grafana grafikonoknak és a Yandex.Tanknak köszönhetően — tapasztalatainkból.
A legfontosabb itt lépésről lépésre ellenőrizni a változásokat. Az új javítás hozzáadása után indítsa el a tesztelést, és nézze meg, hogy változtak-e az eredmények az előző futáshoz képest. Ellenkező esetben nehéz lesz azonosítani a nem hatékony megoldásokat, és a jövőben csak kárt okozhatunk (például megnövelhetjük a telepítési időt).
Egy másik szempont — nézze a konténer naplóit a megszüntetés során. Rögzítve van-e ott információ a graceful shutdown-ról? Vannak-e hibaüzenetek más erőforrások (például a szomszédos PHP-FPM konténer) elérhetőségekor? Az alkalmazás hibái (mint az előző NGINX-es esetben)? Remélem, hogy a cikk bevezető információja segít jobban megérteni, mi történik a konténerrel a megszüntetése során.
Tehát, a tesztelés első futása lifecycle és kiegészítő irányelvek nélkül a webalkalmazás szerver számára (process_control_timeout a PHP-FPM-ben). Ennek a tesztnek a célja a hibák nagyságrendjének felmérése volt (és hogy léteznek-e egyáltalán). További információként tudni kell, hogy minden pod teljes készenlétének eléréséhez szükséges átlagos telepítési idő körülbelül 5-10 másodperc volt. Az eredmények a következők:
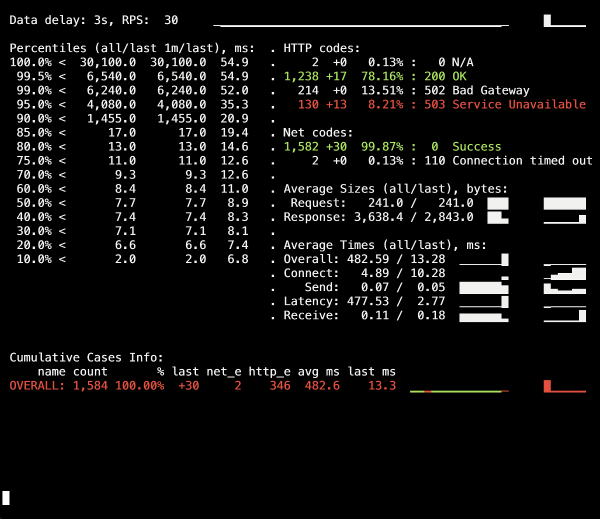
A Yandex.Tank információs panelén látható egy 502 hibákra utaló kiugrás, amely a telepítés pillanatában történt, és átlagosan 5 másodpercig tartott. Feltételezhető, hogy a meglévő kérések megszakadtak a régi pod felbontásakor. Ezt követően jelentkeztek a 503 hibák, ami a leállított NGINX konténer következménye volt, amely szintén megszakította a kapcsolatokat a backend miatt (amiért az Ingresshez nem tudott csatlakozni).
Nézzük meg, hogyan process_control_timeout a PHP-FPM segíthet bennünket a child-procesecek befejezésének megvárásában, azaz a hibák kijavításában. Ismételt telepítés már ennek az irányelvnek a használatával:
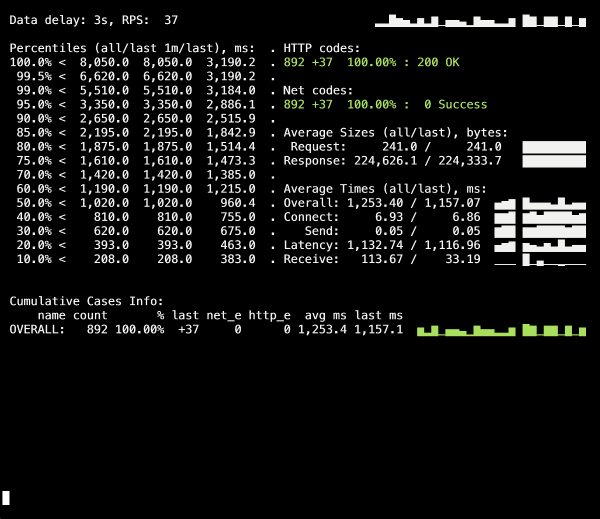
A deploy során már nincsenek 500-as hibák! A telepítés sikeresen zajlik, a graceful shutdown működik.
De érdemes megjegyezni az Ingress konténerekkel kapcsolatos pillanatokat, ahol egy kis százalékos hibát tapasztalhatunk a ideiglenes késlekedések miatt. Azok elkerülésére érdemes hozzáadni egy szerkezetet, amely sleep és megismételni a telepítést. Azonban a mi konkrét esetünkben nem volt látható változás (még mindig nincsenek hibák).
Zárás
A folyamat helyes befejezéséhez a következő viselkedést várjuk el az alkalmazástól:
- Várjon néhány másodpercet, majd ne fogadjon új kapcsolatokat.
- Várja meg az összes kérés befejezését és zárja le az összes keepalive kapcsolatot, amelyek nem teljesítik a kéréseket.
- Fejezze be a folyamatát.
Azonban nem minden alkalmazás tud így működni. A Kubernetes valóságában a probléma egyik megoldása:
- pre-stop hook hozzáadása, amely néhány másodpercig várakozik;
- a backendünk konfigurációs fájljának áttekintése a megfelelő paraméterek tekintetében.
Az NGINX példája azt mutatja, hogy még egy olyan alkalmazás is, amelynek elvileg helyesen kell kezelnia a leállítási jeleket, ezt nem teszi meg, ezért kritikus a 500-as hibák ellenőrzése az alkalmazás telepítése során. Ez lehetővé teszi, hogy szélesebb perspektívából tekintsünk a problémára, és ne koncentráljunk egy adott pod-ra vagy konténerre, hanem az egész infrastruktúrát nézzük.
Tesztelésre eszközként használhatjuk a Yandex.Tank-t bármilyen monitorozó rendszerrel (a mi esetünkben a Grafana-ból származó adatokat használtuk Prometheus backenddel). A graceful shutdown problémái jól láthatók nagy terhelések alatt, amelyeket a benchmark generálhat, és a monitorozás segít részletesebben elemezni a helyzetet a teszt során vagy után.
A cikkhez érkezett visszajelzésekre válaszolva szeretném leszögezni, hogy a problémák és megoldásaik itt az NGINX Ingress-re vonatkoznak. Más esetekben más megoldások léteznek, amelyeket talán a következő ciklus anyagaiban vizsgálunk.
P.S.
Más a K8s tippek & trükkök ciklusból:
- «»;
- «»;
- «»;
- «».
Forrás: habr.com
