

Megjegyzés fordítás.: Ez a cikk, amelyet Galo Navarro írt, aki a Adevinta európai cég fő szoftverfejlesztője, egy lenyűgöző és tanulságos „nyomozás” az infrastruktúra üzemeltetés területén. Az eredeti cím fordításkor kissé kiegészítésre került, amit a szerző az elején magyaráz.
a tidyverse könyvtár hivatalos weboldaláról.: Úgy tűnik, ez a publikáció mint vártuk. Még mindig kapok dühös megjegyzéseket amiatt, hogy a cikk címe félrevezető, és hogy néhány olvasó csalódott. Megértem az okokat, ezért annak ellenére, hogy kockáztatom az egész titok elrontását, azonnal el szeretném mondani, miről szól ez a cikk. Amikor a csapatok átálltak a Kubernetesre, egy érdekes dolgot figyeltem meg: minden alkalommal, amikor probléma merül fel (például a késleltetés növekedése a migráció után), először a Kubernetes-t hibáztatják, de később kiderül, hogy az orchestrasítás nem is felelős. Ez a cikk egy ilyen esetről szól. A címe megismétli az egyik fejlesztőnk felkiáltását (majd biztosan látni fogjátok, hogy a Kubernetes ebben az esetben egyáltalán nem a hunyó). A cikkben nem található váratlan felfedezés a Kubernetesről, de számíthattok néhány jó leckére a bonyolult rendszerekkel kapcsolatban.
Két héttel ezelőtt a csapatom egy mikroszolgáltatás migrálásával foglalkozott a fő platformra, amely CI/CD-t, Kubernetes alapú munkakörnyezetet, metrikákat és egyéb hasznos dolgokat tartalmazott. A költöztetés próbaverzió volt: azt terveztük, hogy ezt az alapot használjuk, és a következő hónapokban körülbelül 150 további szolgáltatást migrálunk. Ezek mind Spanyolország legnagyobb online platformjaiért felelősek (Infojobs, Fotocasa stb.).
Miután telepítettük az alkalmazást a Kubernetesbe és egy részét a forgalomnak átirányítottuk, egy aggasztó meglepetés várt ránk. A késleltetés (latency) a Kubernetesben tízszer magasabb volt, mint az EC2-ben. Összességében vagy meg kellett találni a probléma megoldását, vagy le kellett mondani a mikroszolgáltatás migrálásáról (és esetleg az egész projektről).
Miért olyan magas a késleltetés a Kubernetesben, mint az EC2-ben?
Ahhoz, hogy megtaláljuk a szűk keresztmetszetet, összegyűjtöttük a metrikákat a kérés útján. Az architektúránk egyszerű: az API-gateway (Zuul) a kérdéseket proxyzza az EC2 vagy Kubernetes mikroszolgáltatás példányaihoz. A Kubernetesben az NGINX Ingress Controller-t használjuk, míg a backendek sima Spring-alapú JVM-alkalmazások. JVM-alkalmazással a Spring platformon.
                                  EC2
                            +---------------+
                            |  +---------+  |
                            |  |         |  |
                       +-------> BACKEND |  |
                       |    |  |         |  |
                       |    |  +---------+  |
                       |    +---------------+
             +------+  |
Public       |      |  |
      -------> ZUUL +--+
traffic      |      |  |              Kubernetes
             +------+  |    +-----------------------------+
                       |    |  +-------+      +---------+ |
                       |    |  |       |  xx  |         | |
                       +-------> NGINX +------> BACKEND | |
                            |  |       |  xx  |         | |
                            |  +-------+      +---------+ |
                            +-----------------------------+
Úgy tűnt, hogy a probléma a backend kezdeti munkafázisának késlekedésével volt összefüggésben (a problémás részt a grafikonon „xx”-ként jelöltem meg). Az EC2-ben az alkalmazás válasza körülbelül 20 ms-ot vett igénybe. Kubernetes alatt a késlekedés 100-200 ms-ra nőtt.
Gyorsan kizártuk a valószínű gyanúsítottakat, amelyek a futtatási környezet változásával voltak összefüggésben. A JVM verziója változatlan maradt. A konténerizálással kapcsolatos problémák sem játszottak szerepet: az alkalmazás már sikeresen futott konténerekben az EC2-ben. Terhelés? De még 1 kérés másodpercenként is magas késlekedéseket tapasztaltunk. A szemétgyűjtés közben fellépő szünetek is elhanyagolhatók voltak.
Az egyik Kubernetes adminisztrátorunk megkérdezte, hogy van-e az alkalmazásnak külső függősége, mivel a múltban a DNS-nek címzett kérdések hasonló problémákat okoztak.
Hipotézis 1: DNS névfeloldás
Minden kérésnél az alkalmazásunk 1-3 alkalommal hív meg egy AWS Elasticsearch példányt egy olyan tartományban, mint a elastic.spain.adevinta.com. A konténereken belül van , így ellenőrizhetjük, hogy a névkeresés valóban hosszú időt vesz-e igénybe.
DNS-kérdések a konténerből:
[root@be-851c76f696-alf8z \/]# while true; do dig "elastic.spain.adevinta.com" | grep time; sleep 2; done
;; Query time: 22 msec
;; Query time: 22 msec
;; Query time: 29 msec
;; Query time: 21 msec
;; Query time: 28 msec
;; Query time: 43 msec
;; Query time: 39 msec
Hasonló kérelmek egy EC2 példány egyikéből, ahol az alkalmazás fut:
bash-4.4# while true; do dig "elastic.spain.adevinta.com" | grep time; sleep 2; done
;; Query time: 77 msec
;; Query time: 0 msec
;; Query time: 0 msec
;; Query time: 0 msec
;; Query time: 0 msec
Figyelembe véve, hogy a keresés körülbelül 30 ms-ot vesz igénybe, világossá vált, hogy a DNS feloldása az Elasticsearch-hez való kapcsolódáskor valóban hozzájárul a késleltetés növekedéséhez.
Ugyanakkor ez furcsa volt két okból:
- Már rengeteg Kubernetes-alkalmazásunk van, amelyek kapcsolatban állnak az AWS erőforrásaival, de nem szenvednek jelentős késésektől. Akármi legyen is az oka, az konkrétan ehhez az esetre vonatkozik.
- Tudjuk, hogy a JVM in-memory DNS gyorsítást végez. A képeinkben az TTL értéke a következőben van megadva:
$JAVA_HOME/jre/lib/security/java.securityés 10 másodpercre van beállítva:networkaddress.cache.ttl = 10. Más szavakkal, a JVM-nek 10 másodpercig kell gyorsítania az összes DNS-lekérdezést.
Az első hipotézis megerősítésére úgy döntöttünk, hogy ideiglenesen lemondunk a DNS-lekérdezésekről, és megnézzük, eltűnik-e a probléma. Először át kellett konfigurálnunk az alkalmazást, hogy közvetlenül az Elasticsearch-hoz kapcsolódjon IP-címen, nem pedig domain néven. Ez kódmódosítást és új telepítést igényelt volna, ezért egyszerűen hozzárendeltük a domaint az IP-címéhez: /etc/hosts:
34.55.5.111 elastic.spain.adevinta.comMost a konténer szinte azonnal kapott IP-t. Ez némi javulást hozott, de csak kicsit közelítettünk a várt késleltetési szinthez. Bár a DNS-felbontás sok időt vett igénybe, a valódi ok továbbra is elkerülte a figyelmünket.
Hálózati diagnosztika
A konténerből érkező forgalom elemzésére úgy döntöttünk, hogy tcpdumphasználjuk, hogy nyomon követhessük, mi is történik a hálózaton:
[root@be-851c76f696-alf8z /]# tcpdump -leni any -w capture.pcap Ezután elküldtünk néhány kérést és letöltöttük a capture-t (kubectl cp my-service:/capture.pcap capture.pcap) további elemzés céljából .
A DNS-lekérdezésekben nem volt semmi gyanús (kivéve egy apróságot, amiről később beszélek). De bizonyos furcsaságok voltak abban, ahogyan a szolgáltatásunk kezelte az egyes kéréseket. Az alábbiakban látható egy capture képernyőfotoja, amely a kérés fogadását mutatja az válasz kezdete előtt:
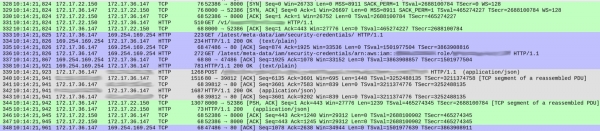
A csomagszámok az első oszlopban találhatók. Az egyértelműség kedvéért külön színekbe emeltem ki a különböző TCP-tömböket.
A zöld tömb, amely a 328. csomaggal kezdődik, megmutatja, hogyan állította fel a kliens (172.17.22.150) a TCP-kapcsolatot a konténerrel (172.17.36.147). Az első kézfogás után (328-330) a 331. csomag hozott HTTP GET /v1/.. – a szolgáltatásunkhoz beérkező kérést. Az egész folyamat 1 ms-ig tartott.
A szürke tömb (a 339. csomagtól) megmutatja, hogy a szolgáltatásunk HTTP-kérést küldött az Elasticsearch példányának (nincs TCP-kézfogás, mivel már létező kapcsolatot használunk). Ennek 18 ms-ig tartott.
Eddig minden rendben van, és az idők nagyjából megfelelnek a várt késéseknek (20-30 ms a kliens méréseivel).
A kék szakasz azonban 86 ms-t foglal el. Mi történik benne? A 333-as csomaggal szolgáltatásunk HTTP GET-kérést indított a /latest/meta-data/iam/security-credentials, majd ezt követően ugyanazon a TCP-kapcsolaton még egy GET-kérést a /latest/meta-data/iam/security-credentials/arn:...
Megállapítottuk, hogy ez minden egyes kérésnél megismétlődik az egész nyomvonalban. A DNS-feldolgozás valóban egy kicsit lassabb a konténereinkben (az ennek a jelenségnek az magyarázata rendkívül érdekes, de ezt fenntartom egy külön cikkhez). Kiderült, hogy a nagy késések oka az AWS Instance Metadata szolgáltatásának minden kérésnél való megkeresése.
2. hipotézis: felesleges megkeresések az AWS-hez
Mindkét végpont a -hoz tartozik. Mikroservice-ünk ezt a szolgáltatást használja, amikor az Elasticsearch-szel dolgozik. Mindkét hívás a hitelesítési folyamat alapvető részét képezi. Az első kérésnél megkeresett végpont adja vissza az IAM szerepet, amely az instán kapcsolódik.
/ # curl http://169.254.169.254/latest/meta-data/iam/security-credentials/
arn:aws:iam::<account_id>:role/some_role
A második kérés a második végponthoz fordul, hogy ideiglenes jogosultságokat kérjen az adott példányhoz:
/ # curl http://169.254.169.254/latest/meta-data/iam/security-credentials/arn:aws:iam::<account_id>:role/some_role`
{
    "Code" : "Success",
    "LastUpdated" : "2012-04-26T16:39:16Z",
    "Type" : "AWS-HMAC",
    "AccessKeyId" : "ASIAIOSFODNN7EXAMPLE",
    "SecretAccessKey" : "wJalrXUtnFEMI/K7MDENG/bPxRfiCYEXAMPLEKEY",
    "Token" : "token",
    "Expiration" : "2017-05-17T15:09:54Z"
}
A kliens ezekkel egy rövid ideig használhatja, és időről időre új tanúsítványokat kell kérnie (azok Expiration). A modell egyszerű: az AWS gyakori rotációt végez az ideiglenes kulcsokkal a biztonság érdekében, de a kliensek ezeket pár percig cache-elhetik, kompenzálva ezzel az új tanúsítványok megszerzésével kapcsolatos teljesítménycsökkenést.
Az AWS Java SDK-nak kellene kezelnie ennek a folyamatnak a megszervezését, de valamiért ez nem történik meg.
Github-on végzett keresésünk során rátaláltunk egy problémára . Ez segített meghatározni, hogy merre kellene "ásni" tovább.
Az AWS SDK frissíti a tanúsítványokat, amikor az alábbi feltételek egyikének bekövetkezte:
- A lejárati idő (
Expiration) eléri aEXPIRATION_THRESHOLD, amelyet a kódban 15 percre állítottak be. - A legutolsó tanúsítványfrissítési kísérlet óta több idő telt el, mint
REFRESH_THRESHOLD, amelyet 60 percre "hardcode-oltak".
Annak érdekében, hogy megnézzük a kapott tanúsítványaink tényleges lejárati idejét, a fenti cURL parancsokat hajtottuk végre a konténerből és az EC2 példányból. A konténerből kapott tanúsítvány érvényességi ideje lényegesen rövidebb volt: pontosan 15 perc.
Most things are clear now: for the first request, our service received temporary certificates. Since their validity did not exceed 15 minutes, upon subsequent requests, the AWS SDK opted to renew them. This happened with every request.
Why has the validity of the certificates become shorter?
The AWS Instance Metadata service is designed to work with EC2 instances, not Kubernetes. On the other hand, we did not want to change the application interface. For this, we used — a tool that allows users (engineers deploying applications in the cluster) to assign IAM roles to containers in pods as if they were EC2 instances, using agents on each Kubernetes node. KIAM intercepts calls to the AWS Instance Metadata service and processes them from its cache, having previously obtained them from AWS. From the application's standpoint, nothing changes.
KIAM supplies short-term certificates to pods. This makes sense, considering that the average lifespan of a pod is shorter than that of an EC2 instance. By default, the validity period of the certificates .
As a result, if both default values are layered on top of each other, a problem arises. Each certificate provided to the application expires after 15 minutes. In this case, the AWS Java SDK forcefully renews any certificate for which less than 15 minutes remain until expiration.
Consequently, the temporary certificate is forcibly renewed with each request, leading to a couple of calls to the AWS API and resulting in a significant increase in latency. In the AWS Java SDK, we discovered , which mentions a similar issue.
The solution turned out to be simple. We just reconfigured KIAM to request certificates with a longer validity period. Once this was done, the requests passed without involving the AWS Metadata service, and the latency even dropped to a lower level than in EC2.
Következtetések
Based on our experience with migrations, one of the most frequent sources of problems is not errors in Kubernetes or other platform components. It is also not related to any fundamental flaws in the microservices we are migrating. Problems often arise simply because we are connecting various elements together.
Bonyolult rendszereket keverünk össze, amelyek korábban soha nem léptek interakcióba egymással, arra számítva, hogy együtt egy nagyobb, egységes rendszert képeznek. Sajnos, minél több elem van, annál nagyobb a hibázás lehetősége és annál nagyobb az entrópia.
Ebben az esetben a nagy késleltetés nem a Kubernetes, KIAM, AWS Java SDK vagy a mikroszolgáltatásunk hibáiból vagy rossz döntéseiből fakadt. Az az eredmény, hogy két független, alapértelmezetten beállított paramétert egyesítettünk: egyet a KIAM-ban, a másikat pedig az AWS Java SDK-ban. Egyedül mindkét paraméter értelmes: mind az AWS Java SDK-ban található aktív tanúsítványfrissítési politika, mind a KAIM rövid lejárati idejű tanúsítványai. De ha ezeket összeolvasszuk, az eredmények előre megjósolhatatlanok lesznek. Két független és logikus döntés egyesítve nem feltétlenül értelmes.
Fejlesztési eszközök, amelyek Kubernetesben futnak
A KIAM eszköz architektúrájáról az AWS IAM Kubernetesbe való integrálásához többet megtudhatsz itt: a készítőitől.
Blogunkban ezeket is olvashatod:
- «»;
- «»;
- «»;
- «».
Forrás: habr.com
