

A nevem Viktor Jagofárov, és a Kubernetes platformok fejlesztésével foglalkozom a DomKliknél, mint a műszaki vezető az Ops csapatban. Szeretném bemutatni a Dev Ops folyamataikat, egy Oroszország legnagyobb k8s klaszterének üzemeltetési sajátosságait, valamint azokat a DevOps/SRE gyakorlatokat, amelyeket a csapatunk használ.
Ops csapat
Jelenleg az Ops csapatban 15 ember dolgozik. Hároman az irodáért felelősek, ketten pedig más időzónában dolgoznak, így éjszaka is elérhetők. Ennek köszönhetően mindig van valaki az Ops csapatból a monitor előtt, aki kész reagálni bármilyen bonyolultságú incidensre. Éjszakai ügyeletünk nincs, ami megőrzi a mentális egészségünket és lehetőséget ad arra, hogy mindenki kipihenje magát és ne csak a számítógép előtt töltsön szabadidőt.
Mindenkinek különböző kompetenciái vannak: hálózati szakemberek, DBA-k, ELK Stack szakértők, Kubernetes adminisztrátorok/fejlesztők, monitorozási, virtualizációs és hardver szakemberek stb. Az összekötő vonásunk az, hogy mindenki valamennyire helyettesítheti a másikat: például új csomópontokat vezethet be a k8s klaszterbe, frissítheti a PostgreSQL-t, írhat CI/CD pipeline-t Ansible-lal, automatizálhat valamit Python/Bash/Go nyelveken, vagy csatlakoztathat hardvert a DC-hez. Az, hogy valaki erős kompetenciával rendelkezik egy adott területen, nem akadályozza meg, hogy más irányba is elmozduljon, és más területen is fejleszthesse magát. Például én rendszergazdaként kerültem a cégnél, és most a Kubernetes klaszterek a fő felelősségi köröm. A csapatban minden növekedést üdvözlünk, és nagyon fejlett a közösségi érzés.
Egyébként toborzunk. A jelöltekkel szembeni követelmények meglehetősen standardak. Személy szerint számomra fontos, hogy az illető beilleszkedjen a csapatba, ne legyen konfliktusos, de ugyanakkor tudja képviselni a véleményét, vágyjon a fejlődésre és ne féljen új dolgokat kipróbálni, javasolni az ötleteit. A programozási készségek a script nyelveken kötelezőek, az alap Linux és angol nyelvtudás pedig szintén elvárt. Az angolra azért van szükség, hogy az illető egy esetleges hiba esetén 10 másodperc alatt googlizhassa a megoldást, ne 10 perc alatt. Jelenleg nagyon nehéz olyan szakembereket találni, akik mély Linux ismeretekkel rendelkeznek: vicces, de a három jelöltből kettő nem tud válaszolni a „Mi az a Load Average? Miből áll össze?” kérdésre, míg a „Hogyan készíthetünk core dump-ot egy C programból?” kérdést valami különc vagy dinoszaurusz dolognak tartják... Ezt el kell fogadnunk, mivel az emberek általában más kompetenciákban magasan képzettek, és a 'linuxra' mi megtanítjuk őket. A kérdésre, hogy „miért szükséges ez a DevOps mérnöknek a felhők modern világában” nem térhetünk ki az írás keretein belül, de három szóval: mindez szükséges.
Tools Csapat
A Tools csapat jelentős szerepet játszik az automatizálásban. Fő feladatuk kényelmes grafikus és CLI eszközök létrehozása fejlesztők számára. Például a belső fejlesztésünk, a Confer lehetővé teszi, hogy szó szerint néhány kattintással indítsunk el egy alkalmazást Kubernetesben, beállítsuk a forrást, kulcsokat a vault-ból stb. Korábban Jenkins + Helm 2 volt, de a saját szerszámunkat kellett kifejlesztenünk, hogy elkerüljük a másolás-beillesztést és egyenesebbé tegyük a szoftver életciklusát.
Az Ops csapat nem ír pipelinet a fejlesztők helyett, de bármilyen kérdésben tud tanácsot adni a megírásukkal kapcsolatban (néhányan még mindig használják a Helm 3-at).
DevOps
A DevOps-ra vonatkozóan így látjuk:
A Dev csapatok kódot írnak, amelyet a Confer segítségével a dev -> qa/stage -> prod környezetbe telepítenek. A kód teljesítményéért és hibamentességéért a Dev és Ops csapatok felelnek. Napközben az Ops csapat ügyeletesének kell elsőként reagálnia az alkalmazásukkal kapcsolatos incidensekre, míg este és éjjel az ügyeletes adminnak (Ops) fel kell ébresztenie az ügyeletes fejlesztőt, ha biztos benne, hogy a probléma nem az infrastruktúrában van. Minden metrika és riasztás a monitorozásban automatikusan vagy félautomatikusan jelenik meg.
Az Ops felelősségi köre az alkalmazás élesítésével kezdődik, de a Dev felelőssége ezzel nem ér véget - egy csapatban dolgozunk, és egy hajóban evezünk.
A fejlesztők tanácsot adnak az adminisztrátoroknak, ha segítségre van szükségük egy admin mikroszolgáltatás (például Go backend + HTML5) írásához, míg az adminisztrátorok bármilyen infrastrukturális kérdésben tanácsot adnak a fejlesztőknek, vagy a k8s-zel kapcsolatos kérdésekben.
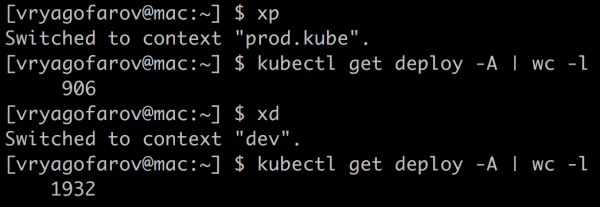
Egyébként nálunk egyáltalán nincs monolit, csak mikroszolgáltatások. A termelési k8s klaszterben a számuk körülbelül 900 és 1000 között mozog, ha a számuk alapján mérünk. telepítések. A podok száma 1700 és 2000 között változik. A termelési klaszterben jelenleg körülbelül 2000 pod van.
Pontosan számokat nem tudok mondani, mivel figyelemmel kísérjük a felesleges mikroszolgáltatásokat, és félautomatikusan eltávolítjuk őket. A felesleges entitások figyelésében a k8s-ben segít nekünk a , ami nagymértékben spórol a forrásokkal és a pénzzel.
Erőforrás-gazdálkodás
Monitorozás
A jól felépített és informatív monitorozás kulcsszerepet játszik egy nagy klaszter üzemeltetésében. Még nem találtunk univerzális megoldást, amely 100%-ban lefedné az összes monitoring igényt, ezért időnként különböző egyedi megoldásokat készítünk ebben a környezetben.
- Zabbix. A régi klasszikus monitorozás, amely elsősorban az infrastruktúra általános állapotának nyomon követésére szolgál. Megmondja nekünk, mikor hal meg egy nóda a CPU, memória, lemez, hálózat stb. miatt. Semmi különös, de van külön DaemonSet az ügynökökből, amelyek például a klaszter DNS állapotát monitorozzák: keresik a sávszélességet elhasználó coredns podokat, ellenőrzik a külső hosztok elérhetőségét. Úgy tűnhet, hogy miért foglalkoznánk ezzel, de nagy sávszélesség mellett ez az összetevő komoly hibapont lehet. Korábban már , hogyan küzdöttem a klaszter DNS teljesítményével.
- Prometheus Operator. A különböző exportőrök készlete széleskörű áttekintést nyújt a klaszter összes összetevőjéről. Ezt követően mindezt nagyméretű dashboardokon vizualizáljuk a Grafanában, és az értesítésekhez alertmanagert használunk.
Egy másik hasznos eszköz számunkra a . Azt követően írtuk meg, hogy többször is szembesültünk azzal a helyzettel, amikor az egyik csapat Eszközei lefedik a másik csapat Ingress-eit, aminek következtében 50x-es hibák keletkeztek. Jelenleg a fejlesztők a termelés előtt ellenőrzik, hogy senkit sem érintenek, és ez egy jó eszköz a problémák elsődleges diagnosztizálására az Ingress-ekkel kapcsolatban a csapatom számára. Vicces, hogy először rendszergazdák számára írták és elég „primitíven” nézett ki, de miután a fejlesztői csapatok megkedvelték az eszközt, jelentősen átalakult, és már nem úgy néz ki, mint „a rendszergazda készített egy webes felületet a rendszergazdák számára”. Hamarosan lemondunk erről az eszközről, és az ilyen helyzeteket még a pipeline kiadása előtt validálni fogják.
A csapatok erőforrásai a „Kubernetes”-ben
Mielőtt példákba vágnánk, érdemes elmagyarázni, hogyan működik nálunk az erőforrások kiadása mikroszolgáltatásokhoz.
Ahhoz, hogy megértsük, milyen csapatok és mennyi erőforrást használnak fel, erőforrások (processzor, memória, helyi SSD), minden csapat számára külön erőforrást biztosítunk a „Kubernetes”-ben, és korlátozzuk a maximális kapacitásaikat processzorban, memóriában és lemezen, előzetesen egyeztetve a csapatok igényeit. Ennek megfelelően egy csapat általában nem blokkolja az egész klasztert azzal, hogy ezer magot és terabájtnyi memóriát foglal el. A hozzáférések a névtérhez az AD-n keresztül kerülnek kiadásra (RBAC-ot használunk). A névterek és határaik a GIT-tárolóba egy pull requesten keresztül adódnak hozzá, és ezt követően az Ansible pipeline automatikusan kibővíti. namespace például a csapatok számára:
A csapat számára történő erőforrás-kiadás példája:
névterek:

  chat-csapat:
    podok: 23
    határok:
      cpu: 11
      memória: 20Gi
    kérdések:
      cpu: 11
      memória: 20Gi
Kérések és határok
A „Kubernetes”-ben Kérés — ez a garantáltan fenntartott erőforrások mennyisége deployment (egy vagy több Docker-konténer) a klaszterben. A Limit — ez egy nem garantált maximum. Gyakran láthatjuk a grafikonokon, hogy egy csapat túl sok kérést állított be az összes alkalmazásához, és nem tudja telepíteni az alkalmazást a „Kubernetes”-be, mivel a névtér alatt minden request már „elkölthettük”.
A helyes megoldás ilyen helyzetben: a valós erőforrás-felhasználást nézni és összehasonlítani a kért mennyiséggel (Request).
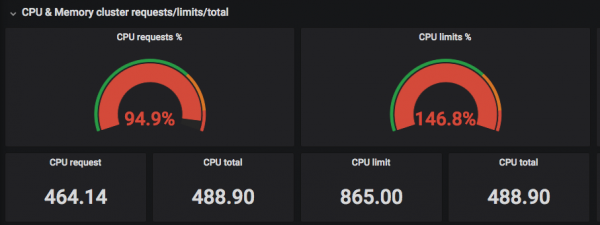
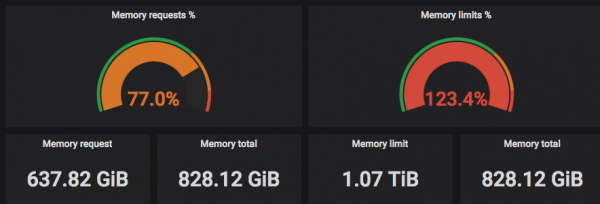
A fenti képernyőképeken látható, hogy a „kért” (Requested) CPU-k a valós szálak számához közelítenek, míg a Határok meghaladhatják a központi processzorok valós szálainak számát =)
Most nézzük meg részletesen egy namespace-t (én a kube-system namespace-t választottam — ez a Kubernetes saját komponenseinek rendszernamespace-a), és nézzük meg, hogy az igényelt CPU-idő és memória hogyan viszonyul a valós felhasználáshoz:
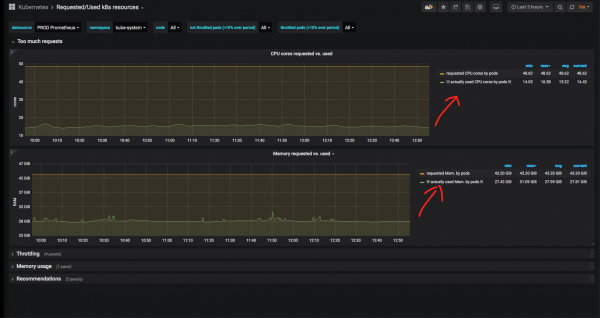
Nyilvánvaló, hogy a rendszer szolgáltatások számára fenntartott memória és CPU jóval meghaladja a valós használatot. A kube-system esetében ennek van joga: voltak olyan esetek, amikor az nginx ingress controller vagy a nodelocaldns csúcsidőben mérhető CPU-t használtak és sok RAM-ot fogyasztottak, ezért itt az ilyen tartalék indokolt. Ezen kívül nem támaszkodhatunk az utolsó 3 óra grafikonjaira: kívánatos, hogy hosszú távú historikus metrikákat lássunk.
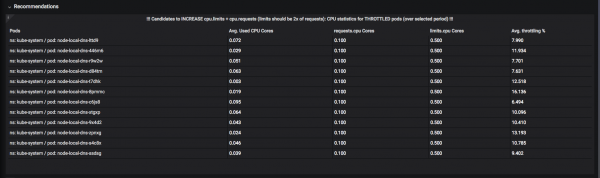
Fejlesztettek ki egy "ajánlási" rendszert. Például itt látható, hogy mely erőforrásokat lenne érdemes "limitálni" (felső engedélyezett határ), hogy ne történhessen "throttling": az a pillanat, amikor a már felhasznált CPU vagy memória kimerítette az adott időintervallumban rendelkezésre álló kvótát, és várakozik, míg "felengedik":
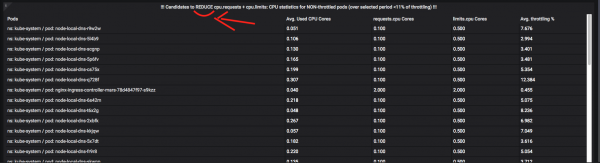
Íme azok a podok, amelyeknek mérsékelniük kellene az igényeiket:
A throttling + Az erőforrások monitorozásáról több cikket is lehetne írni, ezért kérlek, tedd fel a kérdéseidet a megjegyzésekben. Részletekben elmondható, hogy az ilyen metrikák automatizálásának feladata meglehetősen összetett és sok időt igényel, valamint ügyes manőverezést igényel "ablakos" funkciókkal és "CTE" Prometheus / VictoriaMetrics (ezek a kifejezések idézőjelben vannak, mivel a PromQL-ben szinte nincs hasonló, ezért rémült lekérdezéseket kell készíteni, amelyek több képernyőnyi szöveget tartalmaznak, és azokat optimalizálni kell).
Végül a fejlesztők rendelkeznek eszközökkel a saját namespace-jeik monitorozására a "Kubernetes" alatt, és képesek választani, hol és mikor mely alkalmazások esetében lehet "kivágni" az erőforrásokat, és mely podoknak lehet teljes éjszakára átadni az összes CPU-t.
Módszertanok
A cégnél, ahogy most divatos, mi követjük a DevOps- és SRE-gyakorlatokat. Amikor a cégnek 1000 mikroszolgáltatása, körülbelül 350 fejlesztője és 15 adminisztrátora van az egész infrastruktúrára, "divatosnak" kell lenni: mindezek a "buzzword-ek" mögött komoly szükség van mindennek az automatizálására, és az adminisztrátoroknak nem lehetnek szűk keresztmetszetek a folyamatokban.
Ops-ként különböző metrikákat és műszerfalakat biztosítunk a fejlesztők számára, amelyek a szolgáltatások válaszidejével és hibáival kapcsolatosak.
Olyan módszertanokat alkalmazunk, mint például: , és , kombinálva őket. Arra törekszünk, hogy minimalizáljuk a dashboardok számát, így egy pillantással megérthető, hogy melyik szolgáltatás degradálódik (például másodpercenkénti válaszkódok, a 99. percentilis válaszidő), és így tovább. Ahogy új metrikákra van szükség a közös dashboardokhoz, azonnal megrajzoljuk és hozzáadjuk őket.
Már egy hónapja nem rajzoltam grafikonokat. Valószínűleg ez jó jel: azt jelenti, hogy a legtöbb 'kívánság' már megvalósult. Volt, hogy hetente legalább egyszer rajzoltam új grafikont.
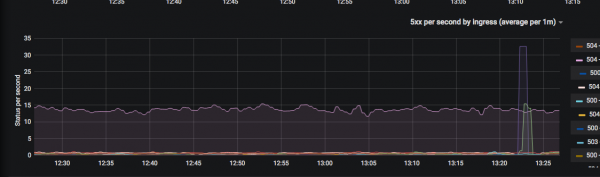
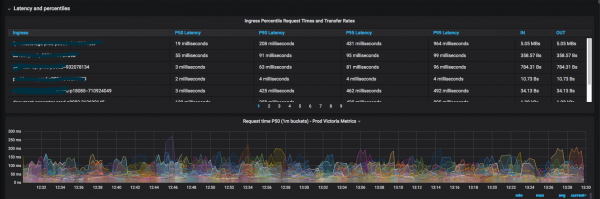
A végeredmény értékes abban, hogy most a fejlesztők eléggé ritkán keresnek meg az adminoktól azzal a kérdéssel, hogy 'hol nézhetik meg valamelyik metrikát'.
Bevezetés Szolgáltatás Mesh nem túl messze és jelentősen megkönnyíti az életet mindenkinek, a Tools csapat munkatársai már közel vannak a 'az Istio egészséges ember' bevezetéséhez: minden egyes HTTP(s) kérés életciklusa látható lesz a monitorozás során, és mindig megérthetjük, hogy 'melyik fázisban romlott el' az interszolgáltatások (és nem csak) interakciója. Iratkozzon fel a ДомКлик cég központi híreire. =)
A Kubernetes infrastruktúra támogatása
Történetileg úgy alakult, hogy javított verziót használunk Kubespray — Ansible szerep a Kubernetes telepítéséhez, kibővítéséhez és frissítéséhez. Egy szakaszban a fő ágból ki lett vágva a non-kubeadm telepítések támogatása, és a kubeadm-ra való átállás folyamatát nem ajánlották fel. Ennek következtében a Southbridge cég elkészítette a saját fork-ját (kubeadm támogatással és kritikus problémák gyors megoldásával).
A k8s klaszterek frissítési folyamata a következőképpen néz ki:
- Felvesszük Kubespray a Southbridge-től, összehasonlítjuk a mi ággal, összevonjuk.
- Kibocsátjuk a frissítést a Stressz-'Kocka'.
- Frissítést egy node-on (az Ansible-ben ez 'serial: 1') végezve Dev-'Kocka'.
- Frissítünk Prod szombat este egy node-on.
A jövőben tervezzük, hogy lecseréljük Kubespray valami gyorsabbra, és áttérünk a kubeadm.
Összesen három 'Kockánk' van: Stressz, Dev és Prod. Tervezzük, hogy elindítunk egy másikat (forró standby) a második adatközpontban lévő Prod-'Kocka'-t. Stressz és Dev 'Virtuális gépekben' élnek (oVirt a Stresszhez és VMWare cloud a Dev-hez). Prod-'Kocka' 'csupasz hardveren' működik: ezek azonos node-ok 32 CPU szálakkal, 64-128 GB memóriával és 300 GB SSD RAID 10 - összesen 50 darab. Három 'vékony' node-ot a 'mester' alá szánunk Prod-'Kockák': 16 GB memória, 12 CPU szál.
A termeléshez inkább a 'csupasz hardver' használatát részesítjük előnyben, és kerüljük a felesleges rétegeket, mint például OpenStack: nem szeretnénk 'zajos szomszédokat' és CPU ellopott időtA házon belüli OpenStack esetén körülbelül kétszeresére nő a rendszergazdálkodás összetettsége.
A CI/CD „Kubernetes” és más infrastruktúra komponensekhez külön GIT szervert, Helm 3-at használunk (sok nehézség árán váltottunk a Helm 2-ről, de nagyon örülünk a lehetőségnek atomic), Jenkins, Ansible és Docker. Szeretjük a feature-brancheket és egy repozitóriumból több környezetbe történő telepítést.
Zárás
Így néz ki nagyjából a DevOps folyamat a DomClick-nél a működési mérnök szemszögéből. A cikk kevésbé technikai lett, mint vártam, ezért kövessétek a DomClick híreit a Habr-on: lesznek komolyabb cikkek a Kubernetes-ről és még sok másról.
Forrás: habr.com
