

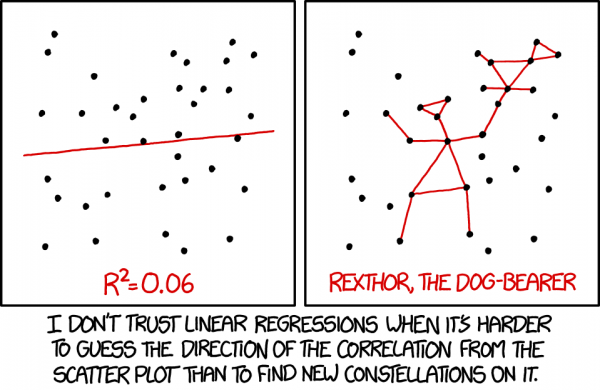
Forrás:
A lineáris regresszió az egyik alapvető algoritmus sok területen, amelyek adatelemzéssel foglalkoznak. Ennek oka nyilvánvaló. Ez egy nagyon egyszerű és érthető algoritmus, ami hozzájárul széles körű alkalmazásához már évtizedek, ha nem évszázadok óta. Az elképzelés az, hogy feltételezzük egy változó lineáris függőségét egy másik változók halmazától, majd megpróbáljuk helyreállítani ezt a függőséget.
De ebben a cikkben nem a lineáris regressziós alkalmazásáról lesz szó gyakorlati problémák megoldására. Itt a lineáris regresszió helyreállításának megvalósításának érdekes sajátosságait fogjuk megvizsgálni, amelyekkel a gépi tanulási modul írása során találkoztunk a környezetében. Néhány alapvető matematikai fogalom, gépi tanulás és elosztott számítások ismerete segít megérteni, hogyan lehet lineáris regressziót helyreállítani, még akkor is, ha az adatok több ezer csomópont között oszlanak meg.
Miről van szó?
Az a feladatunk, hogy helyreállítsuk a lineáris függőséget. A bemeneti adatok között egy független változók halmaza szerepel, mindegyiknek van egy hozzárendelt értéke a függő változónak. Ezeket az adatokat két mátrix formájában ábrázolhatjuk:

Most, hogy feltételezzük a függőséget, és ráadásul ez lineáris is, írjuk le a feltételezésünket mátrixok szorzataként (a kényelmesebb írás érdekében a továbbiakban feltételezzük, hogy az egyenlet szabad tagja el van rejtve a  és az utolsó oszlop mátrixunkban
 egyeseket tartalmaz):

Nagyon hasonlít egy lineáris egyenletrendszerhez, igaz? Hasonlónak tűnik, de valószínűleg ennek a rendszernek nem lesz megoldása. Ennek oka a zaj, amely szinte minden valós adatban jelen van. Emellett az is lehet az oka, hogy nincs is olyan lineáris összefüggés, amellyel harcolhatnánk további, a kezdeti változóktól nemlineárisan függő változók bevezetésével. Tekintsük a következő példát:
Forrás:
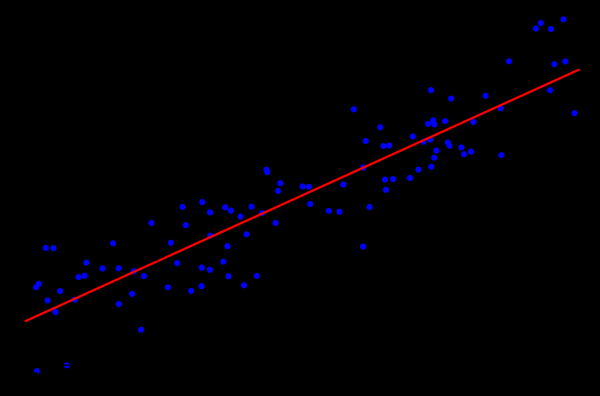
Ez egy egyszerű példa a lineáris regresszióra, amely bemutatja egy változó függőségét (az  tengely mentén) egy másik változótól (az tengely mentén)
 ). Ahhoz, hogy a megfelelő példához tartozó lineáris egyenletrendszernek legyen megoldása, az összes pontnak pontosan egy egyenesen kell elhelyezkednie. De ez nem így van. Azért nem helyezkednek el egy egyenesen, mert a zaj miatt (vagy azért, mert a lineáris összefüggés létezéséről tett feltételezés téves volt). Így tehát a lineáris összefüggés helyreállításához a valós adatokból általában szükség van egy új feltételezés bevezetésére: a bemeneti adatok zajt tartalmaznak, és ez a zaj! . Lehet feltételezéseket tenni más zajtípusok eloszlásáról is, de a legtöbb esetben kifejezetten a normális eloszlásra helyezik a hangsúlyt, amiről a továbbiakban szó lesz.
A maximális valószínűség módszere
Tehát feltételeztük, hogy véletlenszerű normál eloszlású zaj van. Mi a teendő ebben az esetben? Erre a matematikában létezik és széles körben használt . Röviden, a lényege az, hogy választunk, majd azt maximalizáljuk.
Térjünk vissza a lineáris összefüggés helyreállítására normál zajjal rendelkező adatok esetén. Észrevehetjük, hogy a feltételezett lineáris összefüggés a meglévő normális eloszlás matematikai várható értéke.  Ugyanakkor annak a valószínűsége, hogy
 felveszi ezt vagy azt az értéket, a megfigyelhető adatok birtokában
 , a következőképpen néz ki:

Most helyettesítsük be  és
 a szükséges változókat:

Már csak azt a vektort kell megtalálnunk,  amely mellett ez a valószínűség maximális. A maximálisra hozáhozta a függvényt kényelmesebb először logaritmálni (a függvény logaritmusának maximális értéke ugyanabban a pontban lesz, mint magának a függvénynek):

Amely, viszont a következő funkció minimalizálására redukálódik:

Egyébként ezt a módszert nevezik . Gyakran az összes fent említett érvet kihagyják, és egyszerűen csak ezt a módszert használják.
QR felbontás
A fent említett funkció minimuma akkor található meg, ha megtaláljuk azt a pontot, ahol a függvény gradiensje nulla. A gradiens a következő módon lesz felírva:

ez egy mátrix módszer a minimalizálási feladat megoldására, amelyet a legkisebb négyzetek módszere használ. Ennek kapcsán átírjuk az egyenletet mátrixos formában:

Tehát, a mátrixot  mátrixokra bontjuk
 és
 és végrehajtunk egy sor átalakítást (a QR-dekompozíció algoritmusa itt nem kerül tárgyalásra, csak annak alkalmazása a megadott feladathoz):

Mátrix  ortogonális. Ez lehetővé teszi számunkra, hogy megszabaduljunk a szorzattól
 :

Ha helyettesítjük  Gyorsan emlékezzünk vissza, hogyan működik a moduláris aritmetika. Az óra már egy ismert koncepció. Az órák használata
 , akkor kapunk
 . Figyelembe véve, hogy
 felső háromszög alakú mátrix, így néz ki:

Ezt helyettesítési módszerrel lehet megoldani. Az elem  úgy található meg, mint
 , az előző elem
 úgy található meg, mint
 és így tovább.
Itt érdemes megjegyezni, hogy az így kapott algoritmus bonyolultsága a QR-dekompozíció használatával egyenlő  . Annak ellenére, hogy a mátrixok szorzása jól párhuzamosítható, a hatékony elosztott verzió létrehozása erről az algoritmusról nem tűnik lehetségesnek.
Gradiens csökkenés
Ha valamilyen függvény minimalizálásáról beszélünk, mindig érdemes megemlíteni a (stohasztikus) gradiens csökkenési módszert. Ez egy egyszerű és hatékony minimalizálási módszer, amely a függvény gradiensének iteratív kiszámításán alapul egy adott pontban, majd annak elmozdításán a gradiens ellenkező irányába. Minden egyes lépés közelíti meg a megoldást a minimumhoz. A gradiens így néz ki:

Ez a módszer jól párhuzamosítható és eloszlatható a gradiens operátorának lineáris tulajdonságai miatt. Vegyük észre, hogy a fenti képlet összegje alatt független tagok találhatók. Más szóval, a gradiens minden indexre függetlenül kiszámítható.  az elsőtől
 , párhuzamosan kiszámítva a gradiens értékét az indexekhez
 tól
 . Ezután össze kell adni a kapott gradienteket. Az összeadás eredménye ugyanaz lesz, mintha egyszerre kiszámítottuk volna a gradiens értékét az indexekhez az elsőtől
 . Így, ha az adatok több adatdarab között oszlanak el, a gradiens minden darabon függetlenül kiszámítható, majd az ezen számítások eredményeit össze kell adni a végső eredmény eléréséhez:

Megvalósítás szempontjából ez beleillik a paradigmába. A gradiens csökkenés minden lépésénél minden adatcsomópont számára feladatot küldenek a gradiens kiszámítására, majd a kiszámított gradienteket összegyűjtik, és az összegzésük eredményét használják az eredmény javítására.
Bár a megvalósítása egyszerű és a MapReduce paradigmában végrehajtható, a gradiens csökkenésnek megvannak a maga hátrányai is. Különösen a konvergencia eléréséhez szükséges lépések száma lényegesen nagyobb más, specializáltabb módszerekhez képest.
LSQR
– egy másik módszer a feladat megoldására, amely alkalmas mind a lineáris regresszió helyreállítására, mind a lineáris egyenletrendszerek megoldására. Fő jellemzője, hogy ötvözi a mátrixmódszerek és az iteratív megközelítés előnyeit. Ennek a módszernek a megvalósítását megtalálhatjuk a -ban, valamint a -ban. A módszer leírása itt nem kerül bemutatásra (meg található a cikkben ). Ehelyett bemutatásra kerül egy megközelítés, amely lehetővé teszi az LSQR alkalmazását elosztott környezetben.
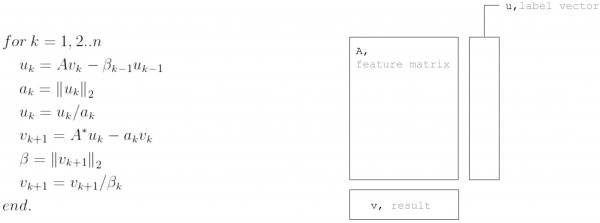
Az LSQR módszer alapja a . Ez egy iteratív eljárás, amely minden egyes iterációból a következő lépésekből áll:
De ha figyelembe vesszük, hogy a mátrix  horizontálisan particionált, akkor minden iterációt két MapReduce lépésként lehet ábrázolni. Így minimalizálható az adatok átvitele az egyes iterációk során (csak a változók számának megfelelő hosszúságú vektorok):
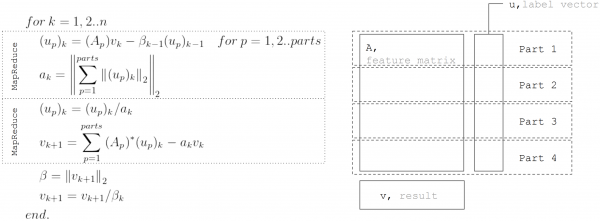
Ezt a megközelítést használják a lineáris regresszió megvalósításakor az .
Zárás
-ben. Számos lineáris regresszió helyreállítására alkalmas algoritmus létezik, de nem mindegyik alkalmazható bármilyen körülmények között. Az QR felbontás jól alkalmazható pontos megoldásokhoz kis adathalmazon. A gradiens csökkenés könnyen megvalósítható és lehetővé teszi a közelítő megoldás gyors megtalálását. Az LSQR pedig ötvözi a két előző algoritmus legjobb tulajdonságait, mivel elosztható, gyorsabban konvergál a gradiens csökkenéshez képest, és lehetővé teszi az algoritmus korai leállítását a QR felbontás mellett a közelítő megoldás keresésekor.
Forrás: habr.com
