

A monitoring system has become a crucial component of growing cloud solutions due to the increasing complexity of distributed systems. It is essential for understanding their behavior. Scalable tools are needed to collect data from all services and provide specialists with a unified interface for performance analysis, error demonstration, availability, and logs.
These tools must also be efficient and productive. In this article, we will examine two popular technology stacks: EFK (Elasticsearch) and PLG (Loki), and explore their architectures and differences.
EFK Stack
You may have already heard of the very popular ELK or EFK. The stack consists of several separate components: Elasticsearch (object storage), Logstash or FluentD (log collection and aggregation), and Kibana for visualization.
A typical operational scheme looks like this:
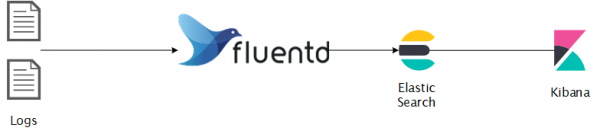
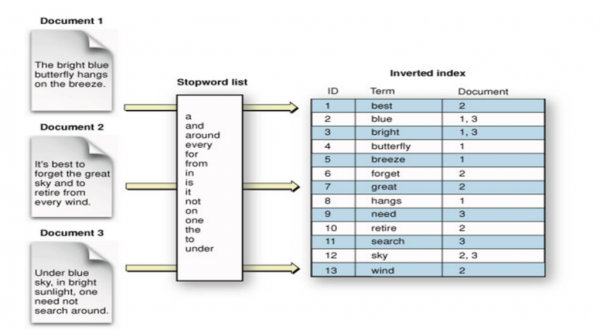
Elasticsearch — a distributed object storage with real-time search and analytics. An excellent solution for semi-structured data, such as logs. Information is stored as JSON documents, indexed in real-time, and distributed across cluster nodes. An inverted index is applied, containing all unique words and the documents associated with them for full-text search, which is based on the Apache Lucene search engine.
FluentD — is a data collector that performs data unification during collection and consumption. It strives to organize data in JSON as much as possible. Its architecture is extensible, with over , supported by the community, for all use cases.
Kibana — a data visualization tool for Elasticsearch with various additional capabilities, such as time series analysis, graphs, machine learning, and more.
Elasticsearch Architecture
Data in the Elasticsearch cluster is stored distributed across all its nodes. The cluster consists of multiple nodes to improve availability and resilience. Any node can perform all roles in the cluster, but in large scalable deployments, nodes are usually assigned specific tasks.
Types of cluster nodes:
- master node — manages the cluster, with a minimum of three needed, one always active;
- data node — stores indexed data and performs various tasks with it;
- ingest node — adatbeküldő csomópont, amely üzemelteti az adatfeldolgozási csatornákat az indexelés előtt;
- coordinating node — lekérdezések irányítása, a keresési feldolgozási fázis csökkentése, tömeges indexelés koordinálása;
- alerting node — figyelmeztetési feladatok indítása;
- machine learning node — gépi tanulási feladatok feldolgozása.
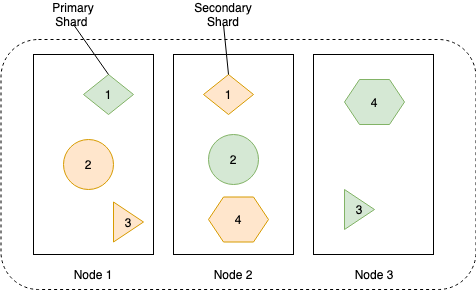
Az alábbi diagram bemutatja, hogyan tárolják és replikálják az adatokat a csomópontok között a nagyobb adat-elérhetőség érdekében.
Minden replikához tartozó adatot megfordított indexben tárolnak, az alábbi séma bemutatja, hogyan történik ez:
Telepítés
A részleteket itt tekintheti meg , én a helm chartot fogom használni:
$ helm install efk-stack stable/elastic-stack --set logstash.enabled=false --set fluentd.enabled=true --set fluentd-elasticsPLG stack
Ne lepődjön meg, ha nem találja ezt a mozaikszót, ugyanis ezt inkább Grafana Loki-ként ismerik. Mindenesetre ez a stack népszerűségnek örvend, mivel jól megfontolt technikai megoldásokat alkalmaz. Talán már hallott a Grafanáról, amely egy népszerű vizualizáló eszköz. A készítői, a Prometheus inspirálásával, megalkották a Lokit, egy vízszintesen skálázható, nagy teljesítményű naplók aggregálási rendszert. A Loki csak a metaadatokat indexeli, magukat a naplókat nem, ez a technikai megoldás lehetővé tette, hogy könnyen üzemeltethető és gazdaságos legyen.
Promtail — egy ügynök a naplók operációs rendszerből a Loki klaszterbe való továbbítására. Grafanába — vizualizáló eszköz a Loki-ból származó adatok alapján.
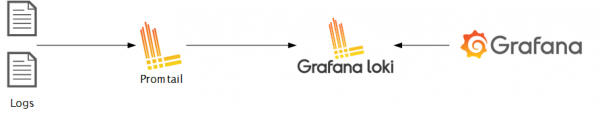
A Loki ugyanazon alapelveken épül fel, mint a Prometheus, ezért jól illeszkedik a Kubernetes naplók tárolásához és elemzéséhez.
Loki architektúra
A Loki egyetlen folyamatként vagy több folyamat formájában is futtatható, amely vízszintes skálázást biztosít.
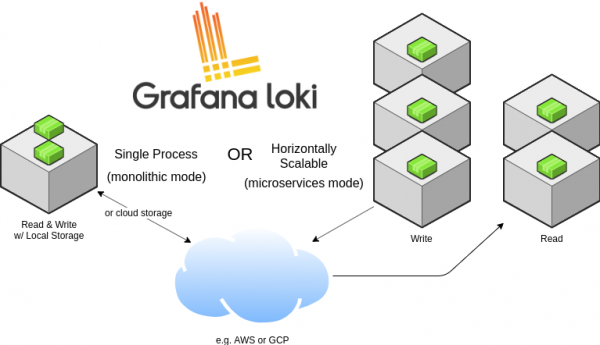
Ezen kívül működhet monolitikus alkalmazásként vagy mikroszolgáltatásként. Az egy folyamatban való futtatás hasznos lehet helyi fejlesztéshez vagy kisebb monitorozáshoz. Ipari alkalmazás és skálázható terhelés esetén a mikroszolgáltatás verzió ajánlott. Az adatok írási és olvasási útvonalai elkülönülnek, így finoman beállítható és igény szerint skálázható.
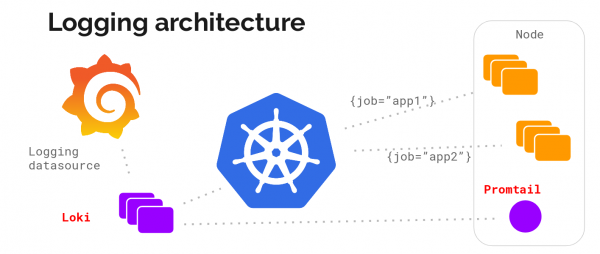
Nézzük meg a naplógyűjtő rendszer architektúráját részletezés nélkül:
Itt pedig a leírás (mikroszolgáltatás architektúra):
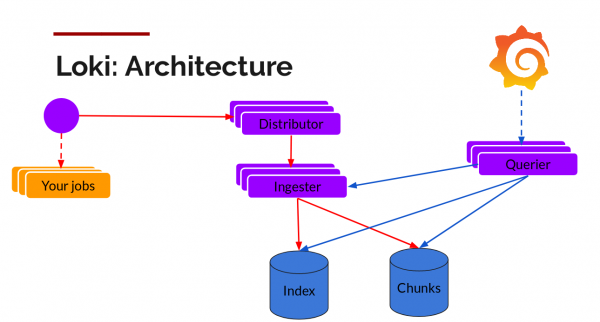
Összetevők:
Promtail — ügynök, amely csomagszolgáltatások formájában telepítve van a csomópontokra, naplókat gyűjt a feladatokból, és a Kubernetes API-n keresztül lekéri a naplók címkézéséhez szükséges metadatákat. Ezután a naplót elküldi a Loki fő szolgáltatásának. A metadaták címkézéséhez használt szabályok megegyeznek a Prometheus szabályaival.
Forgalmazó — elosztószolgáltatás, amely pufferként működik. Millió bejegyzés feldolgozása érdekében összegyűjti a bejövő adatokat, és blokkokba tömöríti azokat. Egyszerre több adatfogadó működik, de az azonos bejövő adatfolyamhoz tartozó naplóknak mindegyik blokk esetében csak egyben kell megjelenniük. Ez egy adatfogadók köré szervezve és soros hasheléssel történik. A megbízhatóság és a redundancia érdekében n-szer (3, ha nem konfigurálják) történik.
Ingester — adatfogadó szolgáltatás. Az adatharmónikus blokkok tömörítve érkeznek a hozzáadott naplókkal. Amint egy blokk elegendő méretűvé válik, a blokkot a adatbázisba mentik. A metadaták az indexbe, a naplóblokk adatai pedig a Chunks-ba kerülnek (ez általában egy objektumtároló). A mentés után a fogadó új blokkot hoz létre, ahová új bejegyzéseket adnak hozzá.
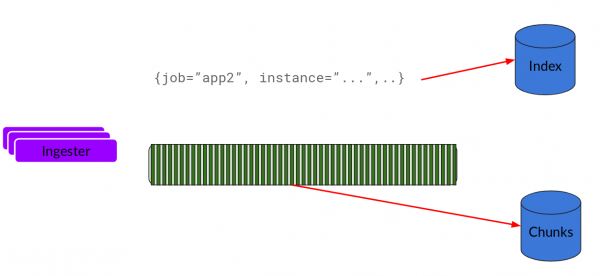
Index — adatbázis, DynamoDB, Cassandra, Google BigTable, és egyebek.
Chunks — naplótömbök tömörített formában, általában objektumtárolóban tárolva, például S3-ban.
Lekérdező — olvasási útvonal, ami az összes nehéz munkát elvégzi. Megnézi az időtartományt és a címkéket, majd az indexet ellenőrzi a meccsek keresésére. Ezután olvassa a adatblokkokat, és szűri őket az eredmények eléréséhez.
Most nézzük meg, hogyan működik mindez.
Telepítés
A Kubernetesben a legegyszerűbb a helm használata. Feltehetően már telepítette és beállította ( jegyzet: fordító)
Hozzáadjuk a tárolót és telepítjük a stack-et.
$ helm repo add loki https://grafana.github.io/loki/charts
$ helm repo update
$ helm upgrade --install loki loki/loki-stack --set grafana.enabled=true,prometheus.enabled=true,prometheus.alertmanager.persistentVolume.enabled=false,prometheus.server.persistentVolume.enabled=false
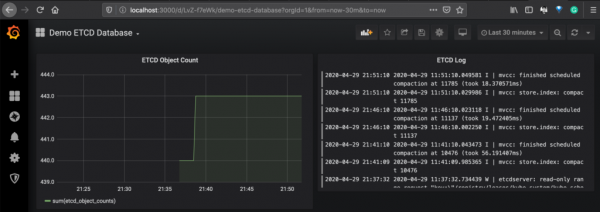
Az alábbiakban egy irányítópult példáját láthatjuk, ahol a Prometheus adatait mutatja az Etcd metrikákhoz és a Lokihoz a podok naplózása számára.
Most nézzük meg a két rendszer architektúráját, és hasonlítsuk össze a képességeiket.
Összehasonlítás
Lekérdezőnyelv
Az Elasticsearch a Query DSL-t és a Lucene lekérdezési nyelvet használja, amelyek lehetővé teszik a teljes szöveges keresést. Ez egy megbízható és erőteljes keresőmotor, amely széles körű operátor támogatással rendelkezik. Segítségével kontextus szerint kereshet, és relevancia alapján rendezheti az eredményeket.
A másik oldalon a ringben ott van a LogQL, amelyet a Loki használ, a PromQL (Prometheus lekérdezési nyelv) örököse. Ez a napló címkéket használ a naplóadatok szűrésére és lekérdezésére. Olyan operátorok és aritmetika alkalmazására is lehetőség van, ahogy azt leírták, , de lehetőségeit tekintve elmarad az Elastic nyelvtől.
Mivel a Loki lekérdezések a címkékhez kapcsolódnak, ezeket könnyen össze lehet kapcsolni a metrikákkal, ami megkönnyíti az operatív felügyelet megszervezését.
Skálázhatóság
Mindkét réteg vízszintesen skálázható, de a Lokinál ez egyszerűbb, mivel az adatolvasási és -írási utak el vannak választva, emellett mikroszolgáltatás-architektúrával rendelkezik. A Loki a saját sajátosságaihoz igazítható, és képes nagyon nagy mennyiségű naplóadatok kezelésére.
Többbérletesség
A klaszter többbérletessége közös téma az OPEX csökkentésében, mindkét réteg biztosítja a többbérletességet. Az Elasticsearch esetében több lehet ügyfelek szétválasztását végezni: egyedi index minden ügyfél számára, ügyfél alapú irányítás, egyedi ügyfélmezők, keresési szűrők. A Loki esetében pedig a HTTP X-Scope-OrgID fejléc segítségével.
Ár
A Loki gazdaságilag nagyon hatékony, mivel nem indexeli az adatokat, csak a metaadatokat. Ezzel és a memóriában (gyorsítótár), mivel az objektumtárolás olcsóbb, mint a blokkos tárolás, amely az Elasticsearch klaszterekben használatos.
Zárás
Az EFK réteg különféle célokra használható, maximális rugalmasságot biztosítva, és sokoldalú Kibana felület áll rendelkezésre az elemzéshez, vizualizációhoz és lekérdezésekhez. Ezt tovább lehet javítani a gépi tanulás lehetőségeivel.
A Loki réteg hasznos a Kubernetes ökoszisztémában a metaadatok felfedezési mechanizmusa miatt. Könnyen össze lehet kapcsolni az időbeli sorokban történő monitoring adatait a Grafana-ban és naplókkal.
Ha a naplók költségéről és hosszú távú tárolásáról van szó, a Loki kiváló választás a felhőmegoldásokhoz való belépéshez.
A piacon több alternatíva is létezik — egyesek akár jobbak is lehetnek az Ön számára. Például a GKE esetében elérhető a Stackdriver integráció, amely kiváló megoldást nyújt a monitorozásra. Ezeket nem vontuk be a cikkünk elemzésébe.
Linkek:
A cikket a Habr számára a Slurm oktatóközpont munkatársai fordították és készítették el — intenzív kurzusok, videóképzések és céges oktatás gyakorló szakemberektől (Kubernetes, DevOps, Docker, Ansible, Ceph, SRE, Agile)
Forrás: habr.com
