

Nézzük meg a Docker és Kubernetes loggolásának alapjait, majd két eszközt, amelyeket bátran használhatunk a termelésben: Grafana Loki és az EFK (Elasticsearch + Fluent Bit + Kibana) stack.
A cikk anyaga - a . Ha van kedv és különösen termelési igény, teljes képzést is végezhet - jelentkezzen a .
Docker loggolás
Kubernetes szinten az alkalmazások podokban futnak, de alacsonyabb szinten általában Dockerben működnek. Ezért úgy kell beállítani a loggolást, hogy a konténerekből gyűjtse a naplókat. A konténereket a Docker indítja - tehát meg kell értenünk, hogyan működik a loggolás a Docker szinten.
Remélem, hogy minden olvasó tudja: az alkalmazás naplókat stdout/stderr-be kell írni, nem pedig a konténer belsejébe. A naplókat a Docker Daemon aggregálja, és csak a stdout/stderr-be küldött naplókkal dolgozik. Ezen kívül a naplók konténerbe írása problémákat okozhat: a konténer a növekvő napló miatt felnőtt (mivel valószínűleg nincs Logrotate a konténerben), és a Docker Daemon nem tud erről a napról.
A Dockernek több log-driver vagy konténer naplógyűjtő bővítménye van. A Docker Community Edition (CE) ingyenes verziójában kevesebb log-driver található, mint a kereskedelmi Docker Enterprise Edition (EE) verzióban.
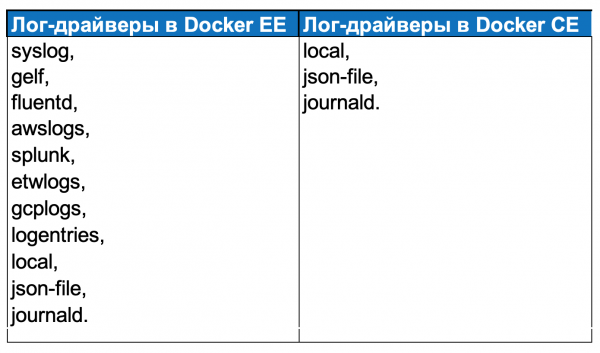
A Docker EE-t soha nem használtam gyakorlatban: a Southbridge-nél igyekszünk az Open Source megoldások mellett maradni, és ügyfeleinknek a Docker EE legtöbb kiegészítő funkciójára nincs szükségük.
A Docker CE log-driverjei:
local — naplók rögzítése a Docker Daemon belső fájljaiba;
json-file — json-log létrehozása minden konténer mappájában;
journald — naplók küldése a journald-hoz.
A Docker loggolási beállításai a daemon.json fájlban találhatók.
A "log-driver" mezőben megadjuk a bővítményt, a "log-opts" mezőben pedig a beállításait. A fenti példában a "json-file" bővítmény szerepel, a napló méretkorlátozása - "max-size": "10m"; fájlok számának korlátozása (forgási beállítások) - "max-file": "3"; valamint a naplókhoz csatolt értékek.
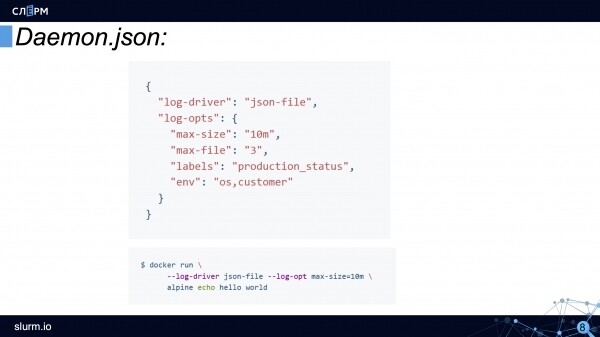
Néhány log-driver beállítást parancssori eszközön keresztül is megadhatunk. Ez kényelmes, ha egy külön konténert más log-driverrel kell elindítani.
Ilyen a Docker loggolási sémája:
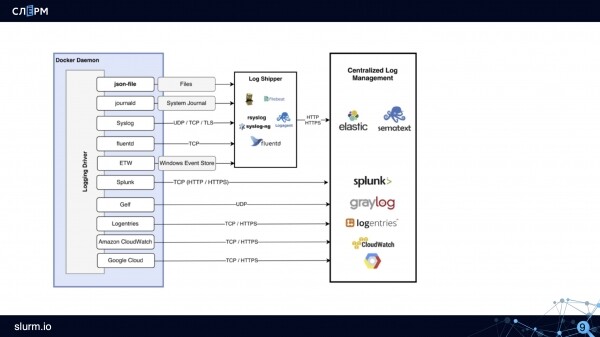
Hogy működik a rendszer: a log driver, például a json-file, fájlokat hoz létre. A naplógyűjtők (Rsyslog, Fluentd, Logagent és mások) ezeket a fájlokat gyűjtik össze és tárolják az Elasticben, Sematextben vagy más tárolókban.
A naplózás jellemzői a Kubernetesben
Egyszerűsítve a Kubernetes naplózási sémája így néz ki: van egy pod, amelyben egy konténer fut, a konténer a naplókat az stdout/stderr-re küldi. Ezután a Docker létrehoz egy fájlt és rögzíti a naplókat, amelyeket később forgatni lehet.
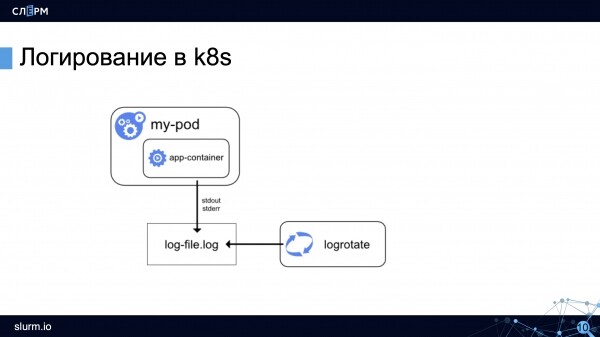
Nézzük meg a naplózás jellemzőit a Kubernetesben.
A naplók megőrzése a telepítések között. Ez kötelező feltétel a naplózás megfelelő beállításához. Ha nem őrizzük meg a naplókat a telepítések között, akkor az új verziók kiadásakor a régi naplók felülíródnak, a konténer újraindítása pedig szintén a naplók elvesztésével járhat. A Kubernetes rendelkezik egy -previous kulcsszóval, amely lehetővé teszi, hogy a pod legutolsó újraindítása előtti alkalmazásnaplókat megtekinthessük, de nem mélyebben.
A naplók aggregálása az összes példányból. Ha a mikroszolgáltatások felhőkben futnak, a rendszert a felhőszolgáltató felügyeli. Ha a mikroszolgáltatások saját hardverükön futnak, akkor a konténerek naplói mellett a rendszer naplóit is gyűjteni kell.
Korábban nem voltak kényelmes eszközök a naplók gyűjtésére sem a rendszertől, sem a mikroszolgáltatásoktól. Általában egy eszköz gyűjtötte a rendszer naplóit (például Rsyslog), a második a Docker naplóit (például journal-bit a Docker log driver journald-ra történő beállításával). Megpróbálták használni a journal-bit-ot — naplók gyűjtésére a konténerekből (a Docker napló driver beállításában megadva, hogy a naplókat a journald-ba kell írni), és a rendszerből is (a CentOS 7 már tartalmazza a systemd-t és a journald-t). A megoldás működőképes, de nem ideális. Ha sok a napló, a journal-bit elkezd akadozni, az üzenetek elvesznek.
A kísérletek folytatódtak — és találtak egy másik megoldást. A CentOS 7 főbb rendszer naplói (messages, audit, secure) fájlok formájában jelennek meg a var-logban. A Dockerben is be lehet állítani a naplók fájlokban való megőrzését json formátumban. Ennek megfelelően ezeket a fájlokat CentrOS 7-ből és Dockerből együttesen lehet gyűjteni.
Idővel népszerűvé vált az ELK Stack megoldás. Ez több eszköz kombinációja: Elasticsearch, Logstash és Kibana.
Az Elasticsearch tárolja a konténerek naplóit, a Logstash gyűjti az instanciák naplóit, a Kibana lehetővé teszi a beérkezett naplók feldolgozását, grafikonok létrehozását belőlük. Egy ideig az ELK Stack-et aktívan használták, de véleményem szerint az ideje lejár. Később elmondom, miért.
Metaadatok hozzáadása. Podok, alkalmazások, konténerek bárhol futtathatók. Sőt, egy alkalmazásnak több példánya is lehet. A naplókat ugyanabban a formátumban rögzítik, de meg kell értenünk, hogy pontosan melyik replikáról van szó, melyik Pod írja ezt, és melyik namespace-ben található. Ezért a naplókhoz metaadatokat kell hozzáadni.
Naplók feldolgozása. Vicces, de a naplózási és monitoring rendszer támogatási költségei meghaladhatják az alapalkalmazás költségeit. Amikor másodpercenként tíz- és százezrek zajlanak, ez természetesnek tűnik, de meg kell ismerni a határokat. Az egyik módja a határ megtalálásának a naplók feldolgozása.
Általában nem szükséges az összes napló összegyűjtése és tárolása, csak a részleteket kell tárolni - például a "warning" vagy "error" státuszú naplókat. Ha Nginx vagy ingress kontroller naplókról van szó, akkor csak azokat kell tárolni, amelyeknek a státusza eltér a 200-tól. De ez nem univerzális tanács: ha valamilyen módon analitikát épít a Nginx naplókra, akkor nyilvánvalóan azokat érdemes összegyűjteni.
A naplók gondolkodás nélkül történő szűrését nem javasolják, mert a szűrt adatokból hiányozhat a normális analitikához szükséges információ. Másrészt lehetséges, hogy az analitikát nem naplózási, hanem metrikagyűjtési szinten kell végezni. Így nem kell tárolnia százezernyi 200-as kóddal rendelkező sort. Az egyik megközelítés az, hogy információt gyűjtsünk a forgalomról és a hibákról az ingress kontrollerek metrikáiból.
Összességében itt jól meg kell gondolni: mit szeretne tárolni és meddig, mert különben olyan helyzet alakulhat ki, amikor a naplózási rendszer több erőforrást von el, mint az alap projekt.
Jelenleg nincs standard megoldás a naplózáshoz. A monitoringtól eltérően, ahol egy legismertebb megoldás a Prometheus, a naplózásban nincs norma.
Ezen az előadáson két eszközt fogunk áttekinteni: egy népszerűt és egy másikat - a népszerűség felé haladót. Ezen kívül mások is léteznek, de ezt a cikket nem érintjük.
Figyelembe véve a fent tárgyalt sajátosságokat, a Kubernetes naplózása most így ábrázolható:
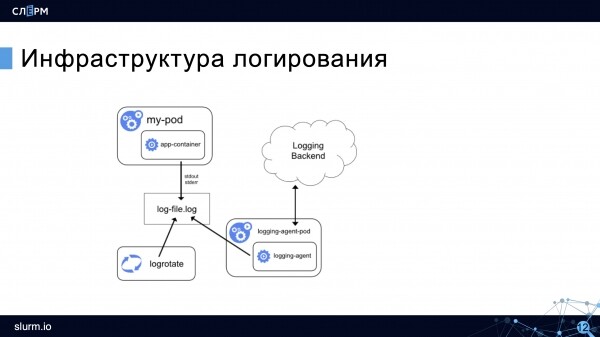
Megmarad a konténer naplója, a rotáció, de megjelenik egy gyűjtő ügynök, amely összegyűjti a naplókat és tárolásra küldi (az ábrán - Logging Backend). Az ügynök minden node-on működik és általában Kubernetesben fut.
Most nézzük meg a naplózási eszközöket.
Hogyan vezettek a Kubernetes pod prioritásai leálláshoz a Grafana Labsnál
Nemrég jelent meg, de már elég ismertté vált. Előnyei: könnyen telepíthető, kevés erőforrást fogyaszt, nem igényel Elasticsearch telepítést, mivel az adatokat TSDB-ben (idősor adatbázis) tárolja. Az előző cikkemben írtam, hogy ilyen adatbázisban tárolja az adatokat a Prometheus, és ez az egyik sok hasonlóság a két termék között. A fejlesztők még azt is állítják, hogy a Loki a „Prometheus a naplózás világában”.
Egy kis kitérő a TSDB-ről azok számára, akik nem olvasták. : A TSDB jól kezeli a nagy mennyiségű adatok és idősorok tárolását, de nem a hosszú távú tárolásra készült. Ha valamilyen oknál fogva két hétnél hosszabb ideig kell a naplókat tárolnia, akkor jobb, ha beállítja az átadásukat egy másik adatbázisba.
A Loki egyik másik előnye, hogy az adatok vizualizálásához a Grafanát használják. Nagyon kényelmes: a Grafanában nézzük a monitorozási adatokat, és ott ugyanazon a felületen, a Lokit összekötve, nézzük a naplókat. A naplókból grafikonokat is lehet építeni.
A Loki architektúrája körülbelül így néz ki:
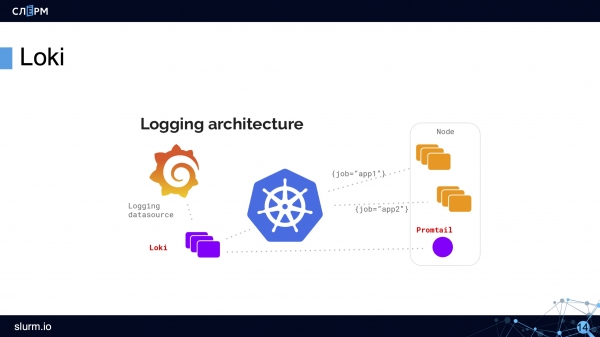
DaemonSet segítségével egy ügynök - Promtail vagy Fluent Bit - települ a klaszter összes szerverére. Az ügynök gyűjti a naplókat. A Loki ezekből átveszi és tárolja azokat a TSDB-ben. A naplókhoz azonnal metaadatok is hozzáadódnak, ami kényelmes: lehet szűrni Pods, névtartományok, konténernevek és akár címkék szerint is.
A Loki a jól ismert Grafana felületén működik. A Lokinak saját lekérdező nyelve is van, amelyet LogQL-nek hívnak - nevét és szintaxisát tekintve a PromQL-hez hasonlít a Prometheusban. A Loki felületén vannak javaslatok a lekérdezésekhez, így nem szükséges azokat fejből tudni.
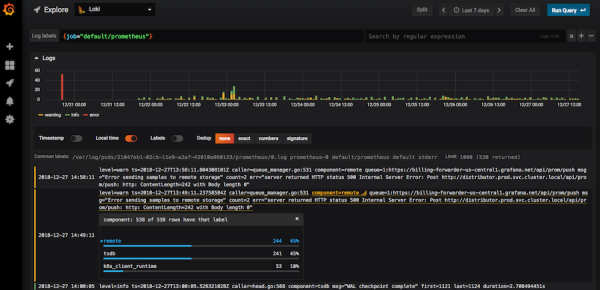
Loki a Grafana felületén
Szűrők használatával a Lokiban megtalálhatók a kódok („400”, „404” és bármely más); megtekinthetők a teljes nodból származó naplók; szűrheti az összes naplót, ahol szerepel a „hiba” szó. Ha rákattint egy naplóra, megnyílik egy kártya az esemény minden információjával.
A Lokiban elegendő eszköz áll rendelkezésre, amelyek lehetővé teszik a szükséges naplók kiemelését, bár őszintén szólva technikailag lehetne több is. Jelenleg a Loki aktívan fejlődik és egyre népszerűbbé válik.
Elastic + Fluent Bit + Kibana (EFK Stack)
Az EFK stack hagyományosabb, és ugyanakkor nem kevésbé népszerű naplózási eszköz.
A cikk elején említésre került az ELK (Elasticsearch + Logstash + Kibana), de ez a stack elavult a nem túl hatékony és erőforrásigényes Logstash miatt. Helyette egy könnyebb és hatékonyabb Fluentd-t használnak, amit később támogatott — egy még könnyebb és még hatékonyabb gyűjtőügynök.
A fejlesztők szerint a Fluent Bit több mint 100-szor jobb teljesítményű, mint a Fluentd: „ott, ahol a Fluentd 20 MB RAM-ot használ, a Fluent Bit 150 KB-ot” — ez egy közvetlen idézet a dokumentációból. Ebből kiindulva a Fluent Bit-et egyre gyakrabban használják.
A Fluent Bit kevesebb lehetőséget kínál, mint a Fluentd, de a fő igényeket kielégíti, ezért alapvetően a Fluent Bit-et használjuk.
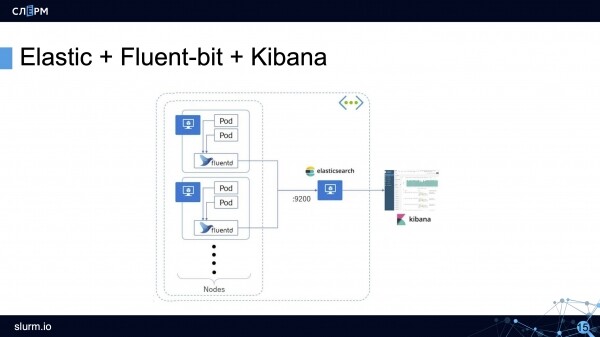
Az EFK stack működési sémája: az ügynök összegyűjti a naplókat az összes podból (jellemzően ez egy DaemonSet, ami a klaszter minden szerverén működik) és elküldi a tárolóba (Elasticsearch, PostgreSQL vagy Kafka). A Kibana csatlakozik a tárolóhoz, és kinyeri onnan a szükséges információkat.
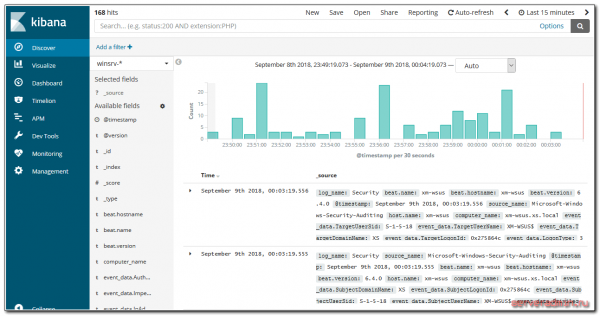
személyre szabottan egy kényelmes webes felületen mutatja be az információt. Vannak grafikonok, szűrők és sok más egyéb.
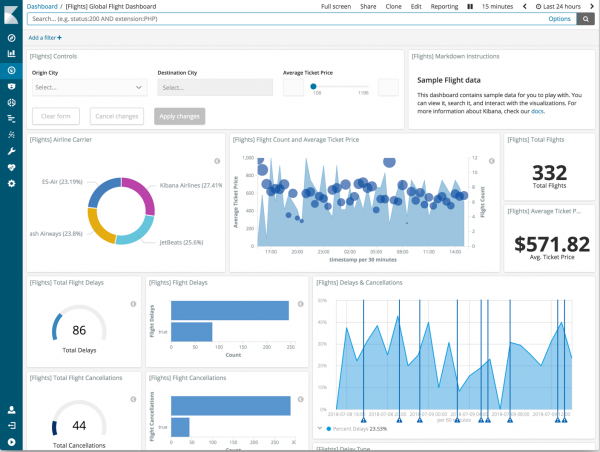
A naplókból teljes mértékben irányítópultokat lehet létrehozni.
A Fluent Bit lehetőségei
Mivel a Fluent Bit-ről általában kevesebben hallottak, mint a Logstash-ról, nézzük meg kicsit részletesebben. A Fluent Bit logikailag 6 modulra bontható, amelyeken plugineket lehet elhelyezni, amelyek kiterjesztik a Fluent Bit lehetőségeit.
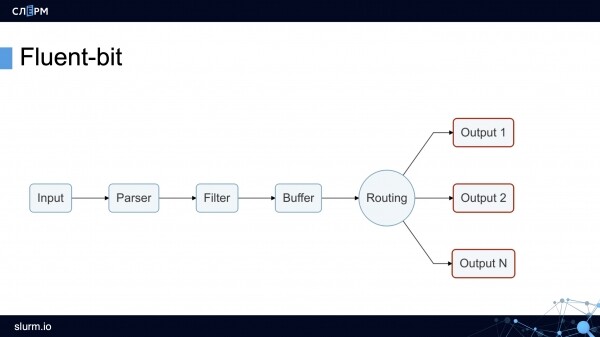
Input modul nagyja a naplókat fájlokból, systemd szolgáltatásokból, sőt tcp socket-ből is gyűjti (csak meg kell adni az endpointot, és a Fluent Bit elkezd ott gyűjteni). Ezek a lehetőségek elegendőek a naplók gyűjtésére mind a rendszerről, mind a konténerekről.
Gyártásban leggyakrabban a plugineket használjuk (ezeket a naplókat tartalmazó mappára irányíthatjuk) és (ezt meg lehet mondani, hogy melyik szolgáltatásokból gyűjtse a naplókat).
Parser modul egységesíti a naplókat. Alapértelmezett beállítás szerint az Nginx naplói egy sorban jelennek meg. A plugin segítségével ezt a sort JSON formátummá alakíthatjuk: mezőket és értékeket adunk meg. A JSON sokkal könnyebben kezelhető, mint a szöveges napló, mert sokkal rugalmasabb rendezési lehetőségeket kínál.
Filter modul. Ezen a szinten kiszűrik a felesleges naplókat. Például csak a “warning” értékkel vagy meghatározott címkékkel rendelkező naplókat küldenek tárolásra. A kiválasztott naplók a puffertárba kerülnek.
Buffer modul. A Fluent Bit-nek kétféle pufferje van: memória puffer és lemez puffer. A puffer egy ideiglenes tároló a naplók számára, amire hibák vagy leállások esetén szükség van. Mindenki szeretne spórolni a RAM-on, ezért általában a lemez puffert választják. De figyelembe kell venni, hogy a naplók mielőtt a lemezre kerülnének, először mindig a memóriába töltődnek.
Routing / Output modul tartalmazza a naplók küldésének szabályait és címeit. Ahogy már említettük, a naplókat küldhetjük Elasticsearchba, PostgreSQL-be vagy például Kafka-ba.
Érdekes, hogy a Fluent Bit-ből naplókat lehet küldeni a Fluentd-nek is. Mivel az első könnyebben használható és kevésbé funkcionális, rajta keresztül gyűjthetjük a naplókat és küldhetjük a Fluentd-nek, ahol további pluginek segítségével feldolgozhatjuk és tárolásokba küldhetjük őket.
Ha Elasticsearchot szeretne használni…
Végezetül két tanács mindazok számára, akik az Elasticsearchot tervezik használni napló tárolására a termelésben.
- Állítson be riasztásokat a . Ez a program kiemeli a naplók általános áramából a fontos üzeneteket, és róluk riasztásokat küld e-mailben vagy más csatornákon. Igaz, nemrégiben megjelent egy .
- Forgassa a naplókat a vagy az Elasticsearch API-jának használatával. Az Elastic egyébként jelentős lépéseket tesz a keresések élettartamának kezelésére külső eszközök nélkül. A hosszú távú naplózásnak igazából nincs értelme: valószínűleg egy napló két hét múlva nem fog szükséges lenni – ha tényleg kritikus, akkor az biztos, hogy két hét alatt feldolgozásra kerül. Végső esetben a régi naplókat archiválhatjuk és hosszú távú tárolásra helyezhetjük őket. Hallottam speciális naplókról, amelyeket a törvény szerint 5 évig kell tárolni. Személy szerint ezzel nem találkoztam, de ezt az információt nem vonnám párhuzamba a normális naplókkal, és lehet, hogy azokat külön kellene kezelni.
Folytatás következik…
Szerző: Marsel Ibraev, Kubernetes tanúsítvánnyal rendelkező adminisztrátor, gyakorló mérnök a , előadó és tanfolyamfejlesztő .
Forrás: habr.com
