

Röviden összefoglalva
- A magas szintű konténerek és mikroszolgáltatások, naplózás és alapvető metrikák megfigyeléséhez nem elegendő pusztán az, hogy jók legyenek.
- Az alkalmazásoknak a Magas Megfigyelhetőségi Elvet (HOP, High Observability Principle) kell alkalmazniuk a gyorsabb helyreállítás és a hibabiztosság növelése érdekében.
- A HOP megvalósításához az alkalmazás szinten szükséges: megfelelő naplózás, alapos monitorozás, egészségügyi vizsgálatok és teljesítmény / átmeneti nyomozás.
- A HOP elemének tekintse az egészségügyi ellenőrzéseket. átterjedési ellenőrzéshez és livenessProbe Kubernetes.
Mi az egészségügyi ellenőrzési minta?
Amikor kritikus fontosságú és magas rendelkezésre állású alkalmazást tervez, nagyon fontos figyelembe venni a hibabiztosságot. Az alkalmazás akkor tekinthető hibabiztosnak, ha gyorsan helyreáll a hiba után. A tipikus felhőalapú alkalmazás mikroszolgáltatás alapú architektúrát használ – amikor minden komponens külön konténerbe kerül. Annak érdekében, hogy biztosak legyünk abban, hogy a k8s-en futó alkalmazás magas rendelkezésre állású, a klaszter tervezésekor bizonyos minták követése szükséges. Ezek közé tartozik az egészségügyi ellenőrzési minta. Ez meghatározza, hogy az alkalmazás hogyan informálja a k8s-t a működéséről. Ez nem pusztán információ arról, hogy a pod működik-e, hanem arról is, hogy hogyan fogadja és válaszol a kérésekre. Minél többet tud a Kubernetes a pod működéséről, annál okosabb döntéseket hoz a forgalom irányításáról és a terhelés egyensúlyozásáról. Így a Magas Megfigyelhetőségi Elv lehetővé teszi, hogy az alkalmazás időben válaszoljon a kérésekre.
Magas Megfigyelhetőségi Elv (HOP)
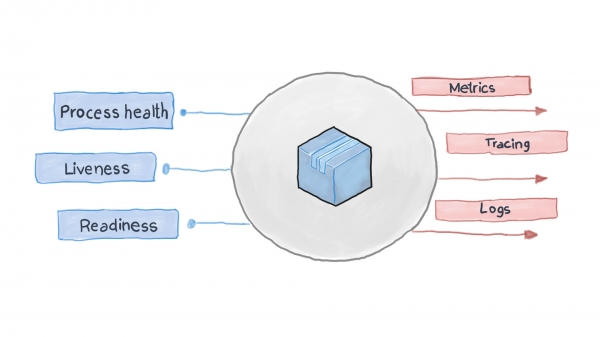
A Magas Megfigyelhetőségi Elv az egyik . A mikroszolgáltatás-architektúrában a szolgáltatások számára mindegy, hogyan dolgozzák fel a kérésüket (és ez helyes), de fontos, hogy miként kapjanak válaszokat a fogadó szolgáltatásoktól. Például, a felhasználó hitelesítéséhez egy konténer HTTP-kérést küld egy másiknak, várva egy válaszra egy meghatározott formátumban – ennyi az egész. A kérés feldolgozható PythonJS-sel, míg a válaszadás Python Flask segítségével történhet. A konténerek egymás számára – mint fekete dobozok rejtett tartalommal. A NEM-elv azonban azt követeli meg, hogy minden szolgáltatás több API végpontot nyújtson, amelyek megmutatják, mennyire működőképes, valamint a készenléti és hibatűrő állapotát. Ezeket az adatokat kéri a Kubernetes, hogy megtervezze a következő lépéseket az útválasztáshoz és a terheléselosztáshoz.
A jól megtervezett felhőalkalmazások naplózzák fő eseményeiket a szabványos STDOUT és STDERR bemeneti/kimeneti folyamatok használatával. Ezt követi egy segédszolgáltatás, például a filebeat, logstash vagy fluentd, amelyek a naplókat egy központosított monitorozó rendszerbe (például Prometheus) és egy naplógyűjtő rendszerbe (ELK szoftvercsomag) juttatják el. Az alábbi ábra azt mutatja be, hogyan működik egy felhőalkalmazás az Üzemképességi mintának és a Magas megfigyelhetőségi elvnek megfelelően.
Hogyan lehet alkalmazni az Üzemképességi mintát a Kubernetes-ben?
A k8s alapértelmezés szerint monitorozza a pod-ok állapotát az egyik vezérlő segítségével (, , , és egyebek). Ha észleli, hogy egy pod valamilyen okból leállt, a vezérlő megpróbálja újraindítani vagy egy másik csomópontjára átütemezni azt. Azonban a pod jelezheti, hogy elindult és működik, miközben valójában nem működik. Például: az alkalmazása Apache-t használ webkiszolgálóként, több pod-ra telepítette a komponenst a klaszterben. Mivel a könyvtár rosszul volt konfigurálva – minden kérésre 500-as kódot válaszol az alkalmazás. A szállítást ellenőrző állapotvizsgálat sikeres eredményt ad, azonban az ügyfelek másként tapasztalják. Ezt a nem kívánt szituációt a következőképpen írjuk le:
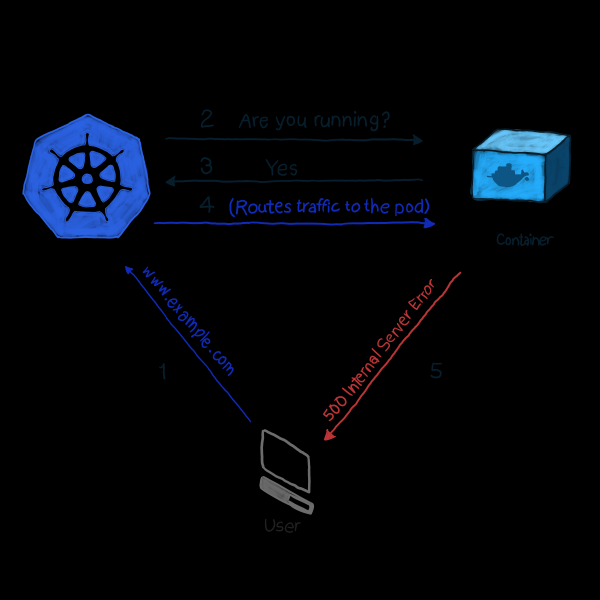
A példánkban a k8s végrehajtja az üzemképességi ellenőrzést. Ebben a típusú ellenőrzésben a kubelet folyamatosan ellenőrzi a folyamat állapotát a konténerben. Amint észleli, hogy a folyamat megállt, újraindítja azt. Ha a hiba egy egyszerű újraindítással orvosolható, és a programot úgy tervezték, hogy bármely hiba esetén leálljon, akkor a működési ellenőrzéshez elegendő a folyamat állapotának ellenőrzése. Sajnos nem minden hiba orvosolható újraindítással. Erre az esetre a k8s két mélyebb hibaelhárítási módot ajánl a pod működésének feltárására: és .
LivenessProbe
Közben livenessProbe a kubelet háromféle ellenőrzést végez: nemcsak azt állapítja meg, hogy a pod működik-e, hanem azt is, hogy készen áll-e a kérések fogadására és megfelelő válaszadásra:
- HTTP-kérést kell beállítani a podhoz. A válasznak 200 és 399 közötti HTTP-válaszkódot kell tartalmaznia. Így az 5xx és 4xx kódok jelzik, hogy a podnak problémái vannak, még akkor is, ha a folyamat működik.
- Nem HTTP-szolgáltatásokkal rendelkező podok ellenőrzéséhez (például Postfix levelezőszerver) TCP-kapcsolatot kell létesíteni.
- Tetszőleges parancs végrehajtása a podhoz (belsőleg). Az ellenőrzés sikeresnek számít, ha a parancs kilépési kódja 0.
Példa arra, hogyan működik ez. A következő pod meghatározása tartalmaz egy NodeJS alkalmazást, amely HTTP-kérésekre 500-as hibát ad vissza. Annak biztosítása érdekében, hogy a konténer újraindul, ha ilyen hibát kap, használjuk az livenessProbe paramétert:
apiVersion: v1
kind: Pod
metadata:
 name: node500
spec:
 containers:
   - image: magalix/node500
     name: node500
     ports:
       - containerPort: 3000
         protocol: TCP
     livenessProbe:
       httpGet:
         path: /
         port: 3000
       initialDelaySeconds: 5
Ez nem különbözik bármely más pod meghatározásától, de hozzátesszük az objektumot .spec.containers.livenessProbe. A paraméter httpGet elfogad egy útvonalat, amelyre HTTP GET kérést küld (példánkban ez a /, de éles helyzetekben lehet valami más, mint például /api/v1/status). Emellett a livenessProbe fogad egy initialDelaySecondsparamétert is, amely előírja, hogy a vizsgálati műveletnek meg kell várnia a megadott másodperceket. A késleltetés szükséges, mert a konténernek időre van szüksége az indításhoz, és újraindítás esetén egy ideig nem lesz elérhető.
A beállítás alkalmazásához a klaszterre használja:
kubectl apply -f pod.yamlNéhány másodperc múlva ellenőrizheti a pod tartalmát a következő paranccsal:
kubectl describe pods node500A kimenet végén keresse meg .
Ahogy látható, a livenessProbe HTTP GET kérdést indított, a konténer 500-as hibát adott vissza (ahogyan azt programozták), a kubelet újraindította.
Ha érdekli, hogyan lett programozva a NodeJS alkalmazás, itt van az app.js és a Dockerfile, amelyek felhasználásra kerültek:
app.js
var http = require('http');

var server = http.createServer(function(req, res) {
    res.writeHead(500, { "Content-type": "text/plain" });
    res.end("Hiba történtn");
});

server.listen(3000, function() {
    console.log('A szerver 3000-en fut')
})
Dockerfile
FROM node
COPY app.js /
EXPOSE 3000
ENTRYPOINT [ "node","/app.js" ]
Fontos figyelni arra, hogy a livenessProbe csak hiba esetén indítja újra a konténert. Ha az újraindítás nem javítja meg a konténer működését akadályozó hibát, a kubelet nem tud intézkedéseket tenni a hiba elhárítására.
átterjedési ellenőrzéshez
A readinessProbe hasonlóan működik a livenessProbe-hoz (GET-kérések, TCP kapcsolatok és parancsok végrehajtása), kivéve a hibaelhárítási intézkedéseket. Az a konténer, amelyben hiba történt, nem indul újra, hanem elszigetelődik a bejövő forgalomtól. Képzelje el, hogy az egyik konténer számításigényes feladatokat végez, vagy erős terhelésnek van kitéve, ami miatt megnő a válaszidő a kérésekre. A livenessProbe esetén a válaszkészség ellenőrzése (timeoutSeconds paraméter által) után a kubelet újraindítja a konténert. Amikor újraindítják, a konténer újra erőforrás-igényes feladatokat kezd el végezni, és újra újraindítják. Ez kritikus lehet az olyan alkalmazások számára, amelyeknél fontos a válaszidő. Például egy gép úton vár egy választ a szervertől, a válasz késik – és a gép balesetet szenved.
Készítsünk egy redinessProbe meghatározást, amely beállítja a GET-kérés válaszidejét legfeljebb két másodpercre, míg az alkalmazás 5 másodperc alatt válaszol a GET-kérelemre. A pod.yaml fájlnak a következőképpen kell kinéznie:
apiVersion: v1
kind: Pod
metadata:
 name: nodedelayed
spec:
 containers:
   - image: afakharany/node_delayed
     name: nodedelayed
     ports:
       - containerPort: 3000
         protocol: TCP
     readinessProbe:
       httpGet:
         path: /
         port: 3000
       timeoutSeconds: 2
Telepítjük a podot a kubectl segítségével:
kubectl apply -f pod.yamlVárjunk pár másodpercet, majd nézzük meg, hogyan működött a readinessProbe:
kubectl describe pods nodedelayedA kimenet végén látható, hogy egyes események hasonlóak ehhez .
Ahogy látható, a kubectl nem indította újra a podot, amikor a vizsgálat ideje meghaladta a 2 másodpercet. Ehelyett az igényelt kérés visszautasításra került. A bejövő kapcsolatok más, működő podokhoz vannak irányítva.
Észrevette: most, hogy a pod-ról eltávolították a felesleges terhet, a kubectl újra irányítja a kéréseket hozzá: a GET-kérésekre adott válaszok már nem késlekednek.
Összehasonlításképpen: itt a módosított app.js fájl:
var http = require('http');

var server = http.createServer(function(req, res) {
   const sleep = (milliseconds) => {
       return new Promise(resolve => setTimeout(resolve, milliseconds))
   }
   sleep(5000).then(() => {
       res.writeHead(200, { "Content-type": "text/plain" });
       res.end("Hellon");
   })
});

server.listen(3000, function() {
   console.log('A szerver a 3000-es porton fut')
})
Röviden összefoglalva
A felhőalkalmazások megjelenése előtt a fő eszköz a rendszerek monitorozására és állapotának ellenőrzésére a naplók voltak. Azonban nem voltak eszközök a problémák elhárítására. A naplók ma is hasznosak, ezeket össze kell gyűjteni és elküldeni a naplógyűjtő rendszerbe katasztrófaelemzés és döntéshozatal céljából. [ez mind megoldható volt felhőalkalmazások nélkül is, például monit segítségével, de a k8s-szel sokkal egyszerűbbé vált 🙂 – a szerkesztő megjegyzése. ]
Ma a javításokat szinte valós időben kell végrehajtani, ezért az alkalmazások már nem lehetnek fekete dobozok. Nem, meg kell mutatniuk azokat a végpontokat, amelyek lehetővé teszik a monitorozó rendszerek számára, hogy kérdéseket intézzenek és értékes adatokat gyűjtsenek a folyamatok állapotáról, hogy szükség esetén azonnal reagálhassanak. Ezt nevezik a működési készség ellenőrzésének mintájának, amely követi a Magas megfigyelhetőségi elvet (HOP).
A Kubernetes alapértelmezetten 2 típusú működési készség ellenőrzést ajánl: readinessProbe és livenessProbe. Mindkettő ugyanolyan típusú ellenőrzéseket használ (HTTP GET kérések, TCP kapcsolatok és parancsok végrehajtása). Abban különböznek, hogy milyen döntéseket hoznak a pod-ok hibáira reagálva. A livenessProbe újraindítja a konténert abban a reményben, hogy a hiba többet nem ismétlődik, míg a readinessProbe izolálja a pod-ot a bejövő forgalomtól – a hiba okának elhárításáig.
A megfelelő alkalmazástervezésnek mindkét típusú ellenőrzést tartalmaznia kell, és elég adatot kell gyűjtenie, különösen akkor, amikor kivételes helyzet áll fenn. Ezen kívül meg kell mutatnia a szükséges API végpontokat, melyek a monitorozó rendszer (mint például a Prometheus) számára fontos működési készség metrikákat közvetítenek.
Forrás: habr.com
