

A fontos szempont a elosztott rendszerek működésében a hibakezelés. A Kubernetes ebben segít azáltal, hogy vezérlőket használ, amelyek figyelik a rendszer állapotát, és újraindítják a leállt szolgáltatásokat. Azonban a Kubernetes kényszerítheti az alkalmazások leállítását is a rendszer általános életképességének biztosítása érdekében. Ebben a sorozatban azt vizsgáljuk meg, hogyan segíthetjük a Kubernetes-t abban, hogy hatékonyabban végezze feladatát és csökkentse az alkalmazások leállásának időtartamát.
A konténerek alkalmazásának megkezdése előtt a legtöbb alkalmazás virtuális vagy fizikai gépeken futott. Ha egy alkalmazás leállt vagy lefagyt, sok időbe telt a futó feladat leállítása és a program újraindítása. A legrosszabb esetben valakinek éjjel, a legkellemetlenebb időpontban kellett megoldania ezt a problémát. Ha egy fontos feladatot mindössze 1-2 munkagép végzett, egy ilyen működési hiba teljesen elfogadhatatlan volt.
Ezért a kézi újraindítás helyett elkezdtek folyamatautomatizálást használni a folyamatok szintjén, hogy automatikusan újraindítsák az alkalmazást vészhelyzet esetén. Ha a program leállt, a megfigyelő folyamat rögzíti az exit-kódot és újraindítja a szervert. Az olyan rendszerek megjelenésével, mint a Kubernetes, ez a fajta hibaérzékelés egyszerűen integrálódott az infrastruktúrába.
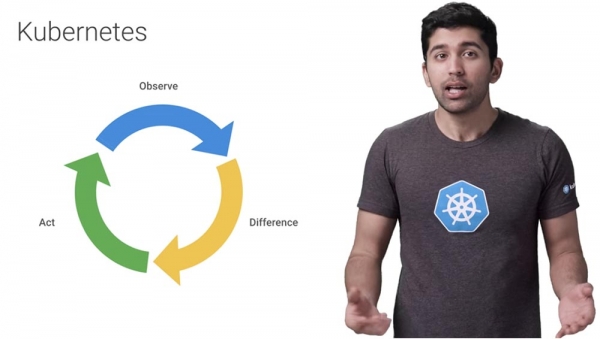
A Kubernetes esemény-újdonság hurok, amely a "figyelés - eltérések rögzítése - művelet végrehajtása" elvet követi, hogy biztosítsa, hogy az erőforrások működőképesek maradjanak az edényekből a csomópontokig.
Ez azt jelenti, hogy már nem szükséges kézzel elindítani a folyamatfigyelést. Ha egy erőforrás nem felel meg az állapotellenőrzésnek, a Kubernetes egyszerűen automatikusan helyettesíti azt. A Kubernetes ráadásul sokkal többet csinál, mint hogy csak figyeli az alkalmazásait. További példányokat hozhat létre az alkalmazásból több gépen, frissítheti az alkalmazást, vagy egyszerre több verziót is futtathat az Ön alkalmazásából.
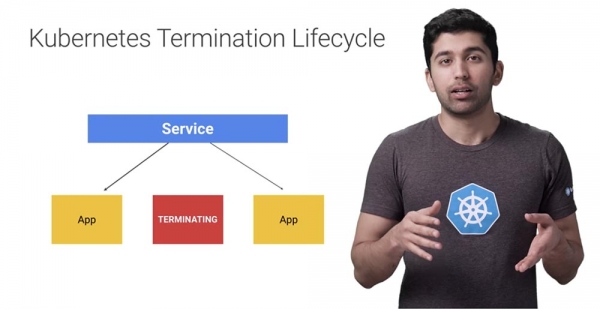
Ezért számos oka van annak, hogy a Kubernetes leállíthat egy teljesen egészséges konténert. Például, ha frissíted a telepítést, a Kubernetes lassan leállítja a régi podokat, miközben újakat indít. Ha egy csomópontot lekapcsolsz, a Kubernetes leállítja az összes podot ezen a csomóponton. Végül, ha egy csomópont kimeríti az erőforrásait, a Kubernetes az összes podot leállítja, hogy felszabadítsa ezeket az erőforrásokat.
Ezért rendkívül fontos, hogy az alkalmazásod a lehető legkisebb hatással a végfelhasználóra és minimális helyreállítással álljon le. Ez azt jelenti, hogy lekapcsolás előtt meg kell őriznie minden szükséges adatot, be kell zárnia minden hálózati kapcsolatot, be kell fejeznie a fennmaradó feladatokat, és el kell végeznie egyéb sürgős teendőket.
A gyakorlatban ez azt jelenti, hogy az alkalmazásodnak képesnek kell lennie kezelni a SIGTERM üzenetet - a folyamat leállításának jele, amely a kill parancs alapértelmezett jele a Unix családú operációs rendszerekben. Miután megkapta ezt az üzenetet, az alkalmazásnak le kell állnia.
Miután a Kubernetes úgy döntött, hogy leállítja a podot, egy sor esemény következik be. Vizsgáljuk meg lépésről lépésre, hogy a Kubernetes hogyan jár el egy konténer vagy pod leállításakor.
Tegyük fel, hogy le szeretnénk állítani az egyik podot. Ekkor ez a pod már nem fog új forgalmat kapni - a podban futó konténerek nincsenek érintve, de minden új forgalmat blokkolni fognak.
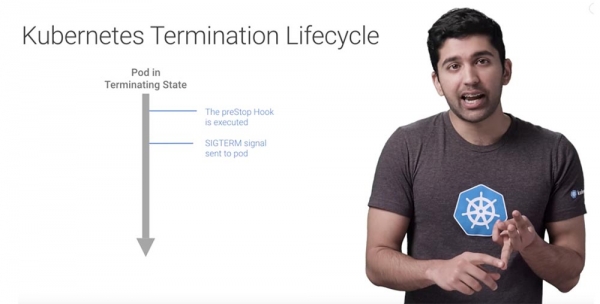
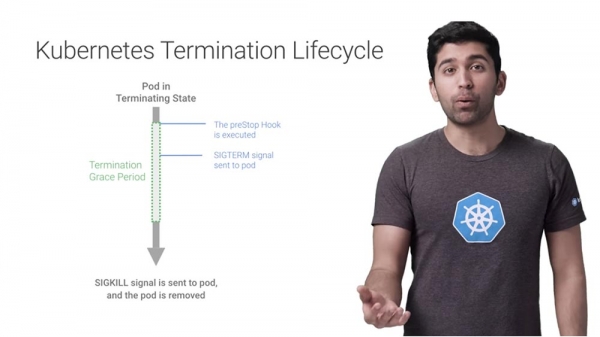
Nézzük meg a preStop horgot - ez egy speciális parancs vagy HTTP-kérés, amit a podban lévő konténerek kapnak. Ha az alkalmazásod a SIGTERM jelzésre nem áll le megfelelően, a preStop segítségével biztosíthatod a helyes leállítást.
A legtöbb program a SIGTERM jelzés bek收到 kontemplat a rendelés után megfelelően fejezi be a működését, de ha harmadik féltől származó kódot vagy egy olyan rendszert használsz, amelyet nem tudsz teljes mértékben ellenőrizni, a preStop horgok remek módot kínálnak a finom leállításra anélkül, hogy módosítanád az alkalmazást.
A Kubernetes ez a horgot követően SIGTERM jelet küld a podban található konténereknek, amely értesíti őket, hogy hamarosan le lesznek állítva. A jel megérkezésekor a kódja elkezd a leállítási folyamathoz. Ez a folyamat magában foglalhatja a tartós kapcsolatok, például az adatbázis-kapcsolatok vagy WebSocket-folyamatok leállítását, a jelenlegi állapot mentését, és hasonlókat.
Még ha preStop horgot is használ, nagyon fontos ellenőrizni, hogy mi történik az alkalmazásával, amikor SIGTERM jelet küld, hogyan reagál, hogy az események vagy a rendszer működésében bekövetkező változások, amelyeket a pod leállítása okoz, ne okozzanak meglepetést.
Ezen a ponton, mielőtt további lépéseket tenne, a Kubernetes megvárja az adott időt, amelyet terminationGracePeriodSecond néven ismerünk, vagyis a helyes leállításhoz szükséges időt a SIGTERM jel megérkezésekor.
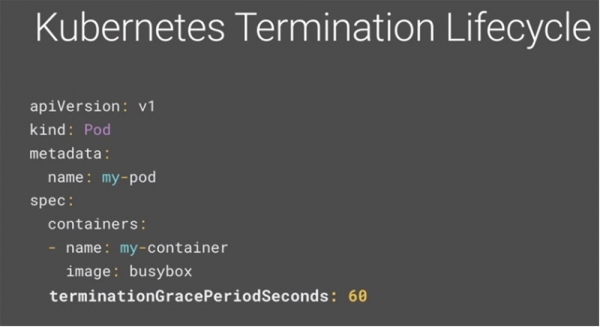
Alapértelmezés szerint ez az időszak 30 másodperc. Fontos megjegyezni, hogy ez a preStop horgony és a SIGTERM jel mellett párhuzamosan zajlik. A Kubernetes nem várja meg, amíg a preStop horgony és a SIGTERM befejeződik — ha az alkalmazása a TerminationGracePeriod vége előtt leáll, a Kubernetes azonnal továbblép a következő lépésre. Ezért ellenőrizze, hogy az időszak másodpercekben megadott értéke ne legyen kevesebb a pod helyes leállításához szükséges időnél, és ha meghaladja a 30 másodpercet, növelje az időt a szükséges méretre a YAML-ban. A bemutatott példában ez 60 másodperc.
Végül, az utolsó lépés — ha a konténerek a terminationGracePeriod lejárta után is futnak, SIGKILL jelet küldenek és kényszerítve lesznek eltávolítva. Ezen a ponton a Kubernetes szintén törli a pod összes többi objektumát.
A Kubernetes sok okból leállítja a podokat, ezért győződjön meg arról, hogy az alkalmazása bármilyen esetben helyesen befejeződik, hogy biztosítsa a szolgáltatás stabilitását.
Egy kis reklám 🙂
Köszönjük, hogy velünk maradtál. Tetszenek a cikkeink? Szeretnél több érdekes anyagot látni? Támogass minket, és rendelés leadásával vagy ismerősöknek ajánlással segíts nekünk. , Egyedülálló alternatívája az entry-level szervereknek, amelyet Önnek találtunk ki: (elérhetők RAID1 és RAID10 opciók, akár 24 magig és 40GB DDR4-ig).
Dell R730xd kétszer olcsóbban a Tier IV Equinix adatközpontban Amszterdamban? Csak nálunk Hollandiában! Dell R420 — 2x E5-2430 2.2GHz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — 99 dollártól! Olvasd el ezt
Forrás: habr.com
