

Helló, Habr! Megerősítjük a Data Engineer-eket és a Machine Learning szakembereket egy ingyenes Demó órára . Valamint közzétesszük Luca Monno cikkét – a CDP SpA pénzügyi elemzési vezetőjétől.
Az egyik leghasznosabb és legegyszerűbb gépi tanulási módszer az Ensemble Learning. Az Ensemble Learning egy olyan módszer, amely az XGBoost, Bagging, Random Forest és sok más algoritmus alapjául szolgál.
A Towards Data Science oldalon sok klassz cikk található, de én két történetet választottam ki ( és ), amelyek a legjobban tetszettek nekem. De miért írjak még egy cikket az EL-ről? Mert szeretném megmutatni Önöknek, hogyan működik ez egy egyszerű példán keresztül, amely segített megértenem, hogy itt nincsen semmiféle varázslat.
Amikor először láttam az EL-t működés közben (nagyon egyszerű regressziós modellek használatával), nem akartam elhinni a szememnek, és azóta is emlékszem arra a professzorra, aki megtanított erre a módszerre.
Két különböző modellem volt (két gyenge tanulási algoritmus), R² értéke 0,90 és 0,93 volt. out-of-sample Mielőtt megnéztem volna az eredményt, azt gondoltam, hogy R² valahol a két kezdeti érték között lesz. Más szóval, úgy gondoltam, hogy az EL használható arra, hogy a modell ne teljesítsen rosszabbul, mint a legrosszabb, de ne is teljesítsen annyira jól, mint a legjobb modell.
A legnagyobb meglepetésemre az egyszerű predikciók átlagolásának eredménye R² 0,95 lett.
Először hibát kezdtem keresni, de aztán arra gondoltam, hogy itt talán valami varázslat rejtőzik!
Mi az az Ensemble Learning?
Az EL segítségével két vagy több modell előrejelzéseit egyesíthetjük, hogy megbízhatóbb és jobb teljesítményű modellt kapjunk. Számos metodológia létezik az modellek együttes használatára. Itt két hasznos módszert érinteni fogok, hogy általános képet adjak.
A segítségével regresszió az aktuális modellek teljesítményének átlagolásával.
A segítségével klasszifikáció a modelleknek lehetőséget adva a címkék választására. Az a címke, amelyet a leggyakrabban választottak – az lesz, amit az új modell választ.
Miért működik az EL jobban?
Az EL egyik fő oka, hogy jobban működik, az az, hogy minden előrejelzéshez van hiba (erről a valószínűségelméletből tudunk), két előrejelzés összekapcsolása csökkentheti a hibát, így javíthatja a teljesítményt (RMSE, R² stb.).
A következő diagramon látható, hogyan működik két gyenge algoritmus egy adathalmazon. Az első algoritmus nagyobb meredekséggel rendelkezik, mint amire szükség lenne, míg a második meredeksége szinte nulla (valószínűleg túlzott regularizáció miatt). De ensemble jelentősen jobb eredményt mutat.
Ha az R² értéket nézzük, az első és második tanuló algoritmus esetében -0,01¹ és 0,22, míg az egyesített modell esetében 0,73 lesz.
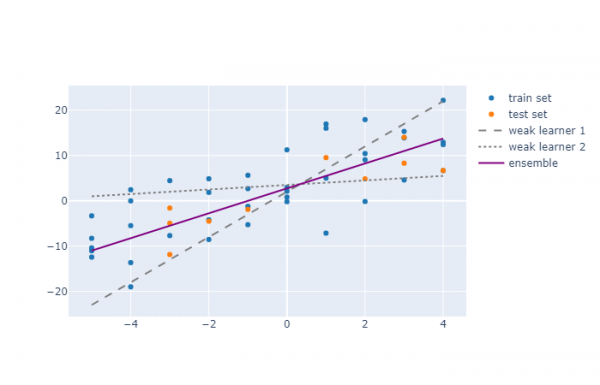
Számos oka lehet annak, hogy egy algoritmus gyenge modellnek bizonyulhat még egy ilyen egyszerű példában is: lehet, hogy regularizációt alkalmazott a túltanulás elkerülésére, vagy úgy döntött, hogy nem zár ki bizonyos anomáliákat, esetleg polinom regressziót használt, és majdnem elhibázta a fokot (például a másodfokú polinomot használta, miközben a tesztadatok világos aszimmetriát mutattak, amelyhez jobban illeszkedne a harmadik fok).
Amikor az EL jobban működik
Nézzünk meg két tanító algoritmust, amelyek azonos adatokkal dolgoznak.
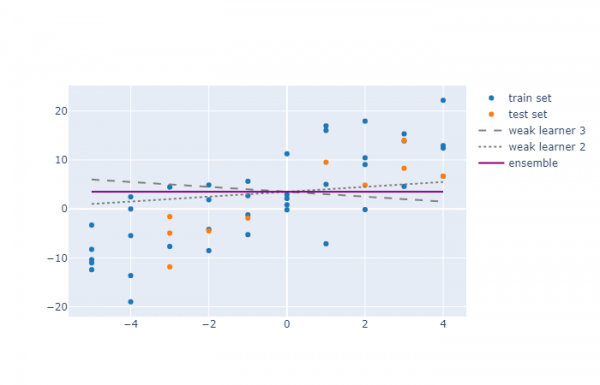
Itt látható, hogy a két modell összekapcsolása nem javította jelentősen a teljesítményt. Az első és második tanuló algoritmus R² értékei kezdetben -0,37 és 0,22 voltak, míg az egyesített modell -0,04-et ért el. Tehát az EL modell átlagos teljesítménye lett.
Azonban a két példa között nagy különbség van: az első példában a modellek hibái negatívan korreláltak, míg a másodikban pozitívan (a három modell koefficienseit nem értékelték, hanem egyszerűen a szerző által példaként választották ki).
Következésképpen az Ensemble Learning használható a torzítás/szórás egyensúlyának javítására bármilyen esetben, de amikor a modellek hibái nem korrelálnak pozitívan, az EL használata növelheti a teljesítményt.
Homoszférikus és heteroszférikus modellek
Az EL gyakran homogén modellek esetén használatos (mint ebben a példában vagy a véletlen erdőben), de valójában különböző modellek (linear regression + neurális háló + XGBoost) kombinálhatóak különböző magyarázó változók halmaival. Valószínűleg ez korrelálatlan hibákhoz és teljesítményjavuláshoz vezet.
Összehasonlítás a portfólió diverzifikációval
Az EL a portfólióelmélet diverzifikációjára hasonlít, de ez nekünk kedvezőbb.
A diverzifikáció során próbálja csökkenteni az indikátorok szórását, úgy, hogy nem korreláló részvényekbe fektet be. Egy jól diverzifikált részvényportfólió jobb eredményt ad, mint a legrosszabb különálló részvény, de soha nem jobb, mint a legjobb.
Warren Buffett szavaival élve:
„A diverzifikáció az tudatlanságtól való védelem, akinek fogalma sincs arról, mit csinál, az számára [a diverzifikáció] nagyon kevés értelmet nyer.”
A gépi tanulásban az EL segít csökkenteni a modell szórását, de ez egy olyan modell létrehozásához vezethet, amelynek általános teljesítménye jobb, mint a legjobb kezdeti modell.
Összegzés
Több modell egyesítése egybe viszonylag egyszerű módszer, amely megoldhatja a szórási torzítás problémáját, és növelheti a teljesítményt.
Ha van két vagy több jól működő modellje, ne válasszon közülük: használja mindet (de óvatosan)!
Érdekel, hogy ebben az irányban fejlődj? Jelentkezzen ingyenes bemutató órára és vegyen részt — Machine Learning Engineer a Mail.ru Groupnál.
Forrás: habr.com
