

A jelentés bemutat néhány olyan megközelítést, amelyek lehetővé teszik millió SQL-lekérdezés teljesítményének nyomon követését napi szinten, és a felügyelt PostgreSQL kiszolgálók számának számosát.
Mely technikai megoldások segítenek nekünk hatékonyan kezelni ezt az információmennyiséget, és hogyan könnyíti meg ez a hétköznapi fejlesztők életét.
Kit érdekel konkrét problémák elemzése és különböző optimalizálási technikák SQL-lekérdezések és tipikus DBA-feladatok megoldása PostgreSQL-ben – szintén lehetőséget biztosít arra, hogy erről a témáról.
A nevem Kirill Borovikov, a . Kifejezetten az adatbázisokkal való munkára specializálódtam a cégünknél.
Ma arról fogok beszélni, hogyan optimalizáljuk a lekérdezéseket, amikor nem azt kell „kicsit megnedvesíteni”, hogy egyetlen lekérdezés teljesítménye javuljon, hanem tömeges problémákat kell megoldanunk. Amikor a lekérdezések számában több millió van, és meg kell találnunk különböző megoldásokat erre a nagy problémára. Alapvetően a Tenzor több mint egymillió ügyfél számára
a SBIS – a mi alkalmazásunk, Ahhoz, hogy mindez jól működjön és fejlődjön — az ország különböző részein 10 fejlesztő központunk van, ahol több mint
1000 fejlesztő dolgozik..
A PostgreSQL-t 2008 óta használjuk, és hatalmas mennyiségű dolgot kezelünk — ezek ügyféldata, statisztikai, elemző adatok, külső információs rendszerekből származó adatok — több mint 400TB.Csak a „produkcióban” körülbelül 250 szerverünk van, és összesen körülbelül 1000 DB-kiszolgálót monitorozunk.
Az SQL egy deklaratív nyelv. Ön nem azt írja le, hogy „hogyan” kell valaminek működnie, hanem azt, hogy „mit” szeretne kapni. Az SGBD jobban tudja, hogyan kell végrehajtani a JOIN-t — hogyan kell összekapcsolni a táblákat, milyen feltételeket kell alkalmazni, mi halad végig az indexen, mi nem…
Egyes SGBD-k elfogadnak ajánlásokat: „Nem, ezeket a két táblát ebben a sorrendben kell összekapcsolni”, de a PostgreSQL ezt nem tudja. Ez a vezető fejlesztők tudatos álláspontja: „Jobb, ha az optimalizálót finomítjuk, mint hogy lehetővé tegyük a fejlesztők számára, hogy hárítsák a hintákat.”
De, bár a PostgreSQL nem engedi, hogy kívülről irányítsuk, remekül lehetőséget ad arra, hogy lássuk, mi történik a "belső" terében,, amikor végrehajtjuk a lekérdezésünket, és hol merülnek fel a problémák.
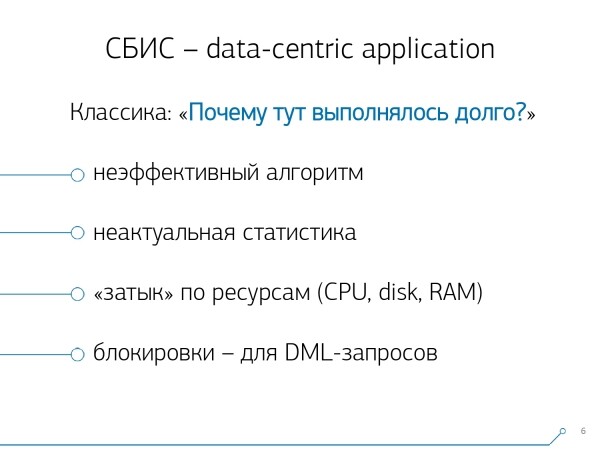
Általában milyen klasszikus problémákkal kerülnek a fejlesztők [a DBA-hoz]? "Itt futtattunk egy lekérdezést, és minden lassú,, minden megakadt, valami történik… Valami baj van!"
Az okok majdnem mindig ugyanazok:
- hatékonytalan lekérdezési algoritmus.
Fejlesztő: "Most 10 táblát kapcsolok össze SQL-ben..." — és azt várja, hogy a feltételei csodálatos módon hatékonyan "megoldódnak", és gyorsan megkapja az eredményeket. De csodák nincsenek, és bármely rendszer ilyen variabilitás mellett (10 tábla egy FROM-ban) mindig ad valamilyen hibát. [] - elavult statisztikák
Ez a kérdés különösen aktuális a PostgreSQL esetében, amikor egy nagy adathalmazon dolgozol, és azt mondod, hogy a lekérdezésed - de ő "szekvenciálisan" járja be a táblázatot. Mert tegnap 10 rekord volt benne, ma már 10 millió, de a PostgreSQL még nem tud róla, és erről értesítened kell. [] - „elakadás” az erőforrásokban
Felállítottál egy nagy és nehezen terhelt adatbázist egy gyenge szerverre, amelynek nincs elég lemezterülete, memóriája, vagy a processzor teljesítménye gyenge. És ennyi… Valahol van egy teljesítménykorlát, amit már nem tudsz túllépni. - zárolások
Bonyolult kérdés, de ezek leginkább különböző módosító lekérdezésekre (INSERT, UPDATE, DELETE) vonatkoznak - ez egy külön nagy téma.
A terv megszerzése
… És minden máshoz szükségünk van tervre! Látni kell, mi történik a szerveren belül.
A PostgreSQL lekérdezési végrehajtási terve egy fáfa, amely a lekérdezés végrehajtási algoritmusának szöveges ábrázolása. Pontosan az a algoritmus, amelyet a tervező a legjobbnak ítélt a bejáratás során.
Minden faág - művelet: adatok kinyerése táblából vagy indexből, bitkép építése, két táblázat összekapcsolása, unió, metszet vagy minták kizárása. A lekérdezés végrehajtása - a fák ágain való átjárás.
A lekérdezési terv beszerzésének legegyszerűbb módja az utasítás végrehajtása, EXPLAIN. Ahhoz, hogy valós attribútumokkal, azaz valóban végrehajtsd a lekérdezést az adatbázison - EXPLAIN (ANALYZE, BUFFERS) SELECT ....
Rossz pillanat: amikor végrehajtod, ez »itt és most« történik, így csak helyi hibakeresésre alkalmas. Ha viszont van egy nagy terhelésű szervered, ami intenzív adatváltozások alatt áll, és azt látod: »Ó! Itt lassan fut le alekérdezés.« Fél órája, egy órája — míg te kerested és visszahúztad a lekérdezést a naplóból, és újra a szerverre vittük, az egész adatgyűjteményed és statisztikád megváltozott. Execute it to debug — and it runs fast! And you can’t understand why, why lassan. történt Ahhoz, hogy megértsd, mi történik pontosan abban a pillanatban, amikor a lekérdezés a szerveren fut, okos emberek kitalálták
az auto_explain modult. Ha észleli, hogy egy lekérdezés a megadott határidőn túl fut, készít egy
»pillanatfelvételt« a lekérdezés tervéről és ezt is beleírja a naplóba. Úgy tűnik, most minden rendben van, megyünk a naplóba, és ott látjuk… [szöveges blokk]. De erről semmit nem tudunk mondani, azon kívül, hogy ez egy remek terv, mert 11 ms alatt futott..
Úgy tűnik, minden rendben van — de semmi nem világos, hogy mi is történt valójában. Az összesített időn kívül alig látunk valamit. Mert egy ilyen »batyut« plain textként nézni nem igazán áttekinthető.
De még ha nem is átlátható, kényelmetlen, de vannak komolyabb problémák:
A csomóponton meg van adva
- az összeg az egész alhálózat erőforrásait illetően alatta. Tehát egyszerűen nem tudod megmondani, hogy mennyi időt töltött el a lekérdezés konkrétan ezen az Index Scan-en — ha alatta van egy beágyazott feltétel. Dinamikusan kell néznünk, hogy nincs-e benne »gyerek« és feltételes változók, CTE — és ezt mind „fejben” kell levonni. A második pillanat: az idő, amelyet a csomópont megad, — ez
- a csomópont egyszeri végrehajtási ideje. Ha ez a csomópont a táblázat rekordjainak ciklusában lett végrehajtva, többször, akkor a tervben növekszik a loops száma — az e csomópont ciklusainak száma. De az atomisztikus végrehajtási idő magában a tervben változatlan marad. Tehát ahhoz, hogy megértsd, mennyi ideig működött ez a csomópont összesen, az egyiket a másikkal kell szorozni — megint csak „fejben”.. Если этот узел выполнялся в результате, например, цикла по записям таблицы, несколько раз, то в плане увеличивается количество loops — циклов этого узла. Но само время атомарного выполнения остается в плане прежним. То есть для того, чтобы понять, а сколько же этот узел выполнялся всего суммарно, надо одно умножать на другое — опять-таки «в уме».
Ilyen körülmények között szinte lehetetlen megérteni, hogy "Ki a leggyengébb láncszem?" Ezért még a fejlesztők is a "kézikönyvben" azt írják, hogy "A tervek megértése egy művészet, amelyet meg kell tanulni, tapasztalat...".
De nekünk 1000 fejlesztőnk van, és ezt a tapasztalatot mindenkinek nem tudjuk a fejébe adni. Én, te, ő — tudják, de valaki ott már nem. Talán megtanulja, talán nem, de már most dolgoznia kell — honnan szerezze ezt a tapasztalatot.
A terv vizualizálása
Ezért megértettük — ahhoz, hogy ezeket a problémákat kezelhessük, szükségünk van jó tervvizualizációra.
Először a "piacon" indultunk — nézzük meg az interneten, hogy mi létezik egyáltalán.
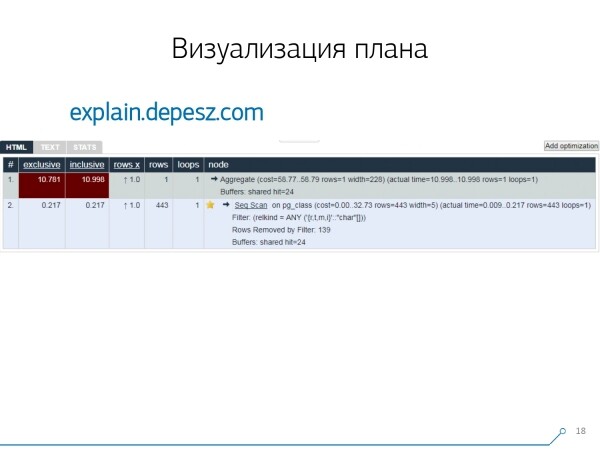
De kiderült, hogy a "valódi" megoldásokból, amelyek valamilyen szinten fejlődnek, nagyon kevés van — szinte csak egy: Hubert Lubaczewski-től. A mezőbe szöveges formában "betáplálod" a tervet, és megmutatja a táblázatot az elemezett adatokkal:
- a csomópont saját feldolgozási ideje
- az összes idő az egész részfán
- azoknak a rekordoknak a száma, amelyet ki kellett volna vonni, és amely statisztikailag várt
- maga a csomópont teste
Ennek a szolgáltatásnak van lehetősége megosztani a linkek archívumát is. Bepakoltad a terveidet, és mondod: "Hé, Vanya, itt van a link, ott valami nem stimmel."
De vannak kisebb problémák is.
Először is, hatalmas mennyiségű "másolás-beillesztés". Fogsz egy logdarabot, belerakod, és újra, meg újra.
Másodszor, nincs elemzés a beolvasott adatok mennyiségéről — a buffer-ek, amelyeket kiad, EXPLAIN (ANALYZE, BUFFERS), itt nem látjuk. Egyszerűen nem tudja őket elemezni, megérteni és dolgozni velük. Amikor sok adatot olvasol, és megérted, hogy lehet, hogy rosszul "készülődöl" elosztani a lemezen és a memóriában, ez az információ nagyon fontos.
A harmadik negatív dolog — ennek a projektnek az nagyon gyenge fejlődése. A commitok nagyon kicsik, jó, ha félévente egyszer, és a kód Perl-en íródott.
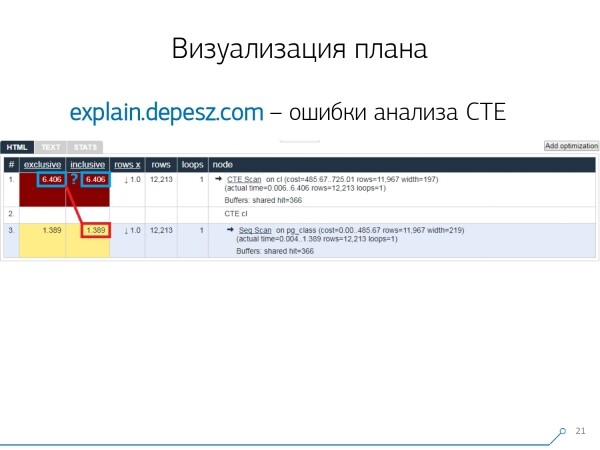
De ez mind "líra", ezzel valahogy meg lehetne élni, de van egy dolog, ami erősen elfordított minket ettől a szolgáltatástól. Ezek a Common Table Expression (CTE) és a különböző dinamikus csomópontok, mint az InitPlan/SubPlan, elemzési hibái.
Ha elhisszük ezt a képet, akkor a külön csomópontok összes végrehajtási ideje nagyobb, mint az egész lekérdezés összes végrehajtási ideje. Minden egyszerű — a CTE Scan csomópontból nem vonták le a CTE generálási idejét. Ezért már nem tudjuk, mennyi időt is vett igénybe magának a CTE szkennelésnek.
Itt jöttünk rá, hogy ideje létrehozni a sajátunkat — hurrá-hurrá! Minden fejlesztő azt mondta: "Most megírjuk a sajátunkat, szuper egyszerű lesz!"
Egy tipikus webes szolgáltatásokra jellemző stack-et vettünk: a mag Node.js + Express, Bootstrap-ot húztunk fel, és a szép diagramokhoz D3.js-t használtunk. És az elvárásaink teljesen teljesültek — az első prototípust 2 hét alatt elkészítettük:
- saját tervparsert
Ezért most már bármilyen tervet elemezhetünk, amit a PostgreSQL generál. - helyes dinamikus csomópont-elemzés — CTE Scan, InitPlan, SubPlan
- a bufferek eloszlásának elemzése — ahol az adatoldalak a memóriából, a helyi cache-ből vagy a lemezekről olvashatók
- áttekinthetőséget kaptunk
Hogy ne kelljen mindezt a naplóban "ásni", és azonnal láthassuk a "leggyengébb láncszemet" képen.
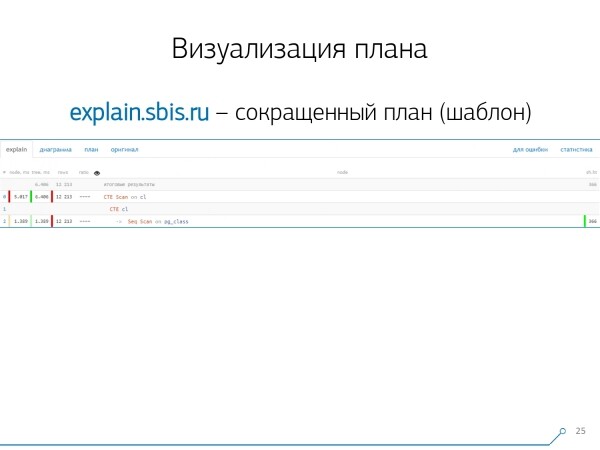
Körülbelül ilyen képet kaptunk — azonnali szintaxiskiemeléssel. De általában a fejlesztőink már nem a teljes tervvel dolgoznak, hanem ami rövidebb. Végül is minden számot már elemeztünk, és balra-jobbra elhajtottuk, a középen pedig csak az első sort hagytuk, hogy mi ez a csomópont: CTE Scan, CTE generálás vagy Seq Scan valamilyen táblázat alapján.
Ezt a rövidített nézetet mi tervsablonnak nevezzük.
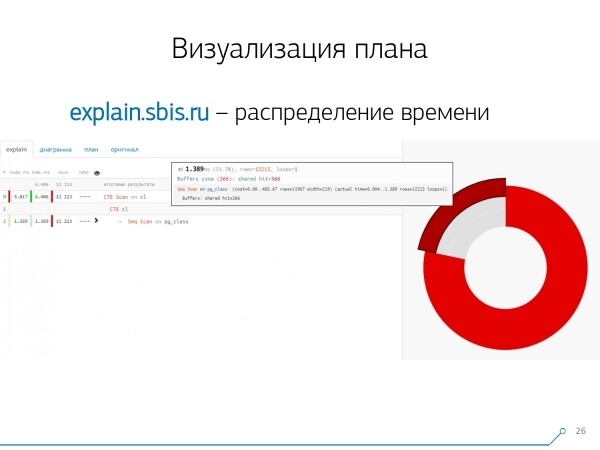
Mi lenne még kényelmes? Kényelmes lenne látni, hogy az összes idő hány százaléka megy egy adott csomópontra — és egyszerűen „ráragasztottuk” az oldalra tortadiagram.
Rámutatunk a csomópontra, és látjuk — kiderül, hogy a Seq Scan az összes időnek kevesebb mint egynegyedét vitte el, míg a maradék 3/4-et a CTE Scan. Katasztrófa! Ez egy kis megjegyzés a CTE Scan "sebességéről", ha aktívan használja őket a lekérdezéseiben. Nem éppen gyorsak — még a szokásos táblázatos szkennelésnél is lassúbbak.
De általában ezek a diagramok érdekesebbek, bonyolultabbak, amikor azonnal rákattintunk egy szegmensre, és látjuk például, hogy a teljes idő több mint felét egy Seq Scan "evett meg". Ráadásul belül még volt egy szűrő, és rengeteg rekord lett eldobva… Ezt a képet nyugodtan elküldhetjük a fejlesztőnek, és mondhatjuk: "Vaszja, itt nagyon rossz a helyzet! Nézd meg, valami nem stimmel!"
Természetesen nem úsztuk meg "buktatók" nélkül.
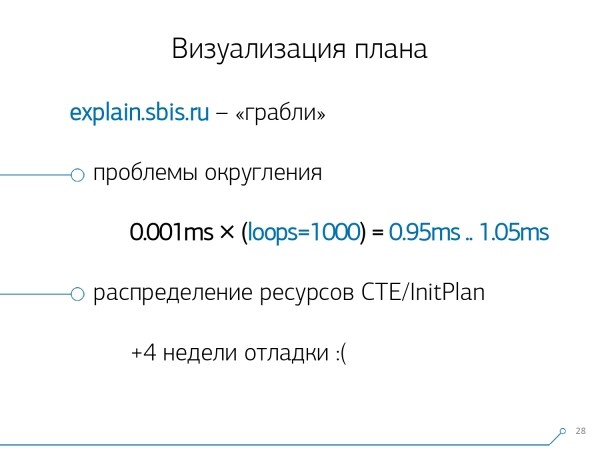
Az első probléma, amellyel szembesültünk, a kerekítés kérdése. Minden egyes csomópont ideje a tervben 1 μs pontossággal van megadva. Amikor a csomópont ciklusok száma meghaladja az 1000-et, akkor a PostgreSQL a „pontossággal” osztja el, így a fordított számítással az összesített időt „valahol 0,95 ms és 1,05 ms között” kapjuk. Amikor mikroszekundumokkal számolunk, akkor ez még kezelhető, de amikor már millimásodpercről van szó, akkor az erőforrások „kibogozásánál” a csomópontok között figyelembe kell venni ezt az információt.
A második, bonyolultabb dolog az erőforrások (azaz a bufferek) elosztása a dinamikus csomópontok között. Ez még négy hét extra munkát jelentett az első 2 hét prototípusához.
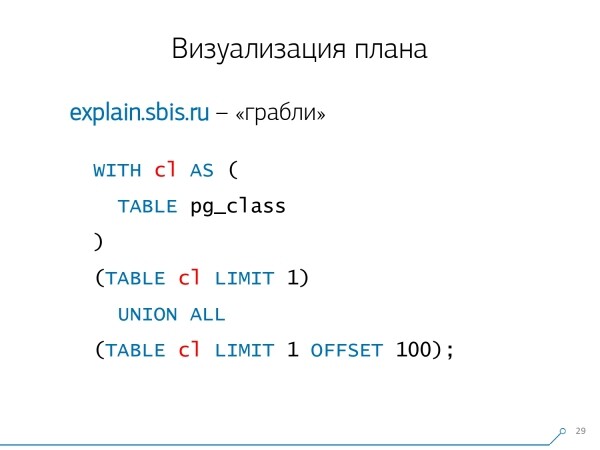
Ilyen problémát könnyen előidézhetünk - készítünk egy CTE-t, és abban valamit állítólag olvasunk. Valójában a PostgreSQL „okos” és nem fog közvetlenül ott olvasni. Aztán az első bejegyzést vesszük belőle, és ahhoz a CTE-ből a százegyedik bejegyzést.
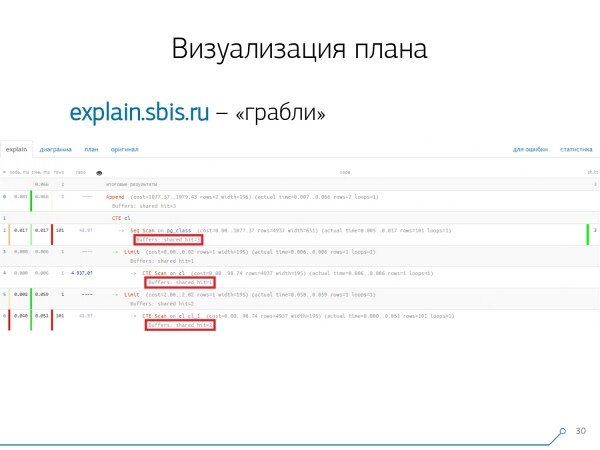
Megnézzük a tervet, és megértjük - furcsa, hogy 3 buffert (adatlapot) „fogyasztottunk” a Seq Scanban, egyet a CTE Scanban, és még kettőt a második CTE Scanban. Tehát ha mindent egyszerűen összeadunk, 6-ot kapunk, de a táblázatból csak 3-at olvastunk! A CTE Scan ugyanis semmit sem olvas a memóriából, hanem közvetlenül a folyamat memóriájával dolgozik. Tehát itt egyértelműen valami nem stimmel!
Valójában kiderült, hogy ezek a 3 adatlap, amelyeket a Seq Scan kérésére kértünk, először az 1. CTE Scan kérte, majd a 2. számú, és további 2-t olvastak. Tehát összesen 3 adatlapot olvastak, nem 6-ot.
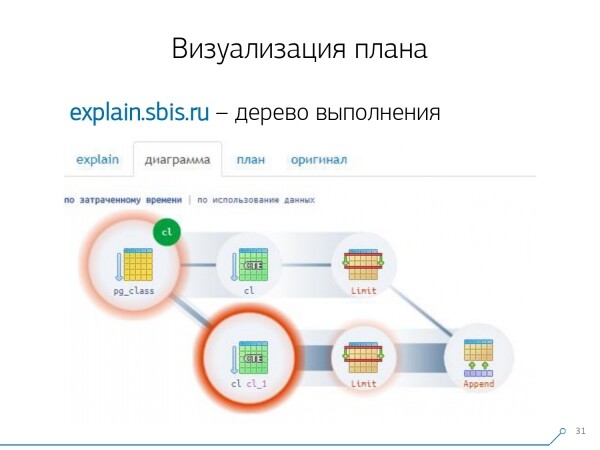
Ez a kép arra vezetett minket, hogy megértsük, hogy a terv végrehajtása már nem egy fa, hanem egy egyszerű irányítatlan gráf. Tehát körülbelül egy ilyen diagramunk lett, hogy megértsük, „honnan jött mi”. Itt létrehoztunk egy CTE-t a pg_class-ból, és kétszer kértük, és az időnk szinte teljes része azon a vonalon telt el, amikor másodszor kérdeztük. Egyértelmű, hogy a 101. bejegyzés elolvasása sokkal költségesebb, mint egyszerűen az elsőt a táblázatból.

Egy időre megkönnyebbültünk. Azt mondtuk: „Most, Neo, tudod a kung-fut! A tapasztalatunk most rajtad van a képernyőn. Most már használhatod.”
A naplók konszolidálása
A 1000 fejlesztőnk megkönnyebbült. De mi tudtuk, hogy csak száz „éles” szerverünk van, és ez a „másolás-beillesztés” a fejlesztők részéről egyáltalán nem volt kényelmes. Rájöttünk, hogy ezt magunknak kell összeraknunk.
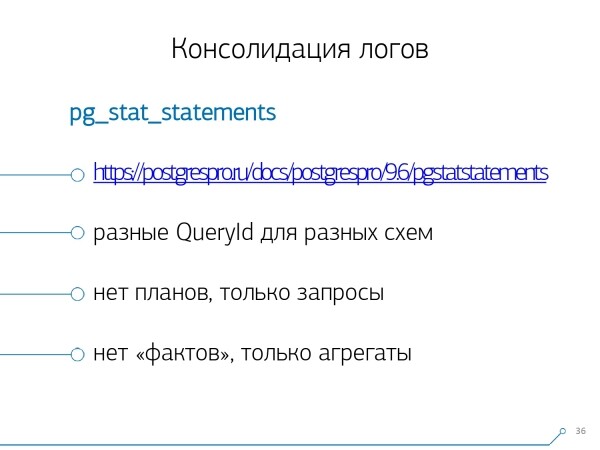
Valójában létezik egy beépített modul, amely képes statisztikákat gyűjteni, igaz, ezt a konfigurációban is aktiválni kell — ez a De ez minket nem elégedett meg.
Először is, ugyanazokhoz a lekérdezésekhez különböző azonosítókat rendel a különböző sémákon belül ugyanazon adatbázison. Különböző QueryId.Tehát, ha először futtatjuk a SET search_path = '01'; SELECT * FROM user LIMIT 1;, majd SET search_path = '02'; és ugyanazt a lekérdezést, akkor ennek a modulnak a statisztikáiban eltérő bejegyzések lesznek, és nem tudom összegyűjteni az általános statisztikákat éppen ennek a lekérdezési profilnak a szempontjából, figyelembe véve a sémákat.
A második dolog, ami megakadályozta minket a használatában — a tervek hiánya.Tehát tervek nincsenek, csupán maga a lekérdezés. Látjuk, mi okozta a lassulást, de nem értjük, miért. Ebben az esetben visszatérünk a gyorsan változó adathalmazon belüli problémához.
És az utolsó dolog — a „tények” hiánya.Tehát nem lehet hivatkozni egy adott lekérdezés végrehajtási példányára — az nincs, csak aggregált statisztika van. Ezzel akár lehet is dolgozni, de nagyon nehéz.
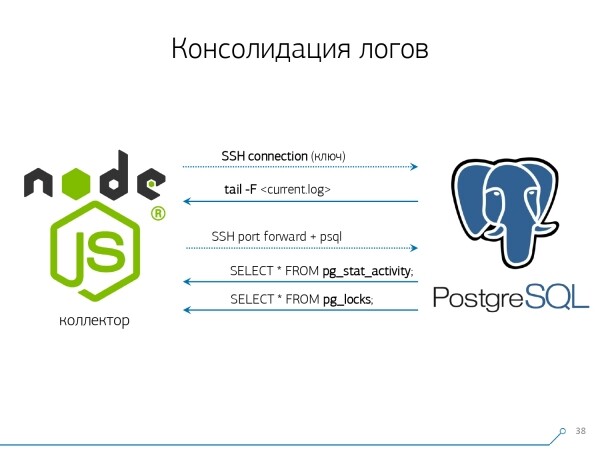
Ezért úgy döntöttünk, hogy harcolunk a „másolás-beillesztéssel”, és elkezdtük írni a gyűjtőt..
A gyűjtő SSH-n keresztül csatlakozik, biztonságos kapcsolatot létesít a szerverhez az adatbázissal a tanúsítvány segítségével, és tail -F „felcsatlakozik” a naplófájlra. Így ebben az ülésben megkapjuk a szerver által generált naplófájl teljes „tükrét”. A terhelés magán a szerveren minimális, mivel ott semmit sem elemezünk, egyszerűen csak tükrözzük a forgalmat.Mivel már elkezdtük a felület írását Node.js-ben, ezért a gyűjtőt is azon folytattuk. Ez a technológia bevált, mert a gyenge formázású szöveges adatokkal, mint amilyen a napló is, nagyon kényelmes JavaScriptet használni. A Node.js infrastruktúra pedig backend platformként lehetővé teszi a hálózati kapcsolatokkal és általában bármilyen adatfolyammal való egyszerű és kényelmes munkát.
Поскольку мы уже начали писать интерфейс на Node.js, то на нем же и коллектор продолжили писать. И эта технология себя оправдала, потому что для работы со слабоформатированными текстовыми данными, которыми и является лог, использовать JavaScript очень удобно. А сама инфраструктура Node.js в качестве backend-платформы позволяет легко и удобно работать с сетевыми соединениями, да и вообще с какими-то потоками данных.
Ezért "két kapcsolatot húzunk" meg: az első, hogy "hallgassuk" magát a naplót és azt átvigyük magunkhoz, a második pedig, hogy időszakosan kérdéseket tegyünk fel az adatbázisnak. "A naplóban megjelent, hogy blokkolva van a táblázat oid 123" - de ez a fejlesztőnek nem mond semmit, és jó lenne megkérdezni az adatbázist: "Mi is az OID = 123?" Így időről időre kérdéseket teszünk fel az adatbázisnak arról, amiről még nem tudunk.
"Csak egy dolgot nem vettél figyelembe, van egy fehér elefánt típusú méh!.." Akkor kezdtük el fejleszteni ezt a rendszert, amikor tíz szerver monitorozására vágytunk. A legkritikusabbak szerinti fogalmaink szerint, amelyeken problémák adódtak, amelyekkel nehéz volt kezelni. De az első negyedévben már százat kaptunk megfigyelésre – mert a rendszer "bejött", mindenki akarta, mindenkinek kényelmes volt.
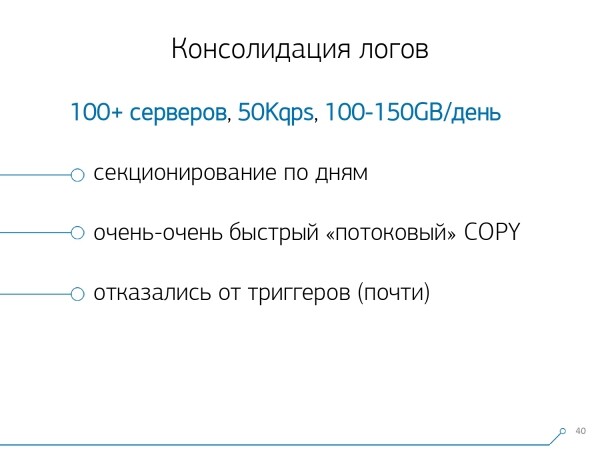
Ezt mind össze kell gyűjteni, az adatok áramlása nagy és aktív. Tulajdonképpen, amit monitorozunk, amit tudunk kezelni – azt használjuk. Adatbázisként is PostgreSQL-t használunk. Nincs is gyorsabb módja annak, hogy "töltsük" bele az adatokat, mint az operátor COPY jelenleg nincs.
De egyszerűen "önteni" az adatokat – nem teljesen a mi technológiánk. Mert ha van száz szervered, ahol körülbelül 50k kérést generálsz másodpercenként, akkor ez napi 100-150GB naplót termel. Ezért óvatosan kellett "faragnunk" az adatbázison.
Először is, készítettünk napi szekcionálást, mert alapvetően senkit nem érdekel a napok közötti korreláció. Mindegy, hogy mi volt tegnap, ha ma éjjel új verziót telepítettél – és már valami új statisztika van.
Másodszor, megtanultuk (kénytelenek voltunk) nagyon-nagyon gyorsan írni a COPY. Tehát nem csak COPY, mert gyorsabb, mint a INSERT, hanem még gyorsabb.
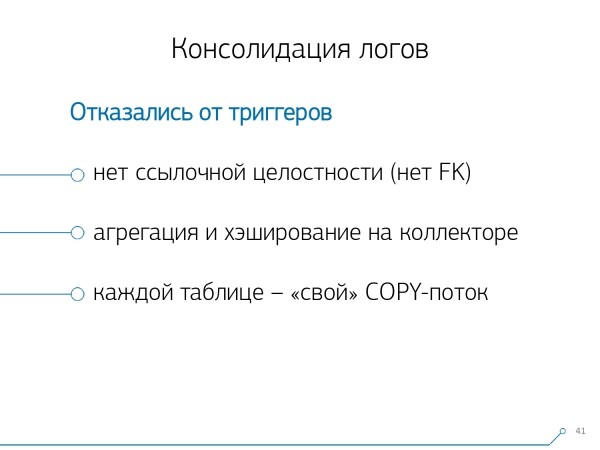
A harmadik szempont – le kellett mondanunk a triggerről, következésképpen a külső kulcsokról. Tehát nincs senki hivatkozási integritásunk. Mert ha van egy táblázatod, amelyen van egy pár FK, és te azt mondod az adatbázis struktúrájában, hogy "itt egy naplóból származó bejegyzés FK-val hivatkozik, például egy bejegyzéscsoportra", akkor amikor beszúrod, a PostgreSQL-nek nem marad más választása, mint hogy tisztességesen végrehajtsa SELECT 1 FROM master_fk1_table WHERE ... azzal az azonosítóval, amelyet megpróbálsz beszúrni – csupán azért, hogy ellenőrizze, hogy ez a bejegyzés ott van-e, hogy ne "rombold el" a beszúrásoddal ezt a külső kulcsot.
Egy rekord és annak indexei helyett több rekordot kapunk a céltáblázatba, valamint a hivatkozott táblázatokból való olvasást is. Erre viszont nincs szükségünk — a feladatunk, hogy minél több adatot minél gyorsabban, a lehető legkisebb terheléssel rögzítsünk. Tehát FK — el a fenébe!
A következő pont az aggregáció és a hash-elés. Eredetileg ezeket az adatbázisban valósítottuk meg — végül is kényelmes, amikor egy rekord érkezik, azonnal készíthetünk valamit egy táblázatban. „plusz egy” közvetlenül a triggerben.. Jól van, kényelmes, de a hátránya az, hogy amikor egy rekordot beilleszt, kénytelen vagy egy másik táblázatból is olvasni és írni. Ráadásul nemcsak olvasni és írni kell, hanem ezt minden alkalommal meg kell tenni.
Most képzelje el, hogy van egy táblázata, amelyben csak a konkrét hoszton végrehajtott kérések számát számolja: +1, +1, +1, ..., +1. Erre viszont alapvetően nincs szüksége — mindezt lehet a memóriában összesíteni a gyűjtőn és egyszerre küldeni az adatbázisba. +10.
Igen, valamilyen hiba esetén a logikai integritás „összeomolhat”, de ez gyakorlatilag irreális eset — mivel normális szervere van, a vezérlőn van akkumulátor, van tranzakciós napló, fájlrendszer napló... Összességében, nem éri meg. Nem éri meg azt a teljesítménycsökkenést, amelyet a trigger-ektől/FK-tól kap, és azt a költséget, amelyet ez okoz.
Ugyanez vonatkozik a hash-elésre is. Jön egy kérés, amelyből kiszámít egy azonosítót az adatbázisban, beírja a tárolóba, és mindenkinek azt mondja. Minden rendben van, amíg a bejegyzés pillanatában nem érkezik egy második személy, aki megpróbálja ugyanazt beírni — és önnél blokk keletkezik, ami már rossz. Ezért, ha a kliensen ki tudja vinni valamilyen ID generálását (az adatbázis vonatkozásában), érdemes ezt megtenni.
Tökéletesen megfelelt az MD5 használata a szövegből — kérés, terv, sablon,... Ezt a gyűjtő oldalán számoljuk ki, és már kész az ID, amit az adatbázisba „öntünk”. Az MD5 hossza és a napi szekciózás lehetővé teszi, hogy ne aggódjon a lehetséges ütközések miatt.
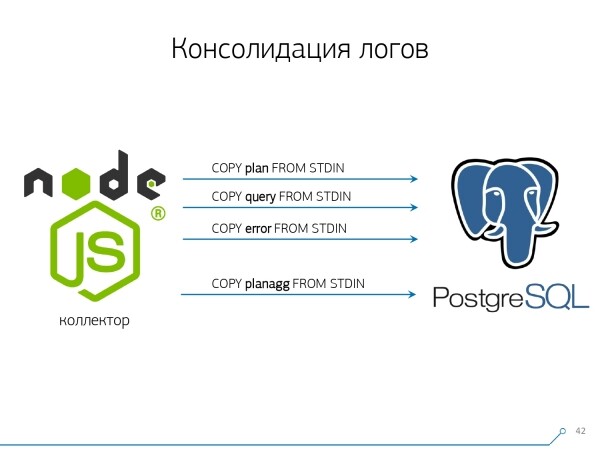
De ahhoz, hogy mindezt gyorsan rögzíthessük, módosítanunk kellett magát a felvételi eljárást.
Hogyan írják az adatokat általában? Van egy adathalmazon, amelyet több táblázatra bontunk, majd COPY — először az elsőbe, aztán a másodikba, a harmadikba... Kényelmetlen, mert úgy tűnik, egy adatfolyamot három egymás utáni lépésben írunk be. Kellemetlen. Lehet ezt gyorsabban csinálni? Igen!
Ehhez mindössze annyira van szükség, hogy ezeket a folyamokat párhuzamosan rendezzük egymás mellett. Így különböző folyamokban futnak a hibák, kérdések, sablonok, zárolások… — és mindezt párhuzamosan írjuk. Ehhez elég folyamatosan nyitva tartani egy COPY-csatornát minden egyes cél táblázathoz..
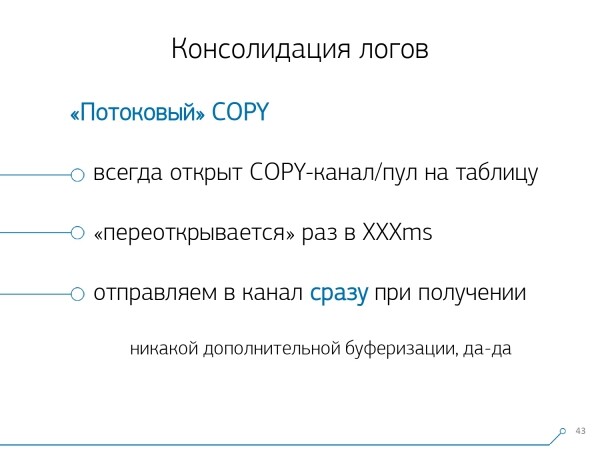
Tehát a gyűjtőnek mindig van egy streamje,, amelybe be tudom írni a szükséges adatokat. De ahhoz, hogy az adatbázis észlelje ezeket az adatokat, és senki ne akadhasson meg egy zárolás miatt, várva a beírásra, a COPY-t bizonyos időközönként meg kell szakítani.. Számunkra a leghatékonyabb időszak körülbelül 100 ms volt — bezárjuk, majd azonnal újra kinyitjuk ugyanarra a táblázatra. Ha egy folyam nem elegendő valamilyen csúcsidőknél, akkor egy adott határig pollingot végzünk.
Továbbá megállapítottuk, hogy ilyen terhelési profil mellett bármilyen aggregáció, amikor a bejegyzéseket csomagokba gyűjtjük, ártalmas. A klasszikus ártalom — ez a INSERT ... VALUES és így tovább 1000 bejegyzés. Mert ebben a pillanatban csúcsértékük lesz a tárolón, és mindenki, aki próbál valamit felírni a lemezre, várni fog.
Akkor, hogy megszabaduljunk az ilyen anomáliáktól, egyszerűen ne aggregáljunk semmit, ne buffereljünk semmilyen módon.. És ha a lemezre való buffering mégis bekövetkezik (szerencsére a Node.js Stream API lehetővé teszi ennek észlelését) — halassza el ezt a kapcsolatot. Amikor megkapsz egy eseményt, hogy újra szabad — írd be a felhalmozódott sorból. És amíg ez foglalt — vedd a következő, szabad lehetőséget a poolból, és írd be oda.
Az ilyen adatírási megközelítés bevezetése előtt körülbelül 4K írószámunk volt, és ezzel a módszerrel négyszeresére csökkentettük a terhelést. Most még 6-szorosára nőtt az új megfigyelt adatbázisok révén — 100 MB/s-ig. Most az elmúlt 3 hónapra vonatkozó naplókat körülbelül 10–15 TB terjedelemben tároljuk, remélve, hogy három hónap alatt bármely probléma bármely fejlesztő számára megoldható.
Érthetjük a problémákat
De csak ezeket az adatokat összegyűjteni — jó, hasznos, releváns, de kevés — meg kell őket érteni. Mert ezek milliónyi különböző tervet jelentenek naponta.
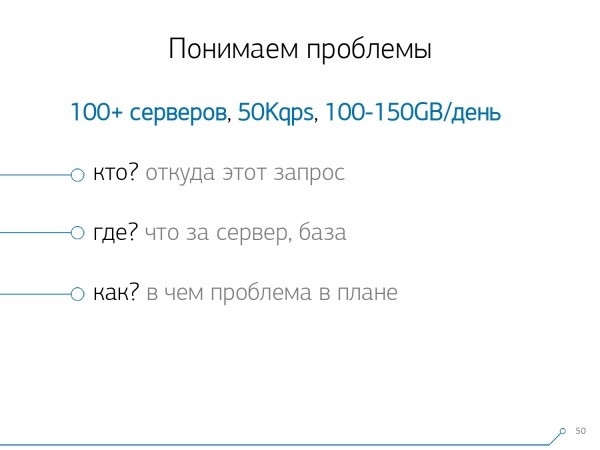
De a milliók kezelhetetlenek, először is „kisebbé” kell tenni őket. És elsősorban el kell dönteni, hogyan fogják ezt a „kisebb” részt megszervezni.
Három kulcsfontosságú szempontot emeltünk ki:
- ki ezt a kérést küldte
Tehát melyik alkalmazásból érkezett: web-interfész, backend, fizetési rendszer vagy valami más. - ahol ez történt
Melyik konkrét szerveren. Mert ha egy alkalmazás mögött több szerver áll, és hirtelen az egyik „lefagyott” (mert a „lemez megromlott”, a „memória rózsaszín lett”, vagy valami más baj), akkor konkrétan a szerverhez kell címeznünk. - hogyan pontosan melyik tervben jelentkezett a probléma
Ahhoz, hogy megértsük, „ki” küldte el a kérésünket, a szokásos eszközünket használjuk — egy session változó beállítását: SET application_name = '{bl-host}:{bl-method}'; — megadjuk a business logic host nevét, ahonnan a kérés érkezik, és a metódus vagy alkalmazás nevét, amelyik elindította azt.
Miután átkonfiguráltuk a kérés „gazdáját”, azt ki kell írni a naplóba — ehhez beállítjuk a változót log_line_prefix = ' %m [%p:%v] [%d] %r %a'. Akinek ez érdekes, az megnézheti , mit is jelent mindez. Így a naplóban ezt látjuk:
- idő
- a folyamat- és tranzakcióazonosítók
- a database neve
- az IP cím, aki ezt a kérést küldte
- és a metódus neve
Továbbá rájöttünk, hogy nem nagyon érdekes egy kérdés korrelációját nézni különböző szerverek között. Ritkán fordul elő olyan helyzet, amikor egy alkalmazás ugyanazon módon „hibázik” itt és ott. De még ha ugyanaz is — nézd meg bármelyik szervert.
Szóval, az elemzéshez elegendőnek bizonyult a „egy szerver — egy nap” egyszerűsített formája.
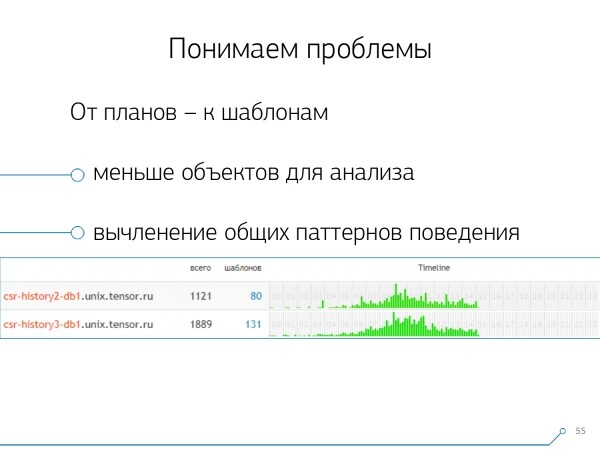
Az első analitikai dimenzió — ez a bizonyos „sablon” — a terv rövidített bemutatási formája, megtisztítva minden numerikus mutatótól. A második dimenzió — az alkalmazás vagy metódus, a harmadik pedig az a konkrét tervcsomópont, amely problémát okozott számunkra.
Amikor átváltottunk a konkrét példányokról a sablonokra, azonnal két előnyt kaptunk:
- többszörös csökkentése az elemzendő objektumok számának
Most már nem ezer kérés vagy terv alapján kell megoldanunk a problémát, hanem néhány tucat sablon alapján. - idővonal
Tehát, összefoglalva a "tényeket" valamilyen vágat keretében, meg lehet jeleníteni a nap során való megjelenésüket. Itt megértheted, hogy ha van egy minta, amely például óránként következik be, de annak naponta kellene történnie, érdemes elgondolkodni, mi történt rosszul – ki és miért hívta elő, lehet, hogy itt nem is lenne szabad lennie. Ez egy újabb nem numerikus, tisztán vizuális elemzési módszer.
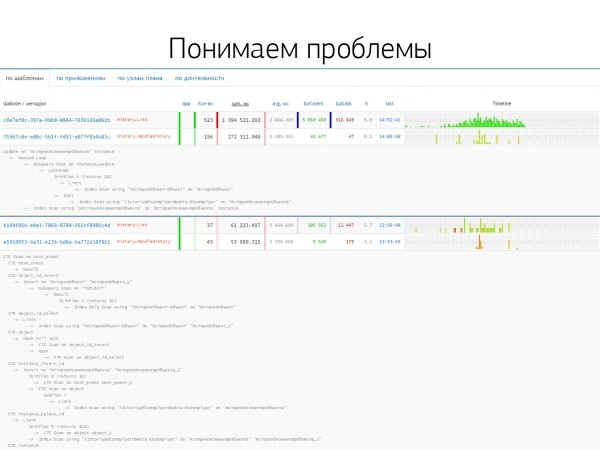
A többi módszer azokban a mutatókban alapul, amelyeket a tervből kinyerünk: hányszor következett be egy ilyen minta, összesített és átlagos idő, mennyi adatot olvastunk le a lemezről, és mennyit a memóriából…
Mert például megérkezel a hoszt analitikai oldalára, és látod – valami túl sokat kezdett el olvasni a lemezen. A lemez a szerveren nem bírja – ki is olvas róla?
Így bármely oszlop szerint sorba tudod állítani, és eldöntheted, mivel foglalkozol most – a CPU vagy a lemez terhelésével, vagy a kérések összesített számával… Sorba állítottad, megnézted a "legjobban teljesítőket", megjavítottad – kiadtad az új verziót az alkalmazásból.
Azonnal láthatod, hogy különböző alkalmazások használják ugyanazt a mintát egy ilyen típusú kéréshez SELECT * FROM users WHERE login = 'Vasya'. Frontend, backend, feldolgozás… És elgondolkodsz, miért olvasná a feldolgozás a felhasználót, ha az nem lép kölcsönhatásba vele.
A fordított módja az, hogy az alkalmazás azonnal láthatóvá teszi, mit csinál. Például a frontend – ez, ez, meg ez, és még ez is óránként (a timeline segít is ebben). És azonnal felmerül a kérdés – úgy tűnik, nem a frontend dolga óránként csinálni valamit…
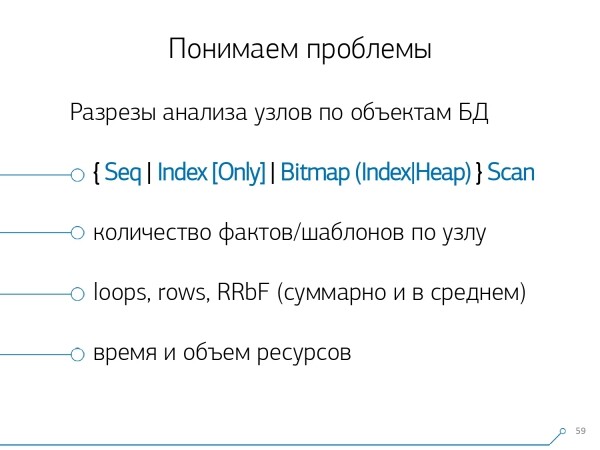
Egy idő után rájöttünk, hogy hiányzik a csoportosított statisztika a terv csomópontjainak vágatában. Csak azokat a csomópontokat megragadtuk a tervekben, amelyek valamit csinálnak a táblák adataival (olvasnak/írnak az index szerint vagy sem). A lényegében a korábbi képhez egyetlen aspektus adódik – hány rekordot hozott nekünk ez a csomópont, és hányat dobott el (Rows Removed by Filter).
Nincs megfelelő indexed a táblán, kérdést intézel hozzá, ami elkerüli az indexet, és Seq Scan-ba esik… minden rekordot, kivéve egyet, kiszűrtél. Miért van szükséged 100M kiszűrt rekordra egy nap alatt, nem lenne jobb egy indexet létrehozni?
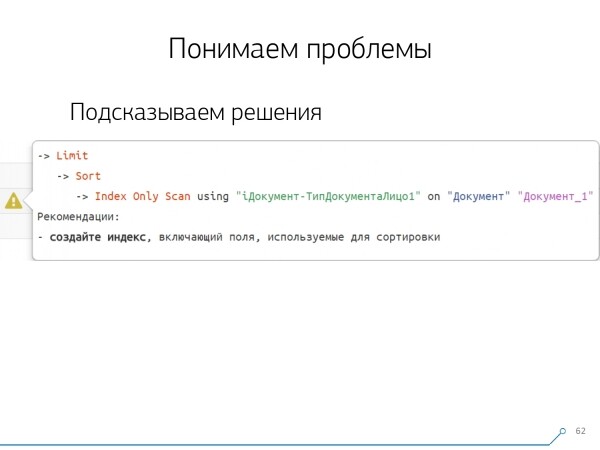
Miközben elemeztük a csomópontok terveit, rájöttünk, hogy léteznek tipikus struktúrák a tervekben, amelyek rendkívül gyanúsan néznek ki. Jó lenne a fejlesztőnek azt javasolni: „Barátom, itt először az index szerint olvasol, majd rendezol, aztán levágsz” — általában itt egy bejegyzés található.
Mindenki, aki ilyen mintázatú lekérdezéseket írt, biztosan találkozott már ezzel: „Add meg nekem az utolsó megrendelést Vasztól, annak dátumát.” És ha nincs dátum szerint indexed, vagy a használt indexben nincs dátum, akkor pontosan ezekre a „sáros utakra” fogsz lépni.
De tudjuk, hogy ezek a „sáros utak” — miért ne lehetne észlelni a fejlesztőnek már az elején, mit kellene tennie. Ennek megfelelően, most, hogy megnyitja a tervet, a fejlesztőnk azonnal egy szép képet lát a javaslatokkal, ahol azonnal elmondják neki: „Itt és itt problémáid vannak, és így és így oldhatók meg.”
Ennek eredményeként az a tapasztalat, amely szükséges volt a problémák megoldásához az elején, és most, drámaian csökkent. Egy ilyen eszközt sikerült kifejlesztenünk.
Forrás: habr.com
