

Helló, Habr! Bemutatom nektek a cikk hiteles fordítását .
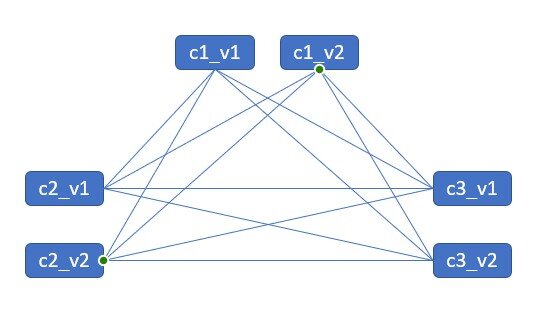
Abban az időben, amikor az IT világ fokozatosan átáll a mikroszolgáltatásokra és olyan eszközökre, mint a Kubernetes, egyetlen probléma válik egyre nyilvánvalóbbá. Ez a probléma pedig a mikroszolgáltatások verzióiban. Az IT közösség azonban úgy véli, hogy a mai helyzet jelentősen jobb, mint a előző generációs technológiáé. Mindazonáltal a mikroszolgáltatások verzióinak kezelése meglehetősen bonyolult probléma. Ezt bizonyítják olyan cikkek is, mint például .
Ha még mindig nem érted ezt a szöveget, engedd meg, hogy elmagyarázzam. Tegyük fel, hogy a terméked 10 mikroszolgáltatásból áll. Most tegyük fel, hogy mindegyik mikroszolgáltatás esetében megjelenik 1 új verzió. Csak 1 verzió — remélem, mindannyian egyetérthetünk abban, hogy ez egy elég triviális és jelentéktelen tény. Most azonban nézzük meg még egyszer a termékünket. Mivel minden egyes komponens esetében egy új verzió van, most már 2^10 — vagyis 1024 permutációnk van arra, ahogyan a termékünket összerakhatjuk.
Ha még mindig van félreértés, hagyd, hogy elmagyarázzam a matematikát. Tehát, van 10 mikroszolgáltatásunk, mindegyik kap egy frissítést. Ez azt jelenti, hogy 2 lehetséges verzió van minden mikroszolgáltatásnál (vagy a régi, vagy az új). Most, a termék minden komponenséhez használhatjuk bármelyik verziót. Matematikailag ez ugyanaz, mintha lenne egy 10 számjegyből álló bináris számunk. Például, mondjuk, hogy az 1 az új verziót, míg a 0 a régi verziót jelenti - akkor az egyik lehetséges permutációt 1001000000-ként lehet ábrázolni - ahol az 1-es és 4-es komponens frissítve lett, míg minden más nem. A matematikából tudjuk, hogy a 10 számjegyből álló bináris szám 2^10 vagyis 1024 értéket vehet fel. Ez azt jelenti, hogy megerősítettük a szám nagyságrendjét, amivel foglalkozunk.
Folytassuk a gondolatmenetet - mi történik, ha 100 mikroszolgáltatásunk van, és mindegyiknek 10 lehetséges verziója? Az egész helyzet nagyon kellemetlenné válik - most már 10^100 permutációnk van - ami egy óriási szám. Mindazonáltal én inkább így nevezném el ezt a helyzetet, mert most nem bújunk olyan szavak mögé, mint a «kubernetes», hanem szembenézünk a problémával, ahogy van.
Miért lenyűgöz ez a probléma annyira? Részben azért, mert korábban az NLP és az AI világában dolgozva sokat beszéltünk a kombinatorikai robbanás problémájáról körülbelül 5-6 évvel ezelőtt. Csak a verziók helyett külön szavaink voltak, termékek helyett pedig mondataink és bekezdéseink. És bár az NLP és az AI problémái nagymértékben megoldatlanok maradtak, el kell ismernünk, hogy az elmúlt néhány évben jelentős előrelépést értünk el. (véleményem szerint a fejlődés nagyobb lehetett volna,óha az iparág emberei valamivel kevesebb figyelmet fordítanak a gépi tanulásra, és egy kicsit több más technikákra — de ez már off-topic).
Visszatérve a DevOps és a mikroszolgáltatások világába. Egy hatalmas probléma áll előttünk, mely egy elefántként rejtőzik a Kincstárban — hiszen amit gyakran hallok — „csak vedd a kubernetes-t és a helm-et, és minden rendben lesz!” De nem, semmi sem lesz rendben, ha minden a régiben marad. Sőt, ennek a problémának az analitikai megoldása elfogadhatatlan a bonyolultsága miatt. Az NLP-hez hasonlóan először a probléma szűkítésével kell megközelítenünk ezt a problémát — ebben az esetben a régi permutációk kizárásával.
Ami segíthet, az az, hogy tavaly írtam Fontos megjegyezni, hogy egy jól kidolgozott CI/CD folyamat nagyon segít a variációk csökkentésében. Azonban a CI/CD jelenlegi állapota nem elég jó a permutációs problémák megoldásához további eszközök, figyelembe vétel és nyomon követés nélkül.
Ami szükséges — az egy kísérleti rendszer az integrációs szakaszban, ahol képesek lennénk meghatározni a kockázati tényezőt minden összetevőre vonatkozóan, valamint rendelkezni egy automatizált folyamat frissítésére és tesztelésére különböző összetevők esetében operátor beavatkozása nélkül — hogy lássuk, mi működik, és mi nem.
Egy ilyen kísérleti rendszer a következőképpen nézhetne ki:
- A fejlesztők teszteket írnak (ez egy kritikus lépés — mert különben nincs értékelési kritériumunk — ez olyan, mint az adatok megjelölése a gépi tanulásban).
- Minden összetevő (projekt) saját CI rendszerét kapja — ez a folyamat jelenleg jól kidolgozott, és a CI rendszer létrehozása egyetlen összetevő számára nagyban megoldott.
- Az „Okos integrációs rendszer” összegyűjti a különböző CI rendszerek eredményeit és a projektkomponenseket egy végtermékké állítja össze, tesztelést indít el, és végül meghatározza a leggyorsabb utat a kívánt termékfunkcionalitás eléréséhez, figyelembe véve a meglévő komponenseket és a kockázati tényezőket. Ha a frissítés nem lehetséges, a rendszer értesíti a fejlesztőket a rendelkezésre álló komponensekről és arról, hogy melyiken lép fel hiba. Ismétlem, a tesztelő rendszer kulcsfontosságú itt, mivel az integrációs rendszer a teszteket használja a mérési kritériumként.
- A CD rendszer, amely ezután adatokat kap az „Okos integrációs rendszerből” és közvetlenül végrehajtja a frissítést. Ez a fázis zárja le a ciklust.
Összefoglalva, számomra az egyik legnagyobb probléma jelenleg az, hogy hiányzik egy olyan „Okos integrációs rendszer”, amely összekötné a különböző komponenseket a termékké, és így lehetővé tenné, hogy nyomon követhessük, hogyan áll össze a termék egésze. Érdekelne a közösség véleménye erről (spoilerek — jelenleg egy projekten dolgozom , amely lehet az ilyen okos integrációs rendszer).
Egy utolsó dolog, amit meg szeretnék említeni: számomra a monolitikus rendszer nem elfogadható bármely közepes méretű projekt számára. Nagy szkepticizmust váltanak ki bennem a monolitra való visszatérés által a megvalósítási idő és a fejlesztési minőség felgyorsítására tett kísérletek. Először is, a monolitikus rendszer hasonló komponenskezelési problémával rendelkezik — a különböző könyvtárak között, amelyekből áll, azonban mindez nem annyira észlelhető, és elsősorban abban nyilvánul meg, hogy a fejlesztők mennyi időt töltenek el. A monolitus probléma következménye a kód módosításának tényleges lehetetlensége — és rendkívül lassú fejlesztési sebesség.
A mikroszolgáltatások javítják a helyzetet, de a mikroszolgáltatás-architektúra az integrációs fázisban szembesül a kombinatorikusan robbanás problémájával. Igen, lényegében ugyanazt a problémát toltuk át — a fejlesztési fázisból az integráció fázisába. Azonban véleményem szerint a mikroszolgáltatások megközelítése mégis jobb eredményekhez vezet, és a csapatok gyorsabban érnek el eredményeket (valószínűleg főként a fejlesztési egységek méretének csökkentése miatt — vagy batch size). Azonban a monolitikus architektúráról a mikroszervizekre való áttérés eddig nem hozott elegendő javulást a folyamatban — a mikroszervizek verzióinak kombinatorikus robbanása hatalmas probléma, és nagy potenciál rejlik a helyzet javításában, ahogy ezt megoldjuk.
Forrás: habr.com
