

Ebben a cikkben egy olyan helyzetről beszélek, amely nemrégiben történt egy VPS felhőszerverünkkel, és amely több órára megzavart engem. Körülbelül 15 éve foglalkozom Linux szerverek konfigurálásával és hibakeresésével, de ez az eset teljesen idegen a gyakorlatomtól — néhány téves feltételezést tettem, és kissé kétségbe estem, mielőtt sikerült helyesen azonosítanom a probléma okát és megoldanom azt.
Előszó
Egy közepes méretű felhőt üzemeltetünk, amelyet az alábbi konfigurációval rendelkező tipikus szerverekre építünk — 32 mag, 256 GB RAM és PCI-E Intel P4500 NVMe tároló 4TB méretben. Nagyon tetszik ez a konfiguráció, mivel lehetővé teszi, hogy ne aggódjunk az IO hiánya miatt, biztosítva a megfelelő korlátozást a VM példányok szintjén. Mivel az NVMe Intel lenyűgöző teljesítménnyel rendelkezik, egyidejűleg biztosítani tudjuk mind a gépek számára a teljes IOPS-t, mind a tároló biztonsági mentését a nullás IOWAIT-tel rendelkező biztonsági mentési szervere.
A régi vágásúak közé tartozunk, akik nem használják a hiper-konvergens SDN-t és egyéb stílusos, divatos, ifjúsági dolgokat a VM kötetek tárolására, hiszen azt valljuk, hogy minél egyszerűbb a rendszer, annál könnyebb hibakeresni, amikor a "fő guru a hegyekben van". Ennek eredményeként a VM köteteket QCOW2 formátumban tároljuk XFS vagy EXT4 fájlrendszeren, amely az LVM2 fölött van telepítve.
A QCOW2 használatát egy termék is indokolja, amelyet az orchestrationra használunk — Apache CloudStack.
A biztonsági mentés elvégzéséhez teljes kötetképet készítünk, mint az LVM2 pillanatkép (igen, tudjuk, hogy az LVM2 pillanatképek lassúak, de az Intel P4500 itt is segít nekünk). lvmcreate -s .. és azzal, hogy dd a biztonsági mentést egy távoli ZFS tárolóval rendelkező szerverre küldjük. Itt azért kicsit haladóbbak vagyunk — végül is a ZFS képes az adatokat tömörített formában tárolni, és gyorsan helyreállíthatjuk őket DD segítségével, vagy különálló VM köteteket kaphatunk meg a mount -o loop ....
Persze, lehet, hogy nem teljes LVM2 kötetképet csinálunk, hanem a fájlrendszert
ROQCOW2-képek másolása közben találkoztunk azzal, hogy az XFS teljesítménye romlott, és ez nem azonnal, hanem kiszámíthatatlanul történt. Nagyon nem szeretjük, amikor a hypervisor hostok váratlanul "beragadnak" a hétvégén, éjszaka vagy ünnepnapokon az olyan hibák miatt, amelyek mikor következnek be, nem világos. Ezért az XFS-nél nem használunk pillanatfelvétel-montírozást aROtérfogatok kinyerésére, hanem egyszerűen az egész LVM2 kötetet másoljuk.
A biztonsági mentés sebességét a biztonsági mentési szerver teljesítménye határozza meg, amely körülbelül 600-800 MB/s a tömörítetlen adatok esetében, a következő korlátozó tényező a 10Gbit/s-os csatorna, amellyel a biztonsági mentési szervert a klaszterhez csatlakoztatják.
Ezen felül egy biztonsági mentési szerverre egyszerre 8 szerverek hypervisor tölt le biztonsági másolatokat. Így a biztonsági mentési szerver lemezes és hálózati alrendszerei, amelyek lassabbak, nem terhelik túl a hypervisor hostok lemezes alrendszereit, mivel egyszerűen nem képesek feldolgozni például a 8 GB/s-t, amit a hypervisor hostok szabadon tudnak szolgáltatni.
A fenti másolási folyamat nagyon fontos a további fejtegetéshez, beleértve a részleteket is — Intel P4500 gyors tároló használata, NFS alkalmazása és valószínűleg a ZFS alkalmazása.
Biztonsági mentési történet
Minden hypervisor csomóponton van egy kis SWAP partíció, amelynek mérete 8 GB, és a hypervisor csomópontot egy DD referencia képből "hozzuk létre". A szerverek rendszertartalmához 2xSATA SSD RAID1 vagy 2xSAS HDD RAID1-t használunk LSI vagy HP hardveres vezérlőn. Összességében számunkra teljesen mindegy, mi van belül, mivel a rendszertartalom "majdnem readonly" módba működik, kivéve a SWAP-ot. Mivel a szerverünkön nagyon sok RAM van, és 30-40%-a szabad, ezért nem foglalkozunk a SWAP-pal.
A biztonsági másolat készítési folyamata. Ennek a feladatnak a megjelenése körülbelül így fest:
#!/bin/bash

mkdir -p /mnt/backups/volumes

DIR=/mnt/images-snap
VOL=images/volume
DATE=$(date "+%d")
HOSTNAME=$(hostname)

lvcreate -s -n $VOL-snap -l100%FREE $VOL
ionice -c3 dd iflag=direct if=/dev/$VOL-snap bs=1M of=/mnt/backups/volumes/$HOSTNAME-$DATE.raw
lvremove -f $VOL-snap
Kérjük, vegye figyelembe ionice -c3, a valóságban ez NVMe eszközök számára teljesen haszontalan, mivel az IO ütemező úgy van beállítva, mint:
cat /sys/block/nvme0n1/queue/scheduler
[none]
Mindazonáltal számos örökségi csomópontunk van szokványos SSD RAID-ekkel, számukra ez releváns, így AS IS. Összességében ez egy érdekes kód részlet, amely magyarázza az ionice fölöslegességét ezt a konfigurációt tekintve.
Figyeljen a címkére iflag=direct a DD. A direkt IO-t használjuk a puffermemórián keresztül, hogy elkerüljük a felesleges I/O puffercserét olvasáskor. Azonban, oflag=direct nem ezt tesszük, mivel teljesítményproblémákkal találkoztunk a ZFS használata során.
Ezt a módszert sikeresen alkalmazzuk néhány éve probléma nélkül.
És itt kezdődött… Felfedeztük, hogy az egyik csomóponton leállt a mentési folyamat, míg az előző hatalmas IOWAIT mellett 50%-os terheléssel futott. Mikor próbáltuk kideríteni, miért nem történik mentés, egy jelenséggel szembesültünk:
Volume group "images" nem találhatóElkezdett gondolkodni a "véget ért az Intel P4500", azonban mielőtt leállítottuk volna a szervert az adapter cseréje érdekében, mégis fontos volt a mentés elvégzése. Helyre állítottuk az LVM2-t a LVM2 biztonsági mentéséből visszaállító metadaták segítségével:
vgcfgrestore imagesElindítottuk a mentést, és a következő látvány fogadott minket:
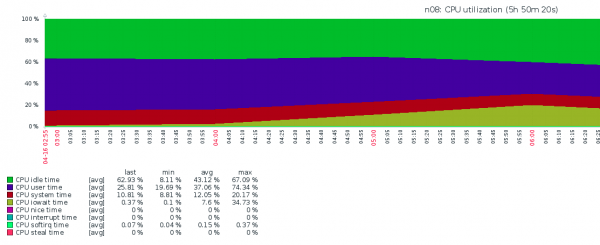
Ismét nagyon elkeseredtünk – világossá vált, hogy így nem lehet folytatni, mert minden VPS szenvedni fog, ami azt jelenti, hogy mi is szenvedni fogunk. Hogy mi történt, az teljesen érthetetlen volt – iostat siralmas IOPS-okat és rendkívüli IOWAIT-et mutatott. Az egyetlen ötletünk az volt, hogy "cseréljük le az NVMe-t", de időben jött a megvilágosodás.
A helyzet lépésről lépésre
Történeti napló. Néhány nappal korábban ezen a szerveren szükség volt egy nagy VPS létrehozására 128 GB RAM-mal. A memória látszólag elegendő volt, de biztos ami biztos, még 32 GB-ot kijelöltünk a swap terület számára. A VPS-t létrehoztuk, sikeresen megoldotta a feladatát, és az incidenst elfelejtettük, míg a SWAP terület megmaradt.
A konfiguráció sajátosságai. Az összes felhőszerveren az vm.swappiness paramétert az alapértelmezett értékre állítottuk. 60. A SWAP SAS HDD RAID1-en lett létrehozva.
Mi történt (a szerkesztőség véleménye szerint). A mentés során DD sok írási adatot generált, amelyeket a RAM puffereibe helyezett, mielőtt az NFS-be írták volna. A rendszer magja, követve a swappinesspolitikát, sok VPS memóriaoldalt áthelyezett a swap területre, amely a lassú HDD RAID1 kötetben helyezkedett el. Ez rendkívüli IOWAIT növekedéshez vezetett, de nem az NVMe I/O miatt, hanem a HDD RAID1 I/O-ja miatt.
Hogyan oldották meg a problémát. A 32GB-os swap területet kikapcsoltuk. Ennek a 16 órát vett igénybe, arról, hogy hogyan és miért így lassan kapcsolták ki a SWAP-ot, külön olvashat. A paramétereket megváltoztattuk swappiness azonos értékre 5 az egész felhőben.
Hogyan is történhetett ez megElőször is, ha a SWAP SSD RAID-en vagy NVMe eszközön lett volna, másodszor, ha nem lett volna NVMe eszköz, hanem egy lassabb eszköz, amely nem tudta volna kiadni ezt a mennyiségű adatot - irónia, hogy a probléma abból adódott, hogy az NVMe túl gyors.
Ezután minden úgy működött, mint korábban - zéró IOWAIT-tal.
Forrás: habr.com
