

Bevezetés
Régóta áll előttem a feladat, hogy kialakítsak egy megbízható klasztert , amely több adatközpontban működik, egy városon belül optikai kábellel összekapcsolva, és képes elviselni egy adatközpont leállását (például áramkimaradást). A megbízhatóságért felelős szoftverként a következőt választottam: , mivel ez a RedHat hivatalos megoldása a megbízható klaszterek létrehozására. Az előnye, hogy a RedHat támogatja, és hogy ez egy univerzális (moduláris) megoldás. Ezzel nemcsak a PostgreSQL, hanem más szolgáltatások megbízhatósága is biztosítható, akár a standard modulok használatával, akár specifikus igényekhez való létrehozásával.
A megoldáshoz jogos kérdés merült fel: mennyire megbízható lesz a megbízható klaszter? Ennek vizsgálatára olyan tesztkörnyezetet alakítottam ki, amely különböző hibákat modellez a klaszter csomópontjain, várja a munkaképesség helyreállását, rehabilitálja a leállt csomópontot, és folytatja a tesztelést ciklusban. Eredetileg ezt a projektet hapgsql-nek nevezték, de idővel unalmassá vált számomra a név, amelyben csak egy magánhangzó van. Így a megbízható adatbázisokat (és az azokhoz tartozó float IP-t) a következőképpen kezdtem hívni: krogan (a számítógépes játék karaktere, akinek minden fontos szervét megismétlik), míg a csomópontokat, klasztereket és magát a projektet - tuchanka (a bolygó, ahol a kroganok élnek).
Most a vezetőség engedélyezte . A README hamarosan angolra lesz fordítva (mivel várhatóan a fő fogyasztók a Pacemaker és PostgreSQL fejlesztői lesznek), a régi orosz README verziót pedig úgy döntöttem, hogy részben cikk formájában formázom.
A klasztereket virtuális gépeken futtatják. Összesen 12 virtuális gép kerül telepítésre (összesen 36GiB), amelyek 4 megbízható klasztert alkotnak (különböző variációk). Az első kettő klaszter két PostgreSQL szerverből áll, amelyek különböző adatközpontokban találhatók, és egy közös szerverből, witness c quorum device (olcsó virtuális gépen a harmadik adatközpontban), amely feloldja a bizonytalanságot, 50%/50%, egy szavazatot adva valamelyik félnek. A harmadik klaszter három adatközpontban működik: egy mester, két munkás, anélkül, quorum device. A negyedik klaszter négy PostgreSQL szerverből áll, kettő adatközpontonként: egy mester és a többi replikáns, és szintén használja witness c quorum device. A negyedik elbír két szerver vagy egy adatközpont meghibásodását. Ez a megoldás, ha szükséges, nagyobb számú replikára is skálázható.
Pontos időszolgáltatás szintén átszervezésre került a hibamentesség érdekében, de ott a legújabb módszer található ntpd (orphan mode). Az általános szerver witness központi NTP-szerverként működik, megosztva az időt minden klaszter között, ezáltal szinkronizálva az összes szervert egymással. Ha witness meghibásodik vagy elszigetelődik, akkor az időt egy klaszterbeli szerver kezdheti megosztani (a klaszteren belül). Az auxiliary cache HTTP proxy szintén fent van witness, ezzel a többi virtuális gép hozzáfér az Yum-repozitóriumokhoz. A valóságban az olyan szolgáltatások, mint a pontos idő és a proxy, valószínűleg dedikált szervereken lesznek elhelyezve, míg a bemutató során witness csak a virtuális gépek számának és a helynek a megtakarítása érdekében kerültek elhelyezésre.
Verziók
v0. Működik a CentOS 7 és PostgreSQL 11 alatt a VirtualBox 6.1-en.
Klaszterek struktúrája
Minden klaszter a több adatközpontban való elhelyezésre készült, egy lapos hálózatba egyesítve, és képesnek kell lennie elbírni egy adatközpont leállását vagy hálózati elszigeteltségét. Ezért lehetetlen megvédeni a split-brain standard Pacemaker technológiával, amit úgy hívnak STONITH (Shoot The Other Node In The Head) vagy fencing. Lényege, hogy ha a klaszter csomópontjai azt gyanítják, hogy valamelyik csomóponttal probléma van, nem válaszol vagy helytelenül működik, akkor kényszerítetten lekapcsolják külső eszközök, például IPMI vagy UPS vezérlő kártya által. De ez csak akkor működik, ha a szerver egypontos leállításakor az IPMI vagy UPS továbbra is működik. Itt viszont a sokkal katasztrofálisabb leállás védelme van tervezve, amikor az egész adatközpontot leállítják (például áramtalanítják). Ilyen leálláskor az összes stonith-eszköz (IPMI, UPS stb.) szintén nem fog működni.
Ehelyett a rendszer alapja a kvórum eszméje. Minden csomópontnak van szavazati joga, és csak azok működhetnek, amelyek több mint a csomópontok felét látják. Ezt a mennyiséget „fél+1”-nek hívják kvórum. Ha a kvórum nem áll össze, akkor a csomópont úgy dönt, hogy hálózati elszigeteltségben van, és ki kell kapcsolnia az erőforrásait, azaz ez egyfajta védelme a split-brain. Ha a viselkedésért felelős szoftver nem működik, akkor működésbe kell lépnie egy watchdog-nak, például az IPMI alapjain.
Ha a csomópontok száma páros (a klaszter két adatközpontban), akkor úgynevezett bizonytalanság léphet fel 50%/50% (ötven-ötven), amikor a hálózati elszigeteltség pontosan félbe osztja a klasztert. Ezért páros számú csomópont esetén hozzáadódik quorum device — egy igénytelen démon, amely a legolcsóbb virtuális gépen futtatható a harmadik adatközpontban. Ő egy szavazatot ad egy olyan szegmenseknek (amit lát), és így feloldja az 50%/50% bizonytalanságot. A szerver, amelyen a kvórum eszköz futni fog, witness — (terminológia a repmgr-ből, tetszett ez a kifejezés).
Az erőforrások helyet változtathatnak, például hibás szerverekről jó állapotúakra, vagy a rendszergazdák utasítása alapján. Hogy az ügyfelek tudják, hol találhatóak a szükséges erőforrások (hova csatlakozzanak?), úszó IP (float IP). Ezek az IP-címek, amelyeket a Pacemaker áthelyezhet a csomópontok között (minden egy sík hálózatban található). Mindegyik jelképezi az erőforrást (szolgáltatást), és ott fog tartózkodni, ahova csatlakozni kell, hogy hozzáférjünk ehhez a szolgáltatáshoz (esetünkben a DB-hez).
Tuchanka1 (összenyomott séma)
Struktúra
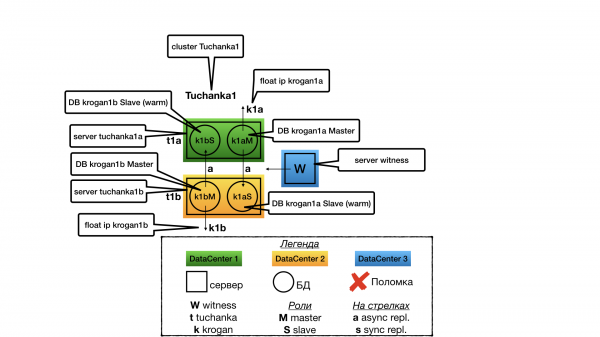
Az ötlet az volt, hogy sok apró adatbázisunk van alacsony terheléssel, amelyekhez nem jövedelmező fenntartani egy dedikált slave-szervert hot standby módban read only tranzakciókhoz (nincs szükség ilyen erőforrás-pazarlásra).
Minden adatközpontban egy szerver található. Minden szerveren két PostgreSQL példány működik (a PostgreSQL terminológiájában ezeket klasztereknek nevezzük, de a félreértések elkerülése érdekében őket példányoknak fogom hívni, hasonlóan más adatbázisokhoz, míg a klaszterek alatt csak a Pacemaker klasztereket értem). Az egyik példány mester módban működik, és csak ő nyújt szolgáltatásokat (csak rá irányul a float IP). A másik példány háttérként működik a második adatközpont számára, és csak akkor fog szolgáltatásokat nyújtani, ha a mestere meghibásodik. Mivel a legtöbb időben csak az egyik példány (a mester) fog szolgáltatásokat nyújtani (lekérdezéseket végezni), a szerver összes erőforrása a mester optimalizálására kerül, úgy, hogy a második példánynak is elegendő erőforrás álljon rendelkezésre (akár a fájlrendszer gyorsítótárán keresztül nem optimális működéshez) arra az esetre, ha az egyik adatközpont leállna. A háttér nem nyújt szolgáltatásokat (nem végez read only lekérdezéseket) a klaszter normál működése során, hogy elkerülje a forrásokért folytatott harcot a mesteren ugyanazon a gépen.
Két csomópont esetén a hibatűrés csak aszinkron replikációval lehetséges, mivel szinkron replikáció esetén a háttér meghibásodása a mester leállásához vezetne.
Witness meghibásodás
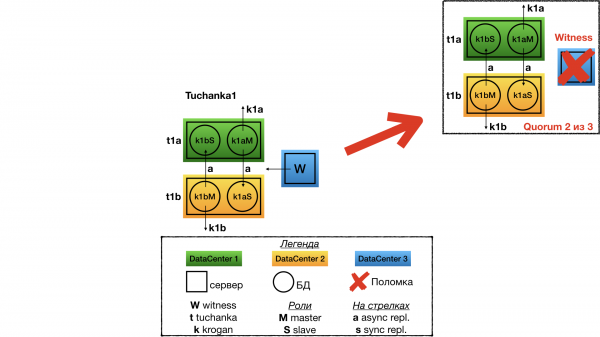
Witness meghibásodás (quorum device) csak a Tuchanka1 klaszteren fogom megvizsgálni, a többi esetében ugyanaz a helyzet. A witness meghibásodása esetén a klaszter struktúrája nem változik, minden ugyanúgy fog működni, ahogy korábban. De a kvórum 2 az 3-hoz válik, és ezért bármely következő meghibásodás fatális lesz a klaszter számára. Így is sürgősen meg kell javítani.
Tuchanka1 meghibásodás
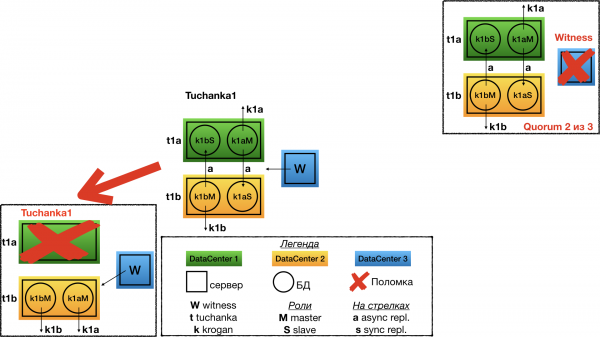
Az egyik adatközpont meghibásodása a Tuchanka1 esetében. Ebben az esetben witness a második csomópontnak adja a szavazatát a második adatközpontban. Ott a korábbi háttér mesterré válik, így egy szerveren működik mindkét mester, és rájuk mutat mindkettő float IP.
Tuchanka2 (klasszikus)
Struktúra
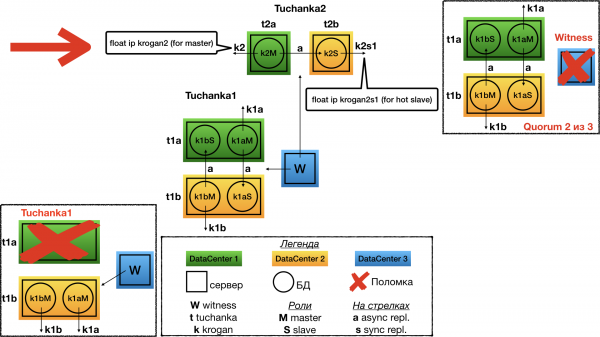
Klasszikus séma két csomóponttal. Az egyiken a mester, a másikon a háttér működik. Mindkettő képes lekérdezések végrehajtására (a háttér csak read only), így mindkettőn float IP található: krogan2 — a mesterhez, krogan2s1 — a háttérhez. Hibatűrés lesz a mester és a háttér esetében is.
Két csomópont esetén a hibatűrés csak aszinkron replikációval lehetséges, mert szinkron replikáció esetén a háttér meghibásodása a mester leállásához vezetne.
Tuchanka2 meghibásodás
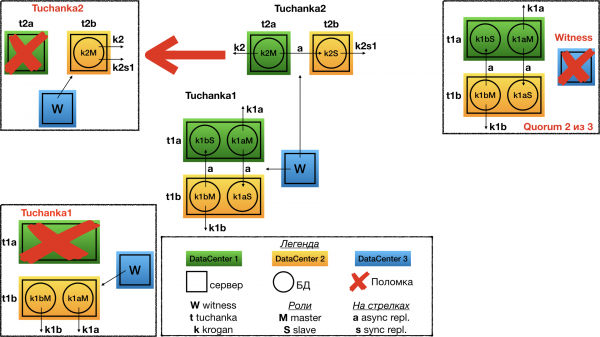
Egy adatközpont meghibásodása esetén witness a másodikra szavaz. Az egyetlen működő adatközpontban felállítanak egy mestert, amelyre mindkét float IP, a mester és a rabszolga is mutat. Természetesen az instanciának úgy kell beállítva lennie, hogy elegendő erőforrása (kapacitás a kapcsolatokhoz stb.) legyen az összes kapcsolat és kérés egyidejű fogadásához a mesteri és rabszolga float IP-től. Vagyis normál működés mellett elegendő tartalékkal kell rendelkeznie a korlátok között.
Tuchanka4 (sok rabszolga)
Struktúra
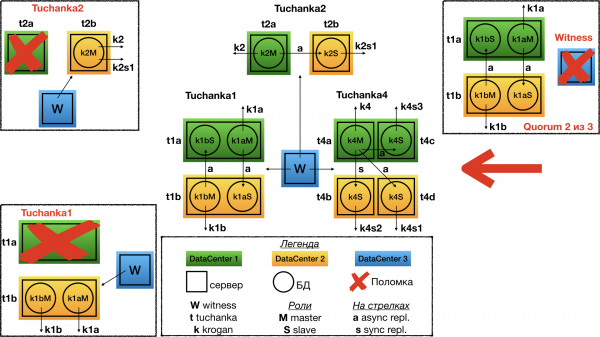
Ez már egy másik szélsőség. Vannak olyan adatbázisok, amelyekre nagyon sok read-only kérés érkezik (tipikus eset egy nagy terhelésű weboldal). A Tuchanka4 olyan helyzet, amikor három vagy több rabszolga is lehet az ilyen kérdések kezelésére, de mégsem túl sok. Nagy számú rabszolga esetén hierarchikus replikációs rendszert kell kitalálni. A minimális esetben (a képen) mindkét adatközpontban két szerver található, mindegyiken egy PostgreSQL instanciával.
Ezeknek a rendszereknek egy másik jellemzője, hogy itt már be lehet állítani egy szinkron replikációt. Ez úgy van konfigurálva, hogy lehetőség szerint egy másik adatközpontba replikáljon, nem pedig arra a replikára, amelyik ugyanabban az adatközpontban található, mint a mester. A mester és minden rabszolga egy float IP-t használ. Ideális esetben a rabszolgák között valamilyen kéréskiegyenlítést kell végrehajtani. sql proxy, például a kliens oldalán. Különböző típusú klienseknek eltérő típusú sql proxy, és csak a kliensfejlesztők tudják, kinek milyen szükséges. Ez a funkció megvalósítható külső démonként, kliens könyvtárként (kapcsolati medence) stb. Mindez túllép a DB kluster megbízhatóságának témáján (megbízhatóság SQL proxy külön is megvalósítható, együtt a kliens megbízhatóságával).
A Tuchanka4 leállása
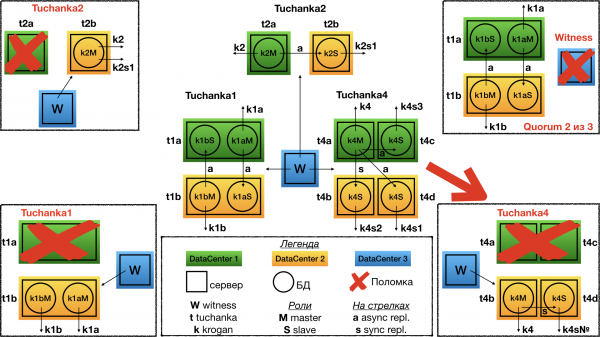
Ha az egyik adatközpont megszűnik működni (azaz két szerver), a witness a másodikra szavaz. Ennek eredményeként a második adatközpontban két szerver működik: az egyik a mestert futtatja, amely a mesteri float IP-re mutat (read-write kérdések fogadása érdekében); a második szerver pedig egy rabszolgát futtat szinkron replikációval, és egy rabszolga float IP-re mutat (read only kérdésekhez).
Az első, amit meg kell jegyezni: a rabszolga float IP-k nem mindegyike lesz működőképes, csak egy. A helyes működés érdekében fontos, hogy sql proxy Minden kérést az egyetlen megmaradt float IP-re irányított; ha pedig sql proxy nem, akkor a kapcsolódáshoz az összes float IP-t vesszük fel vesszővel az URL-ben. Ebben az esetben a libpq kapcsolat az első működő IP-hez történik, ahogyan azt az automatikus tesztelő rendszer megoldotta. Lehetséges, hogy más könyvtárak, például a JDBC esetében ez nem fog működni, és szükséges sql proxy. Ez azért van, mert a slave float IP-k esetében tilalom van érvényben, hogy egy időben egy szerveren legyenek aktiválva, hogy egyenletesen eloszoljanak a slave szerverek között, ha több is működik.
Második: még ha a data center meghibásodik, a szinkron replikáció megmarad. És még ha másodlagos hibásodás is történik, vagyis ha a megmaradt data centerben az egyik a két szerver közül leáll, a klaszter bár nem fog szolgáltatni, de mégis megőrzi az összes megerősített tranzakcióról az információt, amelyekről visszaigazolást adott (nem lesz adatvesztés másodlagos meghibásodás esetén).
Tuchanka3 (3 data center)
Struktúra
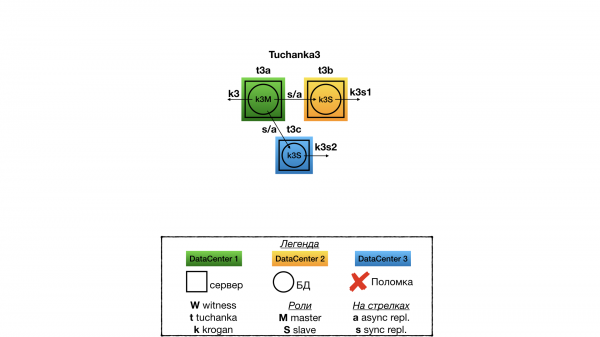
Ez a klaszter olyan helyzetekre készült, amikor három teljesen működőképes data center létezik, mindegyikben egy teljesen működő DB szerverrel. Ebben az esetben quorum device nincs szükség. Az egyik data centerben működik a mester, a másik kettőben – slave. A replikáció szinkron, ANY típusú (slave1, slave2), tehát a kliens akkor kap megerősítést a commitról, amikor bármelyik slave elsőként válaszol, hogy elfogadta a commitot. Az erőforrásokat egy float IP jelöli a mesterhez és kettő a slave-hez. A Tuchanka4-hez képest mindhárom float IP hibamentes. sql proxy A read-only SQL lekérdezések kiegyensúlyozásához használható
(külön hibamentességgel), vagy az ügyfelek felét egy slave float IP-re, a másik felét pedig a másikra osztják.
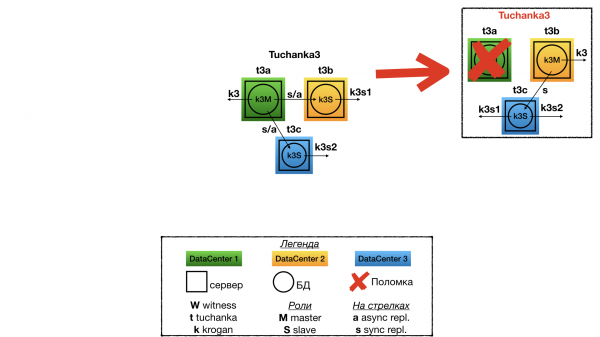
Tuchanka3 hibája általában az, hogy ha az egyik data center meghibásodik, kettő marad. Az egyikben a mester és mester float IP működik, a másodikban a slave és mindkét slave float IP (a példányban dupla erőforrást kell fenntartani, hogy mindkét slave float IP-ről összes kapcsolatot fogadhat). A mester és a slave között szinkron replikáció van. A klaszter megőrzi az összes megerősített és visszaigazolt tranzakció információját (nem lesz adatvesztés) két data center megsemmisítése esetén (ha nem egyszerre semmisítik meg őket).
A fájlszerkezet és a telepítés részletes leírását nem illesztettem be. Aki játszani szeretne, az mindezt elolvashatja a README-ben. Csak az automatikus tesztelés leírását hozom.
Automatikus tesztelési rendszer
A klaszterek megbízhatóságának tesztelésére, különböző hibák szimulálásával készült az automatikus tesztelési rendszer. A script futtatásához használható: test/failure. A script paramétereként elfogadja a tesztelni kívánt klaszterek számát. Például ez a parancs:
test/failure 2 3csak a második és a harmadik klasztert fogja tesztelni. Ha nincsenek megadva paraméterek, akkor minden klaszter tesztelve lesz. Az összes klaszter párhuzamosan tesztelődik, és az eredmény megjelenik a tmux paneljén. A Tmux egy dedikált tmux szervert használ, ezért a scriptet a default tmux-ból is futtathatjuk, így beágyazott tmux jön létre. Ajánlom a terminál használatát nagy ablakban és kisméretű betűvel. A tesztelés megkezdése előtt az összes virtuális gép visszaáll a script befejezésének pillanatában készült snapshotra. setup.
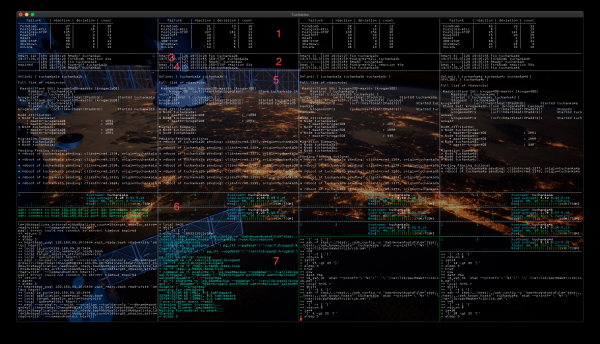
A terminál oszlopokra van felosztva a tesztelt klaszterek számának megfelelően, alapértelmezett esetben (a képernyőképen) négy van belőle. Az oszlopok tartalmát a Tuchanka2 példáján írom le. A képen a panelek számozva vannak:
- Itt a tesztekről szóló statisztikák jelennek meg. Az oszlopok:
- failure — a teszt (a scriptben található funkció) neve, amely szimulálja a hibát.
- reaction — az az átlagos idő másodpercben, amely alatt a klaszter helyreállt. A script kezdetétől a hiba szimulálásáig és addig az időpontig mérve, amikor a klaszter helyreáll és képes folytatni a szolgáltatások nyújtását. Ha az idő nagyon kicsi, például hat másodperc (ez megtörténik a több slave-fel rendelkező klasztereknél (Tuchanka3 és Tuchanka4)), az azt jelenti, hogy a hiba egy aszinkron slave-en történt, és egyáltalán nem befolyásolta a működőképességet, állapotváltás nem történt.
- deviation — a mérés szórását (pontosságát) mutatja reaction a „standard deviation” módszerével.
- count — a teszt hányszor lett végrehajtva.
- A rövid napló segít értékelni, hogy a klaszter jelenleg mivel foglalkozik. Megmutatja az iteráció (teszt) számát, az időbélyeget és az eljárás nevét. A túl hosszú végrehajtás (> 5 perc) problémára utal.
- heart (szív) — aktuális idő. A működőképesség vizuális értékeléséhez mester az ő táblájába folyamatosan beíródik az aktuális idő a mester float IP-jának használatával. Siker esetén az eredmény ezen a panelen jelenik meg.
- ütés (pulzus) — az „aktuális idő”, amely korábban a szkript által lett rögzítve heart a mesterbe, most pedig ből van leolvasható a rabszolga az ő float IP-jén keresztül. Lehetővé teszi a rabszolga és a replikáció működőképességének vizuális értékelését. A Tuchanka1-en nincsenek rabszolgák float IP-vel (nincsenek azok a rabszolgák, akik szolgáltatást nyújtanak), viszont ott két példány (DB) van, ezért itt nem a ütés, és heart második példányt fogjuk mutatni.
- A klaszter állapotának figyelése a
pcs moneszközzel. Megjeleníti a struktúrát, az erőforrások elosztását a csomópontok között és egyéb hasznos információt. - Itt a klaszter minden virtuális gépének rendszermonitoringja megjelenik. Ezekből a panelekből lehet több is — annyi virtuális gép van a klaszterben. Két grafikon CPU Terhelés (a virtuális gépekben két processzorral), a virtuális gép neve, Rendszer terhelés (Load Average néven, mivel 5, 10 és 15 perc alatt átlagolt), a folyamatok adatai és a memória elosztás.
- A szkript nyomvonalának nyomkövetése, amely teszteléseket végez. Ha hiba lép fel — hirtelen a működés megszakítása vagy végtelen várakozási ciklus — itt meg lehet nézni ennek a viselkedésnek az okát.
A tesztelés két lépésben történik. Először a szkript bejárja az összes tesztfajtát, véletlenszerűen választva egy virtuális gépet, amelyre a tesztet alkalmazza. Ezután egy végtelen tesztelési ciklus következik, ahol a virtuális gépek és a hibák minden alkalommal véletlenszerűen kerülnek kiválasztásra. A tesztelő szkript váratlan leállítása (alsó panel) vagy a végtelen várakozási ciklus valamiért (> 5 perc egy művelet végrehajtásához, ezt a nyomvonalban látható) azt jelzi, hogy a klaszteren van egy megbukott teszt.
Minden teszt a következő műveletekből áll:
- A funkció elindítása, amely a hibát emulálja.
- Készen áll? — a klaszter működőképességének helyreállításának várakozása (amikor minden szolgáltatás elérhető).
- A klaszter helyreállításának ideje jelenik meg (reaction).
- Megjavít — a klaszter „javítja” magát. Ezután teljes működőképes állapotba kell visszatérnie, készen a következő hibára.
Itt van a tesztek listája azzal a leírással, hogy mit csinálnak:
- ForkBomb: „Out of memory” létrehozása fork-bombával.
- OutOfSpace: megtelik a merevlemez. De a teszt inkább szimbolikus, figyelembe véve azt a csekély terhelést, amely a tesztelés során keletkezik, a merevlemez telítődésekor általában nem következik be PostgreSQL leállása.
- Postgres-KILL: megöli a PostgreSQL-t a parancs segítségével
killall -KILL postgres. - Postgres-STOP: felfüggeszti a PostgreSQL-t a parancs segítségével
killall -STOP postgres. - PowerOff: "áram nélküli" állapotba állítja a virtuális gépet a parancs segítségével
VBoxManage controlvm "virtuális gép" poweroff. - Reset: újraindítja a virtuális gépet a parancs segítségével
VBoxManage controlvm "virtuális gép" reset. - SBD-STOP: felfüggeszti az SBD démon parancs segítségével
killall -STOP sbd. - ShutDown: SSH-n keresztül küld parancsot a virtuális gépnek
systemctl poweroff, a rendszer helyesen befejezi a működését. - UnLink: hálózati izoláció, parancs
VBoxManage controlvm "virtuális gép" setlinkstate1 off.
A teszt befejezése vagy a standard "tmux kill-window" parancs segítségével Ctrl-b &, vagy a "detach-client" parancs segítségével Ctrl-b d: így a teszt befejeződik, a tmux bezáródik, a virtuális gépek leállnak.
A tesztelés során észlelt problémák
Jelenleg a sbd watchdog démon kezelni tudja a megfigyelt démonok leállítását, de nem azok felfüggesztését. Ennek következtében a felfüggesztéshez vezető meghibásodásokat helytelenül kezelik. Corosync és Pacemaker, de nem felfüggesztve sbd. A teszteléshez Corosync már létezik , elfogadva a masterágba. Megígérték (a PR#83-ban), hogy a Pacemaker számára is lesz valami hasonló, remélem, hogy RedHat 8 -t megcsinálják. De az ilyen "meghibásodások" elméletiek, könnyen mesterségesen utánozhatók például
killall -STOP corosync, de valós életben soha nem fordulnak elő.A Pacemaker CentOS 7 verzióban helytelenül állították be sync_timeout sa-logic-subsets-canary-vs.yaml quorum device, ennek következtében , ahová a mesternek át kellett volna lépnie, újraindult. Ez orvosolva lett a sync_timeout sa-logic-subsets-canary-vs.yaml quorum device telepítés során (a szkriptben
setup/setup1). Ezt a javítást a fejlesztők nem fogadták el Pacemaker, ehelyett megígérték, hogy a jövőben újra dolgozzák az infrastruktúrát, hogy ez a timeout automatikusan kiszámításra kerüljön.Ha az adatbázis konfigurálásakor meg van adva, hogy az
LC_MESSAGES(szöveges üzenetek) esetén használható Unicode, példáulru_RU.UTF-8, akkor ha postgres olyan környezetben indul, ahol a locale nem UTF-8, például üres környezetben (itt pacemaker+pgsqlms(paf) elindítva postgres), akkor . A PostgreSQL fejlesztői soha nem tudták megállapítani, mit kell tenni ebben az esetben. Ezt megkerülni lehet, szükséges a telepítés.LC_MESSAGES=hu_HU.UTF-8adatbázis példányának konfigurálása (létrehozása) során.Ha be van állítva a wal_receiver_timeout (alapértelmezés szerint 60 másodperc), akkor a PostgreSQL-STOP teszt során a mesterben a tuchanka3 és tuchanka4 klaszterekben . A replikáció szinkron, ezért nemcsak a munka, hanem az új mester is leáll. Megoldható a wal_receiver_timeout=0 beállításával a PostgreSQL konfigurálásakor.
Ritkán megfigyeltem a PostgreSQL replikációjának felfüggesztését a ForkBomb teszt során (memória túlterhelés). . Csak a tuchanka3 és tuchanka4 klaszterekben találkoztam ezzel, ahol a szinkron replikáció miatt a mester megfagyott. A probléma magától elmúlt egy hosszú idő után (körülbelül két óra). További kutatás szükséges a javításhoz. A tünetek hasonlítanak a korábbi hibára, amelyet más ok váltott ki, de azonos következményekkel.
A krogan képet innen vették a szerző engedélyével:
Forrás: habr.com
