

A nyomonkövető rendszer létrehozásának gondolata már a termékcsapatok kialakításának szakaszában felmerült. Világossá vált, hogy a mi feladatunk – a működtetés – sehogy sem kapcsolódik ezekhez a csapatokhoz. Miért van ez így?
Az a helyzet, hogy csapataink mind különálló informatikai rendszerek, mikroszolgáltatások és frontok köré épültek, ezért a csapatok nem látják az egész rendszer általános állapotát. Például előfordulhat, hogy nem tudják, egy aprócska rész a mély háttérben hogyan befolyásolja a frontoldali részt. Érdeklődésük a rendszerükhöz integrált rendszerekre korlátozódik. Ha a csapat és annak A szolgáltatása szinte egyáltalán nem kapcsolódik B szolgáltatásához, akkor a csapat számára ez a szolgáltatás szinte láthatatlan.
A mi csapatunk viszont olyan rendszerekkel dolgozik, amelyek között nagyon szoros integráció van: ezek között sok kapcsolat létezik, ez egy meglehetősen nagy infrastruktúra. És mindezek a rendszerek (amelyekből egyébként rengeteg van) meghatározzák az online bolt működését.
Ezért a mi részlegünk nem tartozik egyetlen csapathoz sem, hanem kicsit a háttérbe húzódik. Az egész történetben a mi feladatunk az, hogy együttesen értsük, hogyan működnek az informatikai rendszerek, azok funkciói, integrációik, szoftverei, hálózatai, hardverei, és hogyan kapcsolódnak egymáshoz.
A platform, amelyen az online boltjaink működnek, így néz ki:
- front
- middle-office
- back-office
Bárhogy is szeretnénk, nem létezik olyan, hogy minden rendszer zökkenőmentesen és hibátlanul működik. Az ismételt rendszerek és integrációk száma miatt – a mi esetünkben – elkerülhetetlenek bizonyos incidensek, annak ellenére, hogy a tesztelés minősége kiváló. Ráadásul ezek előfordulhatnak nemcsak egy adott rendszerben, hanem az integrációik szintjén is. A platform állapotát komplex módon kell figyelemmel kísérni, nem pedig valamelyik külön részét.
Ideálisan a platform egészségi állapotának figyelését automatizálni kellene. Így hát a monitoringhoz jutottunk el mint ennek a folyamatnak a elkerülhetetlen részéhez. Kezdetben csak a frontoldali részre épült, ugyanakkor a hálózati szakemberek, a szoftver- és hardveradminisztrátorok régi rétegek monitoring rendszerei már léteztek és léteznek. Mindezek az emberek csak a saját szintjükön figyelték a monitorozást, senkinek sem volt átfogó megértése.
Például, ha egy virtuális gép leáll, a legtöbb esetben erről csak a hardverért és a virtuális gépért felelős adminisztrátor tud. A frontend csapata ilyenkor csak az alkalmazás leállását látja, de a virtuális gép leállásáról nincs információja. Az adminisztrátor tudhatja, ki a megrendelő, és körülbelül tudhatja, mi fut éppen azon a virtuális gépen, feltéve, hogy az egy nagyobb projekt. A kisebb projektekről valószínűleg nem tud. Mindenesetre az adminisztrátornak fel kell keresnie a tulajdonost, és meg kell kérdeznie, mi volt az adott gépen, mit kell helyreállítani és mit kell cserélni. Ha valami igazán komoly hibát tapasztaltak, elkezdődött a futkosás, mert senki sem látta az egész rendszert.
Végső soron ezek a szétszórt történetek hatással vannak az egész frontend működésére, a felhasználókra és a fő üzleti funkciónkra - az internetes értékesítésre. Mivel nem tartozunk a csapatokhoz, és az összes e-kereskedelmi alkalmazás üzemeltetésével foglalkozunk az online bolt keretein belül, ezért magunkra vállaltuk, hogy kialakítunk egy átfogó monitoring rendszert az e-kereskedelmi platformhoz.
A rendszer struktúrája és technológiai stackje
Az első lépésként kiemeltük néhány monitoring réteget a rendszereink számára, amelyek mentén szükségünk volt metrikák gyűjtésére. Ezt mind össze kellett kapcsolnunk, amit meg is tettünk az első szakaszban. Jelenleg ezen a szakaszon dolgozunk a lehető legjobb metrikagyűjtés kiépítésén az összes rétegünkre, hogy korrelációkat alakítsunk ki és megértsük, hogyan hatnak egymásra a rendszerek.
A komplex monitoring hiánya az alkalmazások kezdeti indítási szakaszában (mivel akkor kezdtük el felépíteni, amikor a legtöbb rendszer már üzemelt) jelentős technikai adósságot okozott az egész platform monitoring rendszerének beállításában. Nem engedhettük meg magunknak, hogy egyetlen információs rendszer monitoringjára összpontosítsunk, és részletesen kidolgozzuk a monitoringot, mivel a többi rendszer egy ideig monitoring nélkül maradt volna. E feladat megoldására meghatároztuk a legszükségesebb metrikákat az információs rendszer állapotának rétegekre bontott értékeléséhez és elkezdtük azok bevezetését.
Ezért a problémát részletekben döntöttük el.
A rendszerünk a következőkből áll:
- hardver;
- operációs rendszer;
- szoftver;
- UI-alkatrészek a monitorozó alkalmazásban;
- ügyviteli mutatók;
- integrációs alkalmazások;
- információbiztonság;
- hálózat;
- terheléselosztó.
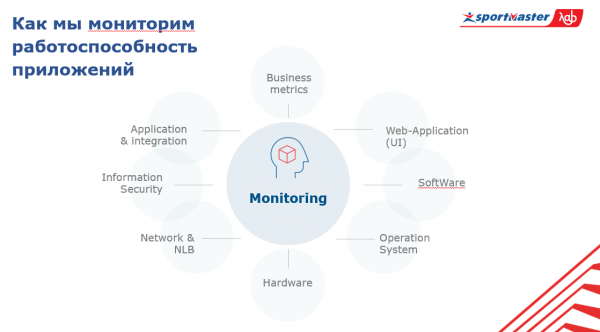
A rendszer középpontjában a monitorozás áll. Ahhoz, hogy általánosan megértsük az egész rendszer állapotát, tudnunk kell, mi történik az alkalmazásokkal minden egyes rétegben és a számos alkalmazás kereszttüzében.
Szóval, a technológiai stackről.
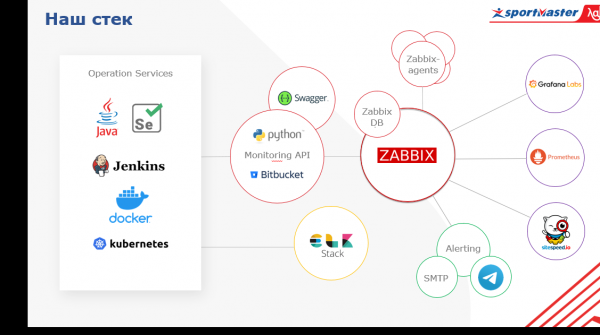
Nyílt forráskódú szoftvert használunk. A középpontban a Zabbix áll, amelyet elsősorban riasztási rendszerként használunk. Mindenki tudja, hogy ez az infrastruktúra monitorozására tökéletesen alkalmas. Miről van szó? Pontosan azokról az alacsony szintű metrikákról, amelyek minden cég esetében megtalálhatóak, amelynek van saját adatközpontja (a Sportmősternek saját adatközpontjai vannak) - a szerver hőmérséklete, a memória állapota, a RAID, a hálózati eszközök metrikái.
Integráltuk a Zabbixot a Telegram és a Microsoft Teams üzenetküldőkkel, amelyeket a csapatok aktívan használnak. A Zabbix lefedi a tényleges hálózati, hardveres és részben szoftveres réteget, de ez nem csodaszer. Ezeket az adatokat néhány más szolgáltatásból gazdagítjuk. Például a hardver szintjén közvetlenül az API-n keresztül csatlakozunk a virtualizációs rendszerünkhöz, és onnan hozzuk el az adatokat.
Mi még? A Zabbix mellett használunk Prometheust, amely lehetővé teszi az alkalmazás metrikáinak monitorozását dinamikus környezetben. Ez azt jelenti, hogy HTTP végpontról kaphatjuk az alkalmazás metrikáit, és nem kell aggódnunk amiatt, hogy mely metrikákat töltsünk be, és melyeket ne. Ezen adatok alapján analitikai kérdéseket dolgozhatunk ki.
Az egyéb rétegek adatforrásai, például az üzleti metrikák, három összetevőre oszlanak.
Először is külső üzleti rendszerek, Google Analytics, logokból gyűjtött metrikák. Ezekből adatokat kapunk az aktív felhasználókról, a konverziókról és minden egyéb, a üzlettel kapcsolatos dologról. Másodszor, UI-monitorozó rendszerről van szó. Ezt részletesebben meg kell beszélnünk.
Valaha manuális teszteléssel kezdtük, ami funkcionalitás- és integrációs automatizált tesztekké fejlődött. Ebből alakítottuk ki a monitorozást, megtartva csak a fő funkciót, és azokra a markerekre támaszkodtunk, amelyek maximálisan stabilak és nem változnak gyakran az idő múlásával.
Az új csapatstruktúra azt jelenti, hogy az alkalmazásokkal kapcsolatos tevékenységek a termékcsapatokra összpontosulnak, ezért a tiszta tesztelést abbahagytuk. Ehelyett a teszteket UI-monitoringgá alakítottuk, amely Java, Selenium és Jenkins segítségével készült (ez utóbbi a futtató és riportgeneráló rendszerünk).
Sok tesztünk volt, de végül úgy döntöttünk, hogy a fő útra, egy felső szintű metrikára mozdulunk el. Ha sok specifikus tesztet végezünk, nehéz lesz fenntartani az adatok relevanciáját. Minden egyes új kiadás jelentősen megszakítja a rendszert, és mi csak a javítással foglalkozunk. Ezért a teljesen alapvető dolgokra összpontosítunk, amelyek ritkán változnak, és csak azokat figyeljük.
Végül, harmadszor, az adatok forrása egy központosított naplózási rendszer. A naplókhoz Elastic Stack-et használunk, majd ezeket az adatokat betudjuk tölteni az üzleti metrikáink felügyeleti rendszerébe. Ezenkívül működik a saját Monitoring API szolgáltatásunk, amit Pythonban írtunk, amely API-n keresztül lekérdezi a különféle szolgáltatásokat, és adatokat gyűjt a Zabbix számára.
A monitoring másik elengedhetetlen eleme a vizualizáció. Nálunk ez a Grafana alapjain épül fel. Más vizualizáló rendszerekhez képest azzal tűnik ki, hogy a műszerfalon különböző adatok forrásaiból származó metrikákat vizualizálhatunk. Összegyűjthetjük egy online bolt felső szintű metrikáit, például az utolsó órában leadott rendelések számát az adatbázisból, a boltot futtató operációs rendszer teljesítménymetrikáit a Zabbixból, és az alkalmazás példányainak metrikáit a Prometheusból. Mindez ugyanazon a műszerfalon jelenik meg. Áttekinthető és elérhető.
Megjegyzem a biztonságot is — most épp finomítjuk a rendszert, amelyet később integrálni fogunk a globális felügyeleti rendszerrel. Véleményem szerint az e-kereskedelem információbiztonság területén jelentkező fő problémák a botokkal, parse-kkel és bruteforce támadásokkal kapcsolatosak. Ezen figyelni kell, mert ezek kritikusan befolyásolhatják alkalmazásaink működését, valamint a vállalkozás szempontjából a hírnevünket. A választott technológiai stackkel ezeket a feladatokat sikeresen lefedjük.
Egy másik fontos szempont, hogy az alkalmazások szintjének adatait a Prometheus gyűjti. Ez is integrálva van a Zabbix-szal. Továbbá van egy sitespeed nevű szolgáltatásunk, amely lehetővé teszi számunkra, hogy nyomon követhessük az olyan paramétereket, mint a weboldalunk betöltési sebessége, szűk keresztmetszetek, a weboldal megjelenítése, a szkriptek betöltése és egyebek; ez szintén API-n keresztül van integrálva. Így a metrikáink a Zabbixban gyűlnek, tehát az értesítéseinket is onnan küldjük. Az összes értesítés jelenleg a fő értesítési módokra megy (jelenleg ez email és telegram, nemrég csatlakoztattuk a MS Teams-t is). Terveink között szerepel, hogy az értesítési rendszert olyan állapotba fejlesszük, hogy intelligens botok szolgáltatásként működjenek, és információkat nyújtsanak a monitorozásról minden érdeklődő termékcsapat számára.
Számunkra fontosak a metrikák nemcsak az egyes információs rendszerek szintjén, hanem az egész infrastruktúra által használt általános metrikák is: klaszterek, fizikai szerver telepítésemelyekre virtuális gépek, terheléselosztók, Network Load Balancer-ek futnak, maga a hálózat, a kommunikációs csatornák kihasználtsága. Plusz metrikák a saját adatközpontjainkról (több van belőlük, és az infrastruktúra elég jelentős méretű).
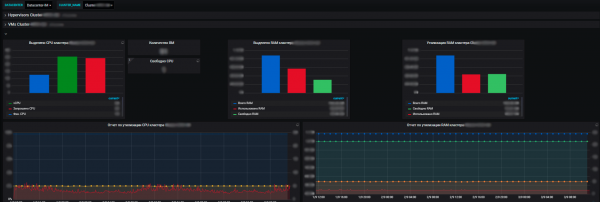
A megfigyelő rendszerünk előnyei abban rejlenek, hogy ezen a módon láthatjuk a rendszerek működési állapotát, értékelhetjük a hatásukat egymásra és az általános erőforrásokra. Végső soron lehetővé teszi a források tervezését is, ami szintén a felelősségi körünkbe tartozik. Kiszolgáló erőforrásokat kezelünk – egy e-kereskedelmi kereten belül, új eszközöket állítunk üzembe és vonunk ki a forgalomból, újakat vásárolunk, auditáljuk az erőforrások kihasználtságát, és így tovább. Évente a csapatok új projekteket terveznek, fejlesztik a rendszereiket, és fontos számunkra, hogy erőforrásokat biztosítsunk számukra.
A metrikák segítségével látjuk az információs rendszereink erőforrás-fogyasztásának tendenciáit. Ezek alapján már tudunk tervezni. A virtualizációs szinten adatokat gyűjtünk, és látjuk az elérhető erőforrások mennyiségét az adatközpontok bontásában. Az adatközponton belül pedig látható a kihasználtság és a tényleges elosztás, erőforrás-fogyasztás. Ráadásul a standalone szerverek mellett virtuális gépekről és fizikai szerverek klaszteréről van szó, ahol ezek a virtuális gépek aktívan működnek.
Kilátások
Jelenleg a rendszer magja kész, de még mindig számos olyan terület van, amin dolgoznunk kell. Legalábbis ez a réteg az információbiztonság, de fontos, hogy elérjük a hálózatot, fejlesszük az értesítést, és megoldjuk a korreláció problémáját. Sok réteg és rendszer van, mindegyiken további mutatók találhatók. Olyan, mint egy matrjoška, ami matrjoškák sorozatát rejti.
Célunk végső soron a megfelelő értesítések létrehozása. Például, ha probléma adódik a hardverrel, például egy virtuális géppel, ahol egy fontos alkalmazás futott, és a szolgáltatás nem volt tartalékolva. Megtudjuk, hogy a virtuális gép leállt. Ezután az üzleti mutatók figyelmeztetnek: felhasználók tűntek el, nincs konverzió, a felhasználói felület nem elérhető, a szoftver és a szolgáltatások szintén leálltak.
Ebben az esetben spam értesítéseket kapunk, ami már nem felel meg a helyes monitoring rendszer formátumának. Felmerül a korreláció kérdése. Ezért ideális esetben a monitoring rendszerünknek azt kellene mondania: „Fiúk, a fizikai gép leállt, és vele együtt ez az alkalmazás és ezek a mutatók”, mindezt egyetlen értesítéssel, ahelyett, hogy dühösen számos értesítéssel árasztana el minket. Azért van, hogy a legfontosabbat — az okot — jelentse, ami segíti a probléma gyors elhárítását.
Az értesítési rendszerünk és az értesítések feldolgozása a 24 órás forródróton alapul. Minden értesítést, amely nálunk must-have, és szerepel a check-listán, oda küldenek. Minden értesítéssel kötelezően rendelkeznie kell leírással: mi történt, mit jelent valójában, milyen hatása van. Emellett link a műszerfalra és útmutató, hogy mit kell tennünk ilyen esetben.
Ez az értesítések kialakításának követelményeiről szól. A helyzet két irányban fejlődhet — vagy probléma van, amit meg kell oldani, vagy hiba történt a monitoring rendszerben. De mindenesetre, ki kell menni és megoldani a helyzetet.
Átlagosan mostanra naponta körülbelül száz értesítést kapunk, tekintettel arra, hogy az értesítések korrelációja még nem megfelelően van beállítva. És ha technikai munkálatokat kell végezni, és valamit kényszerített módon leállítunk, ezek száma többszörösére nő.
A rendszerek, amelyeket üzemeltetünk, monitorozása és az általunk fontosnak tartott metrikák gyűjtése mellett a monitorozó rendszer lehetőséget ad az adatok összegyűjtésére a termékcsapatok számára. Ezek befolyásolhatják a megfigyelt információs rendszereken belüli metrikák összetételét.
Munkatársunk bejöhet, és kérheti egy új metrika hozzáadását, amely számunkra és a csapatnak is hasznos lehet. Vagy például lehet, hogy a csapatnak nem elegendőek az alapvető metrikák, amelyekkel rendelkezünk, szükségük van egy specifikus nyomon követési megoldásra. A Grafanában létrehozzuk a csapatok számára a saját területeiket, és adminisztrátori jogosultságokat adunk nekik. Továbbá, ha a csapatoknak irányítópultokra van szükségük, de ők maguk nem tudják/ nem ismerik, hogyan kell ezt megtenni, segítünk nekik.
Mivel nincs közvetlen kapcsolatban a csapat értékteremtő folyamataival, kiadásaival és tervezésével, fokozatosan eljutunk oda, hogy az összes rendszer kiadásai zökkenőmentesek, és napi szinten kihelyezhetők anélkül, hogy ezt velünk egyeztetni kellene. Számunkra fontos, hogy nyomon követhessük ezeket a kiadásokat, mert potenciálisan befolyásolhatják az alkalmazás működését és megszakíthatják azt, ami kritikus. A kiadások kezelésére a Bamboo-t használjuk, ahonnan API-n keresztül információkat kapunk, és láthatjuk, hogy mely kiadások és azok státusza milyen információs rendszerekben kerültek kiadásra, és a legfontosabb: mikor. A kiadási jelzőket ráhelyezzük a legfontosabb kritikus metrikákra, ami vizuálisan nagyon kifejező problémák esetén.
Így láthatjuk a korrelációt az új kiadások és a felmerülő problémák között. Az alapgondolat az, hogy megértsük, hogyan működik a rendszer minden szinten, gyorsan lokalizáljuk a problémát és ugyanolyan gyorsan orvosoljuk azt. Hiszen gyakran előfordul, hogy nem a probléma megoldása, hanem a kiváltó ok keresése tart tovább.
A jövőben erre a proaktivitásra szeretnénk összpontosítani. Ideálisan előre szeretnénk értesülni a közelgő problémákról, nem pedig utólag, hogy inkább megelőzésről, semmint megoldásról beszélhessünk. Néha a megfigyelő rendszer hamis riasztásokat ad, akár emberi hiba, akár az alkalmazásban történt változások miatt. Dolgozunk ezen, finomítjuk a rendszert, és igyekszünk bármilyen manipuláció előtt értesíteni azokat a felhasználókat, akik együtt használják velünk a megfigyelő rendszert, vagy ezeket a műveleteket technikai ablakban végezni.
Tehát a rendszer elindult és sikeresen működik kora tavasz óta… és teljesen reális profitot mutat. Természetesen ez nem a végső verziója, még sok hasznos funkciót fogunk bevezetni. De jelenleg, ennyi integráció és alkalmazás esetén, a megfigyelés automatizálása nélkül valóban nem lehet megoldani.
Ha Ön is nagy projekteket figyel, komoly számú integrációval — írja meg a megjegyzésekben, milyen ezüst lövedéket talált ehhez.
Forrás: habr.com
