

Sokan használnak specializált eszközöket az adatok kinyerésére, átalakítására és betöltésére relációs adatbázisokba. Az eszközök működését naplózzák, a hibák rögzítve vannak.
Hiba esetén a naplóban információ található arról, hogy az eszköz nem tudta végrehajtani a feladatot, és hogy mely modulok (gyakran Java) hol álltak meg. Az utolsó sorokban megtalálhatók az adatbázis hibái, például a táblázat egyedi kulcsának megsértése.
Hogy megválaszoljam a kérdést, hogy milyen szerepet játszik az ETL hibákról szóló információ, az elmúlt két év összes problémáját osztályoztam, egy nem kicsi adattárban.
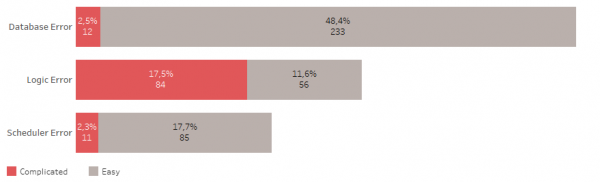
Az adatbázis hibái közé tartoznak olyan problémák, mint a hely hiánya, a kapcsolat megszakadása, a munkamenet lefagyása stb.
A logikai hibák közé tartoznak olyan problémák, mint a táblák kulcsainak megsértése, érvénytelen objektumok, hozzáférési problémák stb.
Az ütemező nem megfelelő időben is elindulhat, le is fagyhat stb.
Az egyszerű hibák javítása nem sok időt igényel. A jó ETL rendszer a legtöbb esetben képes ezeket önállóan kezelni.
A bonyolultabb hibák megkövetelik, hogy megnyissuk és ellenőrizzük az adatkezelési eljárásokat, kutassuk fel az adatforrásokat. Gyakran szükségessé teszik a változások tesztelését és telepítését.
Tehát a problémák fele az adatbázishoz kapcsolódik. A hibák 48%-a egyszerű hiba.
A problémák egyharmada a logika vagy az adattár modelljének megváltozásához kapcsolódik, és ezeknek a hibáknak több mint fele bonyolult.
A problémák kevesebb mint negyede kapcsolódik a feladatütemezőhöz, amelynek 18%-a egyszerű hiba.
Összességében a bekövetkezett hibák 22%-a bonyolult, ezek kijavítása a legnagyobb figyelmet és időt igényli. Ezek körülbelül hetente egyszer fordulnak elő, míg az egyszerű hibák szinte minden nap előfordulnak.
Nyilvánvaló, hogy az ETL folyamatok nyomon követése akkor lesz hatékony, ha a naplóban pontosan meg van jelölve a hiba helye és minimális időre van szükség a probléma forrásának felkutatásához.
Hatékony nyomon követés
Mit szeretnék látni az ETL nyomon követési folyamatában?
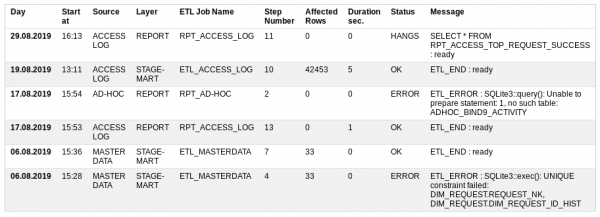
Start at — mikor kezdődött a munka,
Source — adatforrás,
Layer — melyik adattár szintet töltjük be,
ETL Job Name — az adatok betöltési eljárása, amely számos kisebb lépésből áll,
Step Number — az aktuálisan végrehajtott lépés száma,
Érintett sorok — mennyi adatot dolgoztak fel eddig,
Időtartam sec — mennyi ideig fut,
Állapot — vajon minden rendben van-e: OK, HIBA, FOLYAMATBAN, AKADÁLYOZVA
Üzenet — a legutolsó sikeres üzenet vagy hiba leírása.
A bejegyzések állapota alapján elektronikus levelet lehet küldeni más résztvevőknek. Ha nincsenek hibák, akkor a levél nem kötelező.
Így hiba esetén világosan meg van jelölve a baleset helye.
Néha előfordul, hogy magának a monitorozó eszköznek nem működik. Ilyen esetben közvetlenül az adatbázisban lehet megjeleníteni a nézetet, aminek alapján a jelentés készült.
ETL monitorozó táblázat
Az ETL folyamatok monitorozásához elegendő egy táblázat és egy nézet.
Ehhez vissza lehet térni a és prototípust készíteni SQLite adatbázisban.
Tábla DDL
CREATE TABLE UTL_JOB_STATUS (
/* Tábla a munkafolyamat végrehajtásának naplózására. Fontos, hogy a munkának legyenek ETL_START és ETL_END vagy ETL_ERROR lépései */
  UTL_JOB_STATUS_ID INTEGER NOT NULL PRIMARY KEY AUTOINCREMENT,
  SID               INTEGER NOT NULL DEFAULT -1, /* Munkamenet azonosító. Minden munka futása egyedi */
  LOG_DT            INTEGER NOT NULL DEFAULT 0,  /* Dátum idő */
  LOG_D             INTEGER NOT NULL DEFAULT 0,  /* Dátum */
  JOB_NAME          TEXT NOT NULL DEFAULT 'N/A', /* Munka neve, mint pl. JOB_STG2DM_GEO */
  STEP_NAME         TEXT NOT NULL DEFAULT 'N/A', /* ETL_START, ... , ETL_END/ETL_ERROR */
  STEP_DESCR        TEXT,                        /* Feladat vagy hibaüzenet leírása */
  UNIQUE (SID, JOB_NAME, STEP_NAME)
);
INSERT INTO UTL_JOB_STATUS (UTL_JOB_STATUS_ID) VALUES (-1);
DDL nézet/jelentés
LÉTREHOZÁS, HA NINCS UTL_JOB_STATUS_V
AKKOR 	/* Tartalom: Csomag végrehajtási napló az utolsó 3 hónapban. */
SRC KÍSÉRLET MAX(UTL_JOB_STATUS_ID) AS UTL_JOB_STATUS_ID,
	   MAX(START_FLAG) AS START_FLAG,
	   MAX(END_FLAG) AS END_FLAG,
	   MAX(ERROR_FLAG) AS ERROR_FLAG,
	   MIN(LOG_DT) AS MIN_LOG_DT,
	   MAX(LOG_DT) AS MAX_LOG_DT,
	   SUM(1) AS CNT,
	   SUM(IFNULL(AFFECTED_ROWS, 0)) AS AFFECTED_ROWS
  FROM SRC
  GROUP BY SID, SOURCE, LAYER, JOB_NAME
) JB,
( SELECT UTL_JOB_STATUS_ID, SID, JOB_NAME, STEP_LOG
  FROM SRC
  WHERE 1 = 1
) ERR
WHERE 1 = 1
AND JB.SID = ERR.SID
AND JB.JOB_NAME = ERR.JOB_NAME
AND JB.UTL_JOB_STATUS_ID = ERR.UTL_JOB_STATUS_ID
ORDER BY JB.MIN_LOG_DT DESC, JB.SID DESC, JB.SOURCE;
SQL Ellenőrzés a új munkamenet számának megszerzésére
VÁLASZ(AHOVÁ A LEGFONTOSABB LEGFONTOSABB KÜLÖN KIBÍRNI A LELÓT KÖVETÉSÉT IS A</ JOB_NAME IS NOT NULL ÉS A JOB_NAME IS NULL /* létezett munka véget ért */
    ÉS NEM ('y' IS TELJESÍTHETŐ NEM MÁS NEHÁNYMUSOROLVA MÁS PARAMÉTER TOVÁBBB * KÜNDN VÉGÉRE HATT A JOB_NAME ELVÉGZNI KELL MUNKÁT IS KÉRDEZNI A JOB_NAME, JOB_NAME LENK CÍM FELSZEG A VÉGEHHETY) AHOL A JOB_NAME A "RPT_ACCESS_LOG" /* munka nimi PARAMÉTER */
	    ÉS A STEP_NAME 'ETL_START'{ a JOB_NAME A 'RPT_ACCESS_LOG' /* munka név PARAMÉTER */
	    ÉS A STEP_NAME IN ('ETL_END', 'ETL_ERROR') /* megállási állapot */
    GROUP BY JOB_NAME, SID
) KEZDŐDŐ_JOB /* kezdet */
AZTÁN DE JOB_NAME A JOB_NAME ÉS A JOB_NAME A JOB_NAME
	 ÉS A JOB_NAME=T BEEK CSAK AZ ELSŐ KINEK A JOB_NAME A JOB_NAME ALAPJÁN MEG KENNE E GN JELEN FELETT TERMELT KÜLDÉS JÖJJÖN KÍSÉRLETI KÉFOGS IGAZOLÁS ÁLL A LELKET HATÁRMEGFONTOS MUNKÁT JÁTSZA VÁLASZ TOVÁBBA ;
A táblázat sajátosságai:
- Az adatok feldolgozási eljárásának kezdete és vége az ETL_START és ETL_END lépésekkel kell, hogy kísérje.
- Hiba esetén az ETL_ERROR lépésnek kell létrejönnie a hiba leírásával.
- A feldolgozott adatok számát ki kell emelni, például csillagokkal.
- Ugyanazt az eljárást egyszerre csak a force_restart=y paraméterrel lehet elindítani; enélkül a session az csak befejezett eljárások számára adható.
- Normál módban nem lehet párhuzamosan elindítani ugyanazt az adatok feldolgozási eljárást.
A táblával végzett szükséges műveletek a következők:
- az indítandó ETL eljárás session számának lekérdezése
- bejegyzés naplózása a táblába
- az utolsó sikeres ETL eljárás bejegyzésének lekérdezése
Az olyan adatbázisokban, mint például az Oracle vagy a Postgres, ezek a műveletek beépített funkciókkal valósíthatók meg. SQLite esetén külső mechanizmus szükséges, és ebben az esetben ez .
Következtetés
Így az adatok feldolgozásának hibáinak üzenetei rendkívül fontos szerepet játszanak. De nehéz őket optimálisnak nevezni a probléma okának gyors kereséséhez. Amikor az eljárások száma közelíti a százat, a folyamatok figyelése bonyolult projektté válik.
A cikkben bemutatjuk a probléma lehetséges megoldását egy prototípus formájában. A teljes prototípus, egy kis tároló, elérhető a gitlabon. .
Forrás: habr.com
