

A mai napon projektünkön a monolitikus kód mellett tucatnyi mikroszolgáltatás működik. Mindegyikük folyamatos figyelést igényel. Ekkora mennyiségben a DevOps mérnökök segítségével ez problémás. Kifejlesztettünk egy monitorozási rendszert, amely szolgáltatásként működik a fejlesztők számára. Ők maguk mérhetik be az adatokat a monitorozási rendszerbe, használhatják azokat, és alapjukra irányítják a dashboardokat, figyelmeztetéseket csatolhatnak hozzájuk, amelyek akkor aktiválódnak, amikor a küszöbértékek elérik. A DevOps mérnököknek – csak az infrastruktúra és a dokumentáció áll rendelkezésre.
Ez a bejegyzés a plenáris előadásomnak a a RIT++-on. Sokan kérték, hogy készítsünk szöveges változatokat az ott elhangzottakról. Ha részt vettél a konferencián vagy nézted a videót, nem találsz semmi újat. Mindenki másnak – üdvözöljük az alábbiakban. Elmondom, hogyan jutottunk el ehhez a rendszerhez, hogyan működik és hogyan tervezzük a frissítését.
A múlt: sémák és tervek
Hogyan jutottunk el a meglévő monitorozási rendszerhez? Ehhez vissza kell mennünk 2015-be. Így nézett ki akkor:
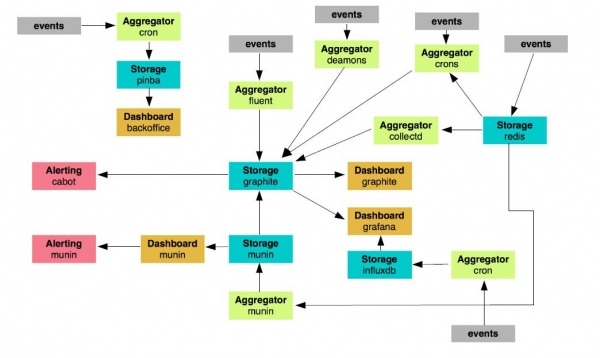
Körülbelül 24 csomópontunk volt, amelyek a monitorozásért feleltek. Itt egy egész halom különféle cron, szkript, démon működik, amelyek valamit itt-ott figyelnek, üzeneteket küldenek, funkciókat hajtanak végre. Arra gondoltunk, hogy minél tovább megyünk, annál kevésbé lesz életképes ez a rendszer. Fejleszteni nem érdemes: túl terjedelmes.
Úgy döntöttünk, hogy kiválasztjuk azokat a monitorozási elemeket, amelyeket megtartunk és fejlesztünk, valamint azokat, amelyekről lemondunk. Ezek száma 19 lett. Csak grafitok, aggregátorok és Grafana maradt fenn dashboardként. De hogyan fog kinézni az új rendszer? Így:
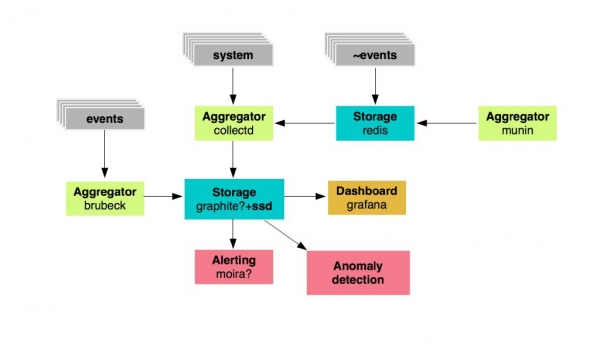
Van egy metrikai tárolónk: ez grafitok, amelyek gyors SSD-kre építkeznek, és bizonyos aggregátorok a metrikákhoz. Ezt követően – Grafana a dashboardok megjelenítéséhez és Moira figyelmeztetésként. Emellett egy anomáliakereső rendszert is szeretnénk kifejleszteni.
Szabvány: Monitorozás 2.0
Így néztek ki a tervek 2015-ben. De nemcsak az infrastruktúrát és magát a szolgáltatást kellett előkészítenünk, hanem a dokumentációt is. Kifejlesztettük a vállalati szabványunkat, amelyet Monitorozás 2.0 névre kereszteltünk. Mik voltak a követelmények a rendszerrel szemben?
- folyamatos rendelkezésre állás;
- a metrikák tárolási intervalluma = 10 másodperc;
- strukturált metrikák és dashboardok tárolása;
- SLA > 99,99%
- esemény metrikák gyűjtése UDP-n keresztül (!).
Szükségünk volt UDP-re, mivel nagy forgalmunk és eseményeink vannak, amelyek metrikákat generálnak. Ha mindet egyszerre írnánk a Graphite-ba, a tárolónk összeomlana. Emellett az első szintű prefixeket választottuk minden metrikához.
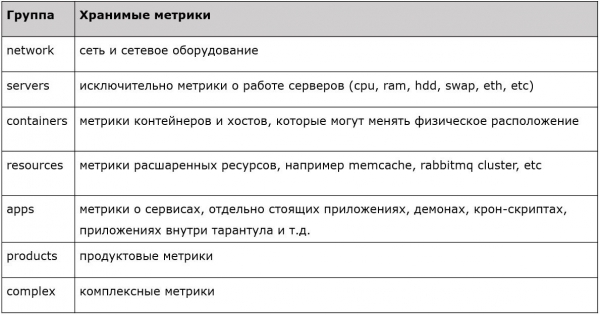
Minden prefix valamilyen jelleggel bír. Vannak metrikák a szerverek, hálózatok, konténerek, erőforrások, alkalmazások és így tovább vonatkozásában. Pontos, szigorú, tipizált szűrést valósítottunk meg, ahol az első szintű metrikákat fogadjuk, a többit pedig egyszerűen eldobjuk. Így terveztük meg ezt a rendszert 2015-ben. Mi a helyzet most?
A jelenlegi állapot: a monitoring komponensek közötti interakciós séma
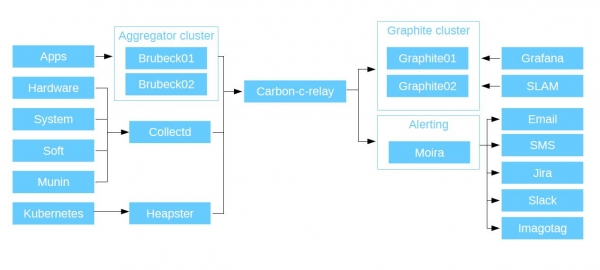
Elsősorban az alkalmazásokat monitoráljuk: a PHP kódunkat, az alkalmazásokat és a mikroszolgáltatásokat – mindent, amit a fejlesztőink írnak. Minden alkalmazás UDP-n keresztül küld metrikákat a Brubeck aggregator számára (statsd, amelyet C nyelven írtak át). Ez bizonyult a leggyorsabbnak a szintetikus tesztek eredményei alapján. Az aggregátor már aggregált metrikákat küld a Graphite-ba TCP-n keresztül.
Van egy olyan típusú metrikánk, mint a timer-ek. Ez nagyon kényelmes dolog. Például minden felhasználói kapcsolat esetén a szolgáltatással küld egy metrikát a Brubeck-nek a válaszidőről. Egymillió válasz érkezik, de az aggregátor csupán 10 metrikát ad ki. Így megvan a beérkezett látogatók száma, a maximális, minimális és átlagos válaszidő, a medián és 4 percentilis. Aztán az adatokat a Graphite-ba továbbítják, és mindezeket élőben látjuk.
Továbbá van aggregációnk a hardver, szoftver, rendszer metrikák és régi monitorozó rendszerünk, a Munin metrikáihoz (ez 2015-ig működött nálunk). Mindezt a CollectD C-s démon segítségével gyűjtjük (amelybe sokféle plugin van beépítve, képes lekérdezni azokat az erőforrásokat, amelyek a gazdagépen elérhetőek, csak állítsuk be a konfigurációt, hová írja az adatokat) és ezen keresztül írjuk az adatokat a Graphite-ba. Támogatja a python és shell script plugineket is, így saját egyedi megoldásokat is készíthet: a CollectD gyűjti az adatokat helyi vagy távoli gazdagépről (tegyük fel, létezik Curl) és elküldi őket a Graphite-ba.
A továbbiakban minden metrikkal, amelyet összegyűjtöttünk, a Carbon-c-relay-ba küldjük. Ez a Carbon Relay megoldás a Graphite-tól, C nyelven továbbfejlesztve. Ez egy router, amely összegyűjti az összes metrikkát, amelyet az aggregátorainkról küldünk, és azokat irányítja a node-okon. A routing szakaszában ellenőrzi a metrikák érvényességét. Először is, meg kell felelniük annak a séma előtagjainak, amelyet korábban bemutattam, és másodszor érvényesek a Graphite számára. Különben eldobják őket.
Ezután a Carbon-c-relay elküldi a metrikát a Graphite klaszterbe. Az alapértelmezett metrikatárolónk a Carbon-cache, amelyet Go nyelven írtunk át. A Go-carbon a párhuzamos feldolgozása miatt lényegesen felülmúlja a Carbon-cache teljesítményét. Az adatok megérkeznek, és a whisper csomag segítségével írják őket a lemezekre (ez a standard, Python nyelven íródott). Az adataink olvasásához a Graphite API-t használjuk. Ez sokkal gyorsabban működik, mint a standard Graphite WEB. Mi történik az adatokkal ezután?
Az adatok a Grafanába kerülnek. Az alapvető adatforrásunk a Graphite klaszterek, plusz van egy Grafana mint webes felület, amely megjeleníti a metrikat, és lehetővé teszi a dashboardok készítését. Minden szolgáltatásunk fejlesztői saját dashboardot hoznak létre. Ezután grafikonokat építenek rajtuk, amelyek megjelenítik az alkalmazásaikból írt metrikákat. A Grafana mellett van még SLAM is. Ez egy Python demon, amely az SLA-t számolja a Graphite-ból származó adatok alapján. Ahogy már említettem, több tucat mikroszolgáltatásunk van, mindegyiknek vannak saját követelményei. A SLAM segítségével megnézzük a dokumentációt, és összehasonlítjuk azt a meglévő Graphite-tal, hogy mennyire felelnek meg a követelmények a szolgáltatásaink elérhetőségének.
Folytassuk: az alerting. Ez egy erős rendszer, a Moira segítségével van megszervezve. Független, mert saját Graphite-jával rendelkezik. A SKB "Kontur" csapata fejlesztette ki, Pythonban és Go-ban íródott, teljesen nyílt forráskódú. A Moira ugyanazt az adatfolyamot kapja, mint ami a Graphite-ba megy. Ha valamilyen okból leáll a tároló, az alerting működni fog.
A Moira-t a Kubernetes-ben valósítottuk meg, mint a fő adatbázist, a Redis szerverek klaszterét használva. Így egy megbízható rendszer jött létre. Összehasonlítja a metrikaáramot a kiváltók listájával: ha nincs említés a listán, akkor eldobja a metrikát. Így képes percenként gigabyte metrikákat feldolgozni.
Ezen kívül csatoltuk a vállalati LDAP-ot, amellyel minden felhasználó a vállalati rendszerben értesítéseket hozhat létre a meglévő (vagy újonnan létrehozott) kiváltók alapján. Mivel a Moira tartalmazza a Graphite-ot, támogatja annak minden funkcióját. Először egy sort vesz, és bemásolja a Grafanába. Megnézi, hogyan jelennek meg az adatok a grafikonokon. Aztán ugyanezt a sort bemásolja a Moirába, korlátokkal látja el, és így kap éles figyelmeztetéseket. Ehhez nincs szüksége semmilyen speciális tudásra. A Moira képes értesíteni SMS-ben, emailben, Jirában, Slackben... Támogatja a testreszabott szkriptek végrehajtását is. Amikor egy kiváltó bekövetkezik, és a Moira írva van egy testreszabott szkriptre vagy bináris fájlra, elindítja azt, és a JSON-t stdin-ben átadja a binárisnak. Következésképpen a programjának ezt ki kell elemeznie. Hogy mit kezd a JSON-nal, az ön döntése.
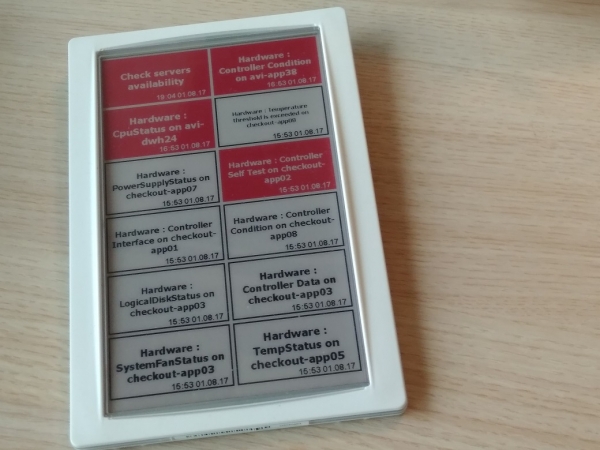
A figyelmeztetéshez egy saját fejlesztésű megoldást is használunk - Imagotag. Az üzletekben általában elektronikus árkijelzők számára alkalmazott panelt alakítottuk át a mi igényeink szerint. Kihoztuk rá a Moira kiváltóit. Ott feltüntetjük, hogy milyen állapotban vannak és mikor történt az esemény. A fejlesztő csapat egy része lemondott a Slack és email értesítésekről, ehelyett ezt a panelt használja.
Mint progresszív cég, a Kubernetes-t is monitoroztuk ebben a rendszerben. A Heapster segítségével integráltuk, amelyet a klaszterbe telepítettünk, ez összegyűjti az adatokat és elküldi őket a Graphite-nak. Ennek eredményeképpen a séma így néz ki:
Monitoring komponensek
Itt van a lista azokról a komponensekről, amelyeket ehhez a feladathoz használtunk. Mindegyik nyílt forráskódú.
Graphite:
- go-carbon:
- whisper:
- graphite-api:
Carbon-c-relay:
Brubeck:
Collectd:
Moira:
Grafana:
Heapster:
Statisztika
És itt van néhány szám arról, hogyan működik a rendszer nálunk.
Aggregator (brubeck)
Metrikák száma: ~ 300 000 / sec
Metrikák Graphite-ba küldésének intervalluma: 30 sec
A szerver erőforrás-használata: ~ 6% CPU (teljes értékű szerverekről van szó); ~ 1Gb RAM; ~ 3 Mbps LAN
Graphite (go-carbon)
Metrikák száma: ~ 1 600 000 / min
Metrikák frissítési intervalluma: 30 sec
Metrikák tárolási sémája: 30sec 35d, 5min 90d, 10min 365d (ez segít megérteni, mi történik a szolgáltatással hosszabb időszakok alatt)
A szerver erőforrás-használata: ~ 10% CPU; ~ 20Gb RAM; ~ 30 Mbps LAN
Rugalmasság
Mi az Avito-nál nagyon értékeljük a monitoring szolgáltatásunk rugalmasságát. Miért lett ilyen? Először is, az alkotóelemei kölcsönösen helyettesíthetők: mind az összetevők, mind a verzióik. Másodszor — karbantarthatóság. Mivel az egész projekt nyílt forráskódú, saját maguk módosíthatják a kódot, változásokat hozhatnak létre, megvalósíthatják azokat a funkciókat, amelyek dobozból nem állnak rendelkezésre. Elég elterjedt technológiai stack-eket használnak, főként Go-t és Python-t, így ez viszonylag egyszerűen kivitelezhető.
Íme egy például felmerült probléma. A metrika a Graphite-ban — ez egy fájl. Van egy neve. A fájl neve = a metrika neve. És van egy útvonal hozzá. A fájlnevek a Linux-ban 255 karakterre korlátozódnak. És nekünk van (mint 'belső megrendelők') egy csapat az adatbázis-értékesítési osztályból. Ők azt mondják nekünk: "Szeretnénk figyelemmel kísérni az SQL-lekérdezéseinket. És ezek nem 255 karakteresek, hanem 8 MB mindegyik. Szeretnénk, ha Grafanában láthatnánk ezeket a lekérdezéseket, látni szeretnénk a paramétereket, és ami még jobb, szeretnénk látni a legjobb ilyen lekérdezéseket. Jó lenne, ha valós időben megjelenhetnének. És igazán szuper lenne, ha ezen belül alerteket is be tudnánk állítani."
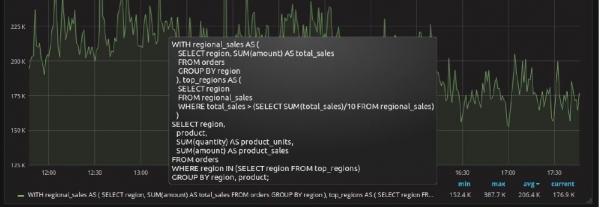
Az SQL lekérdezés példaként szerepel a következő címről
Felemeljük a Redis szervert a Collectd plugineinkkel, amelyek a Postgres-t keresik, és onnan összes adatot gyűjtenek, a metrikákat pedig Graphite-ba küldjük. Azonban a metrika nevét hash-ekre cseréljük. Ugyanezt a hash-t egyszerre küldjük a Redis-be kulcsként, és az egész SQL lekérdezést értékként. Annyit kell még megoldanunk, hogy a Grafana tudjon a Redis-be menni és ezeket az információkat megkapni. Megnyitjuk a Graphite API-t, mivel ez a fő interfész a monitorozó komponensek és a Graphite közötti interakcióhoz, és beleírunk egy új funkciót, amelyet aliasByHash()-nak nevezünk — a Grafana a metrika nevét megadja, és ezt kulcsként használjuk a Redis lekérdezésében, válaszként megkapjuk a kulcs értékét, ami a mi “SQL lekérdezésünk”. Így a Grafana-ban megjelenik az SQL lekérdezés, amelyet elvileg ott nem lehetett megjeleníteni, a hozzá kapcsolódó statisztikákkal (hívások, sorok, teljes idő, …).
Összegzés
Elérhetőség. Monitoring szolgáltatásunk 24/7 elérhető bármilyen alkalmazásból és bármilyen kódból. Ha hozzáférése van a tárolókhoz, akkor adatokat írhat a szolgáltatásba. A nyelv nem számít, a megoldások nem számítanak. Csak annyit kell tudnia, hogyan nyisson egy socket-et, dobja be oda a metrikát, és zárja be a socket-et.
Megbízhatóság. Minden komponens megbízható, és jól kezeli a terheléseinket.
Alacsony belépési küszöb. Ahhoz, hogy használni tudja ezt a rendszert, nem kell programozási nyelveket és Grafana lekérdezéseket tanulmányoznia. Egyszerűen nyissa meg az alkalmazását, írja be a socket-et, amely az adatokat a Graphite-ba küldi, zárja be, nyissa meg a Grafana-t, hozzon létre dashboardokat, és figyelje meg a metrikák viselkedését, értesítéseket kapva a Moira által.
Önállóság. Mind ezt meg lehet csinálni egyedül, DevOps mérnökök segítsége nélkül. Ez túlzás, mert most azonnal figyelheti a projektjét, senkit sem kell megkérdeznie - sem a munka megkezdése előtt, sem a változtatásokhoz.
Mire törekszünk?
Az alább felsoroltak nem csupán absztrakt gondolatok, hanem olyan célok, amelyekhez legalább az első lépéseket megtettük.
- Anomáliadetektor. Szeretnénk létrehozni egy szolgáltatást, amely a Graphite tárolóinkban jár, és minden metrikát különböző algoritmusok alapján ellenőriz. Már vannak olyan algoritmusok, amelyeket szeretnénk vizsgálni, vannak adatok, tudunk velük dolgozni.
- Metaadatok. Sok szolgáltatásunk van, amelyek idővel változnak, ahogyan azok is, akik velük dolgoznak. A dokumentáció kézi vezetése folyamatosan nem megoldás. Ezért most a mikroszolgáltatásainkba metaadatokat építünk be. Ezekben fel van tüntetve, ki fejlesztette, milyen nyelvekkel lép kapcsolatba, SLA követelmények, hova és kinek kell küldeni a értesítéseket. A szolgáltatás telepítésekor minden entitás adata automatikusan létrejön. Végül két linket kapsz - az egyik a triggerekről, a másik a Grafana műszerfalakról.
- Monitoring minden házhoz. Úgy gondoljuk, hogy egy ilyen rendszert minden fejlesztőnek használnia kell. Így mindig tudod, hol van a forgalmad, mi történik vele, hol esik le, hol vannak a gyenge pontjai. Ha véletlenül valami történik és összeomlik a szolgáltatásod, akkor erről nem a menedzsertől értesülsz telefonon, hanem egy riasztásból, és azonnal meg tudod nyitni a friss naplókat, és meg tudod nézni, mi történt.
- Magas teljesítmény. A projektünk folyamatosan növekszik, és ma körülbelül 2 000 000 metrikus értéket dolgoz fel percenként. Egy évvel ezelőtt ez a szám 500 000 volt. A növekedés folytatódik, és ez azt jelenti, hogy egy idő után a Graphite (whisper) nagyon meg fogja terhelni a lemez alrendszert. Ahogyan már mondtam, ez a monitoring rendszer meglehetősen univerzális, köszönhetően a komponensek kölcsönös helyettesíthetőségének. Valaki kifejezetten a Graphite-hoz karbantartja és folyamatosan bővíti az infrastruktúráját, de mi úgy döntöttünk, hogy más utat követünk: használni fogjuk mint a metrikáink tárolójaként. Ez az áttérés gyakorlatilag befejeződött, és hamarosan részletesebben is mesélek arról, hogyan történt: milyen nehézségekkel szembesültünk és hogyan oldottuk meg őket, hogyan zajlott a migrációs folyamat, leírom a választott komponenseket és azok konfigurációit.
Köszönöm a figyelmet! Kérdezzétek meg a témával kapcsolatban, próbálok itt vagy a következő posztokban válaszolni. Lehet, hogy valakinek van tapasztalata egy hasonló monitorozó rendszer kialakításával vagy a Clickhouse-ra való áttéréssel hasonló helyzetben - osszátok meg a hozzászólásokban.
Forrás: habr.com
