

Cégünk 2008 óta elsősorban infrastrukturális üzemeltetéssel és 24/7 technikai támogatással foglalkozik webprojektjeink számára: több mint 400 ügyfelünk van, ami Oroszország elektronikus kereskedelmének körülbelül 15%-át jelenti. Ennek megfelelően a támogatás terén nagyon változatos az architektúra. Ha valami leáll, 15 percen belül meg kell javítanunk. De ahhoz, hogy tudjuk, hogy baleset történt, figyelni kell a projektet és reagálni az incidensekre. De hogyan is tegyük ezt?
Úgy gondolom, hogy a megfelelő monitorozási rendszer kialakítása borzalmasan zajlik. Ha a baj nem lenne, a beszédem egyetlen tézisből állna: «Kérlek, telepítsd a Prometheus + Grafana-t és a 1, 2, 3-as plugineket». Sajnos ez már nem így működik. A legfőbb probléma az, hogy mindenki továbbra is hisz valamiben, ami 2008-ban létezett a szoftverkomponensek szempontjából.
A monitorozási rendszer kialakításával kapcsolatban kockáztatom azt mondani, hogy… olyan projektek, amelyek jól megtervezett monitorozással rendelkeznek, nem léteznek. A helyzet annyira rossz, hogy ha valami leáll, fennáll a kockázat, hogy ez észrevétlen marad – hiszen mindenki biztos benne, hogy «minden monitorozva van».
Lehetséges, hogy minden monitorozva van. De hogyan?
Mindannyian találkoztunk már a következő történettel: működik egy devops, egy admin, hozzájuk érkezik egy fejlesztőcsapat, és mondják – «kibocsátottuk, most monitorozd». Mit monitorozzunk? Hogyan működik ez?
Rendben. A régi módszerek szerint monitorozunk. De már minden változik, és kiderül, hogy te az A szolgáltatást monitoroztad, ami B szolgáltatássá változott, ami a C szolgáltatással lép kapcsolatba. De a fejlesztőcsapat azt mondja: «Telepítsd a szoftvert, annak mindent monitoroznia kell!»
Nos, mi változott? — Minden megváltozott!
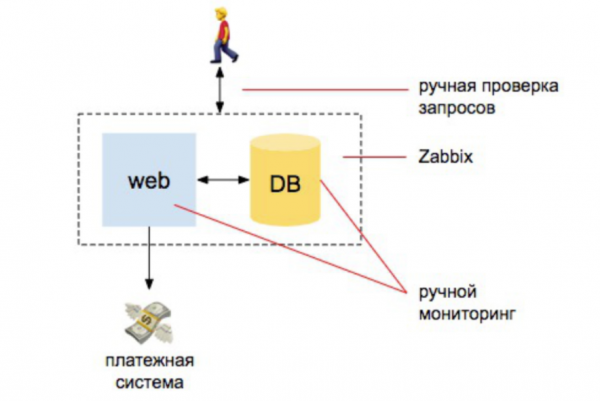
2008. Minden csodálatos.
Van néhány fejlesztő, egy szerver, egy DB szerver. Itt kezdődik minden. Van egy kis információnk, telepítjük a Zabbixot, Nagios-t, Cacti-t. Aztán beállítunk érthető riasztásokat a CPU-ra, a lemezek működésére, a lemezhelyre. Ezen kívül végezünk néhány manuális ellenőrzést, hogy a weboldal válaszol, hogy a rendelések eljutnak az adatbázisba. És ennyi – többé-kevésbé védettek vagyunk.
Ha összehasonlítjuk a munkamennyiséget, amelyet akkor az adminisztrátor végzett a monitoring biztosítása érdekében, akkor az 98%-ban automatikus volt: az a személy, aki a monitoringgal foglalkozik, meg kell értenie, hogyan kell telepíteni a Zabbixot, hogyan kell beállítani, és beállítani az riasztásokat. És 2% - az külső ellenőrzésekre: hogy a weboldal válaszol és lekérdezést végez az adatbázison, hogy új megrendelések érkeztek.
2010. év. Növekszik a terhelés.
Kezdjük skálázni a webeket, hozzáadunk egy keresőmotort. Biztosak akarunk lenni benne, hogy a termékkatalógus tartalmazza az összes terméket. És hogy a termékek keresése működik. Hogy az adatbázis működik, hogy a rendeléseket leadják, hogy a weboldal külsőleg válaszol és válaszol a kettőre. szerverek és a felhasználó nem lesz kidobva az oldalról, amíg át nem kerül egy másik szerverre, és így tovább. A lények száma nő.
Ami a legfontosabb, hogy az infrastruktúrához kapcsolódó entitás továbbra is a legnagyobb a menedzser fejében. Továbbra is ott van a fejében az ötlet, hogy a monitoringgal foglalkozó ember az, aki telepíti a Zabbixot és képes azt konfigurálni.
De közben új feladatok jelentkeznek a külső ellenőrzések elvégzése, a keresőindexelő lekérdezéseinek szkriptjeinek létrehozása, a szkriptek, amelyek ellenőrzik, hogy a keresés változik-e az indexelés során, és a szkriptek, amelyek ellenőrzik, hogy a termékek átadásra kerülnek a szállító szolgáltatásnak, stb.
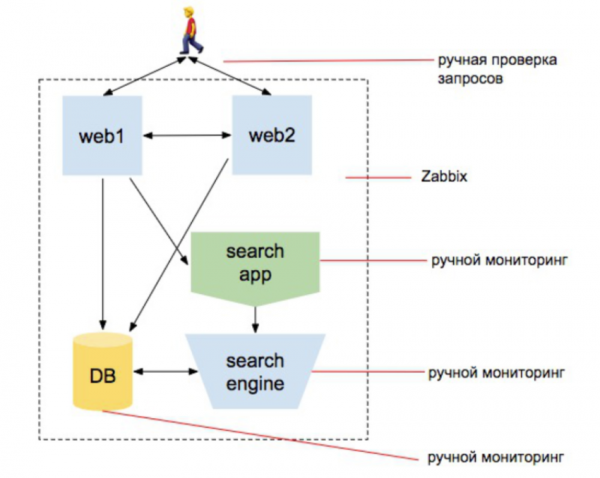
Vegye észre: háromszor írtam „szkriptek készlete”. Vagyis a monitoring felelőse már nem az, aki egyszerűen telepíti a Zabbixot. Ez az az ember, aki elkezd programozni. De a csapat fejében még mindig semmi sem változik.
De a világ változik, egyre bonyolultabbá válik. Hozzáadódik a virtualizációs réteg, több új rendszer. Kezdik egymással kölcsönhatásba lépni. Ki mondta, hogy „itt érződik a mikroszolgáltatások szaga?” De minden egyes szolgáltatás még mindig külön-külön úgy néz ki, mint egy weboldal. Hozzáférhetünk hozzá, és megérthetjük, hogy a szükséges információt biztosítja és önállóan működik. És ha te egy adminisztrátor vagy, aki folyamatosan foglalkozik egy projekttel, amely 5-7-10 éve fejlődik, akkor ezek a tudások felhalmozódnak: megjelenik egy új szint—te ezt tudatosítod, megjelenik egy másik szint—te ezt tudatosítod...
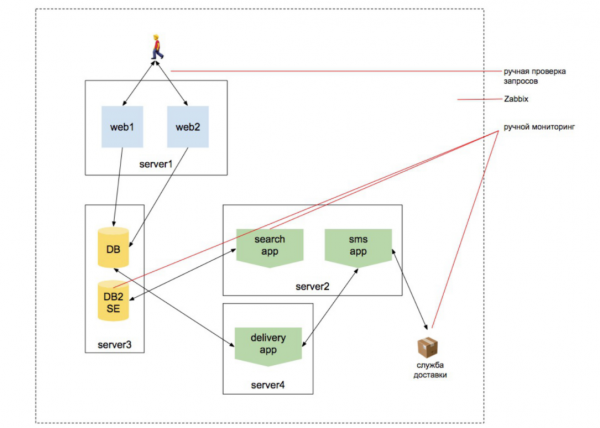
De ritkán kísér valaki egy projektet 10 évig.
Összegzés a monitoring szakembernek
Tegyük fel, hogy egy új startuphoz kerültél, amely azonnal 20 fejlesztőt szerzett, 15 mikroszervizt írt, és te vagy az admin, akinek azt mondják: „Kérlek, építs CI/CD-t.” Te pedig felépítetted a CI/CD-t, és hirtelen azt hallod: „Nehéz dolgoznunk a 'kockában' a termelési környezettel, mivel nem értjük, hogyan fog működni benne az alkalmazás. Készíts nekünk egy homokozót ugyanabban a 'kockában'.
Tehát elkészíted a homokozót ebben a kockában. Azonnal azt mondják: „Szeretnénk egy stage adatbázist, amely minden nap frissül a termelésből, hogy megértsük, működik az adatbázison, de közben ne rontsuk el a termelési adatbázist.”
Te is ebben élsz. Két hét van hátra a kiadásig, és azt mondják: „Most mindezt monitoroznunk kell...” Vagyis monitoroznunk kell a klaszter infrastruktúrát, monitoroznunk kell a mikroszerviz architektúrát, monitoroznunk kell a külső szolgáltatásokkal való munkát...
A kollégák előveszik a megszokott sémát, és azt mondják: „Hát ez mind érthető! Telepíts egy programot, amely mindezt monitorozza.” Igen, igen: Prometheus + Grafana + pluginek.
És hozzáteszik: „Két heted van, csináld meg úgy, hogy minden megbízható legyen.”
A sok projekten, amelyet látunk, a monitorozásra egy embert jelölnek ki. Képzeld el, hogy két hétre fel akarunk venni egy embert, aki a monitorozással foglalkozik, és készítünk neki egy önéletrajzot. Milyen képességekkel kell rendelkeznie ennek az embernek – figyelembe véve mindazt, amit eddig mondtunk?
- Értenie kell a monitorozást és a hardver infrastruktúra működésének sajátosságait.
- Értenie kell a Kubernetes monitorozásának sajátosságait (mert mindenki 'kockában' akar lenni, mert el lehet vonatkoztatni mindentől, és az admin a többi problémát megoldja) – annak infrastruktúráját, és tudnia kell, hogyan kell monitorozni az alkalmazásokat belül.
- Tudnia kell, hogy a szolgáltatások különleges módon kommunikálnak egymással, és ismernie kell a szolgáltatások közötti interakciós sajátosságokat. Teljesen el lehet képzelni egy projektet, ahol egyes szolgáltatások szinkronosan kommunikálnak, mert másként nem lehet. Például, a backend REST-en keresztül megy, a katalogizáló szolgáltatás gRPC-n keresztül, lekéri a termékek listáját és visszaküldi. Itt nem lehet várni. Más szolgáltatásokkal viszont aszinkron módon dolgozik. Rendelést átadni a szállító szolgáltatásnak, levelet küldeni stb.
Valószínűleg már elvesztetted a fonalat mindezt hallva? Az admin, akinek ezt monitoroznia kell, még inkább elveszhet. - Képesnek kell lennie tervezni és azt helyesen megtenni - mivel a munka egyre csak nő.
- Ezért ki kell dolgoznia egy stratégiát a létrehozott szolgáltatásra vonatkozóan, hogy megértse, hogyan kell ezt konkrétan monitorozni. Szüksége van a projekt architektúrájának és fejlődésének megértésére, valamint a fejlesztés során használt technológiák ismeretére.
Egy teljesen normális esetre emlékezzünk: néhány szolgáltatás PHP-n fut, néhány Go-n, néhány pedig JavaScript-en. Ezek valahogyan együtt működnek. Itt jött létre a "mikroszolgáltatás" kifejezés: annyira sok különálló rendszer lett, hogy a fejlesztők nem tudják megérteni a projektet összességében. A csapat egy része JavaScript-en írja a szolgáltatásokat, amelyek önállóan működnek, és nem tudják, hogyan működik a többi rendszer. A másik része Python-ban készít szolgáltatásokat, és nem foglalkozik a többi szolgáltatás működésével, ők izoláltak a saját területükön. A harmadik pedig PHP-val vagy más eszközökkel írja a szolgáltatásokat.
Ez a 20 ember 15 szolgáltatásra van felosztva, és mindössze egy adminisztrátor van, akinek mindezt meg kell értenie. Állj meg! Éppen most osztottuk fel a rendszert 15 mikroszolgáltatásra, mert 20 ember nem tudja megérteni az egész rendszert.
De valahogyan ezt monitorozni kell...
Mi a helyzet végül? Végül van egy ember, akinek a fejében összegyűlik minden, amit a fejlesztők egy egész csapata nem tud megérteni, és emellett még tudnia kell és képesnek kell lennie arra, amit fentebb megadtunk - a hardverinfrastruktúrát, a Kubernetes infrastruktúrát stb.
Mit is mondhatnék... Houston, problémáink vannak.
A modern programozási projekt monitorozása önálló programozási projekt.
A hamis bizalom miatt, hogy a monitorozás csak szoftver, csodákban kezdünk bízni. Pedig csodák sajnos nincsenek. Nem lehet Zabbix-ot beállítani és várni, hogy minden működjön. Nincs értelme Grafana-t beállítani és remélni, hogy minden rendben lesz. Az idő nagy részét a szolgáltatások működésének és egymással való kölcsönhatásának ellenőrzésére, valamint a külső rendszerek működésének ellenőrzésére fogjuk fordítani. Valójában az idő 90%-a nem a szkriptek írására, hanem a szoftverfejlesztésre fog menni. Ezt a fejlesztő csapatnak kell végeznie, aki érti a projekt működését.
Ha ebben a helyzetben egy embert ráállítanak a monitorozásra, akkor baj fog történni. Ami mindenhol meg is történik.
Például van néhány szolgáltatás, amelyek Kafka-n keresztül kommunikálnak egymással. Megérkezett egy rendelés, elküldtük a rendelésről szóló üzenetet a Kafka-ba. Van egy szolgáltatás, amely figyeli a rendelés információit és lebonyolítja az áru kiszállítását. Van egy másik szolgáltatás, amely figyeli a rendelés információit és elküldi a levelet a felhasználónak. Aztán jön még egy csomó szolgáltatás, és elkezdünk összezavarodni.
De ha ezt még az adminisztrátornak és a fejlesztőknek is odaajándékozod, amikor a kiadáshoz már csak rövid idő van hátra, akkor az illetőnek meg kell értenie az egész protokollt. Azaz egy ilyen volumenű projekt jelentős időt igényel, és ezt a rendszerszervezésnél figyelembe kell venni.
De nagyon gyakran, különösen a startupok esetében, látjuk, hogy a monitorozást elhalasztják. "Most megcsináljuk a Proof of Concept-et, elindítjuk, hagyjuk leállni — készen állunk áldozni. Aztán majd mindezt monitorozzuk." Amikor (vagy ha) a projekt elkezd pénzt hozni, a vállalkozás több funkciót akar fejleszteni — mert kezd működni, ezért tovább kell növelni! És ön egy olyan helyzetben van, ahol először az előzőt kell monitorozni, ami nem 1% időt igényel, hanem jelentősen többet. És egyébként a monitorozáshoz fejlesztőkre is szükség lesz, akiket könnyebb új funkciókra átcsoportosítani. Végül új funkciók íródnak, minden felhalmozódik, és ön egy végtelen holtponton találja magát.
Tehát hogyan lehet a projektet a kezdetektől monitorozni, és mit tegyünk, ha kapunk egy projektet, amit monitorozni kell, de nem tudjuk, hol kezdjük?
Először is, tervezni kell.
Egy kis eltérés: nagyon gyakran az infrastruktúra monitorozásával kezdik. Például van Kubernetesünk. Kezdjük azzal, hogy telepítjük a Prometheust a Grafanával, beállítjuk a "kubikus" monitorozás alpluginjeit. Nemcsak a fejlesztők, hanem az adminisztrátorok esetében is szomorú gyakorlat, hogy "telepítjük ezt a plugint, és a plugin valószínűleg tudja, hogyan kell ezt megtenni". Az emberek szeretik a könnyű és érthető dolgokkal kezdeni, nem pedig a fontos feladatokkal. És az infrastruktúra monitorozása éppen ilyen egyszerű.
Először is döntsön arról, hogy mit és hogyan szeretne monitorozni, majd válassza ki az eszközt, mert mások nem gondolkodhatnak helyette. És vajon kellene nekik? Mások magukról, egy univerzális rendszerre gondoltak — vagy egyáltalán nem gondoltak, amikor ezt a plugint írták. Az, hogy ennek a pluginak 5000 felhasználója van, nem jelenti, hogy bármilyen hasznot hoz. Lehet, hogy Ön lesz az 5001., csak azért, mert előtte már volt 5000 fő.
Ha elkezdte monitorozni az infrastruktúrát, és az alkalmazás backendje nem válaszol, akkor minden felhasználó elveszíti a kapcsolatot a mobilalkalmazással. Hibás üzenetek fognak megjelenni. Hozzá fognak jönni, és azt mondják: „Az alkalmazás nem működik, mit csinálnak itt?” — „Monitorozunk.” — „Hogyan monitorozhatnak, ha nem látják, hogy az alkalmazás nem működik?!"
- Úgy gondolom, hogy a monitorozást a felhasználó belépési pontján kell kezdeni. Ha a felhasználó nem látja, hogy az alkalmazás működik — ez már bukás. A monitorozó rendszernek erről kell elsőként értesítenie.
- Csak ezután tudjuk monitorozni az infrastruktúrát. Vagy párhuzamosan megtehetjük. Az infrastruktúra egyszerűbb — itt végre egyszerűen telepíthetjük a Zabbixot.
- Most a mobilalkalmazás gyökereihez kell mennünk, hogy megértsük, hol nem működik valami.
A legfontosabb gondolatom az, hogy a monitorozásnak párhuzamosan kell folynia a fejlesztési folyamattal. Ha leszakítja a monitorozó csapatot más feladatokra (CI/CD létrehozás, sandbox, infrastruktúra átszervezése), a monitorozás elmarad, és lehet, hogy soha többé nem éri utol a fejlesztést (vagy később le kell állítania azt).
Minden szinten
Így látom a monitorozási rendszer szervezését.
1) Alkalmazási szint:
- az alkalmazás üzleti logikájának monitorozása;
- a szolgáltatások health-metrikáinak monitorozása;
- integrációs monitorozás.
2) Infrastruktúra szint:
- az orkestráció szintjének monitorozása;
- a rendszer-szoftver monitorozása;
- a „hardver” szint monitorozása.
3) Ismét alkalmazási szint — de már mint mérnöki termék:
- az alkalmazás naplóinak gyűjtése és megfigyelése;
- APM;
- tracing.
4) Értesítési rendszer:
- értesítési rendszer szervezése;
- ügyeleti rendszer szervezése;
- a „tudásbázis” és az incidenskezelési workflow szervezése.
Fontos: az értesítésekhez nem akkor jutunk el, amikor már késő van, hanem azonnal! Nem kell megkezdeni a monitorozást, majd később kitalálni, hogy kinek küldjük az értesítéseket. A monitorozás célja, hogy megértsük, hol működik valami nem megfelelően a rendszerben, és értesítsük a megfelelő embereket. Ha ezt a végére hagyjuk, akkor a megfelelő emberek csak egy telefonhívásból tudják meg, hogy „nálunk semmi nem működik”.
Alkalmazásszint – üzleti logika monitorozás
Ez arról szól, hogy ellenőrizzük, hogy az alkalmazás működik-e a felhasználó számára.
Ezt a szintet a fejlesztési szakaszban kell létrehozni. Például van egy feltételes Prometheusunk: ő belép a szerverre, amely az ellenőrzéseket végzi, lekéri az endpoint-ot, és az endpoint ellenőrzi az API-t.
Amikor gyakran kérik, hogy monitorozzuk a főoldalt, hogy megbizonyosodjunk arról, hogy a weboldal működik, a programozók adnak egy kézigránátot, amit meg lehet húzni, amikor meg kell győződni arról, hogy az API működik. Közben a programozók még írják /api/test/helloworld.
Az egyetlen módja annak, hogy megbizonyosodjunk arról, hogy minden működik? – Nem!
- Az ilyen ellenőrzések létrehozása alapvetően a fejlesztők feladata. Az egységvizsgálatokat azoknak a programozóknak kell írniuk, akik a kódot írják. Mert ha ezt a rendszergazdára bízod: „Haver, itt van a 25 funkció API protokolljainak listája, kérlek, monitorozd mindet!” – akkor semmi nem fog működni.
- Ha csupán annyit csinálsz, hogy kiírsz egy print „hello world” feliratot, senki nem fogja tudni, hogy az API-nak működnie kellene, és tényleg működik. Minden API-változásnak együtt kell járnia az ellenőrzések megváltoztatásával.
- Ha már ilyen problémád van – állítsd le a funkciókat, és állíts be fejlesztőket, akik megírják ezeket az ellenőrzéseket, vagy békülj meg a veszteségekkel, és fogadd el, hogy semmi nem lesz ellenőrizve, és le fog szakadni.
Technikai tanácsok:
- Kötelező külső szervert létrehozni az ellenőrzések lebonyolításához – biztosnak kell lenned abban, hogy a projekted elérhető a külvilág számára.
- Ellenőrzést kell végezni az API protokoll teljes spektrumában, nem csupán az egyes endpoint-oknál.
- Hozz létre prometheus-endpoint-ot az ellenőrzések eredményeivel.
Alkalmazásszint – health-metrikák monitorozás
Most külső health-metrikákra vonatkozik a szó a szolgáltatások esetében.
Azt döntöttük, hogy az alkalmazás minden „kezelőjét” egy külső ellenőrzés segítségével figyeljük, amelyet egy külső monitorozó rendszerből hívunk meg. De ez tényleg csak azok a „kezelők”, amelyeket a felhasználó lát. Biztosak akarunk lenni abban, hogy a szolgáltatások maguk működnek. Itt a helyzet jobb: a K8s rendelkezik egészségügyi ellenőrzésekkel, hogy legalább maga a „kubus” megbizonyosodjon arról, hogy a szolgáltatás működik. De a legtöbb ellenőrzés, amit láttam, ugyanaz a „hello world” üzenet. Vagyis ezt egyszer meghívja a telepítés után, és ha azt válaszolják, hogy minden rendben van — vége. Aztán a szolgáltatás, amely REST-en keresztül adja ki az API-ját, sok bejárati ponttal rendelkezik az API-ban, amelyet szintén figyelni kell, mert tudni akarjuk, hogy működik. És ezt már belül monitorozzuk.
Hogyan lehet ezt technikailag helyesen megvalósítani: minden szolgáltatás kiad egy végpontot a működőképességéről, és a Grafana (vagy bármely más alkalmazás) grafikonjain látjuk az összes szolgáltatás állapotát.
- Minden API-változtatásnak meg kell hoznia a megfelelő ellenőrzéseket is.
- Új szolgáltatás létrehozásakor azonnal érdemes egészségügyi metrikákat beállítani.
- Az admin kérheti a fejlesztőktől, hogy „írjanak meg nekem néhány funkciót, hogy mindent megérthessek, és ezt az információt hozzáadhassam a monitorozó rendszeremhez”. De a fejlesztők általában azt válaszolják: „Két héttel a megjelenés előtt nem fogunk semmit kiegészíteni.”
Hagyni kell, hogy a fejlesztési menedzserek tudják, hogy lesznek ilyen veszteségek, és a fejlesztési menedzserek vezetősége is tudjon erről. Mert amikor minden leáll, valaki úgyis fel fog hívni és követelni fogja a „folyamatosan leálló szolgáltatás” monitorozását. - Egyébként érdemes fejlesztőket kijelölni a Grafana pluginek írására — ez jó segítség lesz az adminoknak.
Alkalmazási szint — Integrációs monitorozás
Az integrációs monitorozás a kritikus üzleti rendszerek közötti kommunikáció figyelésére összpontosít.
Például 15 szolgáltatás van, amelyek kommunikálnak egymással. Ezek már nem különálló webhelyek. Vagyis nem tudunk egy szolgáltatást önállóan hívni, hogy kapjunk egy /helloworld választ és megértsük, hogy a szolgáltatás működik. Mert a rendelési webszolgáltatásnak információt kell küldenie a rendelésről a buszra — a buszról a raktárkezelő szolgáltatásnak meg kell kapnia ezt az üzenetet és tovább kell dolgoznia vele. Az e-mail küldő szolgáltatásnak is e szerint kellene készülnie, és így tovább.
Ezért nem tudjuk megérteni, ha minden egyes szolgáltatásra kattintunk, hogy mindez hogyan működik. Mert van egy bizonyos busz, amelyen keresztül minden kommunikál és kölcsönhatásba lép egymással.
Ezért ennek a lépésnek a szolgáltatások más szolgáltatásokkal való interakciós tesztelését kell képviselnie. Nem lehet a közvetítő üzenetek megfigyelésével elérni a kommunikáció monitorozását. Ha van egy szolgáltatás, amely adatokat ad át, és egy másik szolgáltatás, amely azokat fogadja, a közvetítő megfigyelésénél csak azokat az adatokat fogjuk látni, amelyek oda-vissza repkednek. Még ha valahogy sikerül is a belső adatinterakció monitorozása — hogy egy bizonyos producer adatokat posztol, valaki olvassa azokat, és ez az áramlás folytatódik a Kafka-ban — ez sem fog információt adni nekünk, ha egy szolgáltatás egy verzióban adta át az üzenetet, a másik szolgáltatás pedig nem várta azt a verziót és elhanyagolta. Erről nem fogunk tudni, mert a szolgáltatások azt mondják, hogy minden rendben működik.
Ahogy javaslom:
- Szinchron kommunikációhoz: az endpoint lekérdezéseket végez a kapcsolódó szolgáltatásokhoz. Azaz, ezt az endpoint-ot vesszük, berántunk egy kis szkriptet a szolgáltatásba, amely végigmegy minden ponton és azt mondja: „ott tudok hívni, és ott tudok hívni, ott tudok hívni…”.
- Aszinchron kommunikációhoz: a bejövő üzenetek — az endpoint ellenőrzi a buszt teszt üzenetek meglétét illetően és kiadja a feldolgozás státuszát.
- Aszinchron kommunikációhoz: a kimenő üzenetek — az endpoint teszt üzeneteket küld a buszra.
Ahogy általában történik: van egy szolgáltatásunk, amely adatokat küld a buszra. Bemegyünk ebbe a szolgáltatásba, és megkérjük, hogy meséljen az integrációs egészségéről. És ha a szolgáltatásnak egy üzenetet kell előállítania valahova (WebApp), akkor ezt a teszt üzenetet előállítja. Ha pedig a rendelésfeldolgozás oldalon hívjuk meg a szolgáltatást, akkor először posztolja, amit függetlenül tud posztolni, és ha vannak függő dolgok — akkor olvassa a buszról a teszt üzeneteket, megérti, hogy ezt feldolgozhatja, erről jelentést ad, és ha szükséges, tovább posztolja őket, és erről mondja — minden rendben, élek.
Nagyon gyakran halljuk a kérdést: „Hogyan tudjuk ezt tesztelni éles adatokkal?” Például a rendelési szolgáltatásról van szó. A rendelés üzeneteket küld a raktárba, ahol a termékek lekerülnek a listáról: ezt nem tudjuk éles adatokkal tesztelni, mert „nekem a termékek lekerülnek a listáról!” A megoldás: a kezdeti szakaszban tervezzétek meg ezt a tesztet. Nektek vannak egységtesztjeitek, amelyek mock-okat készítenek. Tehát, készítsetek egy mélyebb szintű tesztet, ahol átmegy a kommunikációs csatorna, amely nem árt a vállalkozás működésének.
Infrastruktúra szint
Az infrastruktúra monitorozása már régóta alapvető monitorozásnak számít.
- Az infrastruktúra monitorozását el kell indítani egy külön folyamatként.
- Nem szabad az infrastruktúra monitorozásával kezdeni egy működő projektet, még akkor sem, ha nagyon szeretnénk. Ez minden devopsos számára fájdalmas terület. "Először a klasztert fogom monitorozni, az infrastruktúrát monitorozom" – azaz először azt, ami lent van, és nem nézek bele az alkalmazásba. Mert az alkalmazás — nem világos dolog a devops számára. Ezt átadták neki, és nem érti, hogyan működik. De az infrastruktúrával tisztában van, és azzal kezd. De nem — mindig először az alkalmazást kell monitorozni.
- Ne spóroljatok a figyelmeztetések számával. Figyelembe véve a modern rendszerek bonyolultságát, a riasztások folyamatosan érkeznek, és ezzel a riasztómennyiséggel valahogy meg kell élnünk. Az on-call személy, nézve a századik riasztást, eldöntheti, hogy „nem akarok erről gondolkodni”. A riasztásoknak csak a kritikus dolgokról kell értesíteniük.
Az alkalmazás szintje, mint üzleti egység
Kulcspontok:
- ELK. Ez ipari szabvány. Ha valamilyen okból nem aggregáljátok a logokat, sürgősen kezdjétek el ezt.
- APM. Külső APM-ek mint módja az alkalmazás monitorozásának gyors lezárására (NewRelic, BlackFire, Datadog). Ideiglenesen telepíthetitek ezt a dolgot, hogy legalább valamennyire megértsétek, mi történik veletek.
- Tracing. Tíz- vagy több mikroszolgáltatás esetén mindent nyomon kell követnetek, mert a kérés már nem él önállóan. Nagyon nehéz később hozzáadni, ezért jobb előre megtervezni a nyomozást a fejlesztés során – ez a fejlesztők munkája és eszköze. Ha még nem vezettétek be – vezessétek be! Lásd: Jaeger/Zipkin.
Riasztás
- Figyelmeztetési rendszer szervezése: a sok dolog monitorozásának körülményei között egy egységes értesítési rendszerre van szükség. Erre a Grafana is alkalmas. Nyugaton mindenki a PagerDuty-t használja. Az értesítéseknek érthetőnek kell lenniük (például, hogy honnan jöttek…). Ideális esetben ellenőrizni kell, hogy az értesítések valóban megérkeznek-e.
- Ügyeleti rendszer szervezése: az értesítések nem érkezhetnek mindenkinek (különben mindenki egyszerre reagál, vagy senki sem reagál). Az ügyeleti feladatokat a fejlesztőknek is el kell látnia: határozzák meg a felelősségi köröket, készítsenek egy világos útmutatót, amelyben pontosan rögzítik, hogy hétfőn és szerdán kinek kell hívnia, kinek pedig kedden és pénteken (különben senki sem fog hívni, még súlyos probléma esetén sem — félni fognak felébreszteni, zavarni: az emberek általában nem szeretnek másokat felébreszteni, különösen éjjel). És magyarázzák el, hogy a segítségkérés nem a nemtudás jele („ha segítséget kérek, akkor rossz munkatárs vagyok”), ösztönözzék a segítségkéréseket.
- A "tudásbázis" és az incidensfeldolgozási workflow szervezése: minden komoly incidens után posztmortem-t kell tervezni; az incidens megoldásához szükséges lépéseket ideiglenes intézkedésként rögzíteni kell. Be kell vezetni a gyakorlatot is, hogy a visszatérő értesítések bűn; ezeket ki kell javítani a kódban vagy az infrastruktúra munkálataiban.
Technológiai háttér
Tegyük fel, hogy a stack a következő:
- adatgyűjtés — Prometheus + Grafana;
- naplóelemzés — ELK;
- APM vagy Tracing — Jaeger (Zipkin).

A lehetőségek kiválasztása nem kritikus. Mert ha az elején megértetted, hogyan kell monitorozni a rendszert, és kidolgoztad a tervet, akkor már elkezdheted kiválasztani az eszközöket az igényeid szerint. A kérdés az, hogy mit választottál először monitorozni. Mert lehet, hogy az eszköz, amit elsőként választottál, egyáltalán nem felel meg az igényeidnek.
Néhány technikai szempont, amit mostanában mindenhol látok:
A Prometheust belerakják a Kubernetesbe — ki találta ezt ki!? Ha a klasztered leáll, mit fogsz csinálni? Ha bonyolult klasztered van, akkor működnie kell egy belső monitorozó rendszernek a klaszteren belül, és egy külsőnek, amely adatokat gyűjt a klaszteren kívülről.
A klaszteren belül gyűjtjük a naplókat és minden mást. De a monitoring rendszerének kívülről kell működnie. Nagyon gyakran olyan klaszterben, ahol a Prometheus belsőleg van telepítve, ott működnek olyan rendszerek is, amelyek külső ellenőrzéseket végeznek a weboldal működéséről. De mi történik, ha a külső világgal való kapcsolatok megszakadnak és az alkalmazás nem működik? Így bent minden rendben van, de a felhasználóknak nem könnyebb.
Következtetések
- A monitoring fejlesztése nem egyszerűen utilitások telepítése, hanem egy szoftvertermék fejlesztése. A mai monitoring 98%-a kódírás. Kódírás a szolgáltatásokban, kódírás a külső ellenőrzésekhez, külső szolgáltatások ellenőrzése, és minden egyéb.
- Ne sajnáljátok a fejlesztők idejét a monitoringra: ez akár a munkájuk 30%-át is elfoglalhatja, de megéri.
- DevOpsok, ne aggódjatok, ha nem sikerül mindent monitorozni, mert bizonyos dolgokhoz egészen más gondolkodásmód szükséges. Nem voltatok programozók, a monitoring munkája kifejezetten az övék.
- Ha a projekt már működik és nincs monitorozva (és ti menedzserek vagytok) — allokáljatok erőforrásokat a monitoringra.
- Ha a termék már élesben van, és ti devopsok vagytok, akiknek azt mondták, hogy "állítsátok be a monitoringot" — próbáljátok meg elmagyarázni a vezetőségnek, amiről mindezt írtam.
Ez a Saint Highload++ konferencián tartott előadás bővített változata.
Ha érdeklik az ötleteim és gondolataim az IT és ahhoz kapcsolódó témákról, akkor itt lehet A végén én, egy egyszerű szellemi munkás, váratlanul hős lettem ennek a menő csatornának a történetében!
Forrás: habr.com
