

Háttér
Vannak saját fejlesztésű automata gépeink. A belsejükben Raspberry Pi található, egy kis kiegészítő áramkörrel. Csatlakoztatva van érme- és bankjegyelfogadó, valamint bankkártya terminál... Mindent egy saját írású program vezérel. A működési történet egy MicroSD-flash-rekordon íródik, amelyet később interneten keresztül (USB-modem segítségével) a szerverre továbbítanak, ahol az adatbázisba kerül. Az értékesítési információk az 1c-be töltődnek, emellett van egy egyszerű webbeli felület a monitorozáshoz és hasonlókhoz.
Tehát a napló létfontosságú — a nyilvántartáshoz (ott az árbevétel, eladások stb.), a monitorozáshoz (különféle hibák és egyéb váratlan körülmények); ez gyakorlatilag az összes információ, amink van erről az automatáról.
Probléma
A flashmemóriák nagyon megbízhatatlan eszközöknek bizonyulnak. Tisztes rendszerességgel romlanak el. Ez leállásokhoz vezet, és ha valamilyen okból nem tudtuk online átadni a naplót, adatvesztést okoz.
Ez már nem az első tapasztalatunk a flashmemóriák használatával, korábban volt egy másik projektünk több mint száz eszközzel, ahol a napló USB-flashmemóriákon tárolódott, ott is voltak megbízhatósági problémák, időnként a hónap során tucatnyira nőtt a meghibásodások száma. Próbálkoztunk különböző flashmemóriákkal, köztük SLC memória alapú márkásakkal is; voltak modellek, amelyek megbízhatóbbak voltak, de a flashmemóriák cseréje nem oldotta meg a problémát gyökeresen.
Figyelem! Hosszú cikk! Ha nem érdeklik a „miért”-ek, csak a „hogyan”-ok, mehet is egyenesen cikkek.
Megoldás
Az első, ami eszembe jut: lemondani a MicroSD-ről, például SSD-t rakni helyette, és arról bootolni. Elméletileg lehetséges, gondolom, de viszonylag drága, és nem is annyira megbízható (USB-SATA adapter kerül az útba; az olcsóbb SSD-k meghibásodási statisztikája sem rózsás).
A USB HDD sem tűnik különösebben vonzó megoldásnak.
Ezért jutottunk arra a megoldásra, hogy megtartsuk a bootolást MicroSD-ről, de read-only üzemmódban használva, és a működési naplót (és egyéb, a konkrét hardverre jellemző információkat — sorozatszám, szenzorok kalibrálása stb.) máshol tároljuk.
A read-only fájlrendszer témája a Raspberry Pi esetében már alaposan ki lett dolgozva, ezen a cikken nem állok meg az implementáció részleteinél. (de ha érdekel, lehet, hogy írok egy mini-cikket erről a témáról). Az egyetlen dolog, amit érdemes megemlíteni: tanto a személyes tapasztalataim, mint a már implementált megbízhatóságról szóló vélemények alapján. Igen, teljesen megszabadulni a meghibásodásoktól lehetetlen, de a gyakoriságukat nagymértékben csökkenteni lehet. Ráadásul a kártyák egységesebbé válnak, ami jelentősen megkönnyíti a karbantartó személyzet számára a cserét.
Hardver rész
A memória típusa kiválasztása körül nem voltak különösebb kétségek — NOR Flash.
Argumentumok:
- egyszerű csatlakozás (általában SPI busz, aminek már van tapasztalatunk, így "hardveres" problémák nem várhatók);
- vicces ár;
- szabványos működési protokoll (a megvalósítás már megtalálható a Linux kernelében, igény esetén külső implementációkat is lehet találni, vagy akár sajátot is írhatunk, mivel minden egyszerű);
- megbízhatóság és élettartam:
a tipikus adatlapból: az adatok 20 évig tárolódnak, 100000 törlési ciklus minden blokkra;
külső forrásokból: rendkívül alacsony BER, állítják, hogy nincs szükség hibajavító kódokra (néhány dolgozat az ECC-t vizsgálja a NOR-ra, de általában MLC NOR-ra gondolnak, ilyen is van).
Tekintsük át a kapacitásra és a forrásra vonatkozó követelményeket.
Azt szeretném, ha garantáltan megőriznénk az adatokat néhány napig. Erre azért van szükség, hogy ha bármilyen probléma merülne fel a kommunikációval, az értékesítési történet ne vesszen el. 5 napra fogunk célozni, ezen időszak alatt (a hétvégéket és ünnepeket is figyelembe véve) megoldható a probléma.
Jelenleg egy nap alatt körülbelül 100kB napló keletkezik (3-4 ezer bejegyzés), azonban fokozatosan ez a szám növekszik — nő a részleteség, új események kerülnek hozzá. Plusz néha vannak csúcsok (valamilyen érzékelő elkezd hamis riasztásokat küldeni, például). Számoljunk 10 ezer bejegyzésre 100 byte-on — ez napi egy megabájt.
Így összesen 5MB tiszta (jól tömöríthető) adat keletkezik. Ehhez még (durva becslés) 1MB segédadat.
Tehát egy 8MB-os chipre van szükségünk, ha nem használunk tömörítést, vagy 4MB-ra, ha használunk. Teljesen reális számok ennek a memória típusnak.
Ami a forrást illeti: ha azt tervezzük, hogy a memóriát legfeljebb 5 naponként írjuk felül, tíz év szolgálat alatt kevesebb mint ezer újraírási ciklust kapunk.
Emlékeztetek, a gyártó százezer ciklust ígér.
Kicsit a NOR vs NAND-ról
Ma már természetesen sokkal népszerűbb a NAND memória, de ehhez a projekthez nem ajánlanám: a NAND a NOR-ral ellentétben mindenképpen hibajavító kódok, hibás blokktáblák stb. használatát igényli, és a NAND chipek pintjei általában sokkal többek.
A NOR hátrányai közé sorolhatók:
- kicsi kapacitás (ezért magas ár megabájtonként);
- nem túl gyors adatátvitel (többnyire a megszokott soros interfész, általában SPI vagy I2C miatt);
- lassú törlés (a blokk méretétől függően másodperctől néhány másodpercig terjed).
Úgy tűnik, hogy számunkra ez nem kritikus, így folytatjuk.
Ha a részletek érdeklik, a kiválasztott chip a (bár ez lényegtelen, a piacon rengeteg analóg létezik, amelyek az elrendezés és a parancsrendszer szempontjából kompatibilisek; még ha más gyártó chipjét vagy más kapacitásút is szeretnénk használni, akkor minden működik a kód módosítása nélkül).
A Linux kernelben beépített drivert használok, a Raspberry Pi-n a device tree overlay támogatásának köszönhetően nagyon egyszerű — a /boot/overlays mappába kell helyezni a lefordított overlayt és kicsit módosítani a /boot/config.txt-t.
DTS fájl példa
Őszintén szólva nem vagyok biztos benne, hogy hibátlan, de működik.
/*
 * Device tree overlay for at25 at spi0.1
 */

/dts-v1/;
/plugin/;

/ {
    compatible = "brcm,bcm2835", "brcm,bcm2836", "brcm,bcm2708", "brcm,bcm2709";

    /* disable spi-dev for spi0.1 */
    fragment@0 {
        target = <&spi0>;
        __overlay__ {
            status = "okay";
            spidev@1{
                status = "disabled";
            };
        };
    };

    /* the spi config of the at25 */
    fragment@1 {
        target = <&spi0>;
        __overlay__ {
            #address-cells = <1>;
            #size-cells = <0>;
            flash: m25p80@1 {
                    compatible = "atmel,at25df321a";
                    reg = <1>;
                    spi-max-frequency = <50000000>;

                    /* default to false:
                    m25p,fast-read ;
                    */
            };
        };
    };

    __overrides__ {
        spimaxfrequency = <&flash>,"spi-max-frequency:0";
        fastread = <&flash>,"m25p,fast-read?";
    };
};
És még egy sor a config.txt-ben
dtoverlay=at25:spimaxfrequency=50000000A chip Raspberry Pi-hez való csatlakozásának leírását most kihagyom. Egyrészt nem vagyok szakértő az elektronikában, másrészt ez számomra is banális: a chipnek összesen 8 lába van, amelyek közül a föld, tápegység és SPI (CS, SI, SO, SCK) szükséges; a szintek megegyeznek a Raspberry Pi szintjeivel, nem szükséges semmilyen kiegészítő kapcsolás — egyszerűen csak össze kell kötni a megadott 6 érintkezőt.
Lépjünk át a kitűzött feladatra: írjunk egy XDP mechanizmust SYN cookie-kkal.
Mint mindig, a feladat felállítása több iteráción megy át, és úgy érzem, itt az ideje egy újabbnak. Tehát álljunk meg, gyűjtsük össze, ami már készült, és tisztázzuk a még árnyékban maradt részleteket.
Tehát megállapítottuk, hogy a napló SPI NOR Flash-ben lesz tárolva.
Mi az a NOR Flash, akinek nem tudja?
Ez egy nem-energiához kötött memória, amellyel három műveletet lehet végezni:
- Olvasás:
A legegyszerűbb olvasás: megadjuk a címet, és annyi bájtot olvasunk, amennyire szükségünk van; - Írás:
A NOR flash write appears ordinary but has one feature: you can only change 1 to 0, not the other way around. For example, if we had 0x55 stored in a memory cell, after writing 0x0f to it, it would now hold 0x05. (see the table a bit below); - Erase:
Of course, we also need to perform the reverse operation — changing 0 to 1, and that's why the erase operation exists. Unlike the first two, it operates not on bytes but on blocks (the minimum erase block in the chosen chip is 4KB). Erase deletes the entire block, and this is the only way to change 0 to 1. Therefore, when working with flash memory, it often requires aligning data structures on the erase block boundary.
Writing to NOR Flash:
Binary data
Volt
01010101
Recorded
00001111
Lett
00000101
The journal itself represents a sequence of variable-length records. The typical record length is about 30 bytes (although sometimes records may be several kilobytes long). In this case, we treat them simply as a set of bytes, but, if interested, within the records, CBOR is used.
In addition to the journal, we need to store some 'setup' information, both updatable and non-updatable: a device ID, sensor calibration, a 'device temporarily turned off' flag, etc.
This information consists of key-value records, also stored in CBOR. We don't have much of this information (a maximum of a few kilobytes), and it is updated infrequently.
From now on, we will refer to it as context.
As a reminder of where this article started from, it is crucial to ensure data storage reliability and, if possible, uninterrupted operation even in the event of hardware failures/data corruption.
What sources of problems can we consider?
- Power loss during write/erase operations. This is in the category of 'there's no defense against a club'.
Information from stackexchange: during power loss while working with flash, both erase (setting to 1) and write (setting to 0) lead to undefined behavior: the data may be written, partially written (say, we transmitted 10 bytes/80 bits, but only 45 bits were successfully written), and it is also possible that some bits may end up in an 'intermediate' state (reading may yield either 0 or 1); - Flash memory errors.
BER, although very low, cannot be zero; - Bus errors
A SPI-n keresztül átvitt adatok nincsenek védve, így előfordulhatnak egyedi bit- vagy szinkronizálási hibák — bitek elvesztése vagy beszúrása (ami tömeges adateltérésekhez vezethet); - Egyéb hibák / zavarok
Hibák a kódban, Raspberry „bugok”, földönkívüli beavatkozások...
Összeállítottam azokat a követelményeket, amelyeknek, véleményem szerint, szükségesek a megbízhatóság biztosításához:
- az adatoknak azonnal a flash memóriába kell kerülniük, a késleltetett írást nem veszem figyelembe; - ha hiba lép fel, azt a lehető leghamarabb észlelni és kezelni kell; - a rendszernek lehetőség szerint helyre kell állítania a működést hibák után.
(életszerű példa arra, "hogyan ne legyen", amellyel, gondolom, mindenki találkozott: a vészhelyzeti újraindítás után "megromlott" a fájlrendszer, és a operációs rendszer nem indul el)
Ötletek, megközelítések, gondolatok
Amikor elkezdtem gondolkodni ezen a feladaton, rengeteg ötlet futott át az agyamon, például:
- adatok tömörítése;
- okos adatstruktúrák használata, például a rekordok fejlécének külön tárolása a maguk a rekordoktól, hogy hiba esetén a többit problémamentesen lehessen olvasni;
- bitmezők használata a rekord befejezettségének ellenőrzésére áramkimaradás esetén;
- ellenőrző összegek tárolása mindenen és mindenkoron;
- valamilyen zavarálló kódolás alkalmazása.
Ezek közül egyes ötletek megvalósultak, míg másoktól elálltunk. Nézzük sorban.
Adatok tömörítése
A naplóban rögzített események eléggé egységesek és megismétlődnek ("5 forintos érmét dobtunk fel", "megnyomtuk a visszaadás gombot", ...). Tehát a tömörítés valószínűleg eléggé hatékony lesz.
A tömörítés költségei elhanyagolhatóak (a processzorunk elég erős, még az első Pi-n is volt egy 700 MHz-es mag, a jelenlegi modelleken több mag is van, akár egy gigahertzes frekvenciával), a tárolóval való kommunikáció sebessége nem túl magas (több megabájt másodpercenként), a rekordok mérete kicsi. Összességében, ha a tömörítés hatással is lesz a teljesítményre, az csak pozitív lesz. (abszolút nem kritikus, csak megjegyzem). Plusz nekünk nem igazi embedded-ünk van, hanem egy szokványos Linux – így a megvalósításnak nem kell sok erőfeszítést igényelnie (elég csak a könyvtárat összekapcsolni és használni néhány funkciót belőle).
Egy működő eszköz logjának egy részét (1,7 MB, 70 ezer bejegyzés) vettük és először ellenőriztük a tömöríthetőséget a számítógépen elérhető gzip, lz4, lzop, bzip2, xz, zstd segítségével.
- A gzip, xz, zstd hasonló eredményeket mutattak (40 KB).
Meglepett, hogy a divatos xz itt a gzip vagy zstd szintjén teljesített; - Az lzip alapbeállításai kicsit gyengébb eredményt adtak;
- Az lz4 és lzop nem mutattak túlzottan jó eredményt (150 KB);
- A bzip2 meglepően jó eredményt mutatott (18 KB).
Tehát az adatok nagyon jól tömöríthetők.
Szóval (ha nem találunk fatális hibákat) a tömörítésnek lennie kell! Csak azért, mert több adat fér el ugyanarra a flash meghajtóra.
Gondolkodjunk a hátrányokról.
Az első probléma: már megállapodtunk abban, hogy minden bejegyzésnek azonnal a flashbe kell kerülnie. Általában az archiver addig gyűjti az adatokat a bemeneti áramlásból, amíg azt nem döntheti el, hogy ideje írni a kimenetre. Nekünk azonban azonnal meg kell kapnunk a tömörített adatblokkot, és el kell mentenünk az energiatároló memóriába.
Három utat látok:
- Minden bejegyzést szótári tömörítéssel tömöríteni a fenti algoritmusok helyett.
Teljesen működőképes lehetőség, de nem tetszik. A megfelelő szintű tömörítés biztosításához a szótárnak „be kell állítani” a konkrét adatokra, bármilyen módosítás katasztrofálisan csökkenti a tömörítési szintet. Igen, a probléma megoldható egy új szótárverzió létrehozásával, de ez fejfájást okoz – tárolnunk kell az összes szótárverziót; minden bejegyzésben jelölnünk kell, hogy melyik szótárverzióval lett tömörítve… - Minden bejegyzést „klasszikus” algoritmusokkal tömöríteni, de egymástól függetlenül.
A tárgyalt tömörítési algoritmusok nem úgy vannak optimalizálva, hogy ilyen méretű (több tucat bájt) bejegyzésekkel dolgozzanak, a tömörítési arány nyilvánvalóan 1 alatt lesz (azaz az adatok mennyiségének növekedése a tömörítés helyett); - Flush-t végezni minden bejegyzés után.
Sok tömörítési könyvtár támogatja a Flush-t. Ez egy parancs (vagy egy paraméter a tömörítési eljáráshoz), amely megadása után az archiver olyan tömörített áramlatot képez, hogy abból vissza lehessen állítani mindent azokat a tömörítetlen adatokat, amelyek már megkaptuk. Egy hasonlósyncfájlrendszerekben vagycommitsql-ben.
Fontos, hogy a következő tömörítési műveletek felhasználhatják a felhalmozott szótárt, és a tömörítési arány nem fog olyan mértékben szenvedni, mint az előző változatban.
Nyilvánvaló, hogy a harmadik lehetőséget választottam, álljunk meg ennél részletesebben.
Rátaláltak a FLUSH-ról a zlib-ben.
A cikk nyomán egy kóstolót készítettem, és 70 ezer bejegyzést vettem egy valódi eszköz naplójából, 60KB-os oldalmérettel. (az oldalméretre még visszatérünk) kaptam:
Forrásadatok
gzip tömörítés -9 (FLUSH nélkül)
zlib Z_PARTIAL_FLUSH-sal
zlib Z_SYNC_FLUSH-sal
Térfogat, KB
1692
40
352
604
Első pillantásra a FLUSH által hozott költség túl magasnak tűnhet, de valójában nem sok választásunk van - vagy egyáltalán nem tömörítünk, vagy hatékonyan tömörítünk a FLUSH használatával. Ne felejtsük el, hogy 70 ezer bejegyzésről van szó, a Z_PARTIAL_FLUSH által hozott többlet mindössze 4-5 bájt bejegyzésenként. A tömörítési arány pedig majdnem 5:1, ami kiváló eredménynek számít.
Meglepetésnek tűnhet, de a Z_SYNC_FLUSH valójában hatékonyabb módszer a FLUSH végrehajtására.
Z_SYNC_FLUSH használatakor minden bejegyzés utolsó 4 bájtja mindig 0x00, 0x00, 0xff, 0xff. Ha ezeket ismerjük, akkor nem kell tárolnunk őket, így a végső méret mindössze 324KB-ra csökken.
A cikkben, amelyre hivatkozom, található egy magyarázat:
Egy új 0-ás típusú blokk üres tartalommal kerül hozzáadásra.
A 0-ás típusú blokk üres tartalommal a következők alkotják:
- a hárombites blokk fejléc;
- 0-7 bit, amelyek nullák, a byte-igazítás elérése érdekében;
- a négybájtos sorozat 00 00 FF FF.
Nem nehéz észrevenni, hogy az utolsó blokk előtt ezek a 4 bájt előtt 3-10 nullás bit található. Azonban a gyakorlat azt mutatta, hogy a nullás bitek valójában legalább 10-et tesznek ki.
Kiderült, hogy az ilyen rövid adatblokkok általában (mindig?) 1-es típusú blokkal kódolva (fix blokk), amelynek mindig 7 nullás bitje van, így összességében 10-17 garantált nullás bitet kapunk (az egyéb bitek körülbelül 50%-os valószínűséggel lesznek nullák).
Tehát a tesztadatok alapján 100% -os valószínűséggel a 0x00, 0x00, 0xff, 0xff előtt egy nullás bájt áll, és több mint egyharmad esetén - két nullás bájt. (lehet, hogy az a probléma, hogy bináris CBOR-t használok, míg szöveges JSON használata esetén gyakrabban találkozhatunk a 2-es típusú blokkokkal - dinamikus blokk, így a 0x00, 0x00, 0xff, 0xff előtt kevesebb nullás bájt lenne).
Összességében a meglévő tesztadatok alapján kevesebb mint 250KB tömörített adatot lehet elérni.
Még mindig lehet spórolni egy kicsit, ha a bitek zsonglőrködésével foglalkozunk: jelenleg figyelmen kívül hagyjuk a blokk végén lévő néhány nullás bitet, és a blokk elején lévő néhány bit sem változik...
De itt hoztam egy erősebb döntést, hogy megálljak, különben ilyen ütemben eljutok a saját archiváló programom fejlesztéséig.
Összességében a tesztadataimból 3-4 byte-ot kaptam írás közben, a tömörítési arány több mint 6:1 lett. Őszintén mondom: nem is számítottam ilyen eredményre, véleményem szerint minden, ami jobb mint 2:1 — már egy olyan eredmény, ami indokolja a tömörítés használatát.
Minden remek, de a zlib (deflate) — mégis egy régimódi, elismert és kicsit elavult tömörítő algoritmus. Már a tény, hogy a szótár a legutolsó 32KB nem tömörített adatból készül, ma már furcsának tűnik (tehát ha egy adatblokk nagyon hasonlít arra, ami 40KB-al ezelőtt volt a bemeneti áramlásban, akkor újra archiválódik, nem hivatkozik a múltbéli előfordulásra). A modern archiváló programok esetében a szótár méretét gyakrabban mérik megabájtokban, nem kilobájtokban.
Tehát folytatjuk a mini-kutatásunkat az archiválókról.
A következőként a bzip2-t próbáltuk ki (emlékeztetnék, FLUSH nélkül fantasztikus tömörítési arányt mutatott, majdnem 100:1). Sajnos, FLUSH használatával nagyon gyengén teljesített, a tömörített adatok mérete nagyobb lett, mint a nem tömörítettek.
Feltételezéseim a kudarc okairól
A Libbz2 csupán egy flush lehetőséget kínál, amely úgy tűnik, hogy törli a szótárat (analógia a zlib Z_FULL_FLUSH-éval), itt már nem lehet beszélni hatékony tömörítésről.
Végül a zstd-t próbáltam ki. A paramétereitől függően ugyanolyan szinten tömörít, mint a gzip, de sokkal gyorsabban, vagy pedig jobban, mint a gzip.
Sajnos, FLUSH-dsal ő is 'nem túl jól' teljesített: a tömörített adatok mérete körülbelül 700KB lett.
Én a projekt github oldalán, ahol választ kaptam, hogy érdemes számítani 10 byte szolgáltatási adat meglétére minden egyes tömörített adatblokknál, ami közel van a kapott eredményekhez, a deflate-ot utolérni nem fog sikerülni.
Ezen a ponton úgy döntöttem, hogy befejezem a kísérletezést az archiválókkal (emlékeztetnék, az xz, lzip, lzo, lz4 teszteléskor FLUSH nélkül nem teljesítettek jól, és nem néztem meg a különösen egzotikus tömörítési algoritmusokat).
Visszatérünk az archiválás problémáihoz.
A második probléma – ahogy a sorrendre utalunk, nem pedig a jelentésre – az, hogy a tömörített adatok egy egységes folyamot képviselnek, amelyben folyamatosan utalások találhatók az előző részekre. Így, ha a tömörített adatok valamelyik szakasza megsérül, nemcsak a hozzá kapcsolódó tömörítetlen adatok blokkja vész el, hanem az összes következő is.
Két megközelítés létezik a probléma megoldására:
- A probléma megjelenésének megakadályozása – redundanciát adni a tömörített adatokhoz, ami lehetővé teszi a hibák azonosítását és javítását; erről később beszélünk;
- Minimalizálni a következményeket, ha a probléma felmerül
Korábban beszéltünk róla, hogy minden adatblokkot függetlenül tömöríthetünk, így a probléma magától megoldódik (egy blokk adatainak sérülése csak ennek a blokknak az adatait érinti). Azonban ez szélsőséges eset, amikor a tömörítés hatékonysága csökken. Az ellentétes szélsőség: a 4MB-os chipünket egyetlen archívumként használni, ami kiváló tömörítést ad, de katasztrofális következményekkel jár adatvesztés esetén.
Igen, kompromisszumra van szükség a megbízhatóság szemszögéből. De emlékeznünk kell arra, hogy az energiatartós memória adatformátumát fejlesztjük, amely rendkívül alacsony BER-ral és 20 éves tárolási idővel rendelkezik.
Kísérleteim során felfedeztem, hogy a tömörítési szintnél lényeges veszteségek a 10Kb-nál kisebb tömörített adatok blokkjainál kezdődnek.
Korábban említettem, hogy a használt memória lapos szervezésű, nem látok okot, amiért ne használhatnánk az "egy lap – egy tömörített adatblokk" megfelelést.
Tehát a minimális ésszerű lapméret 16Kb (a segédinformációkra is tartalékkal). Azonban ilyen kicsi lapméret jelentős korlátozásokat jelent a maximális rekordméretre nézve.
Bár jelenleg nem tervezek egynél nagyobb rekordokat kilobájt tömörítésben, úgy döntöttem, hogy 32Kb-os lapokat használok (összesen 128 lap a chipre).
Összefoglalva:
- Az adatokat zlib segítségével tömörítve tároljuk (deflate);
- Minden rekordhoz Z_SYNC_FLUSH-t állítunk be;
- Minden tömörített rekord végéről levágjuk a végső biteket (például 0x00, 0x00, 0xff, 0xff); a fejlécben megadjuk, hány byte-ot vágtunk le;
- Az adatokat 32 KB-os lapokban tároljuk; a lapokon belül egyetlen tömörített adatfolyam halad; minden lapnál újraindítjuk a tömörítést.
Mielőtt befejeznénk a tömörítést, érdemes megemlíteni, hogy a tömörített adatokból csak néhány bájtot kapunk íráskor, ezért rendkívül fontos, hogy ne növeljük meg a segédadatokat, hiszen minden egyes bájt számít.
Adatfejlécek tárolása
Mivel a bejegyzéseink változó hosszúságúak, szükségünk van arra, hogy valamilyen módon meghatározzuk a bejegyzések elhelyezkedését/határait.
Három megközelítést ismerek:
- Minden bejegyzést egy folyamatos adatfolyamban tárolunk, először a bejegyzés fejlécét, amely a hosszúságot tartalmazza, majd magát a bejegyzést.
Ebben a változatban mind a fejek, mind az adatok változó hosszúságúak lehetnek.
Alapvetően egy láncolt lista alakul ki, amelyet szinte mindenütt használnak; - A fejek és maguk a bejegyzések külön folyamatokban vannak tárolva.
Állandó hosszúságú fejek használatával elérjük, hogy az egyetlen fej megsérülése ne befolyásolja a többit.
Hasonló megközelítést alkalmaznak például számos fájlrendszerben; - A bejegyzéseket egy folyamatos adatfolyamban tárolják, a bejegyzés határát egy bizonyos jelölő (szimbólum/szimbólumok sorozat, amely a blokkok belsejében tilos) határozza meg. Ha a bejegyzésen belül megjelenik egy jelölő, akkor azt átkonvertáljuk egy bizonyos sorozatra (escape eljárás).
Hasonló megközelítést alkalmaznak például a PPP protokollban.
Illusztrálom.
1. lehetőség:
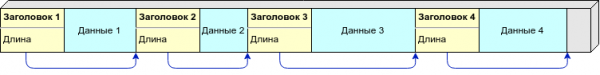
Itt minden nagyon egyszerű: tudva a bejegyzés hosszát, kiszámíthatjuk a következő fejléc címét. Így mozogva haladunk a fejek között, amíg el nem érjük a 0xff-tel kitöltött területet (szabad terület) vagy az oldal végét.
2. lehetőség:
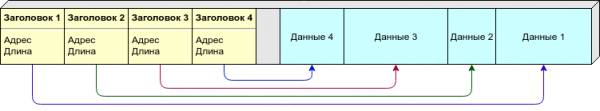
A bejegyzések változó hossza miatt előre nem tudhatjuk meg, hogy hány bejegyzésre (vagyis fejlécre) lesz szükség az oldalra. Lehet, hogy a fejeket és az adatokat külön oldalakra szétosztjuk, de nekem egy másik megközelítés tetszik jobban: mind a fejeket, mind az adatokat egy oldalon helyezük el, de a fejek (állandó méretűek) az oldal elejétől, míg az adatok (változó hosszúságúak) az oldal végéről kezdődnek. Amint „találkoznak” (ha a szabad hely nem elegendő egy új bejegyzéshez) — az oldalt teljesnek tekintjük.
3. lehetőség:

Itt nincs szükség arra, hogy a fejlécben tároljuk az adatok hosszát vagy más információt a helymeghatározásról, elegendő a bejegyzések határait jelző jelölőkkel rendelkezni. Azonban az adatokat feldolgozni kell íráskor/olvasáskor.
Jelölőként a 0xff-et használnám (amellyel az oldal kitöltve van az erase után), így a szabad terület biztosan nem lesz adatként értelmezve.
Összehasonlító táblázat:
1. lehetőség
2. lehetőség
3. lehetőség
Hibaellenállás
—
+
+
Kompatibilitás
+
—
+
Megvalósítás bonyolultsága
*
**
**
Az 1. variánsnak van egy végzetes hátránya: ha bármelyik fejléc sérül, akkor az összes további lánc tönkremegy. A többi variáns lehetővé teszi, hogy részben helyreállítsuk az adatokat, még tömeges sérülések esetén is.
De itt érdemes megemlíteni, hogy úgy döntöttünk, hogy az adatokat tömörített formában tároljuk, ezért úgyis elveszítjük az összes adatot az oldalon a "hibás" bejegyzés után, így bár a táblázatban mínusz áll, mi ezt nem vesszük figyelembe.
Kompatibilitás:
- az első variánsnál csak a hosszúságot kell a fejlécben tárolnunk, ha változó hosszúságú egész számokat használunk, akkor a legtöbb esetben egy bájttal is beérhetjük;
- a második variánsnál az induló címet és a hosszúságot kell tárolnunk; a bejegyzésnek állandó méretűnek kell lennie, amit 4 bájtra becsülök a bejegyzésre (két bájt a eltolásra, és két bájt a hosszúságra);
- a harmadik variánsnak elegendő egyetlen karakter a bejegyzés kezdetének jelölésére, plusz a bejegyzés a szökőjelezés miatt 1–2%-kal megnő. Összességében körülbelül az első variánssal azonos hatékonysággal bír.
Kezdetben a második variánst alapértelmezettként tekintettem (sőt, még a megvalósítást is megírtam). Csak akkor mondtam le róla, amikor véglegosan úgy döntöttem, hogy tömörítést használok.
Lehet, hogy egyszer mégis használni fogom ezt a variánst. Például, ha az űrhajó adatait kellene tárolnom, amely a Föld és Mars között közlekedik – egészen más megbízhatósági követelmények, űrbeli sugárzás, …
Ami a harmadik variánt illeti: két csillagot adtam neki a megvalósítás bonyolultsága miatt, egyszerűen azért, mert nem szeretem a szökőjelezéssel, a hosszúság változtatásával stb. bajlódni. Igen, lehet, hogy elfogult vagyok, de nekem kell a kódot írnom – miért kényszerítsem magam olyan dolgokra, amiket nem szeretek.
Összefoglalva: a "fejléc hosszúsága - változó hosszúságú adatok" láncok formájában történő tárolást választjuk, a hatékonyság és a megvalósítás egyszerűsége miatt.
A bit field usage for tracking the success of write operations.
I can't quite remember where I got the idea, but it looks something like this:
For each record, we allocate several bits to store flags.
As we mentioned earlier, after erase all bits are set to 1, and we can change 1 to 0, but not the other way around. So, for 'flag not set' we use 1, for 'flag set' — 0.
Here's how storing a variable length record in flash might look:
- Set the flag 'length recording has started';
- Record the length;
- Set the flag 'data recording has started';
- Record the data;
- Set the flag 'recording has ended'.
In addition, we'll have a flag 'an error occurred', totaling 4 bit flags.
In this case, we have two stable states '1111' — recording has not started and '1000' — recording was successful; in case of an unexpected interruption of the recording process, we will obtain intermediate states, which we can later detect and handle.
The approach is interesting, but it only protects against sudden power loss and similar failures, which is certainly important, but it's far from the only (and not even the main) reason for potential failures.
Összefoglalva: Let's move forward in search of a good solution.
Checksums
Checksums also allow us to ensure (with sufficient probability) that we are reading exactly what should have been written. And, unlike the bit fields discussed above, they work all the time.
If we consider the list of potential sources of problems that we discussed earlier, checksums can detect an error regardless of its origin (except, perhaps, for malicious aliens — they can forge a checksum too).
So, if our goal is to check that the data is intact, checksums are an excellent idea.
The choice of checksum algorithm was not questioned — CRC. On one hand, the mathematical properties allow us to catch certain types of errors 100%, on the other — with random data, this algorithm usually shows a collision probability not much greater than the theoretical limit.  Bár ez nem a leggyorsabb algoritmus, és nem mindig a legminimálisabb a ütközések számát tekintve, de van egy nagyon fontos tulajdonsága: az általam látott tesztek során nem találkoztam olyan mintázatokkal, ahol nyilvánvalóan megbukott volna. A stabilitás a legfontosabb jellemző ebben az esetben.
Kiterjedt kutatás példája: , (linkek a narod.ru, elnézést).
A checksum kiválasztásának feladata azonban még mindig nem zárult le, a CRC egy egész család ellenőrző összeg. Meg kell határoznunk a hosszúságot, majd választanunk kell egy polinomot.
A checksum hosszának kiválasztása nem olyan egyszerű kérdés, mint amilyennek első pillantásra tűnik.
Példával illusztrálom:
Legyen a hibák valószínűsége minden egyes bájtban  és ideális checksum, számoljuk ki az átlagos hibák számát egymillió rekordra:
Adatok, bájt
Ellenőrző összeg, bájt
Felfedezetlen hibák
Hamis hibafelismerések
Összesen téves riasztások
1
0
1000
0
1000
1
1
4
999
1003
1
2
≈0
1997
1997
1
4
≈0
3990
3990
10
0
9955
0
9955
10
1
39
990
1029
10
2
≈0
1979
1979
10
4
≈0
3954
3954
1000
0
632305
0
632305
1000
1
2470
368
2838
1000
2
10
735
745
1000
4
≈0
1469
1469
Azt gondolnánk, hogy minden egyszerű — válasszuk a védett adatok hosszúságának megfelelő checksumot a lehető legkevesebb téves riasztás érdekében — és kész.
Azonban a rövid checksumokkal problémák merülnek fel: bár jól észlelik az egybites hibákat, viszonylag nagy valószínűséggel tévesen hitelesíthetnek teljesen véletlenszerű adatokat. A Habrán már volt egy cikk, amely leírta .
Ezért annak érdekében, hogy a checksum véletlenszerű ütközése gyakorlatilag lehetetlenné váljon, 32 bit hosszúságú és azt meghaladó checksumokat kell használni (a 64 bitnél hosszabbakhoz általában kriptográfiai hash-funkciókat alkalmaznak).
Annak ellenére, hogy korábban írtam, hogy mindent meg kell tennünk a helyet megtakarítva, mégis, használni fogunk egy 32 bites checksumot (a 16 bit kevés, a ütközés valószínűsége több mint 0,01%; és a 24 bit, ahogy mondják, se ide, se oda).
Itt felmerülhet egy ellenérv: valóban azért spóroltunk meg minden bájt alatt, hogy most 4 bájt hirtelen átadjunk? Nem lenne jobb nem tömöríteni és nem hozzáadni a checksumot? Természetesen nem, a tömörítés hiánya nem jelenti, hogy az integritás ellenőrzésére nincs szükség.
A polinom kiválasztásánál nem kell feltalálni a kereket, hanem vesszük a jelenleg népszerű CRC-32C-t.
Ez a kód 6 bites hibát észlel a 22 bájtos csomagokban (talán a leggyakoribb eset számunkra), 4 bites hibát a 655 bájtos csomagokban (szintén gyakori eset számunkra), 2 vagy bármilyen páratlan számú bites hibát pedig bármilyen ésszerű hosszúságú csomagokban.
Ha valakit érdekelnek a részletek
a CRC-ről.
Gyorsan emlékezzünk vissza, hogyan működik a moduláris aritmetika. Az óra már egy ismert koncepció. Az órák használata — talán a világ legfőbb CRC szakértője.
A tartalmaz , amely valamivel jobb paramétereket biztosít az általunk aktuális csomaghosszokhoz, de nem tartottam a különbséget lényegesnek, és magamat elég kompetensnek ahhoz, hogy egy egyedi kódot válasszak a standard és jól kutatott helyett.
Továbbá, mivel az adataink tömörítettek, felmerül a kérdés: a tömörített vagy a tömörítetlen adatokra számítsuk a checksumot?
Az érvek a tömörítetlen adatok checksum számítása mellett:
- végső soron az adatmegőrzés épségét kell ellenőriznünk — ezt közvetlenül is ellenőrizzük (ezzel együtt ellenőrizve lesznek a tömörítés/dekódolás megvalósításainak esetleges hibái, a hibás memória okozta károk stb.);
- az algoritmus a zlib-ben elég érett megvalósítással bír, és nem kell összeomlania a „törött” bemeneti adatoknál, sőt, gyakran képes önállóan észlelni a bemeneti áramlásban lévő hibákat, csökkentve a hiba észlelésének általános valószínűségét (elvégeztem egy tesztet, ahol egyetlen bitet inverzáltam egy rövid felvételben, a zlib a hibát körülbelül a harmadik esetben észlelte).
Az érvek a tömörítetlen adatok checksum számítása ellen:
- A CRC kifejezetten a ritka bites hibákra van hangolva, amelyek jellemzőek a flash memóriára (a tömörített áramlásban lévő bites hiba tömeges kimeneti átalakulást okozhat, amely elméletileg „ütközést” okozhat);
- nem igazán tetszik az ötlet, hogy a dekódolónak potenciálisan hibás adatokat adjak át, , hogyan fog reagálni.
Ebben a projektben úgy döntöttem, hogy eltávolodom a hagyományos gyakorlatoktól, miszerint a tömörítetlen adatok checksumát tárolnánk.
Összefoglalva: a CRC-32C-t használjuk, a checksumot az adatok azon formájára számítjuk, ahogyan azokat a flash memóriába rögzítjük (tömörítés után).
Túlzott redundancia
A redundáns kódolás használata természetesen nem zárja ki az adatok elvesztését, azonban jelentősen (gyakran több nagyságrenddel) csökkentheti az irreparábilis adatvesztés valószínűségét.
Különböző típusú redundanciákat használhatunk a hibák javítására.
A Hamming-kódok egyes bit hibáit javíthatják, a Reed-Solomon kódok karakterhibákat, több másolat adatai együtt checksumokkal vagy a RAID-6-hoz hasonló kódolás segíthet az adatok helyreállításában még tömeges sérülések esetén is.
Eredetileg a kiterjedt hibajavító kódolás használatára készültem, de aztán rájöttem, hogy először tisztában kell lennünk azzal, hogy milyen hibák ellen szeretnénk védelmet kapni, mielőtt kiválasztanánk a kódolást.
Korábban beszéltünk arról, hogy a hibákat minél gyorsabban fel kell ismerni. Mikor találkozhatunk hibákkal?
- Meg nem fejezett írás (bármilyen okból, például áramszünet, Raspberry lefagyása, stb.)
Sajnálatos módon, ilyen hiba esetén csak az érvénytelen feljegyzéseket lehet figyelmen kívül hagyni, és az adatokat elveszettnek tekinteni; - Írási hibák (bármilyen okból a flash memóriába nem az került beírásra, amit írtunk)
Ilyen hibákat azonnal észlelhetünk, ha az írás után közvetlenül ellenőrző olvasást végzünk; - Adatok torzulása a memória tárolása során;
- Olvasási hibák
A helyesbítéshez elegendő, ha a checksum eltérése esetén többször is elvégezzük az olvasást.
Tehát csak a harmadik típusú hibák (a tárolás során bekövetkező önálló adatkárosodás) nem javíthatók hibajavító kódolás nélkül. Úgy tűnik, hogy az ilyen hibák rendkívül valószínűtlenek.
Összefoglalva: Úgy döntöttek, hogy lemondanak a redundáns kódolásról, de ha a használat során kiderül, hogy ez a döntés hibás, akkor újra megfontolják a kérdést (már összegyűjtött statisztikák alapján a hibákról, amelyek lehetővé teszik a legoptimálisabb kódolás kiválasztását).
Egyéb
Természetesen a cikk formátuma nem teszi lehetővé, hogy minden bitet megindokoljak a formátumban (és már nekem is elfogytak az erőim), ezért röviden át fogok futni néhány olyan ponthoz, amelyet eddig nem érintettem.
- Úgy döntöttek, hogy minden oldal „egyenlő jogú” lesz
Tehát nem lesznek különleges oldalak с метаданными, отдельными потоками и т.п., вместо этого будет единый поток, который переписывает все страницы по очереди.
Ez biztosítja az oldalak egyenletes kopását, az egyetlen leállási pont hiányát, és egyszerűen csak tetszik. - Mindig figyelembe kell venni a formátum verzionálását.
A verziószám nélküli fejléces formátum – rossz!
Elég, ha a címhez hozzáadunk egy mezőt egy úgynevezett Magic Number (aláírás) formájában, amely jelzi a használt formátum verzióját. (nem hiszem, hogy ezekből a gyakorlatban akár tucat is lenne); - Használjunk változó hosszúságú fejléceket a bejegyzésekhez (amelyek nagyon sokan vannak), és próbáljunk meg a legtöbb esetben 1 byte hosszúságúvá tenni őket.
- A fejlécek hossza és a levágott rész hosszának kódolásához használjunk változó hosszúságú bináris kódokat.
Nagyon segített Haffman-kódokhoz. Szó szerint néhány perc alatt sikerült megtalálni a szükséges változó hosszúságú kódokat.
Az adatok tárolási formátumának leírása
Byte sorrend
Az egy byte-nál nagyobb méretű mezők big-endian formátumban (hálózati byte sorrend) tárolódnak, azaz a 0x1234 úgy van írva, hogy 0x12, 0x34.
Oldalra bontás
Az összes flash memória egyenlő méretű oldalakra van felosztva.
Az alapértelmezett oldalméret 32KByte, de nem haladhatja meg a memória chip összes méretének 1/4-ét (4MB-os chip esetén 128 oldal jön ki).
Minden oldal függetlenül tárolja az adatokat a többitől (vagyis egy oldal adatai nem hivatkoznak egy másik oldal adataira).
Minden oldalt természetes sorrendben számoznak (címsorrendben növekvő címek), kezdve a 0-ás számtól (a nulla oldal az 0 címmel kezdődik, az első 32KByte-tal, a második pedig 64KByte-tal és így tovább).
A memóriachip ciklikus pufferként (gyűrűs puffer) működik, tehát először a 0-ás számú oldalra írás történik, utána az 1-es számú oldalra... amikor megtelt az utolsó oldal, akkor kezdődik egy új ciklus, és az írás tovább folytatódik a nulla oldalon.
Az oldalon belül
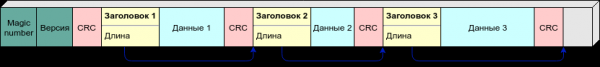
Az oldal elején egy 4 byte-os oldal fejlécet tárolnak, majd a fejléc ellenőrző összege (CRC-32C), utána bekerülnek a bejegyzések a 'fejléc, adatok, ellenőrző összeg' formátumban.
Az oldal fejléc (a vázlaton piszkos zöld) a következőkből áll:
- egy 2 byte-os Magic Number mezőből (ez a formátum verzióját jelzi)
a formátum aktuális verziója számára úgy van tekintve, mint0xed00 ⊕ oldalszám; - kétbájtos számláló "Oldal verzió" (memóriaírási ciklus száma).
Az oldalon található bejegyzések tömörítve vannak tárolva (deflate algoritmust használva). Minden bejegyzés ugyanazon az oldalon egy szálon tömörül (közös szótárat használva), és minden új oldalon a tömörítés újrakezdődik. Ez azt jelenti, hogy bármely bejegyzés dekompressziójához az összes korábbi bejegyzés szükséges az adott oldalról (csak arról).
Minden bejegyzést Z_SYNC_FLUSH flaggel tömörítünk, így a tömörített szál végén 4 bájt 0x00, 0x00, 0xff, 0xff található, amely lehet, hogy egy vagy két 0 bájt előzi meg.
Ezt a (4, 5 vagy 6 bájt hosszú) sorozatot elvetjük a flash memóriába íráskor.
A bejegyzés fejléc 1, 2 vagy 3 bájt, amelyek a következőket tárolják:
- egy bit (T), amely a bejegyzés típusát jelzi: 0 — kontextus, 1 — napló;
- változó hosszúságú mező (S) 1-7 bit között, amely meghatározza a fejléc hosszát és azt a 'farok'-ot, amelyet a bejegyzéshez kell hozzáadni a kicsomagoláshoz;
- a bejegyzés hossza (L).
Az S értékeinek táblázata:
S
A fejléc hossza, bájt
Elvetve íráskor, bájt
0
1
5 (00 00 00 ff ff)
10
1
6 (00 00 00 00 ff ff)
110
2
4 (00 00 ff ff)
1110
2
5 (00 00 00 ff ff)
11110
2
6 (00 00 00 00 ff ff)
1111100
3
4 (00 00 ff ff)
1111101
3
5 (00 00 00 ff ff)
1111110
3
6 (00 00 00 00 ff ff)
Megpróbáltam illusztrálni, nem tudom, mennyire lett érthető:
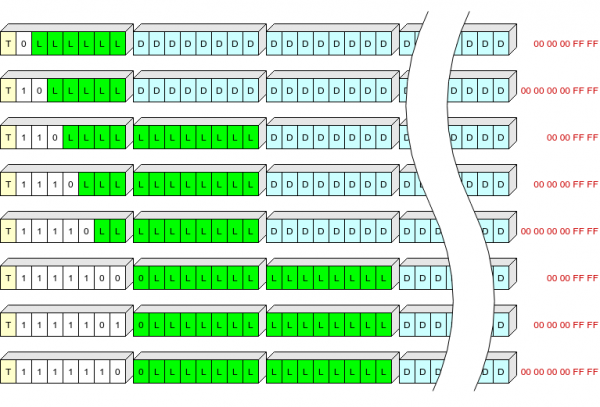
Sárgával itt a T mező, fehérrel az S mező, zölddel az L (a tömörített adatok hossza bájtokban), kékkel a tömörített adatok, pirossal a tömörített adatok végső bájtjai találhatók, amelyeket nem írunk a flash memóriába.
Így a legelterjedtebb hosszúságú bejegyzések (63+5 bájt tömörítve) egy bájton rögzíthetők.
Minden bejegyzés után CRC-32C ellenőrző összeg található, amelynek kiinduló értéke (init) a korábbi ellenőrző összeg inverz értéke.
A CRC rendelkezik a "folytatási" tulajdonsággal, így a következő képlet érvényes (plusz-minusz a bitek megfordítása közben):  .
Tehát valójában a fejléc és az adatok összes korábbi bájtjának CRC-jét számítjuk ki ezen az oldalon.
Közvetlenül az ellenőrző összeg után található a következő bejegyzés fejléc.
A fejléc úgy van megkonstruálva, hogy az első bájtja mindig eltérjen a 0x00-tól és 0xff-től (ha az első fejléc bájt helyett 0xff-t találunk, az azt jelenti, hogy ez egy még nem használt terület; a 0x00 pedig hibát jelez).
Példa algoritmusok
Olvasás a flash memóriából
Bármely olvasás ellenőrző összeg ellenőrzésével történik.
Ha a hashelt összeg nem egyezik, az olvasást többször megismételjük abból a reményből, hogy végül a helyes adatokat olvassuk ki.
(ez érthető, a Linux nem cache-eli a NOR Flash-ból való olvasást, tesztelve)
Írás flash memóriába
Adatokat írunk.
Olvassuk azokat.
Ha az olvasott adatok nem egyeznek a rögzítettekkel, kitöltjük a területet nullákkal, és hibát jelezünk.
Új chip előkészítése a működéshez
Az inicializáláshoz az első (pontosabban nulladik) oldalra egy 1-es verzióval rendelkező fejlécet írunk.
Ezt követően erre az oldalra rögzítjük az alapértelmezett beállításokat tartalmazó kezdeti kontextust (tartalmazza az automata UUID-jét).
Kész, a flash memória készen áll a működésre.
Automata betöltése
Betöltéskor minden oldal első 8 byteját (fejléc + CRC) olvassuk ki, az ismeretlen Magic Number-t vagy hibás CRC-t tartalmazó oldalakat figyelmen kívül hagyjuk.
A "helyes" oldalakat a maximális verziók alapján választjuk ki, és ezek közül az oldalt, amelyiknek a legnagyobb a száma, választjuk ki.
Az első bejegyzést olvassuk ki, ellenőrizzük a CRC helyességét, a "kontextus" jelző meglétét. Ha minden rendben van, ezt az oldalt tekintjük aktuálisnak. Ha nem, visszalépünk az előzőre, amíg élő oldalt nem találunk.
A megtalált oldalon az összes bejegyzést kiolvassuk, a "kontextus" jelzővel rendelkezőket alkalmazzuk.
Megőrizzük a zlib szótárat (szükség lesz rá az oldalhoz való későbbi íráshoz).
Kész, a betöltés befejeződött, a kontextus visszaállt, lehet dolgozni.
Bejegyzés hozzáadása a naplóhoz
A bejegyzést a megfelelő szótárral tömörítjük, megadva a Z_SYNC_FLUSH-t. Megnézzük, hogy a tömörített bejegyzés elfér-e az aktuális oldalon.
Ha nem fér el (vagy az oldalon CRC hibák voltak) - új oldalt kezdünk (lásd lent).
Rögzítjük a bejegyzést és a CRC-t. Ha hiba történt - új oldalt kezdünk.
Új oldal
Kiválasztunk egy szabad oldalt a lehető legkisebb számmal (szabadnak tekintjük az oldalt, amelynek a fejlécében helytelen a CRC, vagy a verziója kevesebb a jelenleginél). Ha ilyen oldal nincs, akkor a jelenlegi verzióval rendelkező oldalak közül választanunk kell a legalacsonyabb számút.
A kiválasztott oldalt töröljük. Ellenőrizzük a tartalmát 0xff-el. Ha valami nem stimmel, a következő szabad oldalt vesszük, stb.
A törölt oldalra rögzítjük a fejlécet, első bejegyzésként a kontextus aktuális állapotát, a következőt - a naplóban nem rögzített bejegyzést (ha van).
A formátum alkalmazhatósága
Szerintem ez egy jó formátum bármilyen, a sűrítésre alkalmas információs áramlás (egyszerű szöveg, JSON, MessagePack, CBOR, esetleg protobuf) tárolására NOR Flash-en.
Természetesen a formátum "fel van készítve" SLC NOR Flash-re.
Ezt nem érdemes használni olyan tárolókkal, amiknek magas a BER-e, például NAND vagy MLC NOR. (van egyáltalán ilyen memória forgalomban? Csak a korrekciós kódokról szóló munkákban láttam rá utalásokat).
Főleg, hogy ezt nem érdemes olyan eszközökkel használni, amelyek saját FTL-lel rendelkeznek: USB flash, SD, MicroSD, stb. (ehhez a memóriához 512 byte-os oldalmérettel, az oldal elején elhelyezett aláírással és egyedi rekordszámokkal rendelkező formátumot készítettem — néha a "megsérült" flash-ból sikerült egyszerű sorozatos olvasással visszaállítani az összes adatot).
A feladatoktól függően a formátum módosítás nélkül használható 128Kbit (16Kbyte) és 1Gbit (128Mbyte) közötti flash egységeken. Igény szerint nagyobb kapacitású chipeken is használható, de valószínűleg a lapméretet ki kell módosítani. (De itt már felmerül a gazdasági szempontok kérdése, a nagy kapacitású NOR Flash ára nem örvendeztet meg.).
Ha valakinek érdekesnek tűnik a formátum, és szeretné használni egy nyílt projektben — írjon, megpróbálom találni az időt, hogy rendbe tegyem a kódot és feltöltsem a githubra.
Zárás
Ahogy látjuk, a formátum végül egyszerűnek bizonyult. és még unalmasnak is..
A cikkben nehéz visszatükrözni a nézeteim evolúcióját, de higgye el: kezdetben olyan valamit akartam létrehozni, ami bonyolult, elpusztíthatatlan és képes lenne túlélni egy közeli nukleáris robbanást. Azonban a józan ész (remélem) végül győzött, és fokozatosan az egyszerűség és a kompaktosság felé tolódtak el a prioritások.
Előfordulhat, hogy tévedtem? Igen, természetesen. Lehet, hogy például rossz minőségű chipeket vásároltunk. Vagy valamilyen más okból az eszköz nem fogja teljesíteni a megbízhatósággal kapcsolatos elvárásokat.
Van-e terve erre az esetre? A cikk elolvasása után gondolom, hogy nem kételkedik abban, hogy van tervem. Sőt, nem is egy.
Ha egy kicsit komolyabban vesszük, a formátumot egyszerre dolgozták ki mint működő megoldást, és mint "próbát".
Jelenleg minden jól működik az asztalon, és pár napon belül a megoldás ki lesz terjesztve. (kb.) száz eszközön fogjuk tesztelni, hogy milyen teljesítményt nyújt a "valós" környezetben (remélhetőleg a formátum megbízhatóan képes a hibák érzékelésére; így teljes statisztikát tudunk majd összegyűjteni). Néhány hónap múlva következtetéseket vonhatunk le. (ha pedig nem lesz szerencsénk – akkor akár hamarabb is).
Ha a használat során komoly problémákat tapasztalok, és szükségesek az utólagos módosítások, akkor erről mindenképpen írok.
Irodalom
Nem akartam hosszú, unalmas listát készíteni a használt anyagokról, végül is mindenki számára elérhető a Google.
Itt úgy döntöttem, hogy összegyűjtöm azokat a felfedezéseket, amelyek különösen érdekesnek tűntek számomra, azonban fokozatosan átkeltek magába a cikkbe, és a listában csak egy pont maradt:
- Eszköz a zlib szerzőjétől. Érthetően képes megjeleníteni a deflate/zlib/gzip archívumok tartalmát. Ha neked is meg kell értened a deflate (vagy gzip) formátum belső felépítését – melegen ajánlom.
Forrás: habr.com
