

Néhány cég, így a megbízónk is, a terméket partnerhálózaton keresztül fejleszti. Például a nagy online áruházak integrálva vannak a szállítási szolgáltatással – tehát terméket rendel, és hamarosan megkapja a csomag követési számát. Egy másik példa, hogy a repülőjegy megvétele mellett biztosítást vagy Aeroexpressz jegyet vásárol.
Ehhez egy API-t használunk, amelyet a partnereknek az API Gateway-en keresztül kell kiadni. Ezt a feladatot mi oldottuk meg. Ebben a cikkben részletezzük.
Adott: egy ökoszisztéma és egy API-portál, ahol a felhasználók regisztrálva vannak, információt kapnak stb. Nekünk egy kényelmes és megbízható API Gateway-t kell létrehoznunk. A folyamat során biztosítanunk kellett
- a regisztrációt,
- az API-hoz való csatlakozás ellenőrzését,
- a felhasználók végső rendszerhasználatának nyomon követését,
- az üzleti mutatók figyelembevételét.
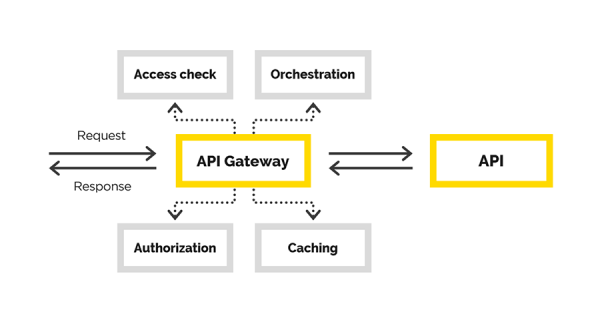
A cikkben megosztjuk tapasztalatainkat az API Gateway létrehozásáról, amely során a következő feladatokat oldottuk meg:
- a felhasználó azonosítása,
- a felhasználó jogosultsága,
- a forráskérés módosítása,
- a kérés proxyzása,
- a válasz utófeldolgozása.
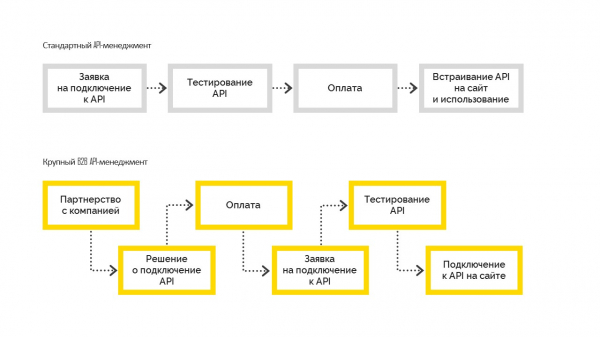
Kétféle API-menedzsment létezik:
1. A standard, amely a következőképpen működik. A csatlakozás előtt a felhasználó teszteli a lehetőségeket, majd fizet és integrálja a saját weboldalára. Ezt leggyakrabban a kis- és középvállalkozások használják.
2. Nagy B2B API menedzsment, amikor a cég először üzleti döntést hoz a csatlakozásról, partnerévé válik egy szerződéses kötelezettséggel, majd csatlakozik az API-hoz. Csak miután a formális ügyek elintézése megtörtént, a cég tesztelésre hozzáférést kap, elvégzi a tesztelést és megkezdődik a termelés. De ez nem lehetséges a csatlakozási döntés nélkül.
A mi megoldásunk
Ebben a részben az API Gateway létrehozásáról beszélünk.
A létrehozott API-híd végfelhasználói a megbízónk partnerei. Mindenki számára már rendelkezésre állnak a szükséges szerződések. Csak annyit kell tennünk, hogy bővítjük a funkcionalitást, figyelembe véve a hídhoz biztosított hozzáférést. Ennek megfelelően szükséges egy ellenőrzött folyamat a csatlakozás és a menedzsment terén.
Természetesen lehetett volna valamilyen kész megoldást választani az API menedzsment feladatának megoldásához, különösen az API Gateway létrehozásához. Például ilyen volt az. Nem volt megfelelő számunkra, mert már volt egy API-portálunk és egy hatalmas ökoszisztéma építve köré. Minden felhasználó már regisztrálva volt, tudták, hol és hogyan kaphatják meg a szükséges információkat. Az API-portálon már léteztek a szükséges interfészek, nekünk csak az API Gateway volt szükséges. Ezt a fejlesztést kezdtük el.
Amit API Gateway-nek hívunk — egyfajta proxy. Itt újra választásunk volt — írhatunk egy saját proxy-t, vagy választhatunk már meglévőt. Ebben az esetben a második utat választottuk, és a nginx+Lua kombinációra esett a választásunk. Miért? Megbízható, tesztelt szoftverre volt szükségünk, ami támogatta a skálázódást. Nem akartuk a megvalósítás után ellenőrizni a business logika helyességét és a proxy működését is.
Minden webservernek van egy kérésfeldolgozási folyamata. A nginx esetében ez a következőképpen néz ki:
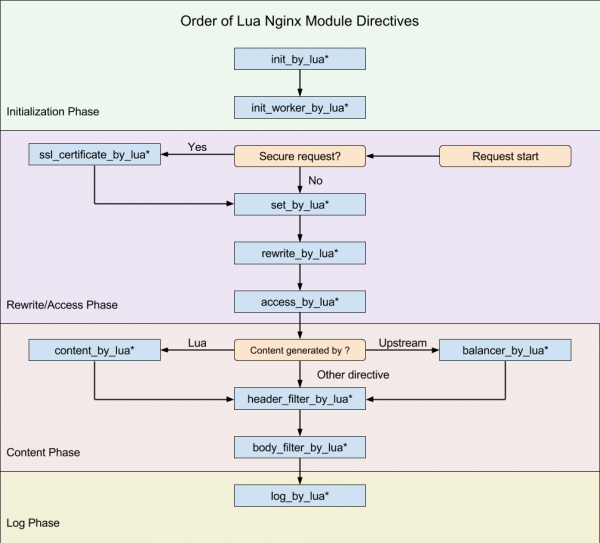
(diagram a )
Célunk az volt, hogy beépüljünk ebbe a folyamatba azon a ponton, ahol módosítani tudjuk az eredeti kérést.
Transzparens proxy-t szeretnénk létrehozni, hogy a funkcionálisan a kérés ugyanolyan maradjon, mint amilyen megérkezett. Csak a hozzáférést ellenőrizzük a végső API-hoz, segítünk a kérésnek eljutni odáig. Ha a kérés hibás volt, akkor a végső API-nak kell megmutatnia a hibát, nem nekünk. Az egyetlen ok, amiért elutasíthatjuk a kérést, az a hozzáférés hiánya az ügyfél részéről.
A nginx-hez már létezik Gyorsan emlékezzünk vissza, hogyan működik a moduláris aritmetika. Az óra már egy ismert koncepció. Az órák használata . A Lua egy szkriptnyelv, nagyon könnyű és könnyen elsajátítható. Így a szükséges logikát Lua segítségével valósítottuk meg.
A nginx konfiguráció (a route alkalmazás analógiája), ahol elvégezzük a munkát, érthető. Érdekes az utolsó direktíva — post_action.
location /middleware {
      more_clear_input_headers Accept-Encoding;
      lua_need_request_body on;
      rewrite_by_lua_file 'middleware/rewrite.lua';
      access_by_lua_file 'middleware/access.lua';
      proxy_pass https://someurl.com;
      body_filter_by_lua_file 'middleware/body_filter.lua';
      post_action /process_session;
}
Nézzük meg, mi történik ebben a konfigurációban:
more_clear_input_headers — törli a direktíva után megadott headerek értékét.
lua_need_request_body — szabályozza, hogy szükséges-e elolvasni az eredeti kérés testét a rewrite/access/access_by_lua direktívák végrehajtása előtt. Alapértelmezés szerint a nginx nem olvassa el az ügyfél kérésének testét, és ha szükséges, hogy hozzáférjünk, akkor ennek a direktívának on értékűnek kell lennie.
rewrite_by_lua_file — a szkript elérési útja, amely leírja a kérések módosításának logikáját
access_by_lua_file — a szkript elérési útja, amely leírja a logikát, amely ellenőrzi az erőforráshoz való hozzáférést.
proxy_pass — az URL, amelyre a kérés proxizálva lesz.
body_filter_by_lua_file — a szkript elérési útja, amely leírja a logikát a kérés szűrésére, mielőtt azt visszaadnánk az ügyfélnek.
És végül, post_action — hivatalosan nem dokumentált direktíva, amellyel további műveleteket végezhetünk, miután a válasz az ügyfélhez került.
Ezután lépésről lépésre elmondjuk, hogyan oldottuk meg a feladatainkat.
Hitelesítés és kérés módosítása
Engedélyezés
A hitelesítést és az azonosítást tanúsítványalapú hozzáféréssel építettük fel. Van egy gyökér tanúsítvány. Minden új ügyfélnek generálunk egy egyéni tanúsítványt, amellyel hozzáférhet az API-hoz. Ez a tanúsítvány a nginx beállításainak server szekciójában van konfigurálva.
ssl on;
ssl_certificate /usr/local/openresty/nginx/ssl/cert.pem;
ssl_certificate_key /usr/local/openresty/nginx/ssl/cert.pem;
ssl_client_certificate /usr/local/openresty/nginx/ssl/ca.crt;
ssl_verify_client on;
Módosítás
Jogosan merülhet fel a kérdés: mit tegyünk a hitelesített ügyféllel, ha hirtelen szeretnénk kikapcsolni a rendszerről? Nem lenne értelme az összes többi ügyfél tanúsítványát újra kibocsátani.
Így jutottunk el a következő feladathoz — a kérés módosítása. Az ügyfél eredeti kérése nem érvényes a végső rendszer számára. Az egyik feladat az, hogy kiegészítsük a kérés hiányzó részeit, hogy érvényes legyen. A lényeg az, hogy a hiányzó adatok különbözők minden ügyfél esetében. Tudjuk, hogy az ügyfél tanúsítvánnyal érkezik, amelyből az ujjlenyomatot kivehetjük, és szükséges adatokat nyerhetünk ki az adatbázisból.
Ha bármikor szükséges lenne az ügyfél kikapcsolása a szolgáltatásunkból, az adatai eltűnnek az adatbázisból, és nem fog tudni semmit csinálni.
Az ügyféladatok kezelése
Magas rendelkezésre állást kellett biztosítanunk, különösen abban, ahogyan az ügyféladatokat megszerezzük. A bonyodalom abban rejlik, hogy e adatok elsődleges forrása egy külső szolgáltatás, amely nem garantálja a folyamatos és elegendő sebességet.
Ezért magas rendelkezésre állást kellett biztosítanunk az ügyféladatok számára. Eszközül a következőt választottuk , amely számunkra biztosítja:
- gyors adat-hozzáférés,
- a lehetőség egy több node-ból álló klaszter létrehozására, ahol az adatok különböző node-okon vannak replikálva.
A legegyszerűbb adatcache-elési stratégiát választottuk:
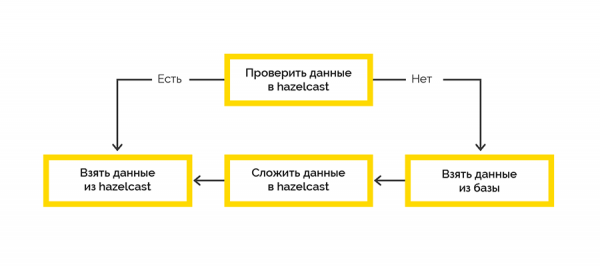
A végső rendszerrel való munka során session-ök keretein belül zajlik, és van egy korlát a maximális számra. Ha a kliens nem zárja be a session-t, ezt nekünk kell megtennünk.
A nyitott session információk a végső rendszertől érkeznek, és kezdetben a Lua oldalán dolgozzák fel őket. Azt döntöttük, hogy a Hazelcast-ot használjuk ezen adatok tárolására egy .NET-ben írt task segítségével. Ezután időnként ellenőrizzük a nyitott session-ök érvényességét és lezárjuk a lejártakat.
Hozzáférés a Hazelcast-hoz Lua-ból és .NET-ből is
Lua-hoz nem létezik ügyfél a Hazelcast-hoz, de a Hazelcast rendelkezik REST API-val, amelyet igénybe vettünk. A .NET-hez pedig , amelyen keresztül terveztük a Hazelcast adatokhoz hozzáférni a .NET oldalán. De nem úgy alakult.
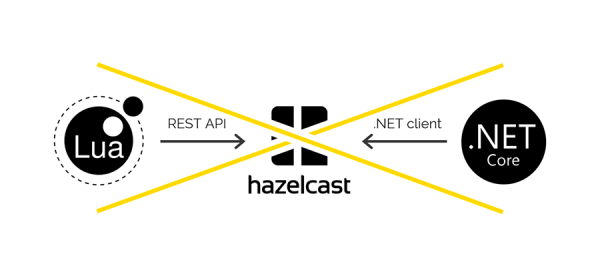
A REST-en keresztüli mentéskor és a .NET kliensen keresztüli lekérdezéskor különböző sorozat-/desorozatolókat használnak. Így nem lehetséges, hogy az adatokat REST-en keresztül helyezzük el, és a .NET kliensen keresztüli hozzáféréssel hívjuk le, és fordítva.
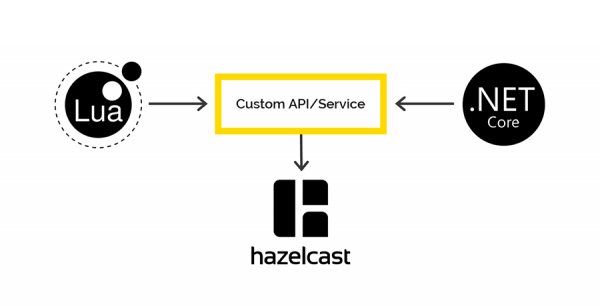
Ha érdeklődők akadnak, részletesebben beszélünk erről a problémáról egy külön cikkben. Spoiler — az ábrán.
Naplózás és monitorozás
A vállalati szabványunk a naplózásra .NET-en keresztül a Serilog, minden napló végül az Elasticsearch-be kerül, az elemzést a Kibana-n végezzük. Hasonló dolgot szerettünk volna tenni ebben az esetben is. Az egyetlen Lua-ban az Elasticsearch munkájához használt kliens, amelyet találtunk, az első require-nél elromlott. Így a Fluentd-t használtuk.
— open source megoldás az alkalmazás egységes naplózási rétegének biztosítására. Lehetővé teszi, hogy különböző alkalmazási rétegekből gyűjtsük a naplókat, majd ezeket egy központi forrásba transzformáljuk.
Az API Gateway a K8S-ben működik, így úgy döntöttünk, hogy hozzáadunk egy fluentd konténert ugyanabba a podba, hogy a meglévő nyitott TCP porton keresztül írhassuk a naplókat.
Azt is megvizsgáltuk, hogy a fluentd hogyan viselkedik, ha nincs kapcsolata az Elasticsearch-szel. Két napon keresztül folyamatosan érkeztek a kérések a gateway-be, a fluentd naplók mentek, de a fluentd IP-jét az Elastic blokkolta. Miután a kapcsolat helyreállt, a fluentd remekül áttolta az összes naplót az Elastic-be.
Zárás
A választott megvalósítási megközelítés lehetővé tette számunkra, hogy valóban működő terméket szállítsunk a éles környezetbe mindössze 2,5 hónap alatt.
Ha valaha hasonló dolgokkal kell foglalkoznia, először is világosan meg kell értenie, hogy milyen feladatot old meg, és hogy milyen erőforrásai vannak már. Legyen figyelemmel az API-kezelő rendszerekkel való integráció bonyolultságaira.
Értenie kell, hogy pontosan mit tervez fejleszteni — csak a kéréskezelési üzleti logikát, vagy akár egy teljes proxyt, ahogyan az a mi esetünkben történt. Ne feledje, hogy mindent, amit saját maga készít, később alaposan tesztelnie kell.
Forrás: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish