

Megjegyzés fordítás.A Kubernetes adaptation in GitLab is considered one of the two main factors contributing to the company’s growth. However, until recently, the infrastructure of the online service GitLab.com was built on virtual machines, and only about a year ago did the migration to K8s begin, which is still ongoing. We are pleased to present a translation of a recent article by a GitLab SRE engineer on how this process is unfolding and what insights the engineers involved in the project are gaining.
For about a year now, our infrastructure department has been migrating all services running on GitLab.com to Kubernetes. During this time, we've encountered issues not only related to moving services to Kubernetes but also managing a hybrid deployment during the transition. This article will cover valuable lessons learned along the way.
From the very beginning, GitLab.com operated its servers in the cloud on virtual machines. These virtual machines are managed by Chef, and their installation occurs using our . in case of needing to update the application consists of simply updating the server fleet in a coordinated sequential manner via a CI pipeline. While this method is slow and somewhat - it ensures that GitLab.com employs the same installation and configuration methods as users of self-managed (self-managed) GitLab installations that utilize our Linux packages.
We use this method because it is essential to experience all the pains and joys that community members go through when installing and configuring their own instances of GitLab. This approach worked well for some time, but once the number of projects on GitLab surpassed 10 million, we realized that it no longer met our scaling and deployment needs.
The first steps towards Kubernetes and cloud-native GitLab
In 2017, the project was created a GitLab felhőbe való telepítésére való felkészítéshez, valamint ahhoz, hogy a felhasználók lehetőséget kapjanak a GitLab telepítésére Kubernetes klaszterekbe. Akkor tudtuk, hogy a GitLab Kubernetesbe való áttelepítése növelni fogja a SaaS-platform skálázhatósági lehetőségeit, leegyszerűsíti a telepítéseket, és javítja a számítási erőforrások hatékonyságának kihasználását. Ugyanakkor sok alkalmazásfunkciónk függött a csatlakoztatott NFS-megosztásoktól, ami lassította a virtuális gépekről való átállást.
A cloud native és Kubernetes iránti törekvés lehetővé tette mérnökeink számára, hogy fokozatos átállást tervezzenek, amely során lemondtunk néhány alkalmazásfüggőségről a hálózati tárolóktól, miközben új funkciókat fejlesztettünk. Azóta, hogy 2019 nyarán elkezdtük a migráció tervezését, sok korlátozást sikerült megszüntetni, és a GitLab.com Kubernetesre való átállása mostanra teljes erőbedobással zajlik!
A GitLab.com munkája Kubernetesben
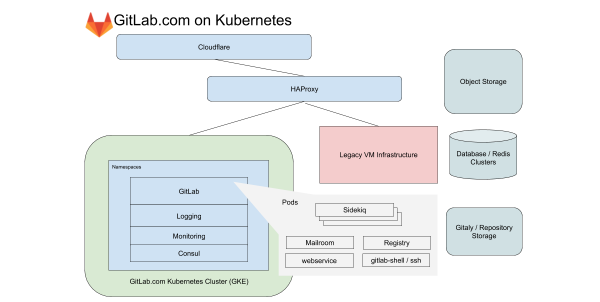
A GitLab.com számára egyetlen regionális GKE klasztert használunk, amely az egész alkalmazásforgalmat kezeli. A migráció (amúgy is összetett) bonyolultságának minimalizálása érdekében a helyi tárolótól vagy NFS-től független szolgáltatásokra összpontosítunk. A GitLab.com főként monolitikus Rails kódalapra épül, és a forgalmat a terhelés jellemzői alapján különböző végpontokra irányítjuk, amelyek saját csomópulusaikban vannak elkülönítve.
A frontend esetében ezek a típusok osztódnak a web, API, Git SSH/HTTPS és Registry hívásokra. A backend esetében a munkákat az arányok különböző jellemzői szerint osztjuk el, figyelembe véve , amelyek lehetővé teszik számunkra, hogy szolgáltatási szinttel kapcsolatos célokat (Service-Level Objectives, SLO-k) állítsunk fel a különböző terhelésekhez.
Mindezek a GitLab.com szolgáltatások a GitLab módosítatlan Helm-diagramjának segítségével vannak beállítva. A konfiguráció a szubdiagramokban történik, amelyeket fokozatosan aktiválhatunk, ahogy az egyes szolgáltatásokat migráljuk a klaszterbe. Még figyelembe véve, hogy úgy döntöttünk, hogy nem vesszük fel a migrációba néhány állapotot megőrző szolgáltatásunkat, mint például a Redis, Postgres, GitLab Pages és Gitaly, a Kubernetes használata radikálisan csökkenti azokat a VM-eket, amelyeket a Chef jelenleg kezel.
A Kubernetes átláthatósága és konfigurációs kezelése
Minden beállítást a GitLab kezel. Ehhez három Terraform és Helm alapú konfigurációs projektet használunk. Igyekszünk mindenhol az aktuális GitLab-ot használni a GitLab indításához, de működési feladatokhoz egy külön GitLab telepítés működik. Erre van szükség, hogy ne függjünk a GitLab.com elérhetőségétől a GitLab.com telepítések és frissítések során.
Bár a Kubernetes klaszter pipelinjei egy külön GitLab telepítésen működnek, a kód repository-knak vannak tükrözései, amelyek nyilvánosan elérhetők az alábbi címeken:
- — a GitLab.com Helm-chart konfigurációs kerete;
- — olyan konfigurációkat tartalmaz, amelyek nem kapcsolódnak közvetlenül a GitLab alkalmazáshoz. Ide tartoznak a klaszter naplózásához és megfigyeléséhez, valamint az integrált eszközökhöz, mint például a PlantUML, szükséges konfigurációk;
- — Terraform konfiguráció Kuberneteshez és régóta használt (legacy) virtuális infrastruktúrához. Itt konfiguráljuk az összes olyan erőforrást, amely a klaszter indításához szükséges, beleértve magát a klasztert, a csomópontpoolsot, a szolgáltatási fiókokat és az IP-címek tartalékát.

A változtatások bevezetésekor nyilvános jelenik meg, amely egy részletes diffre mutat, amit az SRE elemzi a klaszterbe történő változtatások előtt.
Az SRE számára a link a részletes diffhez vezet a GitLab telepítésben, amelyet üzemeltetéshez használnak és amelyhez a hozzáférés korlátozott. Ez lehetővé teszi a munkatársak és a közösség számára, akik nem férnek hozzá az üzemeltetési projekthez (ez csak az SRE számára nyitott), hogy megtekinthessék a konfigurációban javasolt változtatásokat. A GitLab kódjához hasonló nyilvános példány kombinálásával, valamint a CI pipelínek zárt példányával egységes munkafolyamatot biztosítunk, ugyanakkor garantáljuk a függetlenséget a GitLab.com-tól a konfigurációk frissítése során.
A migráció során szerzett tapasztalatok
A költözés során tapasztalatokat gyűjtöttünk, amelyeket új migrációkhoz és Kubernetes telepítésekhez alkalmazunk.
1. A költségek növekedése a rendelkezésre állási zónák közötti forgalom miatt
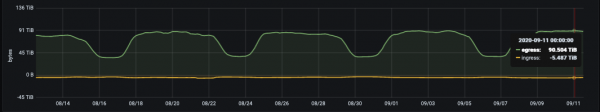
Napi egress statisztika (byte/nap) a GitLab.com-on tárolt Git tárolókhoz
A Google a hálózatát régiókra osztja. Ezek viszont elérhetőségi zónákra (AZ) vannak felosztva. A Git-tárhelyek nagy adatmennyiségekkel dolgoznak, ezért fontos szempont a hálózati egressz kontrolálása. Belső forgalom esetén az egressz ingyenes, amennyiben egy elérhetőségi zónán belül marad. A cikk írásának idején körülbelül 100 TB adatot adunk át egy átlagos munkanapon (és ez csak a Git-repozitóriumok számára). Az olyan szolgáltatások, amelyek a régi VM-alapú topológiánk keretein belül ugyanazokon a virtuális gépeken voltak, most különböző Kubernetes podokban futnak. Ez azt jelenti, hogy a korábban lokális VM forgalom egy része potenciálisan elhagyhatja az elérhetőségi zónákat.
A GKE regionális klaszterek lehetővé teszik, hogy több elérhetőségi zónát is lefedjünk a redundancia érdekében. Fontolóra vesszük, hogy azoknak a szolgáltatásoknak, amelyek nagy forgalmat generálnak. Ez csökkentené az egressz költségeit, miközben megtartaná a klaszter szintű redundanciát.
2. Korlátok, erőforrás igények és skálázás
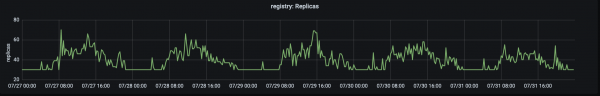
A registry.gitlab.com-on kezelt production forgalmat bonyolító replikák száma. A forgalom csúcsidőszaka ~15:00 UTC között van.
A migrációnk története 2019 augusztusában kezdődött, amikor az első szolgáltatást — a GitLab konténerregiszterét (GitLab Container Registry) — áthelyeztük Kubernetesbe. Ez a kritikus fontosságú, nagy forgalmú szolgáltatás jól megfelelt az első migrációnak, mivel egy stateless alkalmazás alacsony külső függőségekkel. Az első probléma, amellyel szembesültünk, a pods nagyszámú kiszorítása volt a csomópontok memóriahiánya miatt. Emiatt módosítanunk kellett az igényeket és a korlátokat.
Megállapítottuk, hogy ha egy alkalmazás memóriafogyasztása idővel növekszik, akkor az alacsony igényértékek (melyek memóriát rezerválnak minden pod számára) együtt a „bőkezű” kemény korláttal a felhasználás saturációjához vezetnek. (saturáció) a csomópontoknál, és a kiszorítások magas szintjéhez. E probléma megoldására Ez csökkentette a csomópontokra nehezedő nyomást, és olyan pod életciklust biztosított, amely nem gyakorolt túl nagy nyomást a csomópontra. Most gazdag (és majdnem azonos) kérésekkel és korlátokkal kezdjük a migrációkat, amelyeket szükség szerint finomítunk.
3. Metriák és naplók
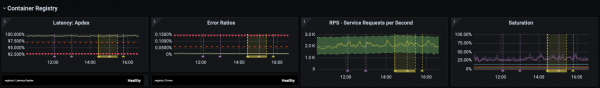
Az infrastruktúra részleg a késleltetésekre, a hibaarányra és a telítettségre összpontosít, a megállapított (SLO), amelyek a .
Az elmúlt évben az infrastruktúra részleg egyik kulcsfontosságú eseménye a SLO-kkal kapcsolatos monitoring és működés javítása volt. A SLO-k lehetővé tették számunkra, hogy célokat állítsunk fel különböző szolgáltatásokra, amelyeket szorosan figyelemmel kísértünk a migráció során. De még a javított megfigyelhetőséggel sem mindig lehet azonnal észlelni a problémákat a metrikák és riasztások segítségével. Például a késleltetések és a hibaarányra összpontosítva nem terjedünk ki teljesen minden használati forgatókönyvre a migráló szolgáltatásnál.
Ez a probléma szinte azonnal felmerült, miután a munkaterhelések egy részét a klaszterbe helyeztük. Különösen éles volt, amikor olyan funkciókat kellett ellenőrizni, amelyeknek kevés kérésük van, de nagyon specifikus konfigurációs függőségekkel rendelkeznek. A migráció végén az egyik kulcsszó a megfigyelés során az volt, hogy nemcsak a metrikákat, hanem a naplókat és a „hosszú farok” (ez a vonatkozik a grafikonon — a fordító megjegyzése) most részletes kéréseket vonunk be a naplókhoz (naplólekérdezések) és világos visszagörgetési eljárásokat tervezünk, amelyeket problémák esetén egyik műszakról a másikra lehet átadni.
Az azonos kérések párhuzamos megoldása a régi VM-infrastruktúrában és az új, Kubernetes alapúban egyedi kihívást jelentett. A lift-and-shift típusú migrációnál (alkalmazások „ahogy vannak” átköltöztetése az új infrastruktúrába; további részletekért például olvasható, — a fordító megjegyzése), a régi VM-ek és a Kubernetes párhuzamos működése megköveteli, hogy a monitorozó eszközök kompatibilisek legyenek mindkét környezettel, és képesek legyenek a metrikák egyesítésére. Fontos, hogy ugyanazokat a dashboard-okat és loglekérdezéseket használjuk, hogy következetes megfigyelhetőséget érjünk el az átmeneti időszakban.
4. A forgalom átkapcsolása az új klaszterre
A GitLab.com számára egyes szerverek dedikáltak . A canary park a belső projektjeinket szolgálja ki, és emellett . De elsősorban a változások ellenőrzésére szolgál, amelyeket az infrastruktúrában és az alkalmazásban végeznek. Az első átvitt szolgáltatás egy korlátozott mennyiségű belső forgalom fogadásával kezdődött, és továbbra is ezt a módszert használjuk, hogy biztosítsuk a SLO betartását, mielőtt az összes forgalmat a klaszterre irányítanánk.
A migráció esetén ez azt jelenti, hogy először a Kubernetes-en belüli projektekre irányítjuk a kéréseket, majd fokozatosan átkapcsoljuk a maradék forgalmat a klaszterre a backend súlyának megváltoztatásával a HAProxy-n keresztül. A VM-ről a Kubernetes-re való átállás során kiderült, hogy nagyon előnyös, ha van egy egyszerű mód a forgalom átirányítására a régi és új infrastruktúra között, így a régi infrastruktúra készen állhat a visszaállításra az átállás első néhány napjában.
5. Pod tartalék kapacitások és azok használata
Hamarosan felmerült a következő probléma: a Registry szolgáltatás pod-jai gyorsan indultak, azonban a Sidekiq pod-dal való indítás akár is igénybe vett. A Sidekiq pod-ok széleskörű indítása problémát jelentett, amikor a Kubernetes-be migráltuk a worker-ek munkaterheit, akiknek gyorsan kell feldolgozniuk a job-okat és gyorsan skálázódniuk kell.
Ebben az esetben a tanulság az volt, hogy bár a Horizontal Pod Autoscaler (HPA) a Kubernetes-ben jól kezeli a forgalom növekedését, fontos figyelembe venni a munkaterhek jellemzőit és dedikálni a pod-ok tartalék kapacitásait (különösen a kereslet egyenetlen eloszlása esetén). Az esetünkben hirtelen megugrott a job-ok száma, ami gyors skálázódást igényelt, és ez CPU erőforrások telítődéséhez vezetett, mielőtt el tudtuk volna indítani a csomópontok medencéjének skálázását.
Mindig kísértés, hogy a lehető legtöbbet „kihozzuk” a klaszterből, azonban mi, miután kezdetben teljesítményproblémákkal küzdöttünk, most egy bőkezű pod költségvetéssel indulunk, amelyet később csökkentünk, figyelemmel kísérve az SLO-t. A Sidekiq szolgáltatáshoz kapcsolódó podok indítása jelentősen felgyorsult, és most átlagosan körülbelül 40 másodpercet vesz igénybe. nyereséges volt mind a GitLab.com, mind a saját magánkezelésű telepítéseink felhasználói számára, akik a GitLab hivatalos Helm-chartjával dolgoznak.
Zárás
Minden szolgáltatás átköltöztetése után örültünk a Kubernetes használatának előnyeinek a production környezetben: gyorsabb és biztonságosabb alkalmazás telepítés, skálázás és hatékonyabb erőforrás-elosztás. Ráadásul a migráció előnyei túlmutatnak a GitLab.com szolgáltatáson. Minden hivatalos Helm-chart frissítés a felhasználók hasznára válik.
Remélem, tetszett nektek a Kubernetes migrációval kapcsolatos kalandjaink története. Továbbra is újabb szolgáltatásokat költöztetünk a klaszterre. További információk találhatók a következő publikációkban:
- «»;
- «»;
- .
Fejlesztési eszközök, amelyek Kubernetesben futnak
Olvasson további információkat a blogunkban:
- «»;
- «»;
- «»;
- «».
Forrás: habr.com
