

Ismert, hogy a CTO szakértelmét csak a szerep második betöltésekor mérik fel. Mert egyrészt évekig dolgozni egy cégnél, vele együtt fejlődni és a mindig ugyanabban a kulturális kontextusban fokozatosan egyre nagyobb felelősséget vállalni, és egészen más, egyből technikai igazgatóként kerülni egy olyan vállalatba, amelynek hagyományai vannak, és egy halom problémát elhárítottak a szőnyeg alá.
Ebben az értelemben Leon Fayer tapasztalata, amelyet megosztott a , nem mondható egyedinek, de a 20 év alatt felhalmozott tapasztalatai és különféle pozíciói miatt nagyon hasznos. Az alábbiakban található idősor 90 napról és sok vicces anekdotáról, amelyek jól esik másokkal együtt nevetve hallani, de kevésbé szórakoztató, amikor személyesen találkozunk velük.
Leon nagyon színesen mesél oroszul, ezért ha van 35-40 percetek, javaslom, hogy nézzétek meg a videót. Az időmegtakarítás érdekében alább található a szöveges változat.
Az első jelentés jól strukturált leíres volt a munka emberekkel és folyamatokkal, hasznos ajánlásokkal. De nem adta vissza az összes meglepetést, ami az út során történt. Ezért megváltoztattam a formátumot, és a problémákat, amelyek az új cégnél elém ugráltak, mint a démon a dobozból, és a megoldás módszereit időrendi sorrendben tettem közzé.
Egy hónappal ezelőtt
Mint sok jó történet, ez is alkohollal kezdődött. Ismerősökkel ültünk a bárban, és ahogy az IT-sek között szokás, mindenki a problémáiról panaszkodott. Az egyikük éppen most váltott munkát, és mesélte a technológiákkal, az emberekkel és a csapattal kapcsolatos nehézségeit. Minél tovább hallgattam, annál inkább megértettem, hogy csak fel kellene venniük engem, mert pontosan ilyen problémák megoldásával foglalkoztam az elmúlt 15 évben. Ezt el is mondtam neki, és másnap már a munkahelyi környezetben találkoztunk. A vállalat neve Teaching Strategies volt.
A Teaching Strategies piacvezető a kora gyermekkorú gyerekek oktatási programjaiban — születéstől három éves korig. A tradicionális „papíralapú” cég már körülbelül 40 éve működik, míg a digitális SaaS-verziója 10 éve. Viszonylag nemrég kezdődött meg a digitális technológia alkalmazása a cég standardjaiban. Az „új” verzió 2017-ben indult, és szinte ugyanolyan volt, mint a régi, csak gyengébben működött.
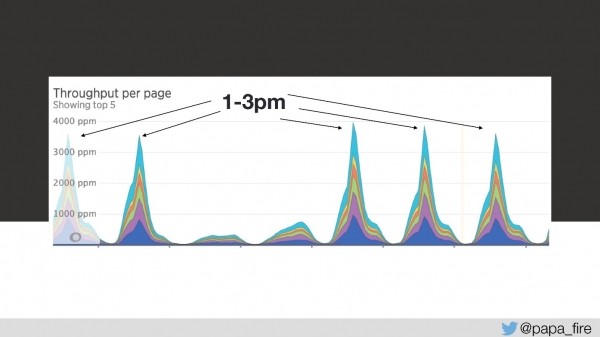
A legérdekesebb, hogy a cég forgalma nagyon előrejelezhető — napról napra, évről évre pontosan meg lehet jósolni, hány ember érkezik és mikor. Például délután 1 és 3 óra között minden gyerek az óvodákban aludni megy, míg a tanárok elkezdik rögzíteni az információkat. Ez minden nap így történik, kivéve hétvégén, mert hétvégén szinte senki sem dolgozik.
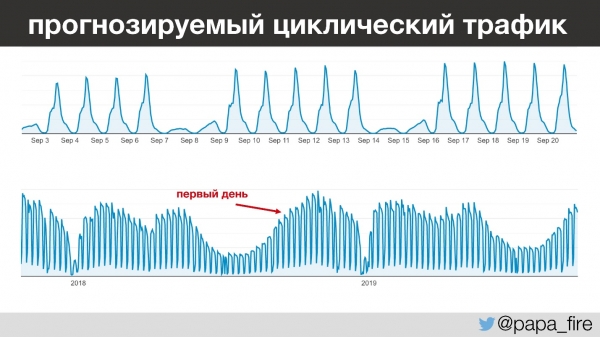
Előreugorva megjegyzem, hogy a legnagyobb éves forgalom idején kezdtem el a munkámat, ami különböző okokból érdekes.
A platform, amelynek úgy tűnt, hogy mindössze 2 éve működik, sajátos technológiai háttérrel rendelkezett: ColdFusion és SQL Server 2008. A ColdFusion, ha esetleg nem tudnád, valószínűleg nem tudod, egy enterprise PHP, amely az 1990-es évek közepén jelent meg, és azóta nem hallottam róla. Továbbá voltak benne: Ruby, MySQL, PostgreSQL, Java, Go, Python. De a fő monolit ColdFusion és SQL Server alatt futott.
Problems
Minél többet beszéltem a cég munkatársaival a munkáról és az ott felmerülő problémákról, annál inkább megértettem, hogy a problémák nemcsak technikai jellegűek. Rendben, a technológia régi — nem ezen nőttünk fel, de voltak problémák a csapattal és a folyamatokkal, és a cég ezt kezdte megérteni.
Hagyományosan a technikai emberek a sarokban ültek és a saját munkájukkal foglalkoztak. De egyre több üzlet kezdett pontosan a digitális verzión keresztül zajlani. Ezért a cég utolsó egy évében, mielőtt elkezdtem volna dolgozni, új pozíciók jelentek meg: igazgatóság, CTO, CPO és QA-vezető. Vagyis a cég kezdett befektetni a technológiai területbe.
A nehéz örökség nyomai nemcsak a rendszerekben voltak. A cégnek örökségi folyamatai, örökségi emberei, örökségi kultúrája volt. Mindezt meg kellett változtatni. Gondoltam, hogy biztosan nem lesz unalmas, és úgy döntöttem, hogy megpróbálom.
Két nappal azelőtt, hogy
Két nappal az új munka kezdete előtt elmentem az irodába, kitöltöttem az utolsó papírokat, megismertem a csapatot, és felfedeztem, hogy a csapat ebben az időben egy problémával küzd. Az problémát az okozta, hogy az oldalak átlagos betöltési ideje 4 másodpercig emelkedett, ami kétszerese volt az előzőnek.
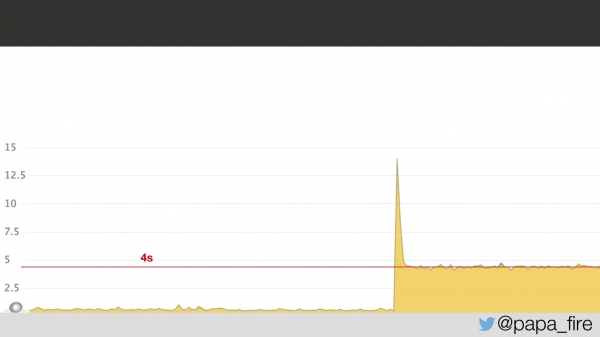
A grafikon alapján nyilván történt valami, de nem volt világos, hogy mi. Kiderült, hogy a probléma a hálózati késleltetésben volt az adatközpontban: 5 ms késleltetés az adatközpontban 2 másodpercre nőtt a felhasználók számára. Hogy ez miért történt, nem tudtam, de mindenesetre kiderült, hogy a probléma az adatközpontban rejlik.
Első nap
Eltelt két nap, és az első munkanapomon úgy találtam, hogy a probléma még mindig nem múlott el.
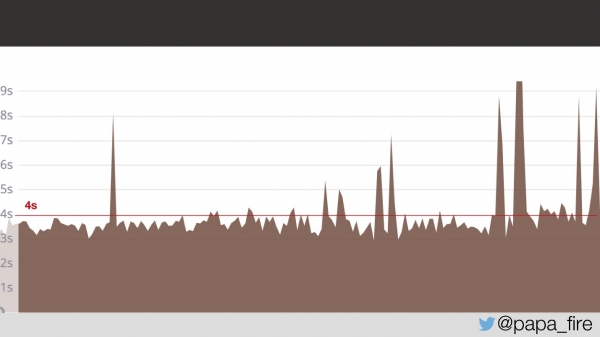
Két napig a felhasználóknak az oldalak átlagosan 4 másodperc alatt töltődtek be. Kérdezem, hogy találtak-e megoldást a problémára.
— Igen, megnyitottunk egy jegyet.
— És?
— Nos, eddig még nem válaszoltak.
Ekkor rájöttem, hogy mindaz, amit korábban mondtak nekem, csak a jéghegy csúcsa, amivel harcolni kell.
Van egy jó idézet, amely nagyon illik ehhez az esetre:
„Néha a technológia megváltoztatásához a szervezetet is meg kell változtatni.”
De mivel a legforgalmasabb időszakban kezdtem a munkát, mindkét megoldási alternatívát meg kellett nézni: a gyorsat és a hosszú távút. És azonnal a kritikus dolgokkal kellett kezdeni.
Harmadik nap
Tehát a betöltési idő 4 másodperc, és 13 és 15 óra között voltak a legnagyobb csúcsok.
A harmadik napon ebben az időszakban a betöltési sebesség így nézett ki:
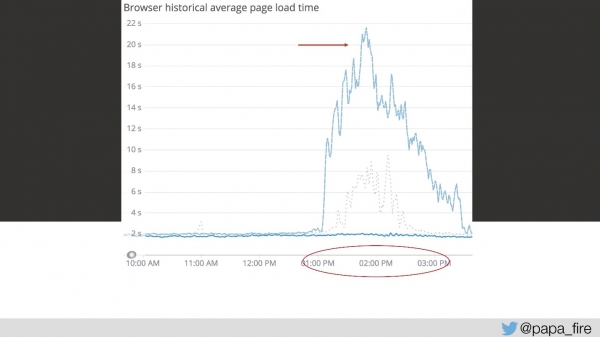
Szerintem semmi sem működött. Mindenki más szerint kicsit lassabban működött, mint általában. De ez biztosan nem lehet véletlen — ez egy komoly probléma.
Megpróbáltam meggyőzni a csapatot, amire azt válaszolták, hogy egyszerűen több szerverre van szükség. Ez természetesen egy megoldás a problémára, de egyáltalán nem mindig az egyetlen és leghatékonyabb. Kérdeztem, hogy miért nincs elég szerver, mekkora a forgalom. Extrapoláltam az adatokat, és megkaptam, hogy körülbelül 150 kérés másodpercenként, ami elvileg ésszerű határokon belül van.
De ne felejtsük el, hogy a helyes válasz megválaszolásához a helyes kérdést kell feltenni. A következő kérdésem az volt: hány frontend szerverünk van. A válasz kissé megdöbbentett — 17 frontend szerverünk volt!
— Meg akarom kérdezni, hogy 150 osztva 17-tel kb. 8? Azt akarja mondani, hogy minden szerver 8 kérést enged át másodpercenként, és ha holnap 160 kérés érkezik másodpercenként, akkor szükségünk lesz még 2 szerverre?
Természetesen nem volt szükségünk további szerverekre. A megoldás a kódban volt, ráadásul a felszínen:
var currentClass = classes.getCurrentClass();
return currentClass;
Volt egy funkció getCurrentClass(), mert minden a webhelyen az osztály kontextusában működik — ez helyes. És egyetlen ilyen funkcióra minden oldalon 200+ kérés jutott.
A megoldás így nagyon egyszerű volt, még csak újra sem kellett írni semmit: egyszerűen nem kérdeztük le ugyanazt az információt újra.
if ( !isDefined("REQUEST.currentClass") ) {
    var classes = new api.private.classes.base();
   REQUEST.currentClass = classes.getCurrentClass();
}
return REQUEST.currentClass;
Nagyon megörültem, mert azt hittem, hogy a harmadik napon megtaláltam a fő problémát. Mennyire naiv voltam, ez csak egy a sok probléma közül.
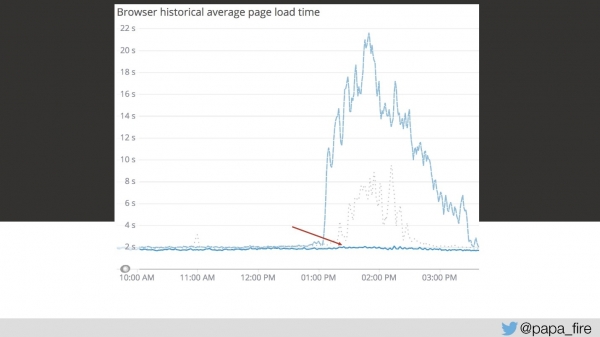
De az első probléma megoldása a grafikont sokkal alacsonyabbra szorította.
Ugyanakkor más optimalizálásokkal is foglalkoztunk. Sok minden a felületen volt, ami javításra várt. Például a harmadik napon felfedeztem, hogy a rendszerben volt cache (először azt hittem, hogy minden kérés azonnal az adatbázisból érkezik). Amikor a cache-re gondolok, az átlagos Redis vagy Memcached jut eszembe. De csak én gondoltam így, mert a rendszer cache-eléséhez a MongoDB-t és az SQL Servert használták — ugyanazt, ahonnan éppen az adatokat olvastuk.
Tizedik nap
Az első héten a problémákkal foglalkoztam, amelyeket azonnal meg kellett oldani. Valahol a második héten először jártam a stand-up-on, hogy beszélgessek a csapattal, megnézzem, mi történik, és hogyan halad az egész folyamat.
Ismét érdekes dologra bukkantunk. A csapat a következőkből állt: 18 fejlesztő; 8 tesztelő; 3 menedzser; 2 építész. És mindannyian részt vettek a közös rituálékban, vagyis több mint 30 ember érkezett a stand-upra minden reggel, és elmondta, mit csináltak. Nyilvánvaló, hogy a találkozó nem 5, és nem is 15 percig tartott. Senki sem hallgatta meg a másikat, mert mindannyian különböző rendszereken dolgoztak. Ebben a formában 2-3 ticketet óránként a grooming session alatt már jó eredménynek számított.
Az első dolog, amit tettünk, az a csapat termékvonalak szerint több részre osztása volt. Külön csapatokat hoztunk létre a különböző szekciókhoz és rendszerekhez, amelyek fejlesztőket, tesztelőket, termékmenedzsereket és üzleti elemzőket is tartalmaztak.
Ennek eredményeként kaptuk:
- A megbeszélések és találkozók számának csökkenése.
- A termék mélyebb megértése.
- Saját felelősség érzése. Amikor korábban az emberek folyamatosan átjártak a rendszerek között, tudták, hogy a saját hibáik kijavítását valószínűleg másnak kell majd elvégeznie, nem nekik maguknak.
- Együttműködés a csoportok között. Nem szükséges mondani, hogy a QA és a fejlesztők korábban nem igazán kommunikáltak, a termékmenedzser a saját dolgával foglalkozott stb. Most közös felelősségi pontjuk van.
Főként a hatékonyságra, teljesítményre és minőségre összpontosítottunk – éppen ezekben a kérdésekben próbáltuk megoldani a csapat átalakulását.
Tizenegyedik nap
A csapat struktúrájának megváltoztatása során felfedeztem, hogy hogyan számolják a StoryPoints. 1 SP egy napnak felelt meg, és minden jegy tartalmazott SP-t a fejlesztéshez és a QA-hoz is, tehát legalább 2 SP-t.
Hogyan fedeztem ezt fel?
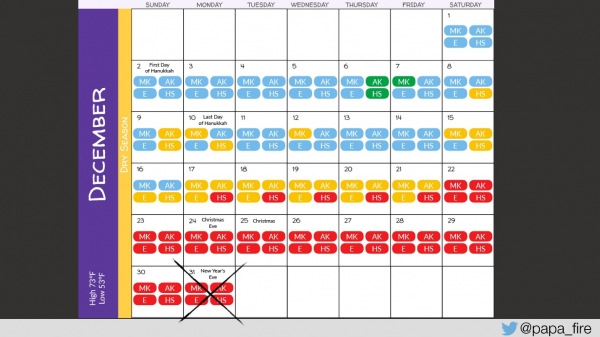
Találtunk egy hibát: egy jelentésben, ahol a jelentési periódus kezdő és végdátumát adják meg, nem veszi figyelembe az utolsó napot. Tehát valahol a lekérdezésben nem <= állt, hanem csak <. Azt mondták, hogy ez három Story Points, tehát 3 nap.
Ezt követően:
- Áttekintettük a Story Points értékelési rendszerét. Most a kisebb hibák javítása, amelyeket gyorsan át lehet futtatni a rendszeren, gyorsabban eljut a felhasználókhoz.
- Kezdtük összefogni a kapcsolódó jegyeket a fejlesztéshez és teszteléshez. Korábban minden jegy, minden hiba egy zárt ökoszisztéma volt, amely nem volt kötve semmi máshoz. Három gomb megváltoztatása egy oldalon három különálló jegyet jelenthetett három különböző QA folyamattal egy automatikus teszt helyett az oldalon.
- A fejlesztőkkel együtt dolgozva kidolgoztuk a munkaerő-értékelési megközelítést. Három nap, hogy megváltoztassunk egy gombot – ez nem vicc.
Huszadik nap
Valahol az első hónap közepe felé a helyzet kissé stabilizálódott, átláttam, hogy főként mi történik, és már a jövőbe néztem, és hosszú távú megoldásokon gondolkodtam.
Hosszú távú célok:
- Kezelt platform. Több száz kérés minden oldalon – ez nem komoly.
- Előrejelezhető tendenciák. Rendszeresen voltak forgalmi csúcsok, amelyek első pillantásra nem korreláltak más metrikákkal – meg kellett értenünk, miért történik ez, és hogyan tudjuk előre jelezni.
- A platform bővítése. Az üzlet folyamatosan növekszik, egyre több felhasználó érkezik, nő a forgalom.
A múltban gyakran mondták: „Írjunk át mindent [nyelv/framework] nyelvre, minden jobban fog működni!”
A legtöbb esetben ez nem működik, jó, ha az átírt tényleg működik. Ezért szükség volt egy roadmap létrehozására – egy konkrét stratégiára, amely lépésről lépésre illusztrálja, hogyan érjük el az üzleti célokat (mit fogunk tenni és miért), amely:
- tükrözi a projekt küldetését és céljait;
- prioritizálja a fő célokat;
- tartalmaz egy időzítést a megvalósításukhoz.
Előtte senki sem beszélt a csapattal arról, hogy milyen céllal történnek a bármilyen változások. Ehhez megfelelő sikerindikátorokra van szükség. Először a cég történetében KPI-t állítottunk fel a műszaki csapat számára, amelyet az üzleti mutatókhoz kötöttünk.
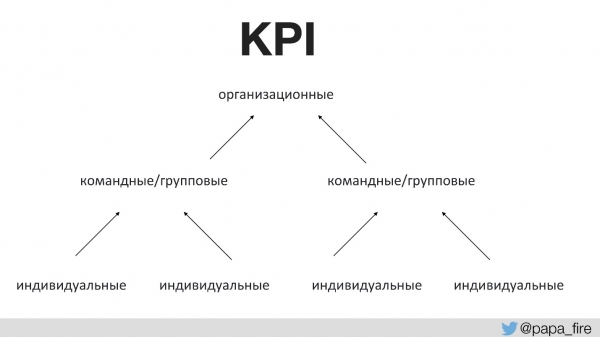
Tehát az üzleti KPI-kat a csapatok, a csapat KPI-jait pedig az egyének támogatják. Ellenkező esetben, ha a technológiai KPI-k nem egyeznek meg az üzleti célokkal, akkor mindenki a saját érdekeit nézi.
Például az egyik üzleti KPI – a piaci részesedés növelése új termékek által.
Mivel lehet támogatni a célt, hogy több új termékünk legyen?
- Először is, szeretnénk több időt szentelni új termékek fejlesztésének a hibák javítása helyett. Ez logikus döntés, amely könnyen mérhető.
- Másodszor, szeretnénk támogatni a tranzakciók volumenének növekedését, mert minél nagyobb a piaci részesedés, annál több felhasználó, és ennek következtében annál nagyobb a forgalom.
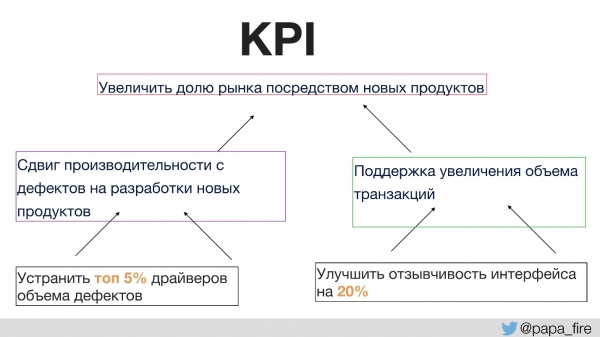
Akkor az egyéni KPI-k, amelyek a csoporton belül teljesülnek, például abból a helyből fognak származni, ahonnan a fő hibák érkeznek. Ha pontosan erre a szekcióra fókuszálunk, sokkal kevesebb hiba fog keletkezni, ezáltal több időt lehet szentelni új termékek fejlesztésére és ismét a vállalati KPI-k támogatására.
Így tehát minden döntés, beleértve a kód újraírását is, támogatnia kell a konkrét célokat, amelyeket a cég előttünk állított (a szervezet növekedése, új funkciók, személyzet felvétele).
A folyamat során egy érdekes dolog derült ki, amely nemcsak a technikai csapatnak, hanem a vállalatnak is hír volt: minden jegynek legalább egy KPI-ra kell összpontosítania. Tehát, ha a termékmenedzser azt mondja, hogy új funkciót akar létrehozni, az első kérdésnek a következőnek kell lennie: „Melyik KPI-t támogatja ez a funkció?” Ha nincs, akkor sajnálom – úgy tűnik, ez egy szükségtelen funkció.
Harmincadik nap
A hónap végén felfedeztem egy másik szempontot, hogy az Ops csapatomból senki sem látta soha a velünk kötött szerződéseket. Kérdezheted, miért fontos ez.
- Először is, mert a szerződésekben SLA-k vannak rögzítve.
- Másodszor, az SLA-k mind különbözőek. Minden ügyfél a saját követelményeivel érkezett, míg az értékesítési osztály hátat fordítva írta alá őket.
Még egy érdekes szempont – az egyik legnagyobb ügyfélünk szerződésében az áll, hogy a platform által támogatott szoftververzióknak n-1-nek kell lenniük, vagyis nem a legújabb verziónak, hanem az utolsó előtti verziónak.
Nyilvánvaló, mennyire távol voltunk az n-1-től, ha a platform ColdFusion-on és 2008-as SQL Serveren futott, amit júliusban teljesen leállítottak.
Negyvenötödik nap
A második hónap közepére annyi időm lett, hogy leüljek és megcsináljam értékstreammapping teljes egészében a folyamatra. Ezek olyan szükséges lépések, amelyeket meg kell tenni a termék létrehozásától a fogyasztóhoz való eljuttatásáig, és ezeket a lehető legrészletesebben kell felvázolni.
Feldarabolod a folyamatot kis részekre, és megnézed, mi tart túl sokáig, mit lehet optimalizálni, javítani stb. Például mennyi időt vesz igénybe egy kérés a terméktől, a grooming során, ameddig eljut a ticketig, amit a fejlesztő átvehet, QA stb. Olyan részletesen nézed meg minden egyes lépést, és gondolkozol, hogy mit lehet optimalizálni.
Amikor ezt csináltam, két dolog szemet szúrt:
- a QA-ból a fejlesztőkhez visszautalások magas arányát;
- a pull request értékelések túl sok időt vettek igénybe.
A probléma az volt, hogy ezek olyan megállapítások voltak, mint: úgy tűnik, hogy sok időt vesz igénybe, de nem vagyunk biztosak, hogy pontosan mennyit.
„Nem lehet javítani azt, amit nem lehet mérni.”
Hogyan lehet indokolni, hogy mennyire komoly a probléma? Napokat vagy órákat vesz el?
Ennek mérésére pár lépést adtunk hozzá a Jira folyamathoz: „ready for dev” és „ready for QA”, hogy mérjük, mennyi időt vár el minden jegy, és hány alkalommal tér vissza egy adott lépésre.
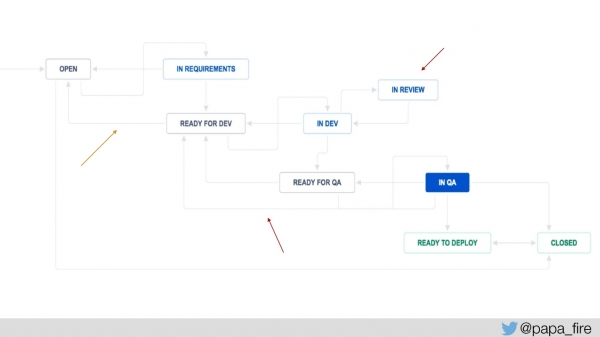
Emellett hozzáadtuk az „in review” státuszt, hogy tudjuk, átlagosan mennyi ideig tartanak a jegyek a felülvizsgálat alatt, és ennek alapján tudjunk továbblépni. Rendelkeztünk rendszermetrikákkal, most új metrikákat is bevezetünk, és elkezdtük mérni:
- A folyamat hatékonyságát: teljesítmény és tervezett/szállított.
- A folyamat minőségét: hibák száma, QA hibák.
Ez valóban segít megérteni, mi működik jól, és mi nem.
Ötvenedik nap
Ez mind szép és érdekes, de a második hónap végére bekövetkezett az, ami tulajdonképpen várható volt, bár nem számítottam ekkora mértékű változásra. Az emberek el kezdtek menni, mert megváltozott a felső vezetés. Új emberek kerültek a vezetőségbe, akik mindent elkezdtek megváltoztatni, és a régiek távoztak. Általában olyan cégeknél, amelyek már néhány éve működnek, mindenki ismeri egymást.
Ez várható volt, de a leépítések mértéke meglepő volt. Például egy héten két csapatvezető egyszerre adta be a felmondását. Ezért nem tudtam nem figyelni más problémákra, hanem a csapat létrehozásárakellett összpontosítanom. Ez egy hosszú és nehezen megoldható probléma, de foglalkozni kellett vele, mert meg akartam tartani azokat az embereket, akik még itt maradtak (vagy a legtöbbjüket). Valamilyen módon reagálni kellett arra, hogy az emberek elmentek, hogy fenntartsuk a csapat morálját.
Elméletben ez jól hangzik: érkezik egy új ember, aki teljes felhatalmazással rendelkezik, hogy felmérje a csapat készségeit és szükség esetén új embereket vigyen a csapatba. Valójában azonban nagyon sok okból nem lehet csak úgy új embereket bevonni. Mindig szükséges a balansz.
- A régiek és az újak között. Meg kell tartani a régi embereket, akik változhatnak és fenntarthatják a küldetést. De ugyanakkor új vért is be kell hozni, erről később még beszélünk.
- Tapasztalat. Sok jó juniorral beszélgettem, akik lángoltak és dolgozni akartak nálunk. De nem tudtam őket felvenni, mert nem volt elegendő senior, aki támogassa a juniorokat és mentorálja őket. Először a felső vezetést kellett felvennem, és csak utána a fiatalokat.
- Kard és mézesbödön.
Nincs jó válaszom arra a kérdésre, hogy mi a helyes egyensúly, hogyan tartsuk fenn, hány embert hagyjunk meg és mennyire nyomjuk őket. Ez egy teljesen egyéni folyamat.
Ötvenegyedik nap
Elkezdtem figyelni a csapatot, hogy megértsem, ki van nálam, és ismét eszembe jutott:
„A legtöbb probléma emberi probléma.”
Felfedeztem, hogy a csapatban, mint olyan — a fejlesztőknél és az Ops-nál egyaránt — három nagy probléma van:
- Az elégedettség a jelenlegi helyzettel.
- Felelősség hiánya — mert senki soha nem kapcsolta össze a végrehajtók munkájának eredményeit az üzleti hatással.
- A változásoktól való félelem.
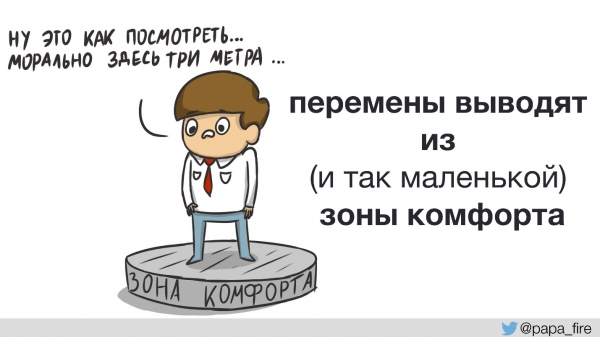
A változások mindig kibillentenek a komfortzónából, és minél fiatalabbak az emberek, annál inkább nem szeretik a változásokat, mert nem értik, miért, és nem tudják, hogyan. A leggyakoribb válasz, amit hallottam: „Ezt soha nem csináltuk így.” Sőt, eljutott odáig a dolog, hogy a legkisebb változások is úgy zajlottak, hogy valaki mindig felháborodott. És nem számított, mennyire érintette a munkájukat a változás, az emberek azt mondták: „Nem, minek? Ez nem fog működni.”
De nem lehet jobbá válni, ha nem változtatunk semmin.
Teljesen abszurd beszélgetésem volt egy munkatárssal, elmondtam neki az optimalizálási ötleteimet, amire ő azt mondta:
— Aha, azt nem láttad, hogy mi volt tavaly!
— És mi van?
— Most sokkal jobb, mint volt.
— Szóval nem lehet még jobb?
— Miért?
Jó kérdés — miért? Mintha, ha most jobb, mint volt, akkor minden elég jó. Ez a felelősség hiányához vezet, ami alapvetően teljesen normális. Mint mondtam, a technikai csapat egy kicsit el volt hanyagolva. A cég úgy vélte, hogy lenniük kell, de senki soha nem állította fel a standardokat. A technikai támogatás soha nem látott SLA-t, ezért a csapat számára teljesen „elfogadható” volt (és ez meglepett a legjobban):
- 12 másodperc betöltés;
- 5-10 perc downtime minden kiadáskor;
- a kritikus hibák elhárítása napokat és heteket vesz igénybe;
- nincs 24/7-es ügyelet és on-call.
Senki soha nem próbálta megkérdezni, miért ne tehetnénk ezt jobban, és senki soha nem értette, hogy ez így nem lehet.
Bónuszként volt még egy probléma: a tapasztalat hiánya. A szeniorok elmentek, és a hátralévő fiatal csapat a régi rendszer mellett nőtt fel, és ezzel mérgezték őket.
Mindezek mellett az emberek még attól is féltek, hogy kudarcot vallanak, és alkalmatlanoknak tűnnek. Ez abban nyilvánul meg, hogy először is, semmilyen körülmények között nem kértek segítséget. Hányszor beszéltünk már csoportosan és egyénileg, és mondtam: „Tegyetek fel kérdéseket, ha nem tudjátok, hogyan kell valamit megcsinálni”. Magabiztos vagyok, és tudom, hogy bármilyen problémát meg tudok oldani, de ez időt vesz igénybe. Tehát, ha lehet, inkább megkérdezek valakit, aki tudja, hogyan kell megoldani 10 perc alatt. Minél kevesebb tapasztalatod van, annál inkább félsz kérdezni, mert azt gondolod, hogy alkalmatlanok tartanak.
Ez a kérdezéstől való félelem érdekes formákban nyilvánul meg. Például megkérdezed: „Hogy áll az a feladat?” — „Még pár órám van, már majdnem kész vagyok.” Másnap újra megkérdezed, választ kapsz, hogy minden rendben van, de volt egy kis probléma, ami miatt biztosan kész lesz a nap végére. Még egy nap telik el, és amíg a falhoz nem szorítod, és nem kényszeríted, hogy beszéljen valakivel, ez így folytatódik. Az ember szeretné saját magának megoldani a problémát, hiszen úgy érzi, hogy ha nem ő oldja meg, az nagy kudarc lesz.
Ezért a fejlesztők túlbecslik az időt. Ez igazán vicces volt, amikor egy meghatározott feladatot vitattunk, és egy olyan számot kaptam, amiből nagyon meglepődtem. Amire azt mondták, hogy a becslésekben a fejlesztő beleveszi az időt is, amíg a ticket visszajön a QA-ból, mert ott hibákat találnak, és az időt, ami a PR-ra vonatkozik, illetve az időt, amíg azok, akiknek át kell nézniük, elfoglaltak lesznek – azaz minden lehetséges dolgot.
Másodszor, az emberek, akik attól félnek, hogy alkalmatlannak tűnnek, túlanalizálják. Amikor mondod, hogy mit kell konkrétan tenni, kezdődnek azzal: „Nem, de mi van, ha itt gondolkodunk?” Ebben a tekintetben a mi cégünk nem egyedi, ez a fiatalok általános problémája.
Válaszul bevezettem az alábbi gyakorlatokat:
- 30 perces szabály. Ha fél órán belül nem tudod megoldani a problémát, kérj meg valakit, hogy segítsen. Ez változó sikerrel működik, mert az emberek úgyis ritkán kérnek segítséget, de legalább a folyamat megkezdődött.
- Kizárni mindent, kivéve a lényeget, az időbecslésben, azaz csak azt számolni, hogy mennyi időt vesz igénybe a kód írása.
- Folyamatos tanulás azok számára, akik túlanalizálnak. Ez egyszerűen folyamatos munka az emberekkel.
A hatvanadik nap
Miközben mindezzel foglalkoztam, eljött az idő, hogy foglalkozzak a költségvetéssel. Természetesen sok érdekes dolgot találtam abban, hova költöttük a pénzt. Például volt egy teljes állvány egy külön adatközpontban, amelyen egy FTP-szerver állt, amit egy ügyfél használt. Kiderült, hogy „... költöztünk, és ő ott maradt, nem cseréltük le”. Ez két éve történt.
Különös érdeklődés övezte a felhőszolgáltatások számláját. Biztos vagyok benne, hogy a magas felhőszámla fő oka a fejlesztők, akiknek először van korlátlan hozzáférésük a szerverekhez. Nem kell kérniük: „Kérek egy tesztszervert”, - maguk is elérhetik. Ráadásul a fejlesztők mindig olyan menő rendszert akarnak építeni, amelytől a Facebook és a Netflix is irigykedne.
De a fejlesztőknek nincs tapasztalatuk szerverek beszerzésében és a megfelelő méretű szerverek meghatározásában, mert erre korábban nem volt szükségük. Ráadásul általában nem egészen értik a skalázhatóság és a teljesítmény közötti különbséget.
Az eszközleltár eredményei:
- Kijöttünk egy adatközpontból.
- Felmondtuk a szerződést 3 logisztikai szolgáltatóval. Mert 5 volt belőlük - minden egyes fejlesztő, aki belekezdett valamibe, új szolgáltatást kért.
- Leállítottunk 7 AWS-rendszert. Ismételten, a halott projektek senki sem állította le, azok tovább működtek.
- A szoftverköltéseinket 6-szor csökkentettük.
Hetvenötödik nap
Eltelt az idő, és két és fél hónappal később találkoznom kellett az igazgatótanáccsal. A tanácsunk nem jobb és nem rosszabb, mint a többi, mint minden igazgatótanács, ők is mindent szeretnének tudni. Az emberek befektetnek, és meg akarják érteni, hogy amit csinálunk, illeszkedik-e a meghatározott KPI-kbe.
Az igazgatótanács havonta sok információt kap: a felhasználók száma, növekedésük, hogy milyen szolgáltatásokat használnak, hogyan, a teljesítmény és a produktivitás, végül pedig az átlagos oldal betöltési sebesség.
A probléma csak az, hogy azt gondolom, az átlagos érték tiszta rossz. De nagyon nehéz ezt az igazgatótanácsnak elmagyarázni. Ők aggregált számokkal operálnak, nem például a betöltési idő szórásával másodpercben.
Ennek kapcsán érdekes pillanatok is voltak. Például azt mondtam, hogy a forgalmat az egyes webszerverek között a tartalom típusa szerint kell elosztani.
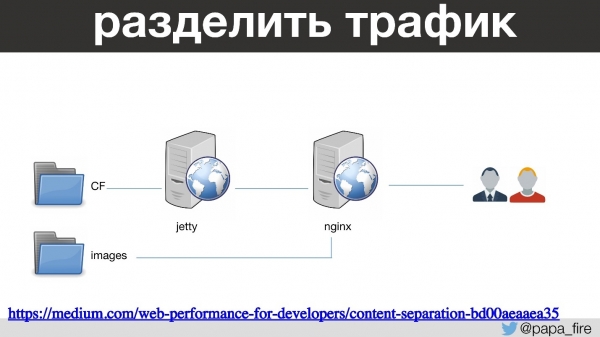
Tehát a ColdFusion a Jetty-n és az nginx-en keresztül fut, és generálja az oldalakat. A képek, JS és CSS külön nginx-en keresztül, saját konfigurációikkal érkeznek. Ez egy elég standard gyakorlat, amiről beszéltem még pár évvel ezelőtt. Ennek eredményeként a képek sokkal gyorsabban tööltődnek be, és ... az átlagos betöltési sebesség 200 ms-ra nőtt.
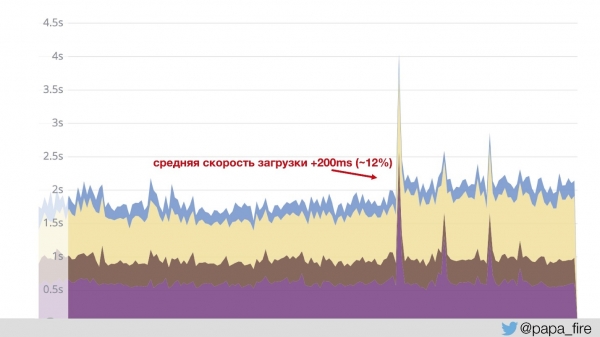
Ez azért történt, mert a grafikon az adatokat a Jetty-től kapja. Tehát a gyors tartalmak nem kerülnek számításra - az átlagérték megugrott. Ezt értettük, nevettünk rajta, de hogyan magyarázzuk el a igazgatóságnak, hogy miért csináltunk valamit, ami 12%-kal rosszabb lett?
Nyolcvanötödik nap
A harmadik hónap végére rájöttem, hogy egy dologra egyáltalán nem számítottam - ez pedig az idő. Minden, amiről beszéltem, időt igényel.
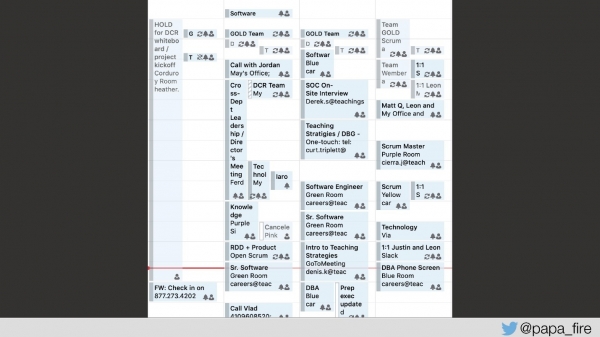
Ez az én valódi heti naptáram - csak munkahelyi hét, nem nagyon leterhelt. Mindenre nem jut idő. Ezért ismét embereket kell felvenni, akik segítenek kezelni a problémákat.
Zárás
Ez még nem minden. Ebben a történetben még nem is jutottam el addig, hogy hogyan dolgoztunk a termékkel és próbáltunk egy közös hullámhosszra kerülni, vagy hogyan integráltuk a technikai támogatást, vagy hogyan oldottuk meg más technikai problémákat. Például teljesen véletlenül megtudtam, hogy a legnagyobb táblákban az adatbázisban nem használunk SEQUENCE. Van egy saját fejlesztésű függvényünk, nextID, és ezt nem tranzakcióban használjuk.
Több millió hasonló dolog volt, amiről hosszasan lehetett volna beszélni. De a legfontosabb, amiről még érdemes szólni, az a kultúra.
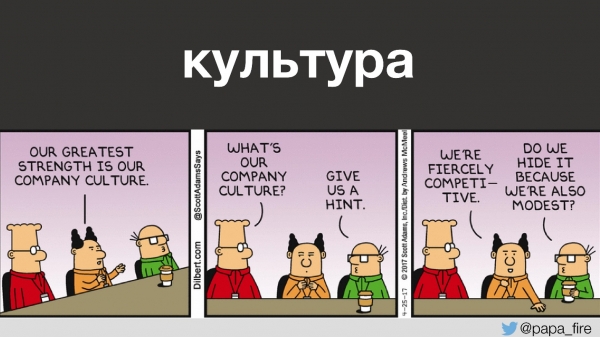
Pontosan a kultúra, vagy annak hiánya vezet minden más problémához. Olyan kultúrát próbálunk építeni, ahol az emberek:
- nem félnek a kudarctól;
- tanulnak a hibáikból;
- együttműködnek más csapatokkal;
- kezdeményeznek;
- vállalják a felelősséget;
- üdvözlik az eredményt mint célt;
- ünneplik a sikert.
Ezzel minden más is eljön.
Leon Fire , és .
A legacy-vel kapcsolatban két stratégia van: mindent elkerülni, vagy bátran szembenézni a kapcsolódó nehézségekkel. Mi a második utat választjuk, változtatva a folyamatainkon és megközelítéseinken. Csatlakozz hozzánk a , és , és együtt vezessük be a DevOps kultúrát.
Forrás: habr.com
