

A SRE/DevOps engineer environment is no surprise when a client (or monitoring system) suddenly reports that "everything is lost": the site is not working, payments are failing, life feels bleak... No matter how much we want to help in such a situation, doing so without a simple and clear tool can be quite difficult. Often, the problem is hidden within the application's code — it just needs to be localized.
In both sorrow and joy…
It so happened that we have loved New Relic for quite some time now. It has been and continues to be an excellent tool for application performance monitoring, as well as allowing for the instrumentation of microservice architecture (using its agent) and much, much more. Everything could be wonderful if it weren't for the changes in the pricing policy of the service: its ár . Additionally, since last year, obtaining a trial account requires communication with a personal manager, which complicates the presentation of the product to potential clients.A common situation: New Relic is not needed on a "permanent basis"; it is only remembered when problems arise. But payment is still required regularly (140 USD per server per month), and in an automatically scalable cloud infrastructure, these amounts add up significantly. Although there is a "Pay-As-You-Go" option, enabling New Relic requires restarting the application, which can lead to losing the problematic situation that initiated everything. Recently, New Relic introduced a new pricing plan —
Essentials Key Transactions Cross Application Tracing, Distributed Tracing, As a result, we began to consider searching for a cheaper alternative, and we settled on two services: Datadog and Atatus. Why exactly them?).
On competitors
I would like to clarify that there are other solutions available in the market. We even considered Open Source options, but not every client has the spare resources to host self-hosted solutions... — moreover, they require additional maintenance. The pair we chose turned out to be the closest to
our needs нашим потребностям:
- beépített és fejlett támogatás PHP-alkalmazásokhoz (az ügyfeleinknél használt technológiai stack nagyon változatos, de ez egyértelmű vezető az alternatíva keresésében a New Relic-hez képest);
- megfizethető ár (kevesebb mint 100 USD havonta a hosztért);
- automatikus eszközbeállítás;
- Kubernetes integráció;
- a New Relic felületének hasonlósága — szembetűnő előny (mert mérnökeink hozzászoktak).
Ezért az első szűrési szakaszban néhány más népszerű megoldást kizártunk, többek között:
- Tideways, AppDynamics és Dynatrace — az ár miatt;
- Stackify — Oroszországban blokkolva van és túl kevés adatot mutat.
A következő írás úgy van felépítve, hogy először röviden bemutatjuk a vizsgált megoldásokat, majd mesélek a New Relic-kel folytatott tipikus együttműködésünkről és a más szolgáltatásokban végzett hasonló műveletek tapasztalatairól/benyomásairól.
A kiválasztott versenytársak bemutatása
A , talán már hallott róla mindenki? Ez a szolgáltatás több mint 10 éve, 2008-ban indult. 2012 óta aktívan használjuk, és nem tapasztaltunk problémát a valóban nagy számú PHP, Ruby és Python nyelvű alkalmazás integrálásával, valamint tapasztalatunk volt a C# és Go integrációjával is. A szolgáltatás szerzőinek megoldásai vannak az alkalmazások, infrastruktúrák monitorozására, mikroserviz alapú infrastruktúrák nyomozására, kényelmes alkalmazásokat készítettek felhasználói eszközökre és még sok mást.
Azonban a New Relic ügynök saját protokollokon működik, és nem támogatja az OpenTracing-et. A kiterjesztett eszközbeállításhoz külön módosításokat kell végrehajtani a New Relic számára. Végül, a Kubernetes támogatás jelenleg kísérleti státuszú.
2010-ben indult fejlesztése szembetűnően érdekesebbnek tűnik a New Relic-nél, különösen a Kubernetes-környezetekben való alkalmazása szempontjából. Különösen támogatja az integrációt az NGINX Ingress-szel, a naplógyűjtést, a statsd és OpenTracing protokollokat, ami lehetővé teszi a felhasználói kérés nyomon követését a csatlakozás pillanatától a munka befejezéséig, valamint a kéréshez tartozó naplók megkeresését (mind a webszerver, mind a fogyasztók oldalán).
A Datadog használata során szembesültünk azzal, hogy néha hibásan építette fel a mikroservizek térképét, és néhány technikai hiányossággal. Például tévesen határozta meg a szolgáltatás típusát (a Django-t gyorsítótárazó szolgáltatásként értelmezte) és 500-as hibákat okozott egy PHP-alkalmazásban, amely a népszerű Predis könyvtárat használta.
— a legújabb eszköz; a szolgáltatás 2014-ben indult. A marketingköltségvetése nyilvánvalóan elmarad a korábban említett versenytársakétól, említések sokkal ritkábbak. Ennek ellenére maga az eszköz nagyon hasonlít a New Relic-re, és nemcsak a funkciókban (APM, böngészőmegfigyelés stb.), hanem a megjelenésében is.
Jelentős hátrány, hogy csak a Node.js-t és a PHP-t támogatja. Másrészt, a megvalósítása lényegesen jobb, mint a Datadog esetében. Eltérően az utóbbitól, az Atatus nem igényli az alkalmazások módosítását és további címkék beállítását a kódban.
Hogyan dolgozunk a New Relic-kel
Most nézzük meg, hogyan használjuk általában a New Relic-t. Tegyük fel, hogy van egy probléma, amely megoldást igényel:
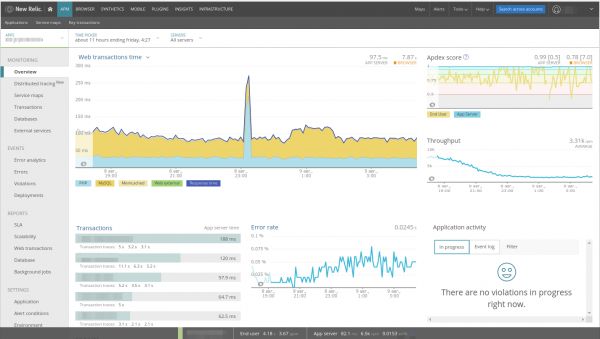
A grafikonon könnyen észlelhető kiugrás — elemezzük ezt. A New Relic-ben a webalkalmazás számára azonnal kiválasztásra kerültek a webes tranzakciók, a teljesítménygrafikonban szerepelnek az összes komponens, valamint megtalálhatók a hibasebesség, kéréssebesség panelek… Ami a legfontosabb — közvetlenül ezekből a panelekből navigálhatunk az alkalmazás különböző részeibe (például a MySQL-re kattintva a adatbázisok részéhez juthatunk).
Mivel a vizsgált példában látható a tevékenység kiugrása, PHP, kattintsunk erre a grafikonra, és automatikusan átkerülünk a Transactions:
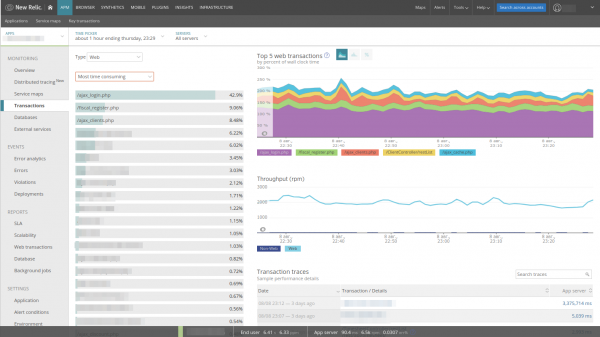
A tranzakciók listája, amelyek lényegében az MVC modell vezérlői, már a Legidőigényesebb, ami nagyon kényelmes: azonnal látjuk, mivel foglalkozik az alkalmazás. Itt találhatók a New Relic által automatikusan összegyűjtött hosszú kérések példái. A rendezés átkapcsolásával könnyen megtalálhatjuk:
- a legnagyobb terhelés alatt álló alkalmazásvezérlőt;
- a leggyakrabban kért vezérlőt;
- a leglassabb vezérlőt.
Ezenkívül minden tranzakció kibővíthető, és láthatjuk, mivel foglalkozott az alkalmazás a kód végrehajtása során:
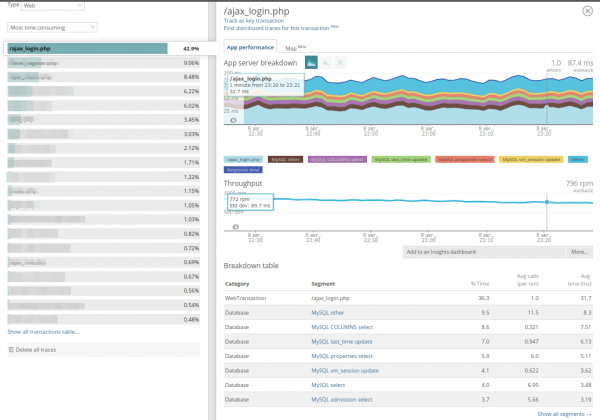
Végül, az alkalmazás tárolja a hosszú kérések nyomvonalainak példáit (amelyek több mint 2 másodpercig futnak). Itt a hosszú tranzakció panelje:
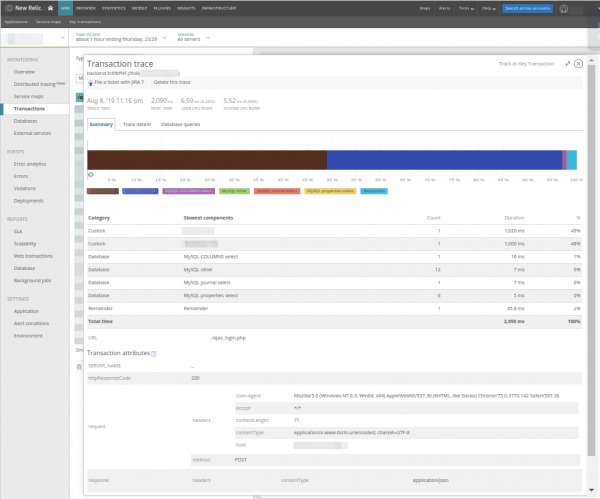
Látható, hogy sok időt igényel két metodus, és mellette megjelenik az is, mikor hajtották végre a kérést, annak URI-ja és domain neve. Nagyon gyakran ez segít megtalálni a kérést a naplókban. Átmenve a Trace details, megnézhetjük, honnan hívják ezeket a metódusokat:
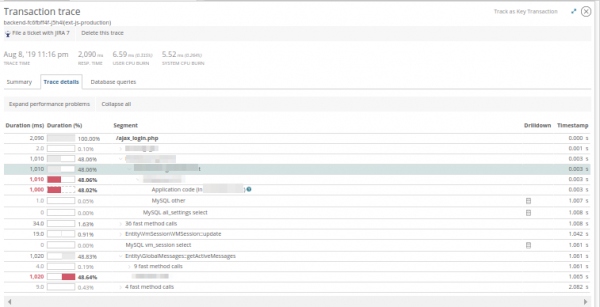
És a Database queries — értékelni a kérdéseket az adatbázisokhoz, amelyek az alkalmazás működése közben futottak:
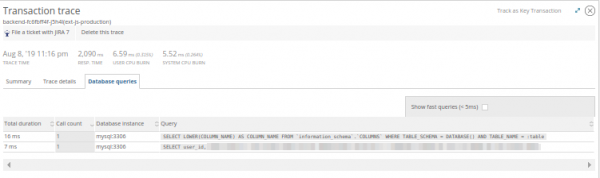
Ez a tudás felvértez minket az alkalmazás lassulásának okainak felmérésére, és lehetővé teszi, hogy a fejlesztővel közösen kidolgozzunk egy probléma-megoldási stratégiát. Valójában a New Relic nem mindig ad világos képet, de segít meghatározni a nyomozás irányát:
- hosszú
PDO::Constructfurcsa működéshez vezetett minket a pgpoll; - időbeli instabilitás
Memcache::Getarra utalt, hogy a virtuális gép beállítása nem megfelelő; - a gyanúsan megemelkedett sablonfeldolgozási idő pedig egy beágyazott ciklushoz vezetett, amely ellenőrizte, hogy 500 avatar megtalálható-e a objektum tárolóban;
- és így tovább…
Előfordulhat az is, hogy a fő képernyőn a kód végrehajtása helyett valami a külső adatok tárolásával kapcsolatos nő — és mindegy, hogy ez mi lesz: Redis vagy PostgreSQL, mindegyik a Adatbázisok.
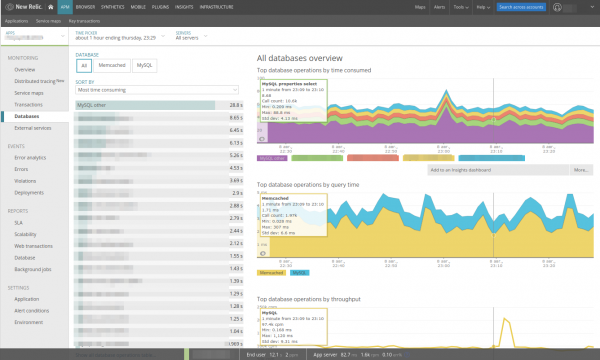
Kiválaszthatunk egy adott adatbázist a vizsgálathoz és végrehajthatjuk a lekérdezések szűrését — hasonlóan ahhoz, ahogyan ezt a Transactions fül alatt tesszük. Ha átmegyünk a lekérdezés fülre, láthatjuk, hogy az a lekérdezés hány alkalommal fordul elő az alkalmazás minden egyes kontrollerében, és azt is felbecsülhetjük, hogy milyen gyakran hívják meg. Ez nagyon kényelmes:
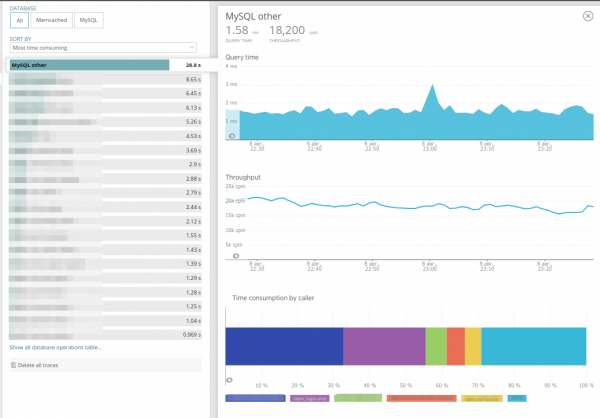
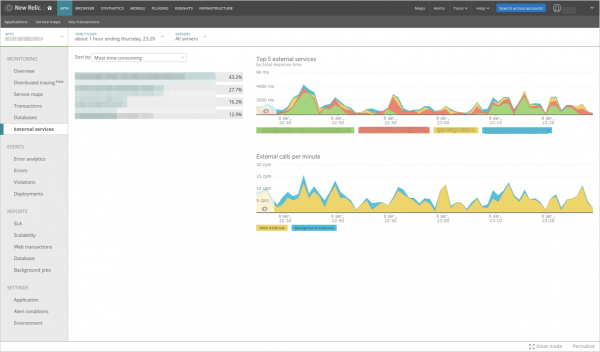
Hasonló adatokat tartalmaz a External Services, amely a külső HTTP-szolgáltatásokra tett lekérdezéseket rejti, mint például az objektumtároló elérése, események küldése a sentry-be vagy hasonló. A tartalma szempontjából a fül teljesen analóg a Databases-szel:
Versenytársak: lehetőségek és benyomások
Most következik a legérdekesebb rész — hasonlítsuk össze a New Relic lehetőségeit a versenytársak által kínáltakkal. Sajnos nem tudtuk tesztelni mindhárom eszközt egyetlen, a gyártásban működő alkalmazás egy verzióján. Ennek ellenére megpróbáltuk összehasonlítani a lehető leginkább hasonló helyzeteket / konfigurációkat.
1. Datadog
A Datadog egy szolgáltatási falat bemutató panellel fogad minket:
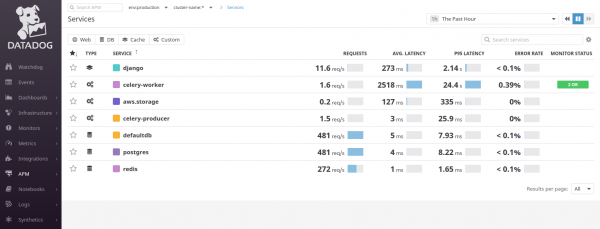
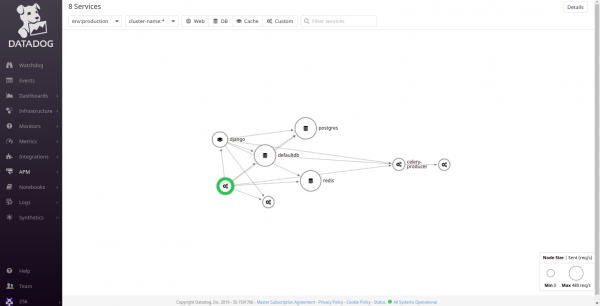
Megpróbálja szétbontani az alkalmazásokat komponensekre / mikroszolgáltatásokra, ezért a megadott példa Django-alkalmazásban két PostgreSQL-kapcsolatot fogunk látni (defaultdb és postgres), valamint Celeryt, Redist. A Datadog használata minimális MVC-elméleti ismereteket igényel: meg kell érteni, hová érkeznek a felhasználói lekérdezések. Ezt általában segíti a szolgáltatások térképe:
Egyébként hasonló található a New Relic-ben:
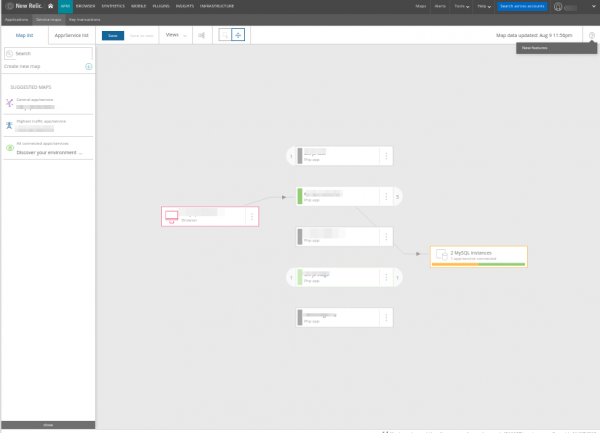
… véleményem szerint azonban a térképe egyszerűbb és érthetőbb: nem egy alkalmazás komponenseit ábrázolja (ami feleslegessé tenné a részletességét, mint a Datadog esetében), hanem csak konkrét szolgáltatásokat vagy mikroszolgáltatásokat mutat.
Visszatérve a Datadogra: a szolgáltatási térképből látható, hogy a felhasználói kérések Django-ba érkeznek. Lépjünk a Django szolgáltatásra, és végre láthatjuk, amire vártunk:
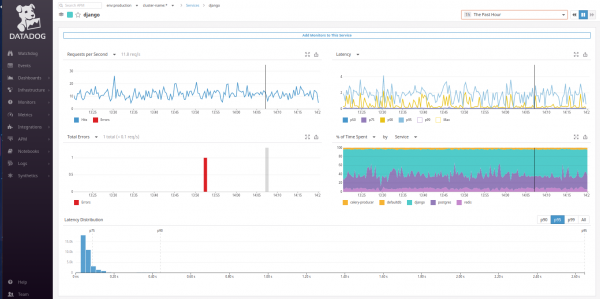
Sajnos itt alapértelmezetten nincs grafikon Web tranzakciós idő, hasonlóan ahhoz, amit a New Relic fő paneljén látunk. Azonban a grafikon helyett beállítható % az eltöltött időből. Elég, ha átkapcsoljuk Kérés szerinti átlagos időtípusok szerint… és máris egy ismerős grafikon néz ránk!
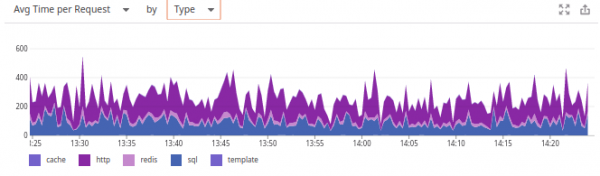
Kérdés számunkra, hogy miért előnyben részesítette a Datadog a másik grafikont — ez titok marad. Az is elszomorító volt, hogy a rendszer nem jegyzi meg a felhasználó választását (ellentétben mindkét versenytárssal), ezért csak a felhasználói panelek létrehozása segít.
Viszont örömteli volt a Datadogban, hogy ezekről a grafikonokról az összekapcsolt szerverek méréseire lehet áttérni, olvasni a naplókat és értékelni a webkiszolgáló feldolgozóinak terhelését (Gunicorn). Minden majdnem ugyanolyan, mint a New Relic… és több (naplók) is!
A grafikonok alatt tranzakciók találhatók, teljesen analóg a New Relic-hez:
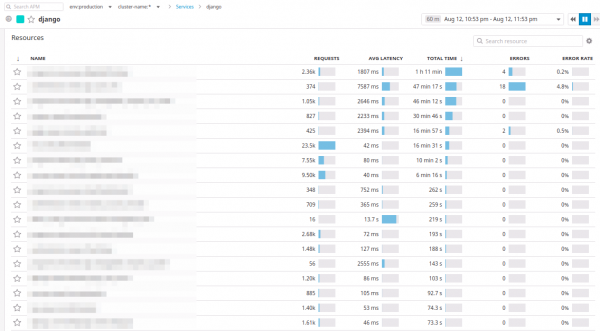
A Datadogban a tranzakciókat nevezzük erőforrásoknak. A vezérlőket a kérések száma alapján, az átlagos válaszidő szerint, vagy a kiválasztott időszak alatt eltöltött maximális idő szerint lehet rendezni.
Az erőforrást ki lehet bontani, és mindazt láthatjuk, amit már a New Relic esetében figyelemmel kísértünk:
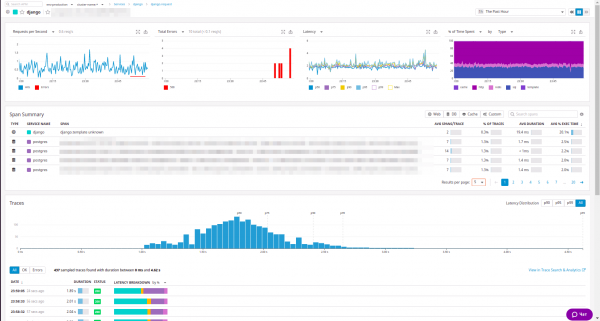
Kaphatók statisztikák az erőforrásról, összesített lista a belső hívásokról és példák a kérésekre, amelyeket a válaszkód szerint lehet rendezni… E sorba rendezés nagyon tetszett mérnökeinknek.
Bármely erőforrás példa a Datadogban kibővíthető és tanulmányozható:
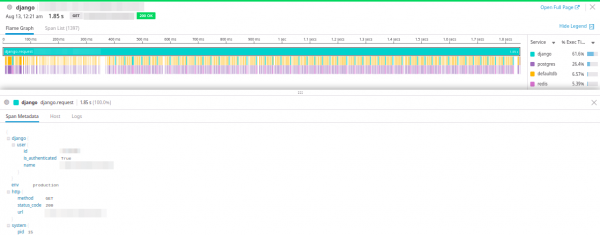
Azt állítják, hogy a kérés paraméterei, az eltöltött idő összefoglaló diagramja minden komponensre és egy vízesés-diagram, amely a hívások sorrendjét mutatja. Továbbá elérhető a vízesés-diagram fában való megjelenítésére is:
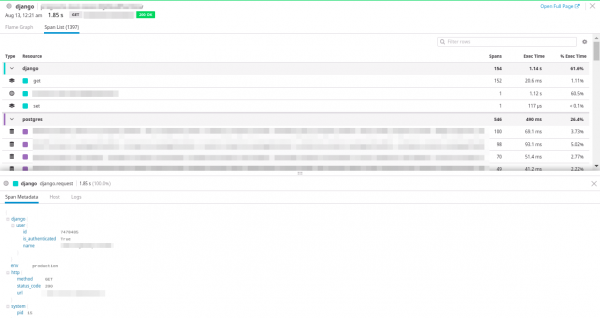
És a legérdekesebb — a terhelés megtekintése a hoszton, ahol a kérés végrehajtásra került, és a kérés naplóinak megnézése.
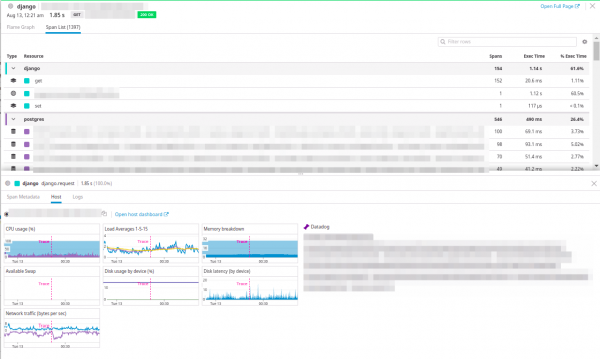
Kiváló integráció!
Felmerülhet a kérdés, hogy hol vannak a lapok Adatbázisok és External Services, mint a New Relicben. Itt nincsenek: mivel a Datadog szétszedi az alkalmazást komponensekre, a PostgreSQL egy külön szolgáltatásnakminősül, a Külső Szolgáltatások helyett pedig az aws.storage (ugyanaz lesz, mint bármely más külső szolgáltatás esetében, amelyhez az alkalmazás hozzáférhet).
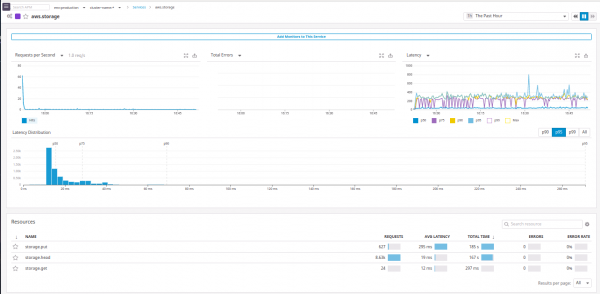
Itt van egy példa a postgres:
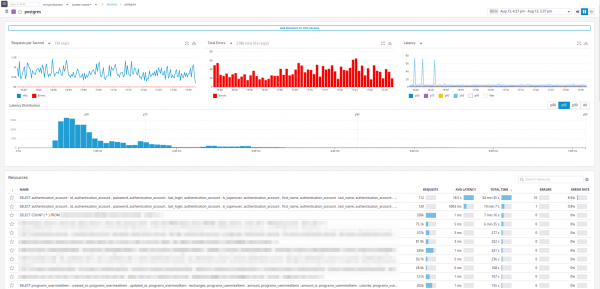
Alapvetően minden megvan, amit akartunk:
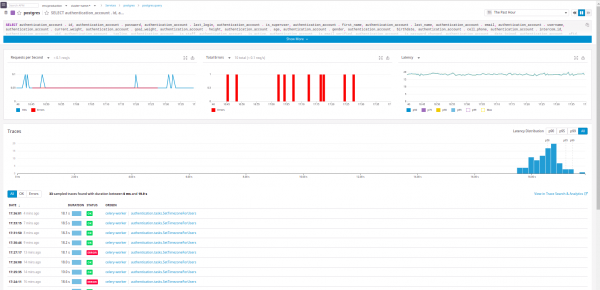
Látható, hogy melyik «szolgáltatásból» jött a kérés.
Nem árt emlékeztetni, hogy a Datadog tökéletesen integrálódik az NGINX Ingress-szel, és lehetővé teszi a teljes nyomkövetést a kérés beérkezésétől a klaszterbe, valamint képes statsd metrikák fogadására, logok és hoszt metrikák gyűjtésére.
A Datadog hatalmas előnye, hogy az ára megfelel az infrastruktúra monitorozásának, APM-nek, Log Management-nek és Synthetics tesztnek, azaz rugalmasan kiválasztható a terv.
2. Atatus
Az Atatus csapata azt állítja, hogy a szolgáltatásuk „ilyen, mint a New Relic, de jobb”. Nézzük meg, hogy ez valóban így van-e.
A fejléctábla valóban hasonlóan néz ki, de nem sikerült meghatározni az alkalmazásban használt Redis és memcached információkat.
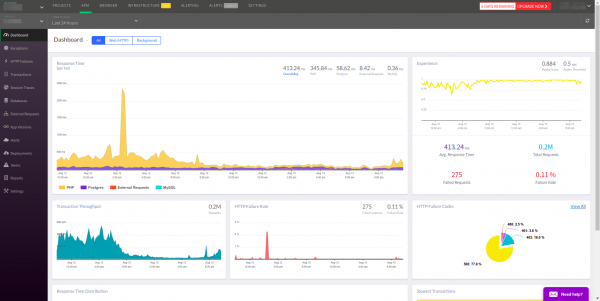
Az APM alapértelmezés szerint az összes tranzakciót kiválasztja, bár általában csak a Web szükséges. Ahogyan a Datadognál, itt sincs lehetőség, hogy az alap panelen a megfelelő szolgáltatásra lépjünk. Ráadásul a tranzakciók a hibák után szerepelnek a listában, ami az APM számára nem annyira logikus.
Az Atatus tranzakcióinál minden maximálisan hasonlít a New Relichez. Hátrány, hogy az egyes vezérlők dinamikáját azonnal nem látni. Ezt a vezérlők táblázatában kell keresni, a következőre rendezve: Legtöbb időt fogyasztó:
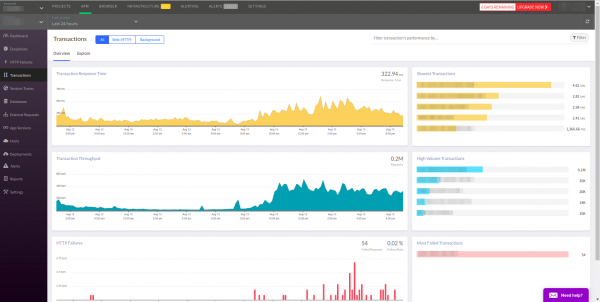
A megszokott vezérlőlistánk elérhető a Felfedezés:
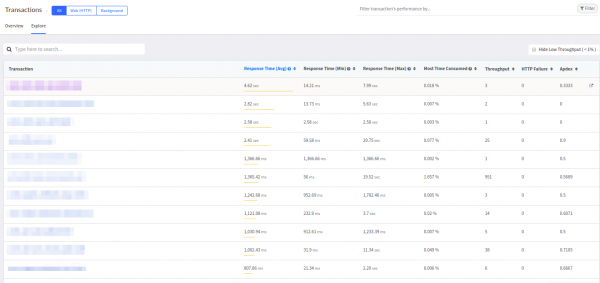
Ez a táblázat egy kicsit hasonlít a Datadogra, és jobban tetszik a New Relichez hasonlító verziónál.
Minden tranzakció kibővíthető, és meg lehet nézni, hogy mivel foglalkozott az alkalmazás:
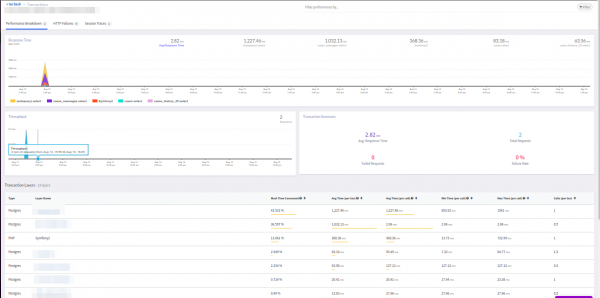
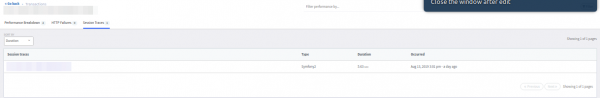
A panel is inkább a Datadogra hasonlít: látható a kérelmek száma, a hívások általános képe. A felső panel egy hibákra vonatkozó lapot biztosít: HTTP hibák és lassú lekérések példái Munkamenet nyomozások:
Ha belépünk egy tranzakcióba, láthatjuk a nyomozás példáját, kaphatunk egy kérést az adatbázishoz, és megnézhetjük a kérelem fejlécét. Minden hasonlít a New Relichez:
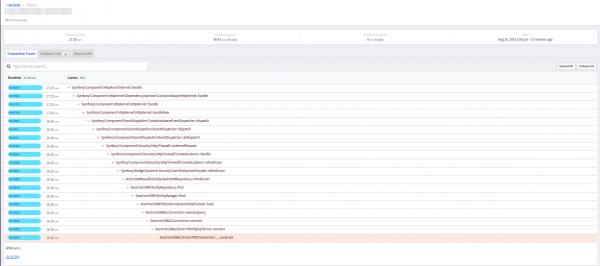
Tényleg, az Atatus részletes nyomozásokat mutatott — a New Relic tipikus hívásainak összevonása nélkül a reminder-blokkba:
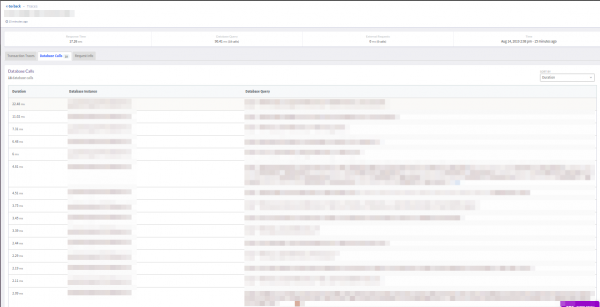
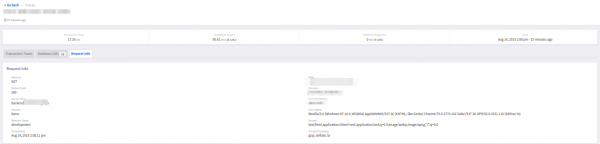
Azonban itt hiányzik egy szűrő, amely (mint a New Relicben) kiszűrné a túl gyors hívásokat (<5ms). Másrészről a tranzakció végső válaszának (sikeres vagy hiba) megjelenítése tetszett.
Panel Adatbázisok segít tanulmányozni a külső adatbázisokhoz intézett kéréseket, amelyeket az alkalmazás végez. Emlékeztetem, hogy az Atatus csak a PostgreSQL-t és a MySQL-t találta, bár a projektben még a Redis és a memcached is használatban van.
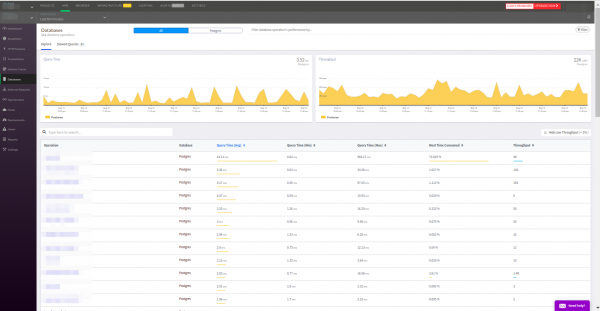
A lekérdezések a megszokott kritériumok alapján vannak rendezve: a hívások gyakorisága, a válaszidők átlaga és így tovább. Különösen megemelném a leglassabb lekérdezések fülét - ez nagyon hasznos. Sőt, az ezen a lapon található adatok a PostgreSQL esetében megegyeznek a bővítmény adataival. — kiváló eredmény!
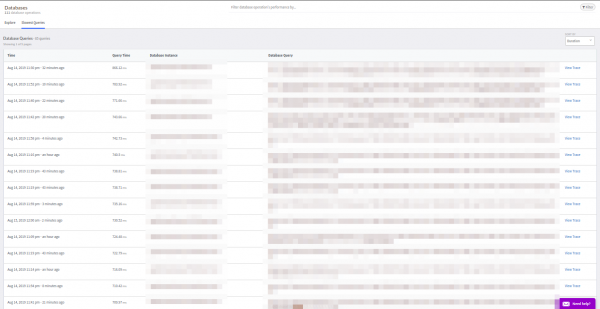
Füle Külső Lekérdezések teljesen azonos a Databases-el.
Következtetések
A bemutatott két eszköz jó teljesítményt nyújtott az APM szerepében. Bármelyikük képes a szükséges minimumot megadni. Röviden összefoglalva a benyomásainkat:
Datadog
Előnyök:
- kényelmes árképzési struktúra (az APM 31 USD/hónap a hosztért);
- kiválóan teljesített Python esetén;
- OpenTracing integrációs lehetőség
- Kubernetes integráció;
- NGINX Ingress integráció.
Hátrányok:
- az egyetlen APM, amely a modul (predis) hibája miatt elérhetetlenné tette az alkalmazást;
- gyenge PHP automatikus eszközölés;
- részben furcsa a szolgáltatások és feladatuk meghatározása.
Atatus
Előnyök:
- mély PHP eszközölés;
- a New Relic-hez hasonló felhasználói felület.
Hátrányok:
- nem működik régi operációs rendszereken (Ubuntu 12.05, CentOS 5);
- gyenge automatikus eszközölés;
- csak két programozási nyelvet támogat (Node.js és PHP);
- lassú felület.
Figyelembe véve az Atatus havi 69 USD-os árat szerverenként, inkább a Datadog-ot használnánk, amely kiválóan integrálódik a mi igényeinkhez (webalkalmazások K8s alatt) és számos hasznos funkciót kínál.
P.S.
Olvasson további információkat a blogunkban:
- «»;
- «»;
- «».
Forrás: habr.com
