

Elmúltak azok a napok, amikor nem kellett aggódni az adatbázisok teljesítményoptimalizálása miatt. Az idő nem áll meg. Minden új technológiai vállalkozó szeretne létrehozni egy új Facebookot, miközben megpróbálja összegyűjteni az összes elérhető adatot. Ezekre az adatokra szüksége van a vállalkozásoknak a modellek jobb betanításához, amelyek segítenek a pénzkeresésben. Ilyen környezetben a programozóknak olyan API-okat kell létrehozniuk, amelyek lehetővé teszik, hogy gyorsan és megbízhatóan dolgozzanak hatalmas mennyiségű információval.
Ha már egy ideje foglalkozik alkalmazások vagy adatbázisok szerveroldali tervezésével, akkor valószínűleg írt már kódot oldaltörésekkel végzett lekérdezésekhez. Például ilyet:
SELECT * FROM table_name LIMIT 10 OFFSET 40
Tényleg így van?
De ha az oldaltöréseket pontosan így végezte, sajnálattal kell megjegyeznem, hogy ezt távolról sem a leghatékonyabb módon tette.
Szeretne vitatkozni velem? . , és már alkalmazzák azokat a technikákat, amelyeket ma szeretnék bemutatni.
Név szerint említsen meg legalább egy backend fejlesztőt, aki soha nem használt OFFSET és LIMIT oldaltörésekkel végzett lekérdezésekhez. MVP (Minimum Viable Product, minimálisan életképes termék) és olyan projektek esetében, ahol kis mennyiségű adatot használnak, ez a megközelítés teljesen alkalmazható. Úgy mondhatni, "csak működik".
De ha megbízható és hatékony rendszereket kell létrehozni a nulláról, érdemes előre gondoskodni az adatbázisokhoz való lekérdezések végrehajtásának teljesítményéről, amelyeket ilyen rendszerekben használnak.
Ma azokról a problémákról fogunk beszélni, amelyek a széles körben használt (kár, hogy így van) oldaltörésekkel végzett lekérdezések megvalósításához kapcsolódnak, és arról, hogyan érhetjük el a magas teljesítményt hasonló lekérdezések végrehajtásakor.
Mi a baj az OFFSET és LIMIT használatával?
Ahogy már említettem, OFFSET és LIMIT remekül teljesítenek azokban a projektekben, ahol nem szükséges nagy mennyiségű adatokkal dolgozni.
A probléma akkor merül fel, ha az adatbázis olyan nagyságúra nő, hogy már nem fér el a szerver memóriájában. De ugyanakkor az adatbázis használata során oldaltörésekkel végzett lekérdezéseket kell használni.
Ahhoz, hogy ez a probléma megjelenjen, olyan helyzetre van szükség, amelyben az adatbázis-kezelő rendszer (DBMS) teljes tábla scan (Full Table Scan) művelethez folyamodik minden lapozással végzett lekérdezés során (ugyanakkor adatok beszúrása és törlése is történhet, és számunkra a régi adatok nem kellenek!).
Mi az a „teljes tábla scan” (vagy „sorozatos tábla bejárás”, Sequential Scan)? Ez egy olyan művelet, amely során az DBMS sorrendben olvassa be a tábla minden sorát, azaz a benne található adatokat, és ellenőrzi azokat a megadott feltételeknek megfelelően. Tudvalevő, hogy ez a típusú tábla bejárás a leglassúbb. Az a probléma, hogy ennek végrehajtásakor sok bemeneti/kimeneti művelet történik, amelyek a szerver lemezalrendszerét érintik. A helyzetet súlyosbítják a lemezen tárolt adatok kezelésével kapcsolatos késések, valamint az, hogy az adatok lemezről a memóriába kerülése erőforrás-igényes művelet.
Például, ha Ön 100000000 felhasználó adatainak bejegyzéseivel rendelkezik, és futtat egy lekérdezést a következő felépítéssel: OFFSET 50000000. Ez azt jelenti, hogy az DBMS-nek le kell töltenie az összes ezeket a bejegyzéseket (pedig ezekre nincs szükségünk!), és a memóriába kell helyeznie őket, és csak ezután vehet például 20 eredményt, amelyről a LIMIT.
Mondjuk, így nézhet ki: „válassza ki az 50000-től 50020-ig terjedő sorokat 100000-ből”. Tehát a rendszernek először 50000 sort kell betöltenie a lekérdezés végrehajtásához. Látja, mennyi felesleges munkát kell elvégeznie?
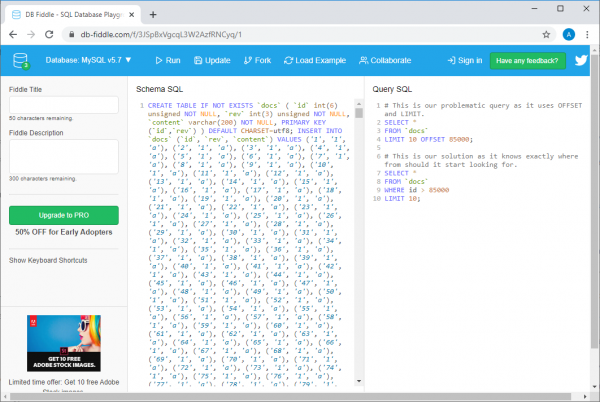
Ha nem hiszi, nézze meg az általam létrehozott példát, kihasználva a .
Példa a db-fiddle.com-on
Ott balra, az Schema SQL, mezőben található kód 100000 sor beszúrását végzi az adatbázisba, míg jobbra, a Query SQL, mezőben két lekérdezés látható. Az első, lassú lekérdezés így néz ki:
SELECT *
FROM `docs`
LIMIT 10 OFFSET 85000;
A második, amely hatékony megoldása ugyanannak a feladatnak, pedig így:
SELECT *
FROM `docs`
WHERE id > 85000
LIMIT 10;
Ezeknek a lekérdezéseknek a végrehajtásához elegendő megnyomni a Run az oldal tetején. Ezt megtehendő, összehasonlítjuk a lekérdezések végrehajtási idejét. Kiderül, hogy egy nem hatékony lekérdezés végrehajtása legalább 30-szor annyi időt vesz igénybe, mint a második (futtatásról futtatásra ez az idő eltérhet, például a rendszer azt jelentheti, hogy az első lekérdezés végrehajtása 37 ms-t, míg a második 1 ms-t vett igénybe).
Ha több adat van, akkor minden még rosszabbul fog kinézni (ha ezt meg akarja győződni, nézze meg az én 10 millió sorral).
Amit most csak megvitattunk, bizonyos megértést kell, hogy nyújtson arról, hogy a lekérdezések hogyan is kezelődnek valójában az adatbázisokban.
Figyelembe kell venni, hogy minél nagyobb az érték OFFSET — annál hosszabb ideig tart a lekérdezés végrehajtása.
Mit érdemes használni az OFFSET és LIMIT kombinációja helyett?
Az OFFSET és LIMIT kombinációja helyett érdemes egy olyan szerkezetet használni, amely így épül fel: OFFSET és LIMIT SELECT * FROM table_name WHERE id > 10 LIMIT 20
Ez egy kurzor alapú lapozási mechanizmus (Cursor based pagination).
Ahelyett, hogy helyben tárolná a jelenlegi
és minden lekérdezéssel továbbítaná azokat, a legutolsó megkapott elsődleges kulcsot kell tárolni (általában ez OFFSET és LIMIT ID ) és, ennek eredményeként a lekérdezések olyan formát öltenek, mint a fent említett. LIMITMiért? Azért, mert ha kifejezetten megadja az utolsó olvasott sor azonosítóját, közli a DBMS-sel, hogy hol kell elkezdenie a szükséges adatok keresését. Ráadásul a kulcs használatának köszönhetően a keresés hatékonyan fog zajlani, a rendszernek nem kell a megadott tartományon kívüli sorokra figyelnie.
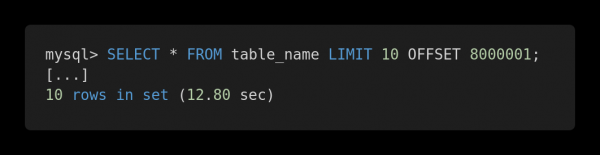
Nézzük meg a különböző lekérdezések teljesítményének következő összehasonlítását. Íme egy nem hatékony lekérdezés.
Lassú lekérdezés
Íme az optimizált változata ennek a lekérdezésnek.
Gyors lekérdezés
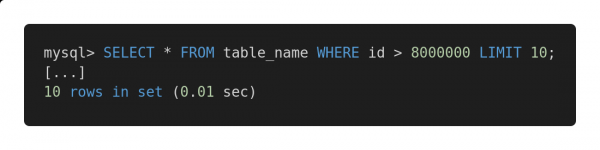
Mindkét lekérdezés pontosan ugyanazt az adatmennyiséget adja vissza. De az első végrehajtása 12,80 másodpercet, míg a második 0,01 másodpercet igényel. Érezhető a különbség?
Lehetséges problémák
Lehetséges problémák
A javasolt lekérdezési módszer hatékony működésének biztosításához szükség van arra, hogy a táblázatban legyen legalább egy (vagy több) oszlop, amely egyedi, egymás után elhelyezkedő indexeket, például egész számú azonosítót tartalmaz. Bizonyos specifikus esetekben ez meghatározhatja az ilyen lekérdezések alkalmazásának sikerét a teljesítmény növelése érdekében.
Természetesen, a lekérdezések megfogalmazásakor figyelembe kell venni a táblák architektúrájának sajátosságait, és olyan mechanizmusokat kell választani, amelyek a legjobban teljesítenek a meglévő táblák esetében. Például, ha nagy mennyiségű kapcsolódó adatokat kell kezelnünk a lekérdezések során, érdekes lehet önnek cikk.
Ha a probléma a hozzáférési kulcs hiánya, például ha van egy „sok-a-sokhoz” kapcsolatot tartalmazó táblázatunk, akkor a hagyományos megközelítés, amely megköveteli OFFSET és LIMIT, garantáltan megfelelő lesz számunkra. De az alkalmazása potenciálisan lassú lekérdezések végrehajtásához vezethet. Ilyen esetekben javasolnám, hogy használjunk automatikusan növekvő elsődleges kulcsot, még akkor is, ha ez csak a lapozott lekérdezések végrehajtásának szervezésére szükséges.
Ha érdekli ez a téma — , és — néhány hasznos anyag.
Összegzés
A legfontosabb következtetés, amit levonhatunk, az, hogy függetlenül a megoldandó adatbázisok méretétől, mindig elemezni kell a lekérdezések végrehajtási sebességét. Manapság rendkívül fontos a megoldások skálázhatósága, és ha a rendszer munkálatai elején minden megfelelően van megtervezve, az a jövőben rengeteg problémától megkímélheti a fejlesztőt.
Hogyan elemzi és optimalizálja az adatbázisokhoz írt lekérdezéseit?
Forrás: habr.com
