

Helló, Habr!
Emlékeztetünk, hogy a könyv után kiadtunk egy legalább annyira érdekes művet a .
Jelenleg a közösség csak felfedezi ennek a hatalmas eszköznek a lehetőségeit. Nemrégiben megjelent egy cikk, amelynek fordításával szeretnénk megismertetni Önöket. A szerző saját tapasztalata alapján mesél arról, hogyan lehet a Kafka Streams-ból elosztott adatraktárt létrehozni. Jó olvasást kívánunk!
Az Apache könyvtár világszerte adatközpontokban használják az Apache Kafka fölötti elosztott folyamfeldolgozáshoz. Ennek a keretrendszernek az egyik alábecsült aspektusa, hogy lehetővé teszi a folyamfeldolgozás alapján generált lokális állapot tárolását.
Ebben a cikkben arról fogok beszámolni, hogyan sikerült cégünknél hatékonyan kihasználni ezt a lehetőséget egy felhőalapú alkalmazásbiztonsági termék fejlesztése során. A Kafka Streams segítségével olyan mikroszolgáltatásokat hoztunk létre, amelyek megosztott állapottal rendelkeznek, és mindegyik megbízható és magas rendelkezésre állású forrásként szolgál az információk pontos állapotáról a rendszerben. Ez előrelépés számunkra mind a megbízhatóság, mind a karbantartás könnyítése szempontjából.
Ha érdekli egy alternatív megközelítés, amely lehetővé teszi, hogy egységes központi adatbázist használjunk az objektumok formális állapotának kezelésére – olvassa el, érdemes lesz…
Miért gondoltuk, hogy itt az ideje megváltoztatni a megközelítéseinket a megosztott állapot kezelésében
Az különböző objektumok állapotának fenntartására volt szükségünk, az ügynökök jelentéseire támaszkodva (például: történt-e támadás a weboldalon?). A Kafka Streams-re való áttérés előtt gyakran támaszkodtunk egy központi adatbázisra (+ szolgáltatási API) az állapot kezeléséhez. Ennek a megközelítésnek megvannak a hátrányai: a az intelligencia és a szinkronizálás fenntartása igazi kihívássá válik. Az adatbázis szűk keresztmetszetté válhat, vagy kerülhet, és szenvedhet a kiszámíthatatlanságtól.
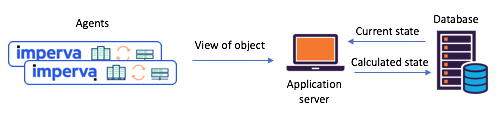
1. ábra: tipikus állapotmegosztási forgatókönyv, amely a Kafka és a Kafka Streams-ra való áttérés előtt fordult elő: az ügynökök az API-n keresztül jelentik az elképzeléseiket, az új állapotot a központi adatbázis számítja ki
Ismerje meg a Kafka Streams-t – most már egyszerűen lehet megosztott állapottal rendelkező mikroszolgáltatásokat létrehozni
Ismerje meg a Kafka Streams-t – most már egyszerű létrehozni a megosztott állapotú mikroszervizeket.
Körülbelül egy évvel ezelőtt úgy döntöttünk, hogy alaposan áttekintjük a megosztott állapottal kapcsolatos munkafolyamatainkat, hogy megoldjuk a felmerült problémákat. Azonnal ki akartuk próbálni a Kafka Streams-t – köztudott, hogy mennyire skálázható, nagy rendelkezésre állású és hibátűrő, és milyen gazdag a folyamfunkcionalitása (többek között állapot megőrzésével végzett átalakítások). Pontosan erre volt szükségünk, nem beszélve arról, milyen érett és megbízható üzenetküldő rendszer alakult ki a Kafka körül.
Az általunk létrehozott minden megosztott állapotú mikroszolgáltatás egy viszonylag egyszerű Kafka Streams példány alapján épült fel. Ez 1) forrást, 2) kulcs-érték tárolóval rendelkező feldolgozót, és 3) egy kimenetet tartalmazott:
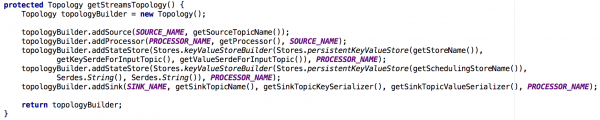
2. ábra: a megosztott állapottal rendelkező mikroszolgáltatások számára beállított alapértelmezett topológia a folyamok példányaiban. Kérjük, vegye figyelembe: itt egy tároló is található, amely a tervezési metainformációkat tartalmazza.
Ezzel az új megközelítéssel az ügynökök üzeneteket állítanak elő, amelyeket az alap téma felé továbbítanak, míg a fogyasztók – mondjuk egy értesítési szolgáltatás – a számított megosztott állapotot egy kimeneti témán keresztül fogadják.
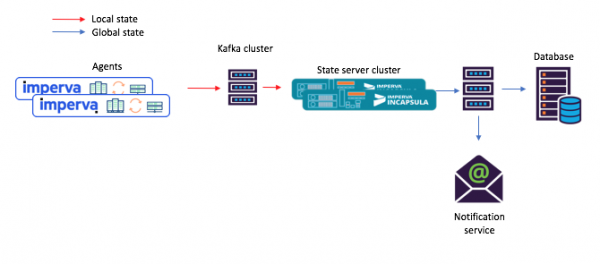
3. ábra: új példa feladatfolyamra a megosztott mikroszolgáltatások forgatókönyvéhez: 1) az ügynök egy üzenetet generál, amely a Kafka alap témájába érkezik; 2) a megosztott állapotú mikroszolgáltatás (Kafka Streams-t használva) feldolgozza azt, és a számított állapotot egy végső Kafka témába rögzíti; ezután 3) a fogyasztók megkapják az új állapotot.
Hé, ez az beépített kulcs-érték tároló tényleg nagyon hasznos!
Ahogy korábban említettük, a megosztott állapottal rendelkező topológiánk tartalmaz egy kulcs-érték tárolót. Több felhasználási módot találtunk, és ezek közül kettőt az alábbiakban mutatunk be.
1. lehetőség: kulcs-érték tároló használata a számítások során
Első kulcs-érték tárolónk olyan segédadatokat tartalmazott, amelyek a számításainkhoz szükségesek voltak. Például bizonyos esetekben a megosztott állapot a „szavazatok többsége” elvén alapult. A tárolóban minden ügynök legutóbbi állapotjelentéseit tárolhattuk egy adott objektumról. Így amikor egy új állapotjelentést kaptunk bármelyik ügynöktől, elmenthettük azt, kibővíthettük a tárolóból az összes többi ügynök jelentését ugyanarról az objektumról, és megismételhettük a számítást.
Az alábbi 4. ábrán látható, hogyan nyitottuk meg a hozzáférést a kulcs-érték tárolóhoz a feldolgozó metódus számára, hogy ezután új üzeneteket tudjunk feldolgozni.
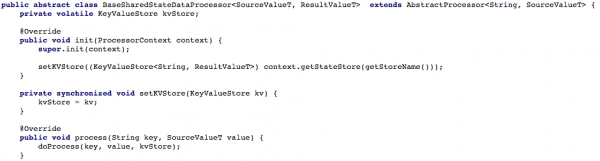
4. ábra: a kulcs-érték tároló hozzáférésének megnyitása a feldolgozó metódus számára (ezután minden, a megosztott állapotot kezelő szcenárióban implementálni kell a metódust doProcess)
Alternatíva #2: CRUD API létrehozása a Kafka Streams felett
Alapvető feladatfolyamunk beállítása után megpróbáltunk egy RESTful CRUD API-t írni megosztott állapotú mikroszolgáltatásaink számára. Szerettük volna, hogy lehessen állapotot lekérni bizonyos vagy minden objektumról, valamint beállítani vagy eltávolítani az objektum állapotát (ez hasznos a backend támogatása során).
Minden Get State API támogatásához, amikor újra kellett számolni az állapotot a feldolgozás során, hosszú időre elmentettük azt a beépített kulcs-érték tárolóba. Így elegendő volt egyetlen példány Kafka Streams segítségével implementálni egy ilyen API-t, ahogyan az alábbi listázásban látható:
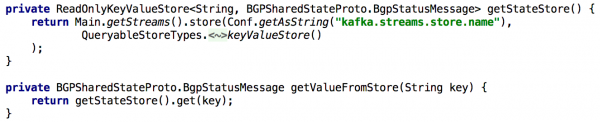
5. ábra: a beépített kulcs-érték tároló használata az előre számolt objektum állapotának lekérésére
Az objektum állapotának frissítése API-n keresztül szintén egyszerűen megvalósítható. Alapvetően ehhez csak egy Kafka termelőt kell létrehozni, amelyen keresztül egy új állapotot tartalmazó bejegyzést hozunk létre. Ezzel garantálva van, hogy minden API-n keresztül generált üzenetet pontosan ugyanúgy dolgoznak fel, mint a többi termelőtől (pl. ügynököktől) érkező üzenetek.
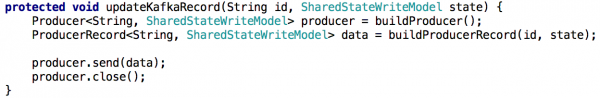
6. ábra: az objektum állapotát a Kafka termelő segítségével lehet beállítani
Egy kis bonyodalom: a Kafka-nak sok partíciója van
A következő lépésben szeretnénk elosztani a feldolgozással járó terhelést, és javítani a rendelkezésre állást, minden forgatókönyvhöz létrehozva egy megosztott állapottal rendelkező mikroszolgáltatás klasztert. A beállítás számunkra rendkívül egyszerűen ment: miután konfiguráltuk az összes példányt úgy, hogy ugyanazzal az alkalmazásazonosítóval (és azonos kezdeti betöltő szerverekkel) működjenek, gyakorlatilag minden más automatikusan történt. Azt is meghatároztuk, hogy minden forrásverem több partícióból áll, így minden példányhoz rendelhető egy részhalmaza ezeknek a partícióknak.
Továbbá megemlítem, hogy itt szokás az állapot tárolásának biztonsági mentése, hogy például hiba esetén ezt a másolatot egy másik példányra áthelyezzük. Minden egyes állapot tárolónak a Kafka Streams-ben replikálható verem jön létre, amely a változások naplóját tartalmazza (ami a helyi frissítéseket követi). Így a Kafka folyamatosan biztosítja az állapot tárolót. Ezért ha az egyik példány hibát észlel, a Kafka Streams állapot tárolója gyorsan helyreállítható egy másik példányon, ahová a megfelelő partíciók kerülnek. Tesztjeink alapján ez néhány másodpercen belül megvalósul, még akkor is, ha az állapot tárolóban millió bejegyzés van.
A megosztott állapotú mikroszolgáltatásból a mikroszolgáltatások klaszteréhez való átmenet nem olyan triviális a Get State API megvalósításában. Az új helyzetben minden mikroszolgáltatás állapot tárolójában csak a teljes térkép egy része található (azok az objektumok, amelyek kulcsai egy adott partícióra vonatkoznak). Meg kellett határoznunk, hogy melyik példányon található a keresett objektum állapota, és ezt az adatfolyamok metaadatai alapján tettük, ahogyan az alább látható:
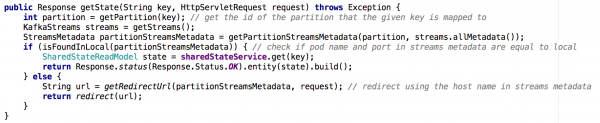
7. ábra: az adatfolyamok metaadatai segítségével meghatározzuk, hogy melyik példánytól kérdezzük le a keresett objektum állapotát; hasonló megközelítést alkalmaztunk a GET ALL API-nál
Főbb megállapítások
A Kafka Streams állapot tárolói de facto elosztott adatbázisként szolgálhatnak,
- folyamatosan replikálva a Kafka-ban
- Ezekre a rendszerekre könnyen felépíthető a CRUD API
- Több partíció kezelése azonban kicsit bonyolultabb lesz
- Lehetőség van egy vagy több állapot tároló hozzáadására a stream topológiához, amely segédadatok tárolására szolgál. Ez a megoldás a következő esetekben használható:
- Hosszú távú adatok tárolása, amelyek szükségesek a stream feldolgozás során végzett számításokhoz
- Hosszú távú adatok tárolása, amelyek hasznosak lehetnek a stream példány következő inicializálásakor
- sok másra...
Ezeknek és más előnyöknek köszönhetően a Kafka Streams kiválóan alkalmas a globális állapot támogatására egy olyan elosztott rendszerben, mint amilyen a miénk. A Kafka Streams a termelés során meglehetősen megbízhatónak bizonyult (azóta, hogy bevezettük, gyakorlatilag nem veszítettünk el üzeneteket), és biztosak vagyunk benne, hogy a lehetőségei ezzel nem merülnek ki!
Forrás: habr.com
