

Bevezető
Gyakran a felhasználók, fejlesztők és MS SQL Server adatbáziskezelő rendszerek adminisztrátorai teljesítményproblémákkal találkoznak az adatbázisok vagy az adatbáziskezelő rendszerek esetében. Éppen ezért a MS SQL Server monitorozása rendkívül aktuális téma.
Ez a cikk kiegészítése egy másik cikknek. A cikkben az MS SQL Server monitorozásának néhány aspektusát fogjuk megvizsgálni, különös figyelmet fordítva arra, hogyan lehet gyorsan meghatározni, hogy mely erőforrások hiányoznak, valamint ajánlásokat adunk a nyomozási flagok beállítására.
A következő szkriptek működéséhez létre kell hozni az inf sémát a szükséges adatbázisban az alábbi módon:
inf séma létrehozása
use ;
go
create schema inf;
A memóriahiány megállapításának módszere
Az első jel, hogy memóriahiány lép fel, az az, amikor az MS SQL Server példány az összes számára rendelkezésre álló RAM-ot használja.
Ehhez létrehozzuk a következő nézetet: inf.vRAM:
inf.vRAM nézet létrehozása
CREATE view [inf].[vRAM] as
select a.[TotalAvailOSRam_Mb]						-- mennyi szabad RAM van a szerveren MB-ban
		 , a.[RAM_Avail_Percent]					-- a szabad RAM százalékos aránya a szerveren
		 , a.[Server_physical_memory_Mb]				-- összes RAM a szerveren MB-ban
		 , a.[SQL_server_committed_target_Mb]			-- összes RAM, amelyet az MS SQL Server kapott MB-ban
		 , a.[SQL_server_physical_memory_in_use_Mb] 		-- az MS SQL Server által jelenleg használt összes RAM MB-ban
		 , a.[SQL_RAM_Avail_Percent]				-- a szabad RAM százalékos aránya az MS SQL Server számára, a teljesen rendelkezésre álló RAM-ra vonatkoztatva
		 , a.[StateMemorySQL]						-- elegendő-e RAM az MS SQL Server számára
		 , a.[SQL_RAM_Reserve_Percent]				-- az MS SQL Server számára fenntartott RAM százalékos aránya a szerver teljes RAM-jához képest
		 -- elegendő-e RAM a szerverhez
		, (case when a.[RAM_Avail_Percent]5 and a.[TotalAvailOSRam_Mb]<8192 then 'Figyelmeztetés' when a.[RAM_Avail_Percent]<=5 and a.[TotalAvailOSRam_Mb]<2048 then 'Veszély' else 'Normális' end) as [StateMemoryServer]
	from
	(
		select cast(a0.available_physical_memory_kb/1024.0 as int) as TotalAvailOSRam_Mb
			 , cast((a0.available_physical_memory_kb/casT(a0.total_physical_memory_kb as float))*100 as numeric(5,2)) as [RAM_Avail_Percent]
			 , a0.system_low_memory_signal_state
			 , ceiling(b.physical_memory_kb/1024.0) as [Server_physical_memory_Mb]
			 , ceiling(b.committed_target_kb/1024.0) as [SQL_server_committed_target_Mb]
			 , ceiling(a.physical_memory_in_use_kb/1024.0) as [SQL_server_physical_memory_in_use_Mb]
			 , cast(((b.committed_target_kb-a.physical_memory_in_use_kb)/casT(b.committed_target_kb as float))*100 as numeric(5,2)) as [SQL_RAM_Avail_Percent]
			 , cast((b.committed_target_kb/casT(a0.total_physical_memory_kb as float))*100 as numeric(5,2)) as [SQL_RAM_Reserve_Percent]
			 , (case when (ceiling(b.committed_target_kb/1024.0)-1024)<ceiling(a.physical_memory_in_use_kb/1024.0) then 'Figyelmeztetés' else 'Normális' end) as [StateMemorySQL]
		from sys.dm_os_sys_memory as a0
		cross join sys.dm_os_process_memory as a
		cross join sys.dm_os_sys_info as b
		cross join sys.dm_os_sys_memory as v
	) as a;
Ezután megállapítható, hogy az MS SQL Server példány az összes neki rendelhető memóriát felhasználja, ha a következő lekérdezést futtatjuk:
select  SQL_server_physical_memory_in_use_Mb,  SQL_server_committed_target_Mb
from [inf].[vRAM];
Ha az SQL_server_physical_memory_in_use_Mb mutató folyamatosan nem kevesebb, mint az SQL_server_committed_target_Mb, akkor ellenőrizni kell a várakozási statisztikákat.
A memóriahiány meghatározásához a várakozási statisztikák alapján létrehozunk egy nézetet az inf.vWaits alapján:
Az inf.vWaits nézet létrehozása
CREATE view [inf].[vWaits] as
WITH [Waits] AS
    (SELECT
        [wait_type], --a várakozási típus neve
        [wait_time_ms] / 1000.0 AS [WaitS],--Az adott típusú várakozás összes ideje milliszekundumban. Ez az idő tartalmazza a signal_wait_time_ms-t
        ([wait_time_ms] - [signal_wait_time_ms]) / 1000.0 AS [ResourceS],--Az adott típusú várakozás összes ideje milliszekundumban signal_wait_time_ms nélkül
        [signal_wait_time_ms] / 1000.0 AS [SignalS],--A várakozó szál jelzési ideje és végrehajtásának kezdeti ideje közötti különbség
        [waiting_tasks_count] AS [WaitCount],--Az adott típusú várakozások száma. Ez a számláló minden egyes várakozás kezdetekor növekszik
        100.0 * [wait_time_ms] / SUM ([wait_time_ms]) OVER() AS [Percentage],
        ROW_NUMBER() OVER(ORDER BY [wait_time_ms] DESC) AS [RowNum]
    FROM sys.dm_os_wait_stats
    WHERE [waiting_tasks_count]>0
		and [wait_type] NOT IN (
        N'BROKER_EVENTHANDLER',         N'BROKER_RECEIVE_WAITFOR',
        N'BROKER_TASK_STOP',            N'BROKER_TO_FLUSH',
        N'BROKER_TRANSMITTER',          N'CHECKPOINT_QUEUE',
        N'CHKPT',                       N'CLR_AUTO_EVENT',
        N'CLR_MANUAL_EVENT',            N'CLR_SEMAPHORE',
        N'DBMIRROR_DBM_EVENT',          N'DBMIRROR_EVENTS_QUEUE',
        N'DBMIRROR_WORKER_QUEUE',       N'DBMIRRORING_CMD',
        N'DIRTY_PAGE_POLL',             N'DISPATCHER_QUEUE_SEMAPHORE',
        N'EXECSYNC',                    N'FSAGENT',
        N'FT_IFTS_SCHEDULER_IDLE_WAIT', N'FT_IFTSHC_MUTEX',
        N'HADR_CLUSAPI_CALL',           N'HADR_FILESTREAM_IOMGR_IOCOMPLETION',
        N'HADR_LOGCAPTURE_WAIT',        N'HADR_NOTIFICATION_DEQUEUE',
        N'HADR_TIMER_TASK',             N'HADR_WORK_QUEUE',
        N'KSOURCE_WAKEUP',              N'LAZYWRITER_SLEEP',
        N'LOGMGR_QUEUE',                N'ONDEMAND_TASK_QUEUE',
        N'PWAIT_ALL_COMPONENTS_INITIALIZED',
        N'QDS_PERSIST_TASK_MAIN_LOOP_SLEEP',
        N'QDS_CLEANUP_STALE_QUERIES_TASK_MAIN_LOOP_SLEEP',
        N'REQUEST_FOR_DEADLOCK_SEARCH', N'RESOURCE_QUEUE',
        N'SERVER_IDLE_CHECK',           N'SLEEP_BPOOL_FLUSH',
        N'SLEEP_DBSTARTUP',             N'SLEEP_DCOMSTARTUP',
        N'SLEEP_MASTERDBREADY',         N'SLEEP_MASTERMDREADY',
        N'SLEEP_MASTERUPGRADED',        N'SLEEP_MSDBSTARTUP',
        N'SLEEP_SYSTEMTASK',            N'SLEEP_TASK',
        N'SLEEP_TEMPDBSTARTUP',         N'SNI_HTTP_ACCEPT',
        N'SP_SERVER_DIAGNOSTICS_SLEEP', N'SQLTRACE_BUFFER_FLUSH',
        N'SQLTRACE_INCREMENTAL_FLUSH_SLEEP',
        N'SQLTRACE_WAIT_ENTRIES',       N'WAIT_FOR_RESULTS',
        N'WAITFOR',                     N'WAITFOR_TASKSHUTDOWN',
        N'WAIT_XTP_HOST_WAIT',          N'WAIT_XTP_OFFLINE_CKPT_NEW_LOG',
        N'WAIT_XTP_CKPT_CLOSE',         N'XE_DISPATCHER_JOIN',
        N'XE_DISPATCHER_WAIT',          N'XE_TIMER_EVENT')
    )
, ress as (
	SELECT
	    [W1].[wait_type] AS [WaitType],
	    CAST ([W1].[WaitS] AS DECIMAL (16, 2)) AS [Wait_S],--Az adott típusú várakozás összes ideje milliszekundumban. Ez az idő tartalmazza a signal_wait_time_ms-t
	    CAST ([W1].[ResourceS] AS DECIMAL (16, 2)) AS [Resource_S],--Az adott típusú várakozás összes ideje milliszekundumban signal_wait_time_ms nélkül
	    CAST ([W1].[SignalS] AS DECIMAL (16, 2)) AS [Signal_S],--A várakozó szál jelzési ideje és végrehajtásának kezdeti ideje közötti különbség
	    [W1].[WaitCount] AS [WaitCount],--Az adott típusú várakozások száma. Ez a számláló minden egyes várakozás kezdetekor növekszik
	    CAST ([W1].[Percentage] AS DECIMAL (5, 2)) AS [Percentage],
	    CAST (([W1].[WaitS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgWait_S],
	    CAST (([W1].[ResourceS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgRes_S],
	    CAST (([W1].[SignalS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgSig_S]
	FROM [Waits] AS [W1]
	INNER JOIN [Waits] AS [W2]
	    ON [W2].[RowNum] <= [W1].[RowNum]
	GROUP BY [W1].[RowNum], [W1].[wait_type], [W1].[WaitS],
	    [W1].[ResourceS], [W1].[SignalS], [W1].[WaitCount], [W1].[Percentage]
	HAVING SUM ([W2].[Percentage]) - [W1].[Percentage] < 95 -- százalékos küszöb
)
SELECT [WaitType]
      ,MAX([Wait_S]) as [Wait_S]
      ,MAX([Resource_S]) as [Resource_S]
      ,MAX([Signal_S]) as [Signal_S]
      ,MAX([WaitCount]) as [WaitCount]
      ,MAX([Percentage]) as [Percentage]
      ,MAX([AvgWait_S]) as [AvgWait_S]
      ,MAX([AvgRes_S]) as [AvgRes_S]
      ,MAX([AvgSig_S]) as [AvgSig_S]
  FROM ress
  group by [WaitType];
Ebben az esetben a memóriahiányt a következő lekérdezéssel lehet meghatározni:
SELECT [Percentage]
      ,[AvgWait_S]
  FROM [inf].[vWaits]
  where [WaitType] in (
    'PAGEIOLATCH_XX',
    'RESOURCE_SEMAPHORE',
    'RESOURCE_SEMAPHORE_QUERY_COMPILE'
  );
Itt a Percentage és AvgWait_S mutatókra kell figyelni. Ha ezek összességében jelentősen magasak, akkor nagy a valószínűsége annak, hogy az MS SQL Server példánynak nem áll rendelkezésére elegendő memória. A jelentős értékek egyediek minden rendszerre. Azonban a következő mutatókkal érdemes kezdeni: Percentage>=1 és AvgWait_S>=0.005.
A mutatók megjelenítéséhez a megfigyelő rendszerben (például Zabbix) az alábbi két lekérdezést lehet létrehozni:
- hány százalékot képviselnek a memória használatra várakozó típusok (összeg az összes ilyen várakozási típus számára):
select coalesce(sum([Percentage]), 0.00) as [Percentage] from [inf].[vWaits] where [WaitType] in ( 'PAGEIOLATCH_XX', 'RESOURCE_SEMAPHORE', 'RESOURCE_SEMAPHORE_QUERY_COMPILE' ); - hány milliszekundumot képviselnek a memória használatra várakozó típusok (a legnagyobb érték az összes ilyen várakozási típus átlagos késleltetései közül):
select coalesce(max([AvgWait_S])*1000, 0.00) as [AvgWait_MS]
from [inf].[vWaits]
       where [WaitType] in (
            'PAGEIOLATCH_XX',
            'RESOURCE_SEMAPHORE',
            'RESOURCE_SEMAPHORE_QUERY_COMPILE'
  );
A két mutató alapján kapott értékek dinamikájából arra lehet következtetni, hogy elegendő-e a memória az MS SQL Server példány számára.
A CPU túlterheltségének azonosítási módszere
A processzori idő hiányának megállapításához elegendő a sys.dm_os_schedulers rendszer megjelenítést használni. Itt, ha a runnable_tasks_count mutató folyamatosan 1-nél nagyobb, akkor valószínű, hogy a magok száma nem elegendő az MS SQL Server példány számára.
A megfigyelő rendszerbe (például Zabbix) való mutató megjelenítéséhez az alábbi lekérdezést lehet létrehozni:
select max([runnable_tasks_count]) as [runnable_tasks_count]
from sys.dm_os_schedulers
where scheduler_id<255;
A kapott értékek dinamikájából arra lehet következtetni, hogy elegendő-e a processzori idő (a CPU magok száma) az MS SQL Server példány számára.
Fontos azonban emlékezni arra, hogy a lekérdezések egyszerre több szálat is kérhetnek. Néha az optimalizáló nem tudja helyesen értékelni a lekérdezés bonyolultságát. Ilyenkor a lekérdezéshez túl sok szál kerülhet hozzárendelésre, amelyet a jelenlegi időpontban nem lehet egyidejűleg feldolgozni. Ez is várakozási típust okoz, amely a processzortime hiányával kapcsolatos, és a várakozási sorok növekedését eredményezi, amelyeket a konkrét CPU magok használnak, tehát a runnable_tasks_count ebben az esetben növekedni fog.
Ilyen esetben, mielőtt növelné a CPU-magok számát, először helyesen be kell állítani a párhuzamosság tulajdonságait az MS SQL Server példányában, valamint a 2016-os verzióktól kezdve helyesen kell beállítani az érintett adatbázisok párhuzamossági tulajdonságait:
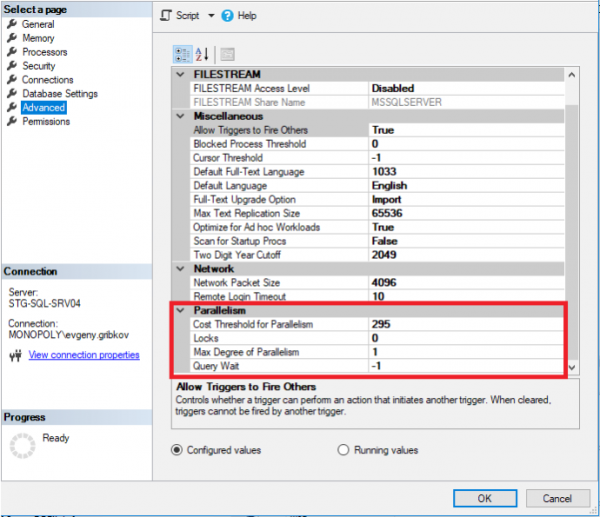
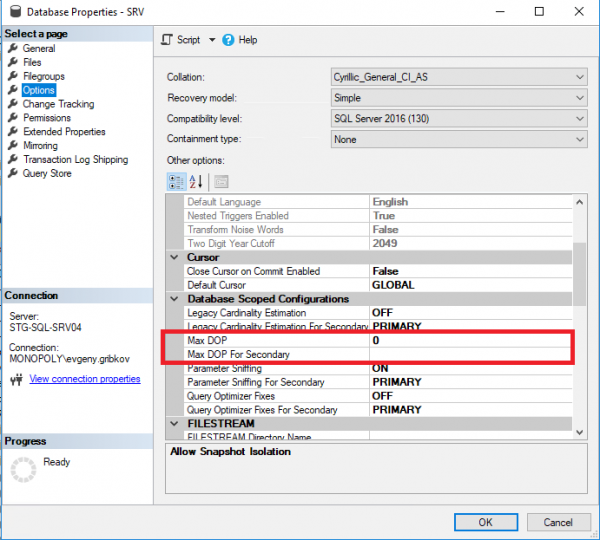
Itt érdemes figyelni a következő paraméterekre:
- Max Degree of Parallelism - maximális számú szálat ad meg, amelyek egy lekérdezéshez hozzárendelhetők (alapértelmezés szerint 0 - csak az operációs rendszer és az MS SQL Server kiadása korlátozza)
- Cost Threshold for Parallelism - a párhuzamosság becsült költsége (alapértelmezés szerint 5)
- Max DOP - maximális számú szálat ad meg, amelyek egy lekérdezéshez hozzárendelhetők az adatbázis szintjén (de nem haladhatja meg a „Max Degree of Parallelism” tulajdonság értékét) (alapértelmezés szerint 0 - csak az operációs rendszer és az MS SQL Server kiadása korlátozza, valamint a teljes MS SQL Server példány „Max Degree of Parallelism” tulajdonságának korlátozása)
Itt nem lehetséges minden esetben egyformán jó receptet adni, tehát elemezni kell a nehéz lekérdezéseket.
Saját tapasztalataim alapján ajánlom a következő lépéseket OLTP rendszerek párhuzamossági tulajdonságainak beállításához:
- először tiltsa le a párhuzamosságot, és állítsa be az egész példány szintjén a Max Degree of Parallelism értékét 1-re
- elemezze a legnehezebb lekérdezéseket, és válassza ki számukra az optimális szálak számát
- állítsa be a Max Degree of Parallelism értékét a 2. pontban meghatározott optimalizált szálak számára, valamint a konkrét adatbázisoknak állítsa be a Max DOP értékét, amely a 2. pontból származik, minden egyes adatbázisra
- elemezze a legnehezebb lekérdezéseket, és azonosítsa a párhuzamosság negatív hatását. Ha van ilyen, emelje meg a Cost Threshold for Parallelism értékét.
Ilyen rendszerek esetén, mint az 1C, a Microsoft CRM és a Microsoft NAV, a párhuzamosság letiltása a legtöbb esetben megfelelő.
Ha Standard kiadás van, a legtöbb esetben elegendő a párhuzamosság letiltása, mivel ez a kiadás korlátozott a CPU magok számában.
OLAP-rendszerekhez a fent leírt algoritmus nem alkalmas.
Saját tapasztalataim alapján javaslom a következő cselekvési algoritmust OLAP-rendszerek számára a párhuzamossági tulajdonságok beállításához:
- elemezze a legnehezebb lekérdezéseket, és válassza ki számukra az optimális szálak számát
- állítsuk be a Max Degree of Parallelism értékét az 1. pontból kapott optimalizált szálak számára, valamint a konkrét adatbázisok esetében állítsuk be a Max DOP értékét az 1. pontban kapott adatbázisonkénti értékre
- elemezzük a legnehezebb lekérdezéseket, és azonosítsuk a párhuzamosság korlátozásának negatív hatását. Ha van, csökkentsük a Cost Threshold for Parallelism értékét, vagy ismételjük meg a 1-2 lépéseket ennek az algoritmusnak
Tehát az OLTP-rendszerek esetében az egy szálú megoldás felé haladunk, míg OLAP-rendszerek esetében éppen ellenkezőleg: a párhuzamos feladatokból az egy szálú feladatok felé. Így optimalizálhatók a párhuzamossági beállítások mind a konkrét adatbázis, mind a teljes MS SQL Server példány számára.
Fontos megérteni, hogy a párhuzamossági beállítások idővel változtatásra szorulnak, a MS SQL Server teljesítménymonitoringának eredményei alapján.
Ajánlások a nyomkövetési flagok beállításához
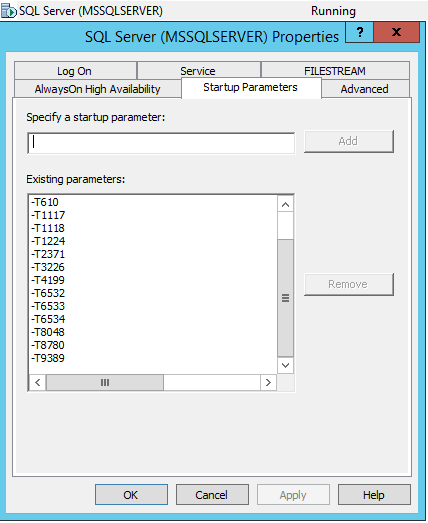
Saját tapasztalat és kollégáim tapasztalatai alapján az MS SQL Server szolgáltatás indítási szintjén a 2008-2016 verziókhoz a következő nyomkövetési flagokat javaslom:
- 610 — Csökkenti a bejegyzések naplózását indexelt táblákban. Segíthet a nagyszámú rekorddal rendelkező táblákra történő bejegyzések kezelésében, különösen a WRITELOG hosszú várakozásaival járó tranzakciók esetén.
- 1117 — Ha egy fájl a fájlcsoportban megfelel az automatikus növelési küszöb követelményeinek, akkor minden fájl a fájlcsoportban növekszik.
- 1118 — Kötelezővé teszi, hogy minden objektum külön kiterjedéseken helyezkedjen el (kevert kiterjedések tilalma), ez minimalizálja a SGAM oldal beolvasásának szükségességét, amely a kevert kiterjedések nyomon követésére szolgál.
- 1224 — Kikapcsolja a zárolások nagyságának növelését a zárolások száma alapján. Azonban a memória túl aktív használata nagyságnövelést okozhat.
- 2371 — Megváltoztatja a statisztikák rögzített automatikus frissítési küszöbértékét dinamikus automatikus frissítési küszöbértékre. Fontos a lekérdezési tervek frissítéséhez nagy táblák esetén, ahol a rekordok számának helytelen meghatározása hibás végrehajtási terveket eredményez.
- 3226 — Elnyomja a sikeres biztonsági mentés végrehajtásáról szóló üzeneteket a hibajegyzékben.
- 4199 — Bekapcsolja a lekérdezésoptimalizálóban a kumulatív frissítési csomagok és a SQL Server frissítési csomagok kiadásaiban megvalósított módosításokat.
- 6532-6534 — Aktiválja a térbeli adattípusokkal végzett lekérdezések teljesítményének javítását.
- 8048 — Átkonvertálja a NUMA szerint szegmentált memóriatárgyakat CP szerint szegmentáltra.
- 8780 — További időt engedélyez a lekérdezési tervek előállításához. Néhány lekérdezés ezen zászló nélkül elutasításra kerülhet, mivel nem rendelkezik lekérdezési tervvel (nagyon ritka hiba).
- 8780 — 9389 — További dinamikusan biztosított memória-tárhelyet aktivál a kötegelt üzemmódú operátorok számára, lehetővé téve ezzel a kötegelt üzemmódú operátor számára, hogy további memóriát kérjen, és elkerülje az adatok átvitelét a tempdb-be, ha további memória rendelkezésre áll.
2016 előtti verziók számára érdemes aktiválni a 2301-es nyomkövetési zászlót, amely magában foglalja a kibővített döntéstámogatás optimalizációját, ezáltal segítve a megfelelőbb lekérdezési tervek kiválasztását. 2016-tól azonban gyakran negatív hatással bír a lekérdezések összesített végrehajtási idejére.
Továbbá, olyan rendszerek esetén, amelyekben sok index található (például 1C adatbázisok), javaslom a 2330-as nyomkövetési zászló aktiválását, amely letiltja az indexhasználati adatok gyűjtését, ami összességében pozitívan hat a rendszerre.
A nyomkövetési zászlókról részletesebben tájékozódhat.
A fenti linken fontos figyelembe venni a MS SQL Server verzióit és kiadásait, mivel az újabb verziók esetén egyes nyomkövetési zászlók alapértelmezés szerint aktiválva vannak, vagy nincsenek hatással.
A nyomkövetési zászlókat a DBCC TRACEON és a DBCC TRACEOFF parancsok segítségével lehet aktiválni és deaktiválni. Részletesebben itt olvashat.
A nyomkövetési zászlók állapotát a DBCC TRACESTATUS parancs segítségével lehet lekérdezni.
Ahhoz, hogy a nyomkövetési flagok automatikusan elinduljanak az MS SQL Server szolgáltatásban, meg kell nyitni a SQL Server Configuration Manager-t, és a szolgáltatás tulajdonságai között hozzá kell adni a nyomkövetési flagokat -T: formátumban.
Összegzés
Ebben a cikkben a MS SQL Server monitorozásának néhány aspektusát tárgyaltuk, amelyek segítségével gyorsan azonosíthatók a RAM és a CPU szabadidő hiányosságai, valamint számos egyéb, kevésbé nyilvánvaló probléma. A leggyakrabban használt nyomkövetési flagok kerültek bemutatásra.
Források:
»
»
»
»
»
»
»
Forrás: habr.com
